即使函数的每个偏导数都为零,您也不能保证自己接近一个最小值。
优化就是寻找函数的最小或最大值,而您使用的每种方法都在寻找梯度变平的点。但梯度变平并不保证您找到了最佳答案。有时这意味着函数在同一点上沿某个方向上升、沿另一个方向下降。
这个点称为鞍点,它一方面下降、另一方面上升,并且在其周围是平的。识别鞍点很重要,因为您的算法可能会被困在这里,把平坦的梯度误认为是真正的最小值。
本文将带您从数学上如何识别鞍点,以及为什么它常常让优化算法困惑。
什么是鞍点?
在鞍点处,梯度为零,就像在最小值或最大值处一样。但鞍点既不是最小值,也不是最大值。
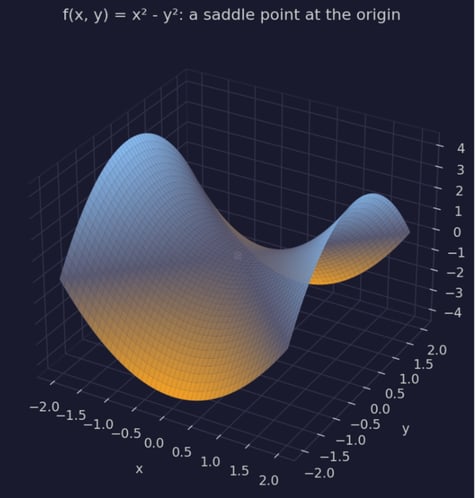
函数在同一点上沿某些方向向上弯曲,沿另一些方向向下弯曲。沿一个坐标轴前进,函数值上升;沿另一条坐标轴前进,函数值下降。这也是名称的由来——它借用了马鞍的形状,前后翘起、两侧下凹。
下面用一个简单的二元函数来展示这种形状:
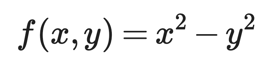
二元函数
在原点 (0, 0) 处,两个偏导数都等于零,因此它是一个临界点(也称为驻点)。沿 x 轴移动,f 因 x^2 项而增加。沿 y 轴移动,f 因 -y^2 项而减少。
如果将该函数绘制为三维图像,曲面会沿一个方向上拱、沿另一个方向下凹,形成鞍点形状。
f(x, y) = x^2 - y^2 的三维曲面图
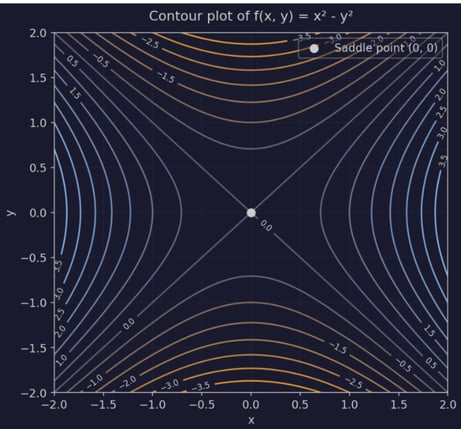
同一个函数的等高线图从俯视角度讲述了相同的故事。原点周围的等高线看起来像双曲线,而不是最小值或最大值周围会出现的闭合曲线。
f(x, y) = x^2 - y^2 的等高线图
精确定义会因领域而异。在多元微积分中,鞍点是既不是局部最小也不是局部最大值的临界点。在优化和博弈论中,该术语可能有不同含义,与极小极大问题而非曲率相关。本文后面将讨论这种区别。
鞍点与极小值和极大值的比较
在学习如何用数学方法识别鞍点之前,先看它与另外两类临界点的对比会更有帮助。
局部最小值
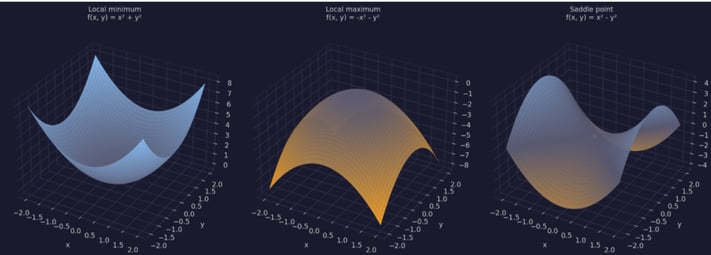
在局部最小值处,函数在附近的每个方向上都增加。想象一个碗——从碗底向任意方向迈出一步,都会向上。函数 f(x, y) = x2 + y2 就是这样。
局部最大值
在局部最大值处,函数在附近的每个方向上都减少。它是最小值的镜像,是一个穹顶而不是一个碗。函数 f(x, y) = -x2 - y2 在您远离原点的每个方向上都下降。
鞍点
在鞍点处,函数在某些方向上增加,在另一些方向上减少。这正是使 f(x, y) = x2 - y2(上一节的例子)成为鞍点而不是极小或极大的原因:它在同一点沿 x 轴上升、沿 y 轴下降。
下图将三者并排比较:
局部最小值、局部最大值与鞍点的三维曲面图并排对比
如何找到鞍点
寻找鞍点归结为求导、找出导数为零的点,然后考察函数在该点附近的弯曲方式。
我将继续使用前面的函数:
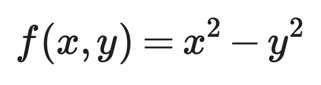
参考函数
步骤如下,一步一步来。
1. 计算一阶偏导数
对 f 关于 x 求导,将 y 视为常数;然后对 y 做同样的事:
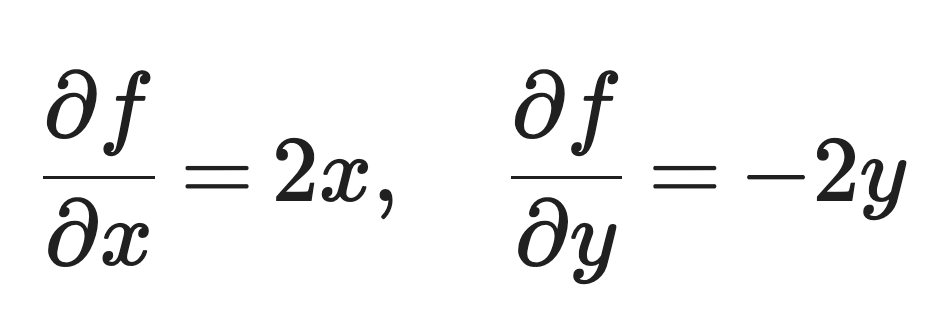
计算一阶偏导数
2. 令其等于零
求解两个偏导数同时为零的点:
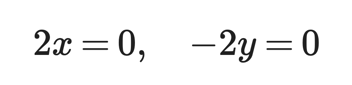
令导数为零
得到 x = 0 和 y = 0,所以 (0, 0) 是一个临界点。仅凭一阶导数无法判断其类型。
3. 计算二阶导数
您需要三个:f_x 关于 x 的导数、f_y 关于 y 的导数,以及混合导数:
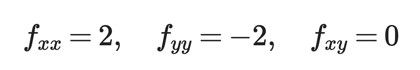
二阶导数
4. 用曲率对临界点分类
f_xx = 2 为正,因此 f 沿 x 轴向上弯曲。f_yy = -2 为负,因此 f 沿 y 轴向下弯曲。同一点上一方向向上、另一方向向下——这就是鞍点。
这四步对任何二次可微函数都适用。
接下来两节将把第 4 步形式化,使用可扩展到两变量以上的工具:Hessian 矩阵与二阶导数判别法。
Hessian 矩阵如何识别鞍点
Hessian 矩阵将上一节中的所有二阶导数放进一个对象中,它是判断临界点是最小值、最大值还是鞍点的工具。
对二元函数,Hessian 形式如下:
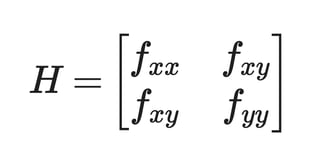
二元函数的 Hessian
每个元素描述曲率:f_xx 和 f_yy 描述沿 x 与 y 轴的曲率,f_xy 描述这两个方向之间的相互作用。将前一节中的二阶导数代入,我们的示例函数的 Hessian 如下:
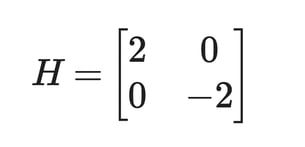
参考函数的 Hessian
仅有矩阵本身并不能说明太多。关键在于它的特征值——这些数值描述函数沿一组特定方向(称为特征向量)的弯曲情况。
- 正特征值意味着函数沿其特征向量方向向上弯曲
- 负特征值意味着函数沿该方向向下弯曲
- 正负特征值并存意味着函数在某些方向上向上、另一些方向上向下(鞍点)
由于示例的 Hessian 是对角矩阵,特征值就在对角线上:2 和 -2。它们的特征向量分别沿 x 轴和 y 轴指向,这与您在上一节手动得到的曲率完全一致。因为该方向上的特征值为正,f 沿 x 向上弯曲;因为该方向上的特征值为负,沿 y 向下弯曲。
大多数函数的 Hessian 不是对角的,因此其特征向量不会整齐地与 x 和 y 轴对齐,需要直接求解而不是从矩阵中读出。但只要有一个正特征值和一个负特征值,您就处在鞍点上。
鞍点的二阶导数判别法
您不必每次都手动计算特征值。对二元函数,有一个捷径——二阶导数判别法——基于 Hessian 的行列式。
使用相同的二阶导数,行列式为:
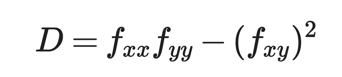
行列式
D 是 Hessian 的行列式,其符号与 f_xx 的符号结合可以对临界点分类:
-
D > 0 且 f_xx > 0:局部最小值
-
D > 0 且 f_xx < 0:局部最大值
-
D < 0:鞍点
-
D = 0:无法定论
对我们的例子,f_xx = 2、f_yy = -2、f_xy = 0:
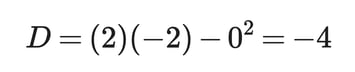
参考函数的二阶导数判别
D 为负,因此该判别确认 (0, 0) 是鞍点。
此判别本质上是上一节特征值规则的改写,以一种无需求特征向量的形式来计算。D 是两个特征值的乘积,f_xx + f_yy 是它们的和。当 D 为负时,特征值必为异号,这正是鞍点。当 D 为零时,至少有一个特征值为零,该方向的曲率为平坦,此时无论该判别还是特征值本身都无法单独说明该处发生了什么。
优化中的鞍点
到目前为止,我们讨论的都是在已知函数的情况下如何识别鞍点。但在优化中,您是在未知最优点在哪里的情况下进行搜索,基于梯度的方法用梯度为零来决定何时停止。
这恰恰是鞍点惹麻烦的地方。
基于梯度的优化器沿使目标函数最快下降的方向移动,直到梯度接近零为止。但接近零的梯度并不会告诉算法它找到的是最小值还是鞍点。
正曲率的方向会把函数值推高,算法已经“学会”了朝这些方向迈步会变糟。负曲率的方向仍然存在,而且是出路——但只信任梯度的算法可能会错过它们,因为在鞍点处,这些方向上的梯度也接近零。
这也会让优化变慢。
当您接近任何驻点时,梯度的大小往往会收缩,因此把步长与梯度大小挂钩的算法在鞍点附近会迈出很小的步子,不管它是否接近真正要找的最小值。
找到一个驻点并不等于完成了优化。您仍需要一种方法来判断接近零的梯度属于鞍点而不是最小值,并在识别后找到继续改进目标的方向。
机器学习中的鞍点
神经网络的损失函数取决于网络中的每个权重和偏置,维度有时达到数百万或数十亿。这与二元的玩具例子相去甚远。
在对高维非凸优化的分析中,Dauphin 及其同事指出,随着维度数量增加,临界点远比局部极小或极大更可能是鞍点。每个维度都会新增一个曲率可正可负的方向,而仅需一个负曲率方向就能把临界点从最小值变成鞍点。
这对训练很重要,因为梯度下降只能“看到”当前所处位置的梯度。
在鞍点附近,各个方向的梯度都会变小——这与接近真实最小值时看到的信号相同。训练可能会在并非最优的区域变慢或停滞,且仅凭损失曲线无法判断您是在最小值附近还是卡在鞍点上。
这也是为什么人们在谈神经网络训练时,鞍点常与局部最小值一起出现。但它们并非唯一的障碍。梯度消失、病态曲率以及搜索空间的尺度都会让高维优化变得困难。
优化算法如何处理鞍点
这并不意味着基于梯度的训练在鞍点附近就注定失败。有几种技术可以从不同角度帮助您穿越它们。
随机梯度下降
随机梯度下降用训练数据的随机子集而不是整个数据集来计算梯度,并且每一步的子集都会变化。
这种噪声意味着估计的梯度很少会恰好为零,即使在真实梯度接近零的区域也是如此。这种噪声足以把优化器从鞍点推开,进入负曲率方向,而不是恰恰在梯度消失处停滞。
动量
动量会保留过去梯度的滑动平均,并用它(而不仅仅是当前梯度)来决定下一步。
在鞍点附近,这很关键,因为优化器到达时已经在某个方向上“动”起来了,由先前的梯度推动。这种累积的动量可以带它穿过鞍点周围的平坦区域,而不是在局部梯度接近零的那一刻就减速。
二阶方法
二阶方法直接利用曲率信息。
通过使用 Hessian 或其近似,这些方法能够在临界点分辨正曲率与负曲率的方向。这正是鞍点所依赖的区别,因此二阶方法可以识别下降方向并朝其迈步,而不是把所有接近零的梯度一概而论。
鞍点与相关概念
有一些术语经常与鞍点混淆,值得澄清。
鞍点 vs. 局部最小值
局部最小值在其附近每个方向上都向上弯曲,即周围各向的一致正曲率。鞍点只在某些方向上向上弯曲,而在另一些方向上向下弯曲。一旦发现哪怕一个负曲率方向,您看到的就不再是最小值。
鞍点 vs. 局部最大值
对于局部最大值,逻辑正好相反。它在附近每个方向上的曲率都为负。鞍点则在这些负曲率方向之外,至少增加了一个正曲率方向。
鞍点 vs. 拐点
拐点是一维概念。它是指曲线沿单一自变量由上凸转为下凸,或反之的地方。
鞍点至少需要两个变量,因为该概念依赖于在同一点比较不同方向的曲率。一元函数可以有拐点,但不会有鞍点,因为没有第二个方向可以向相反一侧弯曲。
鞍点 vs. 驻点
每个鞍点都是驻点,因为其处梯度为零。但反之不然。驻点只是梯度为零的点——它可以是局部最小值、局部最大值或鞍点。您需要来自 Hessian 或二阶导数判别法的曲率信息来判断是哪一种。
下面用更直观的方式比较它们:
| | 曲率模式 | 与鞍点的关系 |
|---|
| 局部最小值 | 各方向均为正 | 绝非鞍点 |
| 局部最大值 | 各方向均为负 | 绝非鞍点 |
| 拐点 | 沿单一变量的凹凸性变化 | 不同概念,仅需一元 |
| 驻点 | 梯度为零 | 鞍点是驻点的一种 |
鞍点与其他概念的比较
极小极大优化中的鞍点
到目前为止,“鞍点”描述的是临界点的曲率。还有一个更早的含义来自博弈论,在现代机器学习中也会出现。
在极小极大优化中,一方最小化某个函数,而另一方最大化它;鞍点是这样一对取值:任何一方单独改变自己的决策都无法改善自己的结果。
博弈论用它来描述竞争性游戏中的均衡策略。对抗式优化将相同结构借用于一类问题:其中一个过程搜索另一个过程必须防御的最坏情况。
生成式对抗网络(GAN)是机器学习中最好的例子。生成器通过生成逼真的假数据来最小化其损失,而判别器则最大化其区分真伪数据的能力。训练 GAN 就是在这种极小极大意义上寻找一个鞍点,或找到生成器与判别器各自对对方的最佳响应之间的平衡。
这种极小极大鞍点与本文前面所说的临界点鞍点相关,但两者并不能互换。
临界点版本描述的是单个函数在某点的曲率;极小极大版本描述的是两个相互竞争目标之间的均衡。二者使用同一个词,是因为它们都涉及“上”“下”的混合行为,但如果您试图把基于 Hessian 的判别用于双人博弈,混为一谈并无帮助。
处理鞍点的常见错误
多数关于鞍点的困惑可归结为几个反复出现的错误。您需要注意以下几点。
将零梯度等同于最小值
零梯度只说明您找到了一个临界点,而不是它的类型。在宣布完成之前请检查曲率,因为鞍点的梯度同样为零。
只用一阶导数对点进行分类
一阶导数能找到临界点,但不能对其分类。您需要二阶导数,通过 Hessian 或二阶导数判别法,来区分最小值、最大值与鞍点。
忽视不同方向的曲率
一个函数即使沿 x 轴向上弯曲,整体上仍可能是鞍点,只要存在某个向下弯曲的方向。要检查所有方向,或使用 Hessian 的特征值,它们一次性覆盖所有方向。
混淆鞍点与拐点
拐点描述的是单一变量上的曲率变化。鞍点描述的是同一点处跨多个变量的混合曲率。二者在思想上相关,但不适用于相同类型的函数,其数学工具也不可互换。
将“鞍点”的所有用法视为相同
临界点意义上的鞍点与极小极大意义上的鞍点只是同名,非同义。在应用基于 Hessian 的测试或特征值论证之前,请确认当前所指是哪一种——博弈论与对抗式优化使用的是极小极大版本,它不能化约为对单个函数的曲率检查。
结语
鞍点在同一坐标处沿某些方向向上弯曲、沿另一些方向向下弯曲——这就是为什么它既不是最小值也不是最大值,尽管它处的梯度同样为零。
梯度能找到临界点。Hessian 的特征值或二阶导数判别法则告诉您它是哪一种。在高维中,这一区分尤为重要,因为鞍点的数量多于局部最小值;诸如 SGD 和动量等训练算法,部分就是为跨越它们而存在。
最后需要区分的一点是,博弈论和 GAN 中的极小极大鞍点与前者同名但数学不同——请确保您清楚自己在指哪一种。
如果您对鞍点背后的思想感兴趣,您一定会喜欢我们的Python 深度学习系列课程。除了理论,您还将使用 PyTorch 构建适用于不同问题的神经网络。


即使函数的每个偏导数都为零,您也不能保证自己接近一个最小值。
优化就是寻找函数的最小或最大值,而您使用的每种方法都在寻找梯度变平的点。但梯度变平并不保证您找到了最佳答案。有时这意味着函数在同一点上沿某个方向上升、沿另一个方向下降。
这个点称为鞍点,它一方面下降、另一方面上升,并且在其周围是平的。识别鞍点很重要,因为您的算法可能会被困在这里,把平坦的梯度误认为是真正的最小值。
本文将带您从数学上如何识别鞍点,以及为什么它常常让优化算法困惑。
什么是鞍点?
在鞍点处,梯度为零,就像在最小值或最大值处一样。但鞍点既不是最小值,也不是最大值。
函数在同一点上沿某些方向向上弯曲,沿另一些方向向下弯曲。沿一个坐标轴前进,函数值上升;沿另一条坐标轴前进,函数值下降。这也是名称的由来——它借用了马鞍的形状,前后翘起、两侧下凹。
下面用一个简单的二元函数来展示这种形状:
二元函数
在原点
(0, 0)处,两个偏导数都等于零,因此它是一个临界点(也称为驻点)。沿 x 轴移动,f因x^2项而增加。沿 y 轴移动,f因-y^2项而减少。如果将该函数绘制为三维图像,曲面会沿一个方向上拱、沿另一个方向下凹,形成鞍点形状。
f(x, y) = x^2 - y^2 的三维曲面图
同一个函数的等高线图从俯视角度讲述了相同的故事。原点周围的等高线看起来像双曲线,而不是最小值或最大值周围会出现的闭合曲线。
f(x, y) = x^2 - y^2 的等高线图
精确定义会因领域而异。在多元微积分中,鞍点是既不是局部最小也不是局部最大值的临界点。在优化和博弈论中,该术语可能有不同含义,与极小极大问题而非曲率相关。本文后面将讨论这种区别。
鞍点与极小值和极大值的比较
在学习如何用数学方法识别鞍点之前,先看它与另外两类临界点的对比会更有帮助。
局部最小值
在局部最小值处,函数在附近的每个方向上都增加。想象一个碗——从碗底向任意方向迈出一步,都会向上。函数
f(x, y) = x2 + y2就是这样。局部最大值
在局部最大值处,函数在附近的每个方向上都减少。它是最小值的镜像,是一个穹顶而不是一个碗。函数
f(x, y) = -x2 - y2在您远离原点的每个方向上都下降。鞍点
在鞍点处,函数在某些方向上增加,在另一些方向上减少。这正是使
f(x, y) = x2 - y2(上一节的例子)成为鞍点而不是极小或极大的原因:它在同一点沿 x 轴上升、沿 y 轴下降。下图将三者并排比较:
局部最小值、局部最大值与鞍点的三维曲面图并排对比
如何找到鞍点
寻找鞍点归结为求导、找出导数为零的点,然后考察函数在该点附近的弯曲方式。
我将继续使用前面的函数:
参考函数
步骤如下,一步一步来。
1. 计算一阶偏导数
对
f关于x求导,将y视为常数;然后对y做同样的事:计算一阶偏导数
2. 令其等于零
求解两个偏导数同时为零的点:
令导数为零
得到
x = 0和y = 0,所以(0, 0)是一个临界点。仅凭一阶导数无法判断其类型。3. 计算二阶导数
您需要三个:
f_x关于x的导数、f_y关于y的导数,以及混合导数:二阶导数
4. 用曲率对临界点分类
f_xx = 2为正,因此f沿 x 轴向上弯曲。f_yy = -2为负,因此f沿 y 轴向下弯曲。同一点上一方向向上、另一方向向下——这就是鞍点。这四步对任何二次可微函数都适用。
接下来两节将把第 4 步形式化,使用可扩展到两变量以上的工具:Hessian 矩阵与二阶导数判别法。
Hessian 矩阵如何识别鞍点
Hessian 矩阵将上一节中的所有二阶导数放进一个对象中,它是判断临界点是最小值、最大值还是鞍点的工具。
对二元函数,Hessian 形式如下:
二元函数的 Hessian
每个元素描述曲率:
f_xx和f_yy描述沿x与y轴的曲率,f_xy描述这两个方向之间的相互作用。将前一节中的二阶导数代入,我们的示例函数的 Hessian 如下:参考函数的 Hessian
仅有矩阵本身并不能说明太多。关键在于它的特征值——这些数值描述函数沿一组特定方向(称为特征向量)的弯曲情况。
由于示例的 Hessian 是对角矩阵,特征值就在对角线上:
2和-2。它们的特征向量分别沿 x 轴和 y 轴指向,这与您在上一节手动得到的曲率完全一致。因为该方向上的特征值为正,f沿x向上弯曲;因为该方向上的特征值为负,沿y向下弯曲。大多数函数的 Hessian 不是对角的,因此其特征向量不会整齐地与
x和y轴对齐,需要直接求解而不是从矩阵中读出。但只要有一个正特征值和一个负特征值,您就处在鞍点上。鞍点的二阶导数判别法
您不必每次都手动计算特征值。对二元函数,有一个捷径——二阶导数判别法——基于 Hessian 的行列式。
使用相同的二阶导数,行列式为:
行列式
D是 Hessian 的行列式,其符号与f_xx的符号结合可以对临界点分类:D > 0且f_xx > 0:局部最小值D > 0且f_xx < 0:局部最大值D < 0:鞍点D = 0:无法定论对我们的例子,
f_xx = 2、f_yy = -2、f_xy = 0:参考函数的二阶导数判别
D为负,因此该判别确认(0, 0)是鞍点。此判别本质上是上一节特征值规则的改写,以一种无需求特征向量的形式来计算。
D是两个特征值的乘积,f_xx + f_yy是它们的和。当D为负时,特征值必为异号,这正是鞍点。当D为零时,至少有一个特征值为零,该方向的曲率为平坦,此时无论该判别还是特征值本身都无法单独说明该处发生了什么。优化中的鞍点
到目前为止,我们讨论的都是在已知函数的情况下如何识别鞍点。但在优化中,您是在未知最优点在哪里的情况下进行搜索,基于梯度的方法用梯度为零来决定何时停止。
这恰恰是鞍点惹麻烦的地方。
基于梯度的优化器沿使目标函数最快下降的方向移动,直到梯度接近零为止。但接近零的梯度并不会告诉算法它找到的是最小值还是鞍点。
正曲率的方向会把函数值推高,算法已经“学会”了朝这些方向迈步会变糟。负曲率的方向仍然存在,而且是出路——但只信任梯度的算法可能会错过它们,因为在鞍点处,这些方向上的梯度也接近零。
这也会让优化变慢。
当您接近任何驻点时,梯度的大小往往会收缩,因此把步长与梯度大小挂钩的算法在鞍点附近会迈出很小的步子,不管它是否接近真正要找的最小值。
找到一个驻点并不等于完成了优化。您仍需要一种方法来判断接近零的梯度属于鞍点而不是最小值,并在识别后找到继续改进目标的方向。
机器学习中的鞍点
神经网络的损失函数取决于网络中的每个权重和偏置,维度有时达到数百万或数十亿。这与二元的玩具例子相去甚远。
在对高维非凸优化的分析中,Dauphin 及其同事指出,随着维度数量增加,临界点远比局部极小或极大更可能是鞍点。每个维度都会新增一个曲率可正可负的方向,而仅需一个负曲率方向就能把临界点从最小值变成鞍点。
这对训练很重要,因为梯度下降只能“看到”当前所处位置的梯度。
在鞍点附近,各个方向的梯度都会变小——这与接近真实最小值时看到的信号相同。训练可能会在并非最优的区域变慢或停滞,且仅凭损失曲线无法判断您是在最小值附近还是卡在鞍点上。
这也是为什么人们在谈神经网络训练时,鞍点常与局部最小值一起出现。但它们并非唯一的障碍。梯度消失、病态曲率以及搜索空间的尺度都会让高维优化变得困难。
优化算法如何处理鞍点
这并不意味着基于梯度的训练在鞍点附近就注定失败。有几种技术可以从不同角度帮助您穿越它们。
随机梯度下降
随机梯度下降用训练数据的随机子集而不是整个数据集来计算梯度,并且每一步的子集都会变化。
这种噪声意味着估计的梯度很少会恰好为零,即使在真实梯度接近零的区域也是如此。这种噪声足以把优化器从鞍点推开,进入负曲率方向,而不是恰恰在梯度消失处停滞。
动量
动量会保留过去梯度的滑动平均,并用它(而不仅仅是当前梯度)来决定下一步。
在鞍点附近,这很关键,因为优化器到达时已经在某个方向上“动”起来了,由先前的梯度推动。这种累积的动量可以带它穿过鞍点周围的平坦区域,而不是在局部梯度接近零的那一刻就减速。
二阶方法
二阶方法直接利用曲率信息。
通过使用 Hessian 或其近似,这些方法能够在临界点分辨正曲率与负曲率的方向。这正是鞍点所依赖的区别,因此二阶方法可以识别下降方向并朝其迈步,而不是把所有接近零的梯度一概而论。
鞍点与相关概念
有一些术语经常与鞍点混淆,值得澄清。
鞍点 vs. 局部最小值
局部最小值在其附近每个方向上都向上弯曲,即周围各向的一致正曲率。鞍点只在某些方向上向上弯曲,而在另一些方向上向下弯曲。一旦发现哪怕一个负曲率方向,您看到的就不再是最小值。
鞍点 vs. 局部最大值
对于局部最大值,逻辑正好相反。它在附近每个方向上的曲率都为负。鞍点则在这些负曲率方向之外,至少增加了一个正曲率方向。
鞍点 vs. 拐点
拐点是一维概念。它是指曲线沿单一自变量由上凸转为下凸,或反之的地方。
鞍点至少需要两个变量,因为该概念依赖于在同一点比较不同方向的曲率。一元函数可以有拐点,但不会有鞍点,因为没有第二个方向可以向相反一侧弯曲。
鞍点 vs. 驻点
每个鞍点都是驻点,因为其处梯度为零。但反之不然。驻点只是梯度为零的点——它可以是局部最小值、局部最大值或鞍点。您需要来自 Hessian 或二阶导数判别法的曲率信息来判断是哪一种。
下面用更直观的方式比较它们:
鞍点与其他概念的比较
极小极大优化中的鞍点
到目前为止,“鞍点”描述的是临界点的曲率。还有一个更早的含义来自博弈论,在现代机器学习中也会出现。
在极小极大优化中,一方最小化某个函数,而另一方最大化它;鞍点是这样一对取值:任何一方单独改变自己的决策都无法改善自己的结果。
博弈论用它来描述竞争性游戏中的均衡策略。对抗式优化将相同结构借用于一类问题:其中一个过程搜索另一个过程必须防御的最坏情况。
生成式对抗网络(GAN)是机器学习中最好的例子。生成器通过生成逼真的假数据来最小化其损失,而判别器则最大化其区分真伪数据的能力。训练 GAN 就是在这种极小极大意义上寻找一个鞍点,或找到生成器与判别器各自对对方的最佳响应之间的平衡。
这种极小极大鞍点与本文前面所说的临界点鞍点相关,但两者并不能互换。
临界点版本描述的是单个函数在某点的曲率;极小极大版本描述的是两个相互竞争目标之间的均衡。二者使用同一个词,是因为它们都涉及“上”“下”的混合行为,但如果您试图把基于 Hessian 的判别用于双人博弈,混为一谈并无帮助。
处理鞍点的常见错误
多数关于鞍点的困惑可归结为几个反复出现的错误。您需要注意以下几点。
将零梯度等同于最小值
零梯度只说明您找到了一个临界点,而不是它的类型。在宣布完成之前请检查曲率,因为鞍点的梯度同样为零。
只用一阶导数对点进行分类
一阶导数能找到临界点,但不能对其分类。您需要二阶导数,通过 Hessian 或二阶导数判别法,来区分最小值、最大值与鞍点。
忽视不同方向的曲率
一个函数即使沿 x 轴向上弯曲,整体上仍可能是鞍点,只要存在某个向下弯曲的方向。要检查所有方向,或使用 Hessian 的特征值,它们一次性覆盖所有方向。
混淆鞍点与拐点
拐点描述的是单一变量上的曲率变化。鞍点描述的是同一点处跨多个变量的混合曲率。二者在思想上相关,但不适用于相同类型的函数,其数学工具也不可互换。
将“鞍点”的所有用法视为相同
临界点意义上的鞍点与极小极大意义上的鞍点只是同名,非同义。在应用基于 Hessian 的测试或特征值论证之前,请确认当前所指是哪一种——博弈论与对抗式优化使用的是极小极大版本,它不能化约为对单个函数的曲率检查。
结语
鞍点在同一坐标处沿某些方向向上弯曲、沿另一些方向向下弯曲——这就是为什么它既不是最小值也不是最大值,尽管它处的梯度同样为零。
梯度能找到临界点。Hessian 的特征值或二阶导数判别法则告诉您它是哪一种。在高维中,这一区分尤为重要,因为鞍点的数量多于局部最小值;诸如 SGD 和动量等训练算法,部分就是为跨越它们而存在。
最后需要区分的一点是,博弈论和 GAN 中的极小极大鞍点与前者同名但数学不同——请确保您清楚自己在指哪一种。
如果您对鞍点背后的思想感兴趣,您一定会喜欢我们的Python 深度学习系列课程。除了理论,您还将使用 PyTorch 构建适用于不同问题的神经网络。