Auch wenn jede partielle Ableitung deiner Funktion null ist, bist du noch lange nicht zwingend in der Nähe eines Minimums.
Optimierung sucht nach dem kleinsten oder größten Funktionswert, und jede Methode fahndet nach einer Stelle mit flachem Gradienten. Aber ein flacher Gradient garantiert nicht die beste Lösung. Manchmal steigt die Funktion in eine Richtung und fällt in eine andere – genau am selben Punkt.
Dieser Punkt heißt Sattelpunkt: In die eine Richtung geht es bergab, in die andere bergauf, und rundherum ist es flach. Sattelpunkte zu erkennen ist wichtig, weil dein Algorithmus dort hängenbleiben und den flachen Gradienten mit einem echten Minimum verwechseln kann.
In diesem Artikel zeige ich dir, wie du einen Sattelpunkt mathematisch erkennst und warum er Optimierungsalgorithmen oft in die Irre führt.
Was ist ein Sattelpunkt?
Am Sattelpunkt ist der Gradient null – genau wie an einem Minimum oder Maximum. Trotzdem ist ein Sattelpunkt weder das eine noch das andere.
Die Funktion krümmt sich in manchen Richtungen nach oben und in anderen nach unten, und das am selben Punkt. Gehst du entlang einer Achse, steigt der Funktionswert, entlang einer anderen fällt er. Daher der Name: Er kommt von der Form eines Pferdesattels, der sich nach vorn und hinten anhebt und zu den Seiten hin abfällt.
Hier ist eine einfache zweidimensionale Funktion als Beispiel:
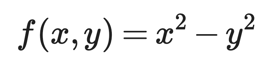
Zweidimensionale Funktion
Am Ursprung (0, 0) sind beide partiellen Ableitungen null – es ist also ein kritischer Punkt (auch stationärer Punkt). Bewegst du dich entlang der x-Achse, steigt f wegen des Terms x^2. Entlang der y-Achse fällt f wegen des Terms -y^2.
In einem 3D-Plot krümmt sich die Fläche in die eine Richtung nach oben und in die andere nach unten – genau die typische Sattelform.
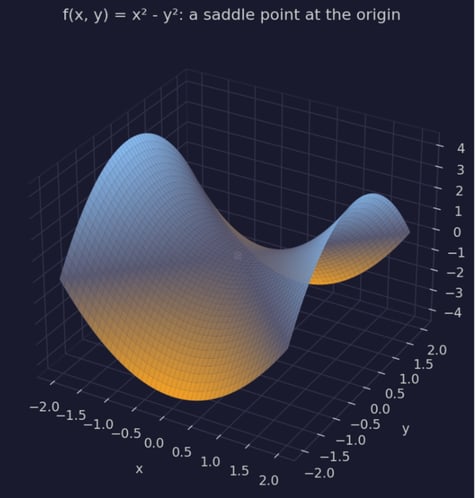
3D-Flächenplot von f(x, y) = x^2 - y^2
Ein Konturplot derselben Funktion erzählt aus der Vogelperspektive das Gleiche. Die Konturlinien um den Ursprung sind Hyperbeln – keine geschlossenen Schleifen wie um ein Minimum oder Maximum.
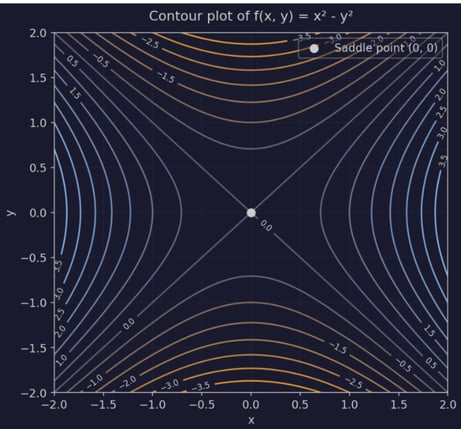
Konturplot von f(x, y) = x^2 - y^2
Die exakte Definition variiert je nach Fachgebiet. In der mehrdimensionalen Analysis ist ein Sattelpunkt ein kritischer Punkt, der weder lokales Minimum noch lokales Maximum ist. In der Optimierung und Spieltheorie kann der Begriff etwas anderes bedeuten und ist eher an Minimax-Probleme als an Krümmung gekoppelt. Auf diesen Unterschied komme ich später zurück.
Sattelpunkte vs. Minima und Maxima
Bevor wir klären, wie man Sattelpunkte mathematisch erkennt, hilft der Vergleich mit den beiden anderen Arten kritischer Punkte.
Lokales Minimum
An einem lokalen Minimum steigt die Funktion in jeder nahegelegenen Richtung. Stell dir eine Schüssel vor – jeder Schritt vom tiefsten Punkt geht nach oben. Die Funktion f(x, y) = x2 + y2 verhält sich so.
Lokales Maximum
An einem lokalen Maximum fällt die Funktion in jeder Richtung. Es ist das Spiegelbild eines Minimums – eher eine Kuppel als eine Schüssel. Die Funktion f(x, y) = -x2 - y2 fällt in jede Richtung, wenn du dich vom Ursprung entfernst.
Sattelpunkt
Am Sattelpunkt steigt die Funktion in manchen Richtungen und fällt in anderen. Genau das macht f(x, y) = x2 - y2, das Beispiel von oben, zu einem Sattelpunkt statt zu einem Minimum oder Maximum: Entlang der x-Achse geht es nach oben, entlang der y-Achse nach unten – am selben Punkt.
So sehen die drei Fälle nebeneinander aus:
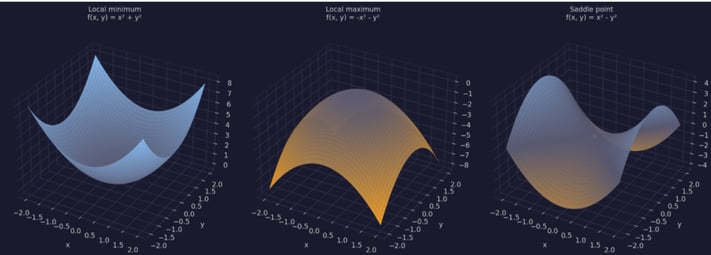
3D-Flächenplots von lokalem Minimum, lokalem Maximum und Sattelpunkt im Vergleich
So findest du einen Sattelpunkt
Einen Sattelpunkt findest du, indem du die Ableitungen berechnest, ihre gemeinsamen Nullstellen bestimmst und dann prüfst, wie sich die Funktion um diesen Punkt krümmt.
Ich verwende wieder die Funktion von oben:
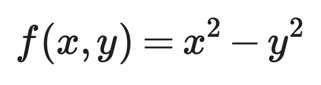
Referenzfunktion
So gehst du Schritt für Schritt vor.
1. Erste partielle Ableitungen berechnen
Bilde die Ableitung von f nach x (mit y als Konstante) und dann die von f nach y:
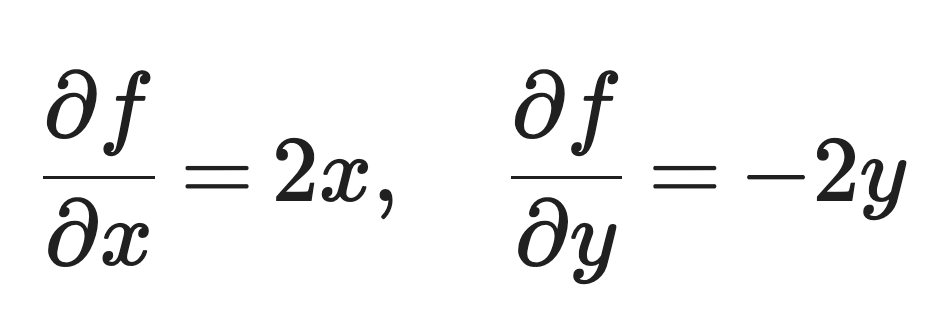
Erste partielle Ableitungen
2. Gleich null setzen
Bestimme den Punkt, an dem beide partiellen Ableitungen gleichzeitig verschwinden:
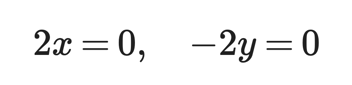
Ableitungen null setzen
Das ergibt x = 0 und y = 0, also ist (0, 0) ein kritischer Punkt. Welche Art, verraten dir die ersten Ableitungen noch nicht.
3. Zweite Ableitungen berechnen
Du brauchst drei: die Ableitung von f_x nach x, die Ableitung von f_y nach y sowie die gemischte Ableitung:
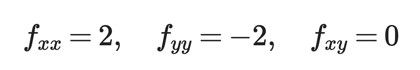
Zweite Ableitungen
4. Den kritischen Punkt über die Krümmung klassifizieren
f_xx = 2 ist positiv, also krümmt sich f entlang der x-Achse nach oben. f_yy = -2 ist negativ, also krümmt sich f entlang der y-Achse nach unten. Eine Richtung krümmt nach oben, die andere nach unten – genau das ist der Sattelpunkt.
Dieses Vier-Schritte-Vorgehen funktioniert für jede zweimal differenzierbare Funktion.
In den nächsten zwei Abschnitten formalisieren wir Schritt 4 mit Werkzeugen, die über zwei Variablen hinaus skalieren: der Hesse-Matrix und dem Test mit den zweiten Ableitungen.
Wie die Hesse-Matrix Sattelpunkte erkennt
Die Hesse-Matrix fasst alle zweiten Ableitungen aus dem letzten Abschnitt in einem Objekt zusammen. Sie zeigt dir, ob ein kritischer Punkt ein Minimum, ein Maximum oder ein Sattel ist.
Für eine zweidimensionale Funktion sieht die Hesse-Matrix so aus:
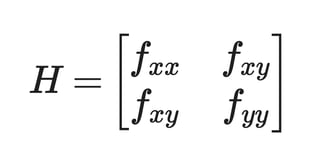
Hesse-Matrix für eine zweidimensionale Funktion
Jeder Eintrag beschreibt Krümmung: f_xx und f_yy die Krümmung entlang der x- und y-Achse, und f_xy das Zusammenspiel der beiden Richtungen. Setzt du die zweiten Ableitungen aus dem Beispiel von oben ein, erhältst du für unsere Funktion diese Hesse-Matrix:
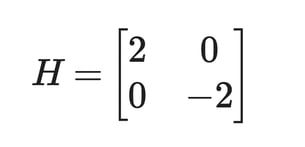
Hesse-Matrix der Referenzfunktion
Eine Matrix allein sagt noch wenig. Entscheidend sind ihre Eigenwerte – sie beschreiben, wie sich die Funktion entlang spezieller Richtungen (Eigenvektoren) krümmt.
- Ein positiver Eigenwert bedeutet: Die Funktion krümmt sich entlang der Richtung ihres Eigenvektors nach oben.
- Ein negativer Eigenwert bedeutet: Die Funktion krümmt sich entlang dieser Richtung nach unten.
- Eine Mischung aus positiven und negativen Eigenwerten bedeutet: Manche Richtungen krümmen nach oben, andere nach unten (Sattelpunkt).
Weil die Hesse-Matrix unseres Beispiels diagonal ist, stehen die Eigenwerte auf der Diagonale: 2 und -2. Die zugehörigen Eigenvektoren zeigen entlang der x- und y-Achse – genau die Krümmung, die du oben von Hand gefunden hast. f krümmt sich entlang x nach oben (positiver Eigenwert) und entlang y nach unten (negativer Eigenwert).
Die meisten Funktionen haben keine diagonale Hesse-Matrix, die Eigenvektoren liegen also nicht sauber auf den x- und y-Achsen. Dann musst du sie bestimmen statt sie aus der Matrix abzulesen. Aber: Ein positiver und ein negativer Eigenwert heißt, du stehst auf einem Sattelpunkt.
Der Test mit den zweiten Ableitungen für Sattelpunkte
Du musst nicht jedes Mal Eigenwerte per Hand berechnen. Für zweidimensionale Funktionen gibt es eine Abkürzung – den Test mit den zweiten Ableitungen – basierend auf der Determinante der Hesse-Matrix.
Hier die Determinante mit denselben zweiten Ableitungen wie oben:
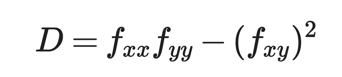
Die Determinante
D ist die Determinante der Hesse-Matrix. Ihr Vorzeichen – zusammen mit dem Vorzeichen von f_xx – klassifiziert den kritischen Punkt:
Für unser Beispiel gilt f_xx = 2, f_yy = -2 und f_xy = 0:
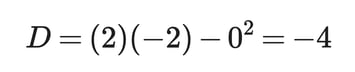
Test mit den zweiten Ableitungen für die Referenzfunktion
D ist negativ, also bestätigt der Test: (0, 0) ist ein Sattelpunkt.
Dieser Test ist die Eigenwertregel aus dem vorigen Abschnitt, nur in einer Form, die du ohne Eigenvektoren berechnen kannst. D ist das Produkt der beiden Eigenwerte, und f_xx + f_yy ihre Summe. Wenn D negativ ist, müssen die Eigenwerte entgegengesetzte Vorzeichen tragen – genau das definiert einen Sattelpunkt. Wenn D null ist, ist mindestens ein Eigenwert null – die Krümmung in dieser Richtung ist flach, und weder der Test noch die Eigenwerte allein klären die Lage.
Sattelpunkte in der Optimierung
Bisher ging es darum, einen Sattelpunkt zu erkennen, wenn die Funktion schon vorliegt. In der Optimierung suchst du jedoch die beste Stelle, ohne sie vorher zu kennen, und gradientenbasierte Verfahren nutzen einen verschwindenden Gradient als Stoppkriterium.
Genau hier machen Sattelpunkte Probleme.
Ein gradientenbasierter Optimierer geht in die Richtung des schnellsten Abstiegs der Zielfunktion und läuft weiter, bis der Gradient nahe null ist. Aber ein nahezu verschwindender Gradient verrät dem Algorithmus nicht, ob er ein Minimum oder einen Sattelpunkt gefunden hat.
Richtungen mit positiver Krümmung treiben den Funktionswert nach oben – der Algorithmus hat bereits gelernt, dass Schritte dorthin schaden. Richtungen mit negativer Krümmung existieren weiterhin und sind der Ausweg – doch ein Algorithmus, der nur dem Gradienten traut, kann sie übersehen, weil direkt am Sattelpunkt auch dort der Gradient nahezu null ist.
Das bremst die Optimierung zusätzlich aus.
Die Gradienten-Norm schrumpft typischerweise in der Nähe jedes stationären Punkts. Skaliert ein Algorithmus seine Schrittweite mit der Gradientenstärke, macht er in der Nähe eines Sattels kleine Schritte – egal, ob er dem gesuchten Minimum tatsächlich nahe ist oder nicht.
Einen stationären Punkt zu finden, ist also nicht gleichbedeutend mit einer gelösten Optimierung. Du brauchst ein Kriterium, um einen nahezu verschwindenden Gradient als Sattelpunkt statt als Minimum zu erkennen – und einen Weg, die absteigende Richtung zu finden, sobald du das weißt.
Sattelpunkte im Machine Learning
Die Verlustfunktion eines neuronalen Netzes hängt von allen Gewichten und Biases ab – oft mit Millionen oder Milliarden Dimensionen. Das ist weit entfernt vom Zweivariablen-Spielzeugbeispiel.
In einer Analyse hochdimensionaler, nichtkonvexer Optimierung argumentieren Dauphin und Kolleginnen/Kollegen, dass mit wachsender Dimension kritische Punkte viel häufiger Sattelpunkte sind als lokale Minima oder Maxima. Jede zusätzliche Dimension bringt eine weitere Richtung mit, in der die Krümmung in beide Vorzeichen gehen kann – und eine einzige Richtung mit negativer Krümmung reicht, um einen kritischen Punkt zum Sattel statt zum Minimum zu machen.
Das ist fürs Training relevant, weil Gradientenabstieg nur den aktuellen Gradienten sieht.
In der Nähe eines Sattelpunkts wird der Gradient in alle Richtungen klein – genau das Signal, das du auch beim Annähern an ein echtes Minimum siehst. Das Training kann sich verlangsamen oder in einer Region festfahren, die gar nicht optimal ist – und aus der Loss-Kurve allein ist nicht ersichtlich, ob du in der Nähe eines Minimums bist oder auf einem Sattel hängst.
Deshalb tauchen Sattelpunkte bei Gesprächen über das Training neuronaler Netze so oft neben lokalen Minima auf. Sie sind aber nicht das einzige Hindernis: Verschwindende Gradienten, schlecht konditionierte Krümmung und die Größe des Suchraums erschweren hochdimensionale Optimierung generell.
Wie Optimierungsalgorithmen mit Sattelpunkten umgehen
All das bedeutet nicht, dass gradientenbasiertes Training an Sattelpunkten scheitert. Es gibt mehrere Ansätze, die dich hindurchführen – jeweils aus einem anderen Blickwinkel.
Stochastischer Gradientenabstieg
Stochastic Gradient Descent berechnet den Gradienten aus einem zufälligen Teil des Trainingsdatensatzes – und dieser Teil ändert sich in jedem Schritt.
Das dabei entstehende Rauschen sorgt dafür, dass der geschätzte Gradient selten exakt null ist – selbst in Regionen, wo der wahre Gradient nahe null liegt. Dieses Rauschen kann den Optimierer vom Sattel weg in eine Richtung negativer Krümmung schieben, statt genau dort zu verharren, wo der Gradient verschwindet.
Momentum
Momentum bildet einen gleitenden Mittelwert vergangener Gradienten und nutzt diesen statt nur des aktuellen für den nächsten Schritt.
In der Nähe eines Sattelpunkts ist das hilfreich, weil der Optimierer bereits mit einer gewissen Geschwindigkeit ankommt – getragen von früheren Gradienten. Diese aufgestaute Bewegung kann ihn durch die flache Region um den Sattel tragen, statt sofort abzubremsen, sobald der lokale Gradient gegen null geht.
Methoden zweiter Ordnung
Methoden zweiter Ordnung nutzen Krümmungsinformation direkt.
Über die Hesse-Matrix oder ihre Approximation unterscheiden sie an einem kritischen Punkt zwischen Richtungen positiver und negativer Krümmung. Genau auf diesem Unterschied beruht der Sattelpunkt – eine Methode zweiter Ordnung kann also die absteigende Richtung identifizieren und hineinschreiten, statt jeden nahezu verschwindenden Gradient gleich zu behandeln.
Sattelpunkte vs. verwandte Konzepte
Einige Begriffe werden oft mit Sattelpunkten verwechselt – hier die wichtigsten Abgrenzungen.
Sattelpunkt vs. lokales Minimum
Ein lokales Minimum krümmt sich in jeder Richtung in seiner Nähe nach oben – also durchgehend positive Krümmung. Ein Sattelpunkt krümmt sich nur in einigen Richtungen nach oben, in anderen nach unten. Findest du auch nur eine Richtung mit negativer Krümmung, ist es kein Minimum mehr.
Sattelpunkt vs. lokales Maximum
Analog dazu beim lokalen Maximum: Die Krümmung bleibt in jeder Richtung negativ. Ein Sattelpunkt bringt mindestens eine Richtung positiver Krümmung zusätzlich zu den negativen mit.
Sattelpunkt vs. Wendepunkt
Ein Wendepunkt ist ein eindimensionaler Begriff: Dort wechselt eine Kurve entlang einer einzelnen Variablen von konkav nach konvex oder umgekehrt.
Ein Sattelpunkt braucht mindestens zwei Variablen, weil es um Krümmungsvergleiche in unterschiedlichen Richtungen am selben Punkt geht. Eine eindimensionale Funktion kann einen Wendepunkt haben, aber keinen Sattelpunkt – es fehlt die zweite Richtung.
Sattelpunkt vs. stationärer Punkt
Jeder Sattelpunkt ist ein stationärer Punkt, weil dort der Gradient null ist. Umgekehrt gilt das nicht: Ein stationärer Punkt ist jeder Punkt mit Gradienten null – er kann ein lokales Minimum, ein lokales Maximum oder ein Sattelpunkt sein. Welche Art vorliegt, verraten Hesse-Matrix oder der Test mit den zweiten Ableitungen.
Hier ist eine visuelle Übersicht zum Vergleich:
| | Krümmungsmuster | Bezug zu Sattelpunkten |
|---|
| Lokales Minimum | Positiv in jede Richtung | Niemals ein Sattelpunkt |
| Lokales Maximum | Negativ in jede Richtung | Niemals ein Sattelpunkt |
| Wendepunkt | Krümmungswechsel entlang einer Variablen | Anderes Konzept, benötigt nur eine Variable |
| Stationärer Punkt | Gradient ist null | Ein Sattelpunkt ist ein Typ stationärer Punkt |
Sattelpunkte im Vergleich zu anderen Konzepten
Sattelpunkte in der Minimax-Optimierung
Bisher stand „Sattelpunkt“ für die Krümmung an einem kritischen Punkt. Es gibt eine zweite, ältere Bedeutung aus der Spieltheorie, die auch im modernen Machine Learning vorkommt.
In der Minimax-Optimierung minimiert ein Akteur eine Funktion, während ein anderer sie maximiert. Ein Sattelpunkt ist das Wertepaar, an dem keiner der beiden seine eigene Entscheidung ändern kann, ohne sich zu verschlechtern.
Die Spieltheorie beschreibt damit Gleichgewichtsstrategien in kompetitiven Spielen. Adversarielle Optimierung überträgt die Struktur auf Probleme, in denen ein Prozess den schlimmsten Fall sucht, gegen den ein anderer Prozess bestehen muss.
Generative Adversarial Networks (GANs) sind das prominenteste ML-Beispiel: Ein Generator minimiert seinen Verlust, indem er überzeugende Fakes erzeugt, während ein Diskriminator seine Fähigkeit maximiert, echte von falschen Daten zu unterscheiden. Das Training eines GANs sucht nach einem Sattelpunkt im Minimax-Sinn – einem Gleichgewicht, in dem Generator und Diskriminator jeweils die beste Antwort auf den anderen gefunden haben.
Dieser Minimax-Sattelpunkt ist mit dem Sattelpunkt als kritischem Punkt verwandt, aber nicht austauschbar.
Die kritische Variante beschreibt die Krümmung an einem Punkt einer einzigen Funktion. Die Minimax-Variante beschreibt ein Gleichgewicht zwischen zwei konkurrierenden Zielen. Beide nutzen dasselbe Wort, weil es jeweils um „hoch“ und „runter“ geht – aber die Gleichsetzung hilft nicht weiter, wenn du versuchst, einen Hessian-Test auf ein Zweipersonenspiel anzuwenden.
Häufige Fehler im Umgang mit Sattelpunkten
Die meiste Verwirrung rund um Sattelpunkte geht auf ein paar wiederkehrende Fehler zurück. Das solltest du beachten.
Annehmen, dass ein nuller Gradient ein Minimum bedeutet
Ein nuller Gradient sagt nur, dass du einen kritischen Punkt gefunden hast – nicht welchen. Prüfe die Krümmung, bevor du den Haken dransetzt, denn auch ein Sattelpunkt hat einen nullen Gradient.
Klassifikation nur mit ersten Ableitungen
Erste Ableitungen finden kritische Punkte, können sie aber nicht klassifizieren. Dafür brauchst du die zweiten Ableitungen – über die Hesse-Matrix oder den Test mit den zweiten Ableitungen –, um Minimum, Maximum und Sattelpunkt zu unterscheiden.
Unterschiedliche Krümmungsrichtungen ignorieren
Eine Funktion kann sich entlang der x-Achse nach oben krümmen und trotzdem insgesamt ein Sattelpunkt sein, wenn eine andere Richtung nach unten krümmt. Prüfe alle Richtungen – oder nutze die Eigenwerte der Hesse-Matrix, die alle Richtungen auf einmal abdecken.
Sattelpunkte mit Wendepunkten verwechseln
Ein Wendepunkt beschreibt eine Krümmungsänderung in einer einzelnen Variablen. Ein Sattelpunkt beschreibt gemischte Krümmung über mehrere Variablen am selben Ort. Sie sind vom Grundgedanken verwandt, gelten aber nicht für denselben Funktionstyp, und die zugrunde liegende Mathematik ist nicht austauschbar.
Alle Bedeutungen von „Sattelpunkt“ gleichsetzen
Der Sattelpunkt als kritischer Punkt und der Minimax-Sattelpunkt teilen sich nur den Namen, nicht die Definition. Bevor du einen Hessian-basierten Test oder ein Eigenwert-Argument anwendest, prüfe die tatsächliche Bedeutung – Spieltheorie und adversarielle Optimierung nutzen die Minimax-Variante, und die lässt sich nicht auf eine Krümmungsprüfung einer einzelnen Funktion reduzieren.
Fazit
Ein Sattelpunkt krümmt sich in manchen Richtungen nach oben und in anderen nach unten – am selben Ort. Deshalb ist er weder Minimum noch Maximum, obwohl der Gradient dort wie bei beiden gegen null geht.
Gradienten finden den kritischen Punkt. Die Eigenwerte der Hesse-Matrix oder der Test mit den zweiten Ableitungen sagen dir, welche Art es ist. In hohen Dimensionen ist dieser Unterschied essenziell, weil Sattelpunkte lokale Minima zahlenmäßig übertreffen – und Trainingsalgorithmen wie SGD und Momentum existieren auch, um sie zu überwinden.
Wichtig ist außerdem, den Minimax-Sattelpunkt aus Spieltheorie und GANs begrifflich zu trennen – der Name ist derselbe, die Mathematik dahinter nicht.
Wenn dich die Idee hinter Sattelpunkten interessiert, wird dir unser Deep Learning Track in Python gefallen. Neben der Theorie baust du mit PyTorch neuronale Netze für verschiedene Problemstellungen.







Auch wenn jede partielle Ableitung deiner Funktion null ist, bist du noch lange nicht zwingend in der Nähe eines Minimums.
Optimierung sucht nach dem kleinsten oder größten Funktionswert, und jede Methode fahndet nach einer Stelle mit flachem Gradienten. Aber ein flacher Gradient garantiert nicht die beste Lösung. Manchmal steigt die Funktion in eine Richtung und fällt in eine andere – genau am selben Punkt.
Dieser Punkt heißt Sattelpunkt: In die eine Richtung geht es bergab, in die andere bergauf, und rundherum ist es flach. Sattelpunkte zu erkennen ist wichtig, weil dein Algorithmus dort hängenbleiben und den flachen Gradienten mit einem echten Minimum verwechseln kann.
In diesem Artikel zeige ich dir, wie du einen Sattelpunkt mathematisch erkennst und warum er Optimierungsalgorithmen oft in die Irre führt.
Was ist ein Sattelpunkt?
Am Sattelpunkt ist der Gradient null – genau wie an einem Minimum oder Maximum. Trotzdem ist ein Sattelpunkt weder das eine noch das andere.
Die Funktion krümmt sich in manchen Richtungen nach oben und in anderen nach unten, und das am selben Punkt. Gehst du entlang einer Achse, steigt der Funktionswert, entlang einer anderen fällt er. Daher der Name: Er kommt von der Form eines Pferdesattels, der sich nach vorn und hinten anhebt und zu den Seiten hin abfällt.
Hier ist eine einfache zweidimensionale Funktion als Beispiel:
Zweidimensionale Funktion
Am Ursprung
(0, 0)sind beide partiellen Ableitungen null – es ist also ein kritischer Punkt (auch stationärer Punkt). Bewegst du dich entlang der x-Achse, steigtfwegen des Termsx^2. Entlang der y-Achse fälltfwegen des Terms-y^2.In einem 3D-Plot krümmt sich die Fläche in die eine Richtung nach oben und in die andere nach unten – genau die typische Sattelform.
3D-Flächenplot von f(x, y) = x^2 - y^2
Ein Konturplot derselben Funktion erzählt aus der Vogelperspektive das Gleiche. Die Konturlinien um den Ursprung sind Hyperbeln – keine geschlossenen Schleifen wie um ein Minimum oder Maximum.
Konturplot von f(x, y) = x^2 - y^2
Die exakte Definition variiert je nach Fachgebiet. In der mehrdimensionalen Analysis ist ein Sattelpunkt ein kritischer Punkt, der weder lokales Minimum noch lokales Maximum ist. In der Optimierung und Spieltheorie kann der Begriff etwas anderes bedeuten und ist eher an Minimax-Probleme als an Krümmung gekoppelt. Auf diesen Unterschied komme ich später zurück.
Sattelpunkte vs. Minima und Maxima
Bevor wir klären, wie man Sattelpunkte mathematisch erkennt, hilft der Vergleich mit den beiden anderen Arten kritischer Punkte.
Lokales Minimum
An einem lokalen Minimum steigt die Funktion in jeder nahegelegenen Richtung. Stell dir eine Schüssel vor – jeder Schritt vom tiefsten Punkt geht nach oben. Die Funktion
f(x, y) = x2 + y2verhält sich so.Lokales Maximum
An einem lokalen Maximum fällt die Funktion in jeder Richtung. Es ist das Spiegelbild eines Minimums – eher eine Kuppel als eine Schüssel. Die Funktion
f(x, y) = -x2 - y2fällt in jede Richtung, wenn du dich vom Ursprung entfernst.Sattelpunkt
Am Sattelpunkt steigt die Funktion in manchen Richtungen und fällt in anderen. Genau das macht
f(x, y) = x2 - y2, das Beispiel von oben, zu einem Sattelpunkt statt zu einem Minimum oder Maximum: Entlang der x-Achse geht es nach oben, entlang der y-Achse nach unten – am selben Punkt.So sehen die drei Fälle nebeneinander aus:
3D-Flächenplots von lokalem Minimum, lokalem Maximum und Sattelpunkt im Vergleich
So findest du einen Sattelpunkt
Einen Sattelpunkt findest du, indem du die Ableitungen berechnest, ihre gemeinsamen Nullstellen bestimmst und dann prüfst, wie sich die Funktion um diesen Punkt krümmt.
Ich verwende wieder die Funktion von oben:
Referenzfunktion
So gehst du Schritt für Schritt vor.
1. Erste partielle Ableitungen berechnen
Bilde die Ableitung von
fnachx(mityals Konstante) und dann die vonfnachy:Erste partielle Ableitungen
2. Gleich null setzen
Bestimme den Punkt, an dem beide partiellen Ableitungen gleichzeitig verschwinden:
Ableitungen null setzen
Das ergibt
x = 0undy = 0, also ist(0, 0)ein kritischer Punkt. Welche Art, verraten dir die ersten Ableitungen noch nicht.3. Zweite Ableitungen berechnen
Du brauchst drei: die Ableitung von
f_xnachx, die Ableitung vonf_ynachysowie die gemischte Ableitung:Zweite Ableitungen
4. Den kritischen Punkt über die Krümmung klassifizieren
f_xx = 2ist positiv, also krümmt sichfentlang der x-Achse nach oben.f_yy = -2ist negativ, also krümmt sichfentlang der y-Achse nach unten. Eine Richtung krümmt nach oben, die andere nach unten – genau das ist der Sattelpunkt.Dieses Vier-Schritte-Vorgehen funktioniert für jede zweimal differenzierbare Funktion.
In den nächsten zwei Abschnitten formalisieren wir Schritt 4 mit Werkzeugen, die über zwei Variablen hinaus skalieren: der Hesse-Matrix und dem Test mit den zweiten Ableitungen.
Wie die Hesse-Matrix Sattelpunkte erkennt
Die Hesse-Matrix fasst alle zweiten Ableitungen aus dem letzten Abschnitt in einem Objekt zusammen. Sie zeigt dir, ob ein kritischer Punkt ein Minimum, ein Maximum oder ein Sattel ist.
Für eine zweidimensionale Funktion sieht die Hesse-Matrix so aus:
Hesse-Matrix für eine zweidimensionale Funktion
Jeder Eintrag beschreibt Krümmung:
f_xxundf_yydie Krümmung entlang derx- undy-Achse, undf_xydas Zusammenspiel der beiden Richtungen. Setzt du die zweiten Ableitungen aus dem Beispiel von oben ein, erhältst du für unsere Funktion diese Hesse-Matrix:Hesse-Matrix der Referenzfunktion
Eine Matrix allein sagt noch wenig. Entscheidend sind ihre Eigenwerte – sie beschreiben, wie sich die Funktion entlang spezieller Richtungen (Eigenvektoren) krümmt.
Weil die Hesse-Matrix unseres Beispiels diagonal ist, stehen die Eigenwerte auf der Diagonale:
2und-2. Die zugehörigen Eigenvektoren zeigen entlang der x- und y-Achse – genau die Krümmung, die du oben von Hand gefunden hast.fkrümmt sich entlangxnach oben (positiver Eigenwert) und entlangynach unten (negativer Eigenwert).Die meisten Funktionen haben keine diagonale Hesse-Matrix, die Eigenvektoren liegen also nicht sauber auf den
x- undy-Achsen. Dann musst du sie bestimmen statt sie aus der Matrix abzulesen. Aber: Ein positiver und ein negativer Eigenwert heißt, du stehst auf einem Sattelpunkt.Der Test mit den zweiten Ableitungen für Sattelpunkte
Du musst nicht jedes Mal Eigenwerte per Hand berechnen. Für zweidimensionale Funktionen gibt es eine Abkürzung – den Test mit den zweiten Ableitungen – basierend auf der Determinante der Hesse-Matrix.
Hier die Determinante mit denselben zweiten Ableitungen wie oben:
Die Determinante
Dist die Determinante der Hesse-Matrix. Ihr Vorzeichen – zusammen mit dem Vorzeichen vonf_xx– klassifiziert den kritischen Punkt:D > 0undf_xx > 0: Lokales MinimumD > 0undf_xx < 0: Lokales MaximumD < 0: SattelpunktD = 0: Nicht eindeutigFür unser Beispiel gilt
f_xx = 2,f_yy = -2undf_xy = 0:Test mit den zweiten Ableitungen für die Referenzfunktion
Dist negativ, also bestätigt der Test:(0, 0)ist ein Sattelpunkt.Dieser Test ist die Eigenwertregel aus dem vorigen Abschnitt, nur in einer Form, die du ohne Eigenvektoren berechnen kannst.
Dist das Produkt der beiden Eigenwerte, undf_xx + f_yyihre Summe. WennDnegativ ist, müssen die Eigenwerte entgegengesetzte Vorzeichen tragen – genau das definiert einen Sattelpunkt. WennDnull ist, ist mindestens ein Eigenwert null – die Krümmung in dieser Richtung ist flach, und weder der Test noch die Eigenwerte allein klären die Lage.Sattelpunkte in der Optimierung
Bisher ging es darum, einen Sattelpunkt zu erkennen, wenn die Funktion schon vorliegt. In der Optimierung suchst du jedoch die beste Stelle, ohne sie vorher zu kennen, und gradientenbasierte Verfahren nutzen einen verschwindenden Gradient als Stoppkriterium.
Genau hier machen Sattelpunkte Probleme.
Ein gradientenbasierter Optimierer geht in die Richtung des schnellsten Abstiegs der Zielfunktion und läuft weiter, bis der Gradient nahe null ist. Aber ein nahezu verschwindender Gradient verrät dem Algorithmus nicht, ob er ein Minimum oder einen Sattelpunkt gefunden hat.
Richtungen mit positiver Krümmung treiben den Funktionswert nach oben – der Algorithmus hat bereits gelernt, dass Schritte dorthin schaden. Richtungen mit negativer Krümmung existieren weiterhin und sind der Ausweg – doch ein Algorithmus, der nur dem Gradienten traut, kann sie übersehen, weil direkt am Sattelpunkt auch dort der Gradient nahezu null ist.
Das bremst die Optimierung zusätzlich aus.
Die Gradienten-Norm schrumpft typischerweise in der Nähe jedes stationären Punkts. Skaliert ein Algorithmus seine Schrittweite mit der Gradientenstärke, macht er in der Nähe eines Sattels kleine Schritte – egal, ob er dem gesuchten Minimum tatsächlich nahe ist oder nicht.
Einen stationären Punkt zu finden, ist also nicht gleichbedeutend mit einer gelösten Optimierung. Du brauchst ein Kriterium, um einen nahezu verschwindenden Gradient als Sattelpunkt statt als Minimum zu erkennen – und einen Weg, die absteigende Richtung zu finden, sobald du das weißt.
Sattelpunkte im Machine Learning
Die Verlustfunktion eines neuronalen Netzes hängt von allen Gewichten und Biases ab – oft mit Millionen oder Milliarden Dimensionen. Das ist weit entfernt vom Zweivariablen-Spielzeugbeispiel.
In einer Analyse hochdimensionaler, nichtkonvexer Optimierung argumentieren Dauphin und Kolleginnen/Kollegen, dass mit wachsender Dimension kritische Punkte viel häufiger Sattelpunkte sind als lokale Minima oder Maxima. Jede zusätzliche Dimension bringt eine weitere Richtung mit, in der die Krümmung in beide Vorzeichen gehen kann – und eine einzige Richtung mit negativer Krümmung reicht, um einen kritischen Punkt zum Sattel statt zum Minimum zu machen.
Das ist fürs Training relevant, weil Gradientenabstieg nur den aktuellen Gradienten sieht.
In der Nähe eines Sattelpunkts wird der Gradient in alle Richtungen klein – genau das Signal, das du auch beim Annähern an ein echtes Minimum siehst. Das Training kann sich verlangsamen oder in einer Region festfahren, die gar nicht optimal ist – und aus der Loss-Kurve allein ist nicht ersichtlich, ob du in der Nähe eines Minimums bist oder auf einem Sattel hängst.
Deshalb tauchen Sattelpunkte bei Gesprächen über das Training neuronaler Netze so oft neben lokalen Minima auf. Sie sind aber nicht das einzige Hindernis: Verschwindende Gradienten, schlecht konditionierte Krümmung und die Größe des Suchraums erschweren hochdimensionale Optimierung generell.
Wie Optimierungsalgorithmen mit Sattelpunkten umgehen
All das bedeutet nicht, dass gradientenbasiertes Training an Sattelpunkten scheitert. Es gibt mehrere Ansätze, die dich hindurchführen – jeweils aus einem anderen Blickwinkel.
Stochastischer Gradientenabstieg
Stochastic Gradient Descent berechnet den Gradienten aus einem zufälligen Teil des Trainingsdatensatzes – und dieser Teil ändert sich in jedem Schritt.
Das dabei entstehende Rauschen sorgt dafür, dass der geschätzte Gradient selten exakt null ist – selbst in Regionen, wo der wahre Gradient nahe null liegt. Dieses Rauschen kann den Optimierer vom Sattel weg in eine Richtung negativer Krümmung schieben, statt genau dort zu verharren, wo der Gradient verschwindet.
Momentum
Momentum bildet einen gleitenden Mittelwert vergangener Gradienten und nutzt diesen statt nur des aktuellen für den nächsten Schritt.
In der Nähe eines Sattelpunkts ist das hilfreich, weil der Optimierer bereits mit einer gewissen Geschwindigkeit ankommt – getragen von früheren Gradienten. Diese aufgestaute Bewegung kann ihn durch die flache Region um den Sattel tragen, statt sofort abzubremsen, sobald der lokale Gradient gegen null geht.
Methoden zweiter Ordnung
Methoden zweiter Ordnung nutzen Krümmungsinformation direkt.
Über die Hesse-Matrix oder ihre Approximation unterscheiden sie an einem kritischen Punkt zwischen Richtungen positiver und negativer Krümmung. Genau auf diesem Unterschied beruht der Sattelpunkt – eine Methode zweiter Ordnung kann also die absteigende Richtung identifizieren und hineinschreiten, statt jeden nahezu verschwindenden Gradient gleich zu behandeln.
Sattelpunkte vs. verwandte Konzepte
Einige Begriffe werden oft mit Sattelpunkten verwechselt – hier die wichtigsten Abgrenzungen.
Sattelpunkt vs. lokales Minimum
Ein lokales Minimum krümmt sich in jeder Richtung in seiner Nähe nach oben – also durchgehend positive Krümmung. Ein Sattelpunkt krümmt sich nur in einigen Richtungen nach oben, in anderen nach unten. Findest du auch nur eine Richtung mit negativer Krümmung, ist es kein Minimum mehr.
Sattelpunkt vs. lokales Maximum
Analog dazu beim lokalen Maximum: Die Krümmung bleibt in jeder Richtung negativ. Ein Sattelpunkt bringt mindestens eine Richtung positiver Krümmung zusätzlich zu den negativen mit.
Sattelpunkt vs. Wendepunkt
Ein Wendepunkt ist ein eindimensionaler Begriff: Dort wechselt eine Kurve entlang einer einzelnen Variablen von konkav nach konvex oder umgekehrt.
Ein Sattelpunkt braucht mindestens zwei Variablen, weil es um Krümmungsvergleiche in unterschiedlichen Richtungen am selben Punkt geht. Eine eindimensionale Funktion kann einen Wendepunkt haben, aber keinen Sattelpunkt – es fehlt die zweite Richtung.
Sattelpunkt vs. stationärer Punkt
Jeder Sattelpunkt ist ein stationärer Punkt, weil dort der Gradient null ist. Umgekehrt gilt das nicht: Ein stationärer Punkt ist jeder Punkt mit Gradienten null – er kann ein lokales Minimum, ein lokales Maximum oder ein Sattelpunkt sein. Welche Art vorliegt, verraten Hesse-Matrix oder der Test mit den zweiten Ableitungen.
Hier ist eine visuelle Übersicht zum Vergleich:
Sattelpunkte im Vergleich zu anderen Konzepten
Sattelpunkte in der Minimax-Optimierung
Bisher stand „Sattelpunkt“ für die Krümmung an einem kritischen Punkt. Es gibt eine zweite, ältere Bedeutung aus der Spieltheorie, die auch im modernen Machine Learning vorkommt.
In der Minimax-Optimierung minimiert ein Akteur eine Funktion, während ein anderer sie maximiert. Ein Sattelpunkt ist das Wertepaar, an dem keiner der beiden seine eigene Entscheidung ändern kann, ohne sich zu verschlechtern.
Die Spieltheorie beschreibt damit Gleichgewichtsstrategien in kompetitiven Spielen. Adversarielle Optimierung überträgt die Struktur auf Probleme, in denen ein Prozess den schlimmsten Fall sucht, gegen den ein anderer Prozess bestehen muss.
Generative Adversarial Networks (GANs) sind das prominenteste ML-Beispiel: Ein Generator minimiert seinen Verlust, indem er überzeugende Fakes erzeugt, während ein Diskriminator seine Fähigkeit maximiert, echte von falschen Daten zu unterscheiden. Das Training eines GANs sucht nach einem Sattelpunkt im Minimax-Sinn – einem Gleichgewicht, in dem Generator und Diskriminator jeweils die beste Antwort auf den anderen gefunden haben.
Dieser Minimax-Sattelpunkt ist mit dem Sattelpunkt als kritischem Punkt verwandt, aber nicht austauschbar.
Die kritische Variante beschreibt die Krümmung an einem Punkt einer einzigen Funktion. Die Minimax-Variante beschreibt ein Gleichgewicht zwischen zwei konkurrierenden Zielen. Beide nutzen dasselbe Wort, weil es jeweils um „hoch“ und „runter“ geht – aber die Gleichsetzung hilft nicht weiter, wenn du versuchst, einen Hessian-Test auf ein Zweipersonenspiel anzuwenden.
Häufige Fehler im Umgang mit Sattelpunkten
Die meiste Verwirrung rund um Sattelpunkte geht auf ein paar wiederkehrende Fehler zurück. Das solltest du beachten.
Annehmen, dass ein nuller Gradient ein Minimum bedeutet
Ein nuller Gradient sagt nur, dass du einen kritischen Punkt gefunden hast – nicht welchen. Prüfe die Krümmung, bevor du den Haken dransetzt, denn auch ein Sattelpunkt hat einen nullen Gradient.
Klassifikation nur mit ersten Ableitungen
Erste Ableitungen finden kritische Punkte, können sie aber nicht klassifizieren. Dafür brauchst du die zweiten Ableitungen – über die Hesse-Matrix oder den Test mit den zweiten Ableitungen –, um Minimum, Maximum und Sattelpunkt zu unterscheiden.
Unterschiedliche Krümmungsrichtungen ignorieren
Eine Funktion kann sich entlang der x-Achse nach oben krümmen und trotzdem insgesamt ein Sattelpunkt sein, wenn eine andere Richtung nach unten krümmt. Prüfe alle Richtungen – oder nutze die Eigenwerte der Hesse-Matrix, die alle Richtungen auf einmal abdecken.
Sattelpunkte mit Wendepunkten verwechseln
Ein Wendepunkt beschreibt eine Krümmungsänderung in einer einzelnen Variablen. Ein Sattelpunkt beschreibt gemischte Krümmung über mehrere Variablen am selben Ort. Sie sind vom Grundgedanken verwandt, gelten aber nicht für denselben Funktionstyp, und die zugrunde liegende Mathematik ist nicht austauschbar.
Alle Bedeutungen von „Sattelpunkt“ gleichsetzen
Der Sattelpunkt als kritischer Punkt und der Minimax-Sattelpunkt teilen sich nur den Namen, nicht die Definition. Bevor du einen Hessian-basierten Test oder ein Eigenwert-Argument anwendest, prüfe die tatsächliche Bedeutung – Spieltheorie und adversarielle Optimierung nutzen die Minimax-Variante, und die lässt sich nicht auf eine Krümmungsprüfung einer einzelnen Funktion reduzieren.
Fazit
Ein Sattelpunkt krümmt sich in manchen Richtungen nach oben und in anderen nach unten – am selben Ort. Deshalb ist er weder Minimum noch Maximum, obwohl der Gradient dort wie bei beiden gegen null geht.
Gradienten finden den kritischen Punkt. Die Eigenwerte der Hesse-Matrix oder der Test mit den zweiten Ableitungen sagen dir, welche Art es ist. In hohen Dimensionen ist dieser Unterschied essenziell, weil Sattelpunkte lokale Minima zahlenmäßig übertreffen – und Trainingsalgorithmen wie SGD und Momentum existieren auch, um sie zu überwinden.
Wichtig ist außerdem, den Minimax-Sattelpunkt aus Spieltheorie und GANs begrifflich zu trennen – der Name ist derselbe, die Mathematik dahinter nicht.
Wenn dich die Idee hinter Sattelpunkten interessiert, wird dir unser Deep Learning Track in Python gefallen. Neben der Theorie baust du mit PyTorch neuronale Netze für verschiedene Problemstellungen.