
Curso
Introducción a la optimización en Python
4 h
5.6K
Aunque todas las derivadas parciales de tu función sean cero, no tienes garantizado estar cerca de un mínimo.
La optimización busca el valor más bajo o más alto de una función, y todos los métodos tratan de encontrar un punto donde el gradiente sea plano. Pero un gradiente plano no garantiza que hayas dado con la mejor solución. A veces significa que la función sube en una dirección y baja en otra, justo en el mismo punto.
Ese punto se llama punto de silla: desciende en una dirección, asciende en otra y es plano alrededor. Reconocerlos importa porque tu algoritmo puede quedarse atascado ahí y confundir un gradiente plano con un mínimo real.
En este artículo, te explico cómo detectar un punto de silla de forma matemática y por qué suele confundir a los algoritmos de optimización.
En un punto de silla, el gradiente es cero, igual que en un mínimo o un máximo. Pero no es ni lo uno ni lo otro.
La función se curva hacia arriba en algunas direcciones y hacia abajo en otras, justo en el mismo punto. Si avanzas a lo largo de un eje, el valor sube; si lo haces por otro, baja. De ahí el nombre: se inspira en la forma de una silla de montar, que se curva hacia arriba por delante y por detrás y hacia abajo por los lados.
Aquí tienes una función sencilla de dos variables para ilustrarlo:

Función de dos variables
En el origen, (0, 0), ambas derivadas parciales son cero, así que es un punto crítico (también llamado punto estacionario). Si te mueves por el eje x, f aumenta por el término x^2. Si te mueves por el eje y, f decrece por el término -y^2.
Si representas esta función en 3D, la superficie se curva hacia arriba en una dirección y hacia abajo en la otra, formando la silueta que da nombre al punto de silla.

Superficie 3D de f(x, y) = x^2 - y^2
Un diagrama de contorno de la misma función cuenta lo mismo desde arriba. Las líneas de nivel alrededor del origen parecen hipérbolas, no los bucles cerrados que verías alrededor de un mínimo o un máximo.

Diagrama de contorno de f(x, y) = x^2 - y^2
La definición exacta cambia un poco según el campo. En cálculo multivariable, un punto de silla es un punto crítico que no es un mínimo ni un máximo local. En optimización y teoría de juegos, el término puede significar otra cosa, ligada a problemas minimax más que a la curvatura. Verás esa distinción más adelante.
Antes de entrar en cómo identificarlos matemáticamente, ayuda ver cómo se comparan con los otros dos tipos de puntos críticos.
En un mínimo local, la función aumenta en todas las direcciones cercanas. Imagina un cuenco: al alejarte del fondo en cualquier dirección, subes. La función f(x, y) = x2 + y2 se comporta así.
En un máximo local, la función disminuye en todas las direcciones cercanas. Es la imagen en espejo de un mínimo: una cúpula en lugar de un cuenco. La función f(x, y) = -x2 - y2 decrece en todas las direcciones al alejarte del origen.
En un punto de silla, la función aumenta en algunas direcciones y disminuye en otras. Por eso f(x, y) = x2 - y2, el ejemplo anterior, es un punto de silla y no un mínimo ni un máximo: sube a lo largo del eje x y baja a lo largo del eje y, en el mismo punto.
Así se ven los tres, comparados lado a lado:
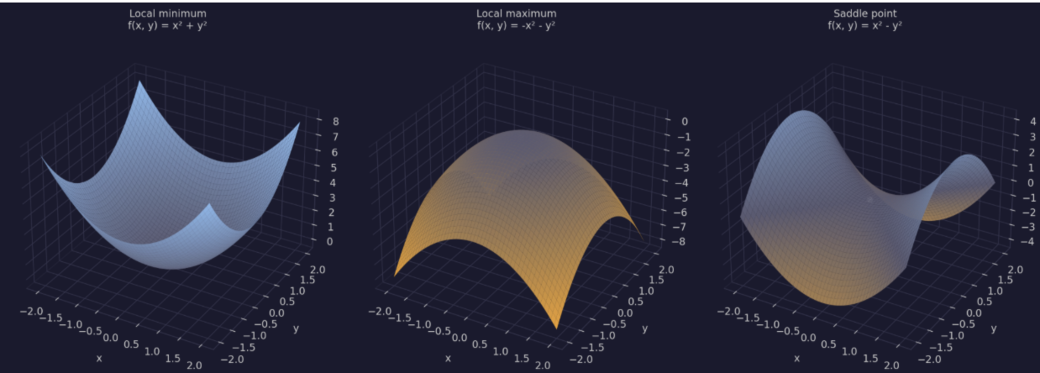
Gráficas 3D de un mínimo local, un máximo local y un punto de silla
Encontrarlos consiste en derivar, localizar dónde se anulan las derivadas y analizar cómo se curva la función alrededor de ese punto.
Usaré la misma función de antes:

Función de referencia
El proceso, paso a paso:
Deriva f respecto a x, tratando y como constante, y haz lo mismo respecto a y:

Cálculo de las primeras derivadas parciales
Resuelve el punto donde ambas derivadas parciales se anulan a la vez:

Igualando las derivadas a cero
Obtenemos x = 0 y y = 0, así que (0, 0) es un punto crítico. Las primeras derivadas no te dirán de qué tipo.
Necesitas tres: la derivada de f_x respecto a x, la de f_y respecto a y y la derivada mixta:

Segundas derivadas
f_xx = 2 es positivo, así que f se curva hacia arriba en el eje x. f_yy = -2 es negativo, así que f se curva hacia abajo en el eje y. Una dirección sube y la otra baja en el mismo punto: eso es un punto de silla.
Este proceso de cuatro pasos funciona para cualquier función dos veces derivable.
En las dos secciones siguientes, formalizo el paso 4 con herramientas que escalan más allá de dos variables: la matriz Hessiana y el test de la segunda derivada.
La matriz Hessiana reúne todas las segundas derivadas en un solo objeto y es la herramienta que te dice si un punto crítico es un mínimo, un máximo o un punto de silla.
Para una función de dos variables, la Hessiana tiene este aspecto:

Hessiana para una función de dos variables
Cada elemento describe curvatura: f_xx y f_yy describen la curvatura a lo largo de los ejes x e y, y f_xy describe cómo interactúan esas dos direcciones. Si sustituyes las segundas derivadas del apartado anterior, la Hessiana de nuestro ejemplo queda así:

Hessiana de la función de referencia
Una matriz por sí sola no dice mucho. Lo que importa son sus autovalores: números que describen cómo se curva la función a lo largo de un conjunto específico de direcciones llamadas autovectores.
Como la Hessiana de nuestro ejemplo es diagonal, los autovalores están en la diagonal: 2 y -2. Sus autovectores apuntan a lo largo de los ejes x e y, justo la curvatura que calculaste a mano antes. f se curva hacia arriba en x porque el autovalor ahí es positivo, y hacia abajo en y porque el autovalor es negativo.
La mayoría de funciones no tienen una Hessiana diagonal, así que los autovectores no se alinean con los ejes x e y, y tendrás que resolverlos. Pero un autovalor positivo y otro negativo significa que estás en un punto de silla.
No necesitas calcular autovalores a mano cada vez. Para funciones de dos variables hay un atajo: el test de la segunda derivada, basado en el determinante de la Hessiana.
Este es el determinante, usando las segundas derivadas de antes:

El determinante
D es el determinante de la Hessiana y su signo, combinado con el signo de f_xx, clasifica el punto crítico:
D > 0 y f_xx > 0: mínimo local
D > 0 y f_xx < 0: máximo local
D < 0: punto de silla
D = 0: inconcluso
En nuestro ejemplo, f_xx = 2, f_yy = -2 y f_xy = 0:

Test de la segunda derivada para la función de referencia
D es negativo, así que el test confirma que (0, 0) es un punto de silla.
Este test es la regla de los autovalores reescrita en una forma que puedes calcular sin resolver autovectores. D es el producto de los dos autovalores, y f_xx + f_yy es su suma. Cuando D es negativo, los autovalores tienen signos opuestos, y eso es precisamente un punto de silla. Cuando D es cero, al menos un autovalor es cero, así que la curvatura en esa dirección es plana y ni el test ni los autovalores por sí solos pueden decirte qué ocurre.
Hasta aquí hemos hablado de identificar un punto de silla cuando ya tienes la función. Pero en optimización buscas el mejor punto sin saber de antemano dónde está, y los métodos basados en el gradiente usan un gradiente nulo para decidir cuándo parar.
Ahí es justo donde los puntos de silla dan problemas.
Un optimizador basado en el gradiente avanza en la dirección que más reduce la función objetivo y continúa hasta que el gradiente se aproxima a cero. Pero un gradiente casi nulo no le dice si ha encontrado un mínimo o un punto de silla.
Las direcciones con curvatura positiva empujan la función hacia arriba, y el algoritmo ya ha aprendido que ir por ahí empeora. Las direcciones de curvatura negativa siguen ahí y son la salida, pero un algoritmo que solo confía en el gradiente puede pasarlas por alto, porque justo en un punto de silla el gradiente en esas direcciones también es cercano a cero.
Aquí también es donde la optimización se ralentiza.
La magnitud del gradiente tiende a reducirse al acercarte a cualquier punto estacionario, así que un algoritmo que escala sus pasos con el tamaño del gradiente da pasos pequeños cerca de un punto de silla, esté o no cerca del mínimo que busca.
Encontrar un punto estacionario no equivale a terminar la optimización. Aún necesitas una forma de distinguir si un gradiente casi nulo corresponde a un punto de silla o a un mínimo, y una forma de encontrar la dirección que sigue mejorando la función objetivo cuando lo sabes.
La función de pérdida de una red neuronal depende de todos sus pesos y sesgos, a veces millones o miles de millones de dimensiones. Está muy lejos de un ejemplo de dos variables.
En un análisis de la optimización no convexa en alta dimensión, Dauphin y colegas sostienen que, a medida que aumentan las dimensiones, es mucho más probable que los puntos críticos sean puntos de silla que mínimos o máximos locales. Cada dimensión añade otra dirección en la que la curvatura puede ir a favor o en contra, y basta una sola dirección de curvatura negativa para que un punto crítico sea un punto de silla en lugar de un mínimo.
Esto importa durante el entrenamiento porque el descenso de gradiente solo ve el gradiente en el que está parado.
Cerca de un punto de silla, ese gradiente se hace pequeño en todas las direcciones, la misma señal que verías al aproximarte a un mínimo real. El entrenamiento puede ralentizarse o atascarse en una región nada óptima, y no hay forma de saber solo por la curva de pérdida si estás cerca de un mínimo o encallado en un punto de silla.
Por eso los puntos de silla aparecen tan a menudo junto a los mínimos locales cuando se habla de entrenamiento de redes neuronales. Pero no son el único obstáculo: los gradientes que se desvanecen, la curvatura mal condicionada y la escala del espacio de búsqueda también complican la optimización en alta dimensión.
Nada de esto significa que el entrenamiento basado en gradientes esté condenado cerca de un punto de silla. Hay varias técnicas que ayudan a superarlos, cada una desde un ángulo distinto.
Stochastic gradient descent calcula el gradiente con un subconjunto aleatorio de los datos de entrenamiento en lugar de usar todo el conjunto, y ese subconjunto cambia en cada paso.
El ruido que introduce hace que el gradiente estimado rara vez sea exactamente cero, incluso en una región donde el gradiente real es cercano a cero. Ese ruido puede bastar para sacar al optimizador del punto de silla y dirigirlo hacia una dirección de curvatura negativa, en lugar de pararse justo donde el gradiente se anula.
Momentum mantiene un promedio móvil de gradientes pasados y lo usa, además del actual, para decidir el siguiente paso.
Cerca de un punto de silla, esto importa porque el optimizador llega con inercia en alguna dirección, arrastrado por gradientes previos. Ese movimiento acumulado puede atravesar la región plana alrededor del punto de silla, en lugar de frenarse en cuanto el gradiente local se acerca a cero.
Los métodos de segundo orden usan directamente la información de curvatura.
Trabajando con la Hessiana o una aproximación, pueden distinguir entre direcciones de curvatura positiva y negativa en un punto crítico. Esa es la clave de un punto de silla, de modo que un método de segundo orden puede identificar la dirección descendente y avanzar por ella, en lugar de tratar todos los gradientes casi nulos por igual.
Hay varios términos que suelen confundirse con los puntos de silla y merece la pena aclararlos.
Un mínimo local se curva hacia arriba en todas las direcciones cercanas; es curvatura positiva consistente alrededor. Un punto de silla solo se curva hacia arriba en algunas direcciones y hacia abajo en otras. En cuanto encuentras una dirección con curvatura negativa, ya no estás ante un mínimo.
La misma lógica al revés para un máximo local: la curvatura es negativa en todas las direcciones cercanas. Un punto de silla añade al menos una dirección de curvatura positiva junto a las negativas.
Un punto de inflexión es una idea unidimensional: donde una curva cambia de cóncava a convexa o viceversa, a lo largo de una sola variable.
Un punto de silla necesita al menos dos variables, porque el concepto se basa en comparar curvaturas en distintas direcciones en el mismo punto. Una función de una variable puede tener puntos de inflexión, pero no puntos de silla: no hay una segunda dirección que se curve en sentido contrario.
Todo punto de silla es un punto estacionario, ya que el gradiente es cero ahí. Pero no al revés. Un punto estacionario es cualquier punto donde el gradiente es cero: puede ser un mínimo local, un máximo local o un punto de silla. Necesitas la curvatura (Hessiana o test de la segunda derivada) para saber cuál es.
Aquí tienes una visión más visual de la comparación:
| Patrón de curvatura | Relación con los puntos de silla | |
|---|---|---|
| Mínimo local | Positiva en todas las direcciones | Nunca es un punto de silla |
| Máximo local | Negativa en todas las direcciones | Nunca es un punto de silla |
| Punto de inflexión | Cambio de concavidad en una variable | Concepto distinto, solo requiere una variable |
| Punto estacionario | El gradiente es cero | Un punto de silla es un tipo de punto estacionario |
Comparativa de los puntos de silla con otros conceptos
Hasta ahora hemos usado "punto de silla" para describir la curvatura de un punto crítico. Hay un segundo significado, más antiguo, que viene de la teoría de juegos y también aparece en el aprendizaje automático moderno.
En la optimización minimax, un jugador minimiza una función mientras otro la maximiza, y un punto de silla es el par de valores donde ninguno puede mejorar su resultado cambiando solo su propia jugada.
La teoría de juegos lo usa para describir estrategias de equilibrio en juegos competitivos. La optimización adversaria toma la misma estructura para problemas en los que un proceso busca el peor caso al que otro proceso debe hacer frente.
Generative adversarial networks (GANs) son el mejor ejemplo en machine learning. Un generador minimiza su pérdida produciendo datos falsos convincentes mientras un discriminador maximiza su capacidad de distinguir lo real de lo falso. Entrenar un GAN es buscar un punto de silla en este sentido minimax: un equilibrio donde generador y discriminador han encontrado su mejor respuesta al otro.
Este punto de silla minimax está relacionado con el punto de silla como punto crítico que vimos antes, pero no son intercambiables.
La versión de punto crítico describe la curvatura de una única función en un punto concreto. La versión minimax describe un equilibrio entre dos objetivos en competencia. Comparten nombre porque en ambos hay mezcla de comportamientos "hacia arriba" y "hacia abajo", pero confundirlos no te ayudará si intentas aplicar una prueba basada en la Hessiana a un juego de dos jugadores.
La mayoría de confusiones sobre los puntos de silla se deben a un par de errores recurrentes. Ten esto en cuenta.
Un gradiente cero solo indica que has encontrado un punto crítico, no cuál. Comprueba la curvatura antes de dar por cerrado el problema, porque un punto de silla también tiene gradiente cero.
Las primeras derivadas localizan puntos críticos, pero no los clasifican. Necesitas las segundas derivadas, vía Hessiana o test de la segunda derivada, para distinguir mínimo, máximo y punto de silla.
Una función puede curvarse hacia arriba en el eje x y seguir siendo un punto de silla si alguna otra dirección se curva hacia abajo. Revisa todas las direcciones, o usa los autovalores de la Hessiana, que las contemplan todas a la vez.
Un punto de inflexión describe un cambio de curvatura en una sola variable. Un punto de silla describe curvatura mixta en varias variables en el mismo punto. Están relacionados en lo conceptual, pero no aplican al mismo tipo de función, y las matemáticas detrás no son intercambiables.
El punto de silla como punto crítico y el punto de silla minimax comparten nombre, no definición. Antes de aplicar una prueba con la Hessiana o un argumento de autovalores, comprueba de qué significado se trata: la teoría de juegos y la optimización adversaria usan la versión minimax, y no se reduce a una comprobación de curvatura de una sola función.
Un punto de silla se curva hacia arriba en unas direcciones y hacia abajo en otras, en las mismas coordenadas; por eso no es ni un mínimo ni un máximo, aunque el gradiente se anule igual que en ambos.
El gradiente te lleva al punto crítico. Los autovalores de la Hessiana, o el test de la segunda derivada, te dicen de qué tipo es. En alta dimensión, esta distinción importa mucho porque los puntos de silla superan en número a los mínimos locales, y algoritmos como SGD y momentum existen en parte para superarlos.
Un último apunte: el punto de silla minimax de la teoría de juegos y los GAN comparte el nombre pero no las matemáticas, así que asegúrate de cuál estás tratando.
Si te interesa la idea detrás de los puntos de silla, te encantará nuestro Deep Learning Track in Python. Además de la teoría, usarás PyTorch para crear redes neuronales para distintos tipos de problemas.
Aprende con DataCamp
Curso
Curso
Curso
blog
Natassha Selvaraj
15 min
blog
Zoumana Keita
14 min
blog
Arun Nanda
15 min
Tutorial
Kurtis Pykes
11 min
Tutorial
Abid Ali Awan
9 min
Tutorial
Richmond Alake
12 min


