
Cursus
Introductie tot optimalisatie in Python
4 uur
5.6K
Zelfs als elke partiële afgeleide van je functie nul is, ben je nog niet per se in de buurt van een minimum.
Optimalisatie is het zoeken naar de laagste of hoogste waarde van een functie, en elke methode die je gebruikt, zoekt naar een plek waar de gradiënt vlak is. Maar een vlakke gradiënt garandeert niet dat je de beste oplossing hebt gevonden. Soms betekent het dat de functie in de ene richting stijgt en in een andere richting daalt, precies op hetzelfde punt.
Dat punt heet een zadelpunt: het gaat omlaag in de ene richting, omhoog in de andere, en is rondom vlak. Zadelpunten herkennen is belangrijk, omdat je algoritme daar kan blijven hangen en een vlakke gradiënt kan verwarren met een echt minimum.
In dit artikel laat ik je zien hoe je een zadelpunt wiskundig herkent en waarom het optimalisatie-algoritmen vaak in de war brengt.
Bij een zadelpunt is de gradiënt nul, net als bij een minimum of een maximum. Maar een zadelpunt is geen van beide.
De functie kromt in sommige richtingen omhoog en in andere omlaag, precies op hetzelfde punt. Ga je langs de ene as, dan neemt de waarde toe, en langs een andere as neemt hij af. Dat is het idee achter de naam: het verwijst naar de vorm van een paardenzadel, dat voor en achter omhoog krult en aan de zijkanten omlaag.
Hier is een eenvoudige tweedimensionale functie die ik gebruik om te laten zien hoe dit eruitziet:

Tweedimensionale functie
In de oorsprong, (0, 0), zijn beide partiële afgeleiden nul, dus het is een kritisch punt (ook wel stationair punt). Beweeg langs de x-as en f neemt toe door de term x^2. Beweeg langs de y-as en f neemt af door de term -y^2 .
Als je deze functie in 3D plot, kromt het oppervlak in de ene richting omhoog en in de andere omlaag, waardoor de vorm ontstaat waarnaar een zadelpunt is vernoemd.

3D-oppervlakteplot van f(x, y) = x^2 - y^2
Een contourplot van dezelfde functie vertelt vanuit bovenaf hetzelfde verhaal. De contourlijnen rond de oorsprong lijken op hyperbolen, niet op de gesloten lussen die je rond een minimum of maximum zou zien.

Contourplot van f(x, y) = x^2 - y^2
De exacte definitie verschilt een beetje per vakgebied. In multivariabele calculus is een zadelpunt een kritisch punt dat geen lokaal minimum of maximum is. In optimalisatie en speltheorie kan de term iets anders betekenen, gekoppeld aan minimaxproblemen in plaats van aan kromming. Dat onderscheid behandel ik later in dit artikel.
Voor je leert hoe je zadelpunten wiskundig identificeert, helpt het om te zien hoe ze zich verhouden tot de andere twee soorten kritische punten.
Bij een lokaal minimum neemt de functie in elke nabije richting toe. Stel je een kom voor: als je vanaf de bodem een stap in welke richting dan ook zet, ga je omhoog. De functie f(x, y) = x2 + y2 gedraagt zich zo.
Bij een lokaal maximum neemt de functie in elke nabije richting af. Het is het spiegelbeeld van een minimum: een koepel in plaats van een kom. De functie f(x, y) = -x2 - y2 daalt in elke richting als je vanaf de oorsprong weg beweegt.
Bij een zadelpunt neemt de functie in sommige richtingen toe en in andere af. Dat maakt f(x, y) = x2 - y2, het voorbeeld uit de vorige sectie, tot een zadelpunt in plaats van een minimum of maximum: het gaat omhoog langs de x-as en omlaag langs de y-as, op hetzelfde punt.
Zo vergelijken de drie naast elkaar:
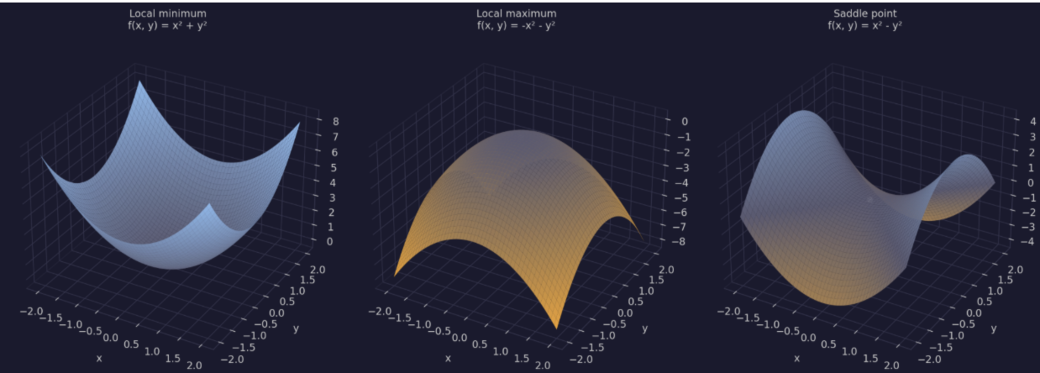
3D-oppervlakteplots naast elkaar van een lokaal minimum, lokaal maximum en zadelpunt
Een zadelpunt vinden komt neer op differentiëren, zoeken waar de afgeleiden nul zijn, en dan kijken hoe de functie rondom dat punt kromt.
Ik gebruik dezelfde functie als net:

Referentiefunctie
Hier is het proces, stap voor stap.
Neem de afgeleide van f naar x, waarbij je y als constant beschouwt, en doe hetzelfde voor y:

De eerste partiële afgeleiden berekenen
Los het punt op waar beide partiële afgeleiden tegelijk nul zijn:

Afgeleiden gelijk aan nul zetten
Dat geeft x = 0 en y = 0, dus (0, 0) is een kritisch punt. Eerste afgeleiden vertellen je nog niet welk type.
Je hebt er drie nodig: de afgeleide van f_x naar x, de afgeleide van f_y naar y, en de gemengde afgeleide:

Tweede afgeleiden
f_xx = 2 is positief, dus f kromt omhoog langs de x-as. f_yy = -2 is negatief, dus f kromt omlaag langs de y-as. De ene richting kromt omhoog, de andere omlaag, op hetzelfde punt – dat is het zadelpunt.
Dit vierstappenproces werkt voor elke tweemaal differentieerbare functie.
In de volgende twee secties formaliseer ik stap 4 met tools die verder gaan dan twee variabelen: de Hessiaan en de tweede-afgeleidentoets.
De Hessiaan bundelt alle tweede afgeleiden uit de vorige sectie in één object, en is het hulpmiddel dat vertelt of een kritisch punt een minimum, maximum of zadel is.
Voor een tweedimensionale functie ziet de Hessiaan er zo uit:

Hessiaan voor een tweedimensionale functie
Elk element beschrijft kromming: f_xx en f_yy beschrijven de kromming langs de x- en y-assen, en f_xy beschrijft hoe die twee richtingen op elkaar inwerken. Als je de tweede afgeleiden uit de vorige sectie invult, ziet de Hessiaan voor onze voorbeeldfunctie er zo uit:

Hessiaan voor de referentiefunctie
Een matrix op zichzelf vertelt niet veel. Waar het om gaat, zijn de eigenwaarden – de getallen die beschrijven hoe de functie kromt langs een specifieke set richtingen, de eigenvectoren.
Omdat de Hessiaan van ons voorbeeld diagonaal is, staan de eigenwaarden gewoon op de diagonaal: 2 en -2. Hun eigenvectoren wijzen langs de x- en y-as, precies de kromming die je zojuist met de hand vond. f kromt omhoog langs x omdat de eigenwaarde daar positief is, en omlaag langs y omdat de eigenwaarde daar negatief is.
De meeste functies hebben geen diagonale Hessiaan, dus komen de eigenvectoren niet netjes overeen met de x- en y-assen, en moet je ze direct oplossen in plaats van ze uit de matrix af te lezen. Maar één positieve en één negatieve eigenwaarde betekent dat je op een zadelpunt staat.
Je hoeft niet elke keer eigenwaarden met de hand te berekenen. Voor functies van twee variabelen is er een snelkoppeling – de tweede-afgeleidentoets – gebaseerd op de determinant van de Hessiaan.
Hier is de determinant, met dezelfde tweede afgeleiden als net:

De determinant
D is de determinant van de Hessiaan, en het teken ervan – gecombineerd met het teken van f_xx – classificeert het kritische punt:
D > 0 en f_xx > 0: Lokaal minimum
D > 0 en f_xx < 0: Lokaal maximum
D < 0: Zadelpunt
D = 0: Niet doorslaggevend
Voor ons voorbeeld gelden f_xx = 2, f_yy = -2 en f_xy = 0:

Tweede-afgeleidentoets voor de referentiefunctie
D is negatief, dus de toets bevestigt dat (0, 0) een zadelpunt is.
Deze toets is de eigenwaardenregel uit de vorige sectie, herschreven in een vorm die je kunt berekenen zonder eigenvectoren op te lossen. D is het product van de twee eigenwaarden, en f_xx + f_yy is hun som. Wanneer D negatief is, moeten de eigenwaarden tegengestelde tekens hebben, en dat is precies wat een zadelpunt is. Wanneer D nul is, is minstens één eigenwaarde nul, dus is de kromming in die richting vlak, en kunnen noch de toets noch de eigenwaarden alleen je vertellen wat daar gebeurt.
Alles tot nu toe ging over het identificeren van een zadelpunt als je de functie al hebt. Maar bij optimalisatie zoek je naar het beste punt zonder vooraf te weten waar het is, en gradiëntgebaseerde methoden gebruiken een gradiënt van nul om te bepalen wanneer te stoppen.
Precies daar zorgen zadelpunten voor problemen.
Een gradiëntgebaseerde optimizer beweegt in de richting die de doelfunctie het snelst verlaagt, en gaat door tot de gradiënt dicht bij nul komt. Maar een bijna-nul gradiënt vertelt het algoritme niet of het een minimum of een zadelpunt heeft gevonden.
Richtingen met positieve kromming duwen de functie omhoog, en het algoritme heeft al geleerd dat stappen daarin de situatie verslechteren. De richtingen met negatieve kromming zijn er nog – dat is de uitweg – maar een algoritme dat alleen de gradiënt vertrouwt, kan die missen, omdat precies op een zadelpunt de gradiënt in die richtingen ook bijna nul is.
Hier vertraagt optimalisatie ook.
De grootte van de gradiënt neemt meestal af naarmate je een stationair punt nadert, dus een algoritme dat zijn stappen schaalt met de gradiëntgrootte zet kleine stapjes in de buurt van een zadel, of het nu in de buurt is van het gezochte minimum of niet.
Een stationair punt vinden is niet hetzelfde als een optimalisatie afronden. Je hebt nog steeds een manier nodig om te zien dat een bijna-nul gradiënt bij een zadelpunt hoort en niet bij een minimum, en een manier om de richting te vinden die de doelstelling blijft verbeteren zodra je dat weet.
De verliesfunctie van een neuraal netwerk is een functie van elk gewicht en elke bias in het netwerk, soms miljoenen of miljarden dimensies. Dat is heel wat anders dan een tweedimensionaal speelgoedvoorbeeld.
In een analyse van hoogdimensionale niet-convexe optimalisatie stellen Dauphin en collega’s dat naarmate het aantal dimensies toeneemt, kritische punten veel vaker zadelpunten zijn dan lokale minima of maxima. Elke dimensie voegt een richting toe waarin de kromming beide kanten op kan, en één richting met negatieve kromming is genoeg om een kritisch punt tot zadelpunt te maken in plaats van een minimum.
Dat is belangrijk tijdens training, omdat gradiëntafdaling alleen de gradiënt ziet waar het zich op dat moment bevindt.
Dicht bij een zadelpunt wordt die gradiënt in elke richting klein – hetzelfde signaal dat je ziet als je een echt minimum nadert. Training kan vertragen of vastlopen in een gebied dat helemaal niet optimaal is, en uit de verliescurve alleen kun je niet afleiden of je in de buurt van een minimum bent of vastzit op een zadelpunt.
Daarom komen zadelpunten zo vaak ter sprake naast lokale minima wanneer mensen het over het trainen van neurale netwerken hebben. Maar het zijn niet de enige hindernis. Wegvallende gradiënten, slecht geconditioneerde kromming en de schaal van de zoekruimte maken hoogdimensionale optimalisatie allemaal lastig.
Dit betekent niet dat gradiëntgebaseerde training gedoemd is in de buurt van een zadelpunt. Er zijn verschillende technieken die je helpen erdoorheen te komen, elk vanuit een andere invalshoek.
Stochastische gradiëntafdaling berekent de gradiënt op basis van een willekeurige subset van de trainingsdata in plaats van de hele dataset, en die subset verandert bij elke stap.
De ruis die dit introduceert, betekent dat de geschatte gradiënt zelden exact nul is, zelfs in een gebied waar de echte gradiënt dicht bij nul is. Die ruis kan genoeg zijn om de optimizer van een zadelpunt af te duwen en een richting met negatieve kromming in te sturen, in plaats van precies stil te vallen waar de gradiënt verdwijnt.
Momentum houdt een voortschrijdend gemiddelde bij van eerdere gradiënten en gebruikt dat, in plaats van alleen de huidige, om de volgende stap te bepalen.
Rond een zadelpunt is dit belangrijk, omdat de optimizer al in een bepaalde richting aankomt, gedragen door de gradiënten van vóórdat hij daar kwam. Die opgebouwde beweging kan hem door de vlakke regio rond het zadel dragen, in plaats van meteen te vertragen zodra de lokale gradiënt bijna nul wordt.
Tweede-ordemethoden gebruiken krommingsinformatie direct.
Door met de Hessiaan of een benadering ervan te werken, kunnen deze methoden rond een kritisch punt het verschil zien tussen richtingen met positieve en negatieve kromming. Dat onderscheid is precies waar een zadelpunt om draait, dus een tweede-ordemethode kan de dalende richting identificeren en daarin stappen, in plaats van elke bijna-nul gradiënt hetzelfde te behandelen.
Een paar termen worden vaak genoeg met zadelpunten verward dat ze het vermelden waard zijn.
Een lokaal minimum kromt in elke richting eromheen omhoog, dus het heeft consequent positieve kromming, rondom. Een zadelpunt kromt alleen in sommige richtingen omhoog en in andere omlaag. Zodra je zelfs maar één richting met negatieve kromming vindt, kijk je niet meer naar een minimum.
Andersom voor een lokaal maximum. De kromming blijft in elke richting negatief. Een zadelpunt voegt minstens één richting met positieve kromming toe naast de negatieve.
Een buigpunt is een eendimensionaal idee. Het is waar een kromme overgaat van hol naar bol, of andersom, langs één enkele variabele.
Een zadelpunt heeft minstens twee variabelen nodig, omdat het hele concept berust op het vergelijken van kromming in verschillende richtingen op hetzelfde punt. Een functie van één variabele kan een buigpunt hebben, maar geen zadelpunt, omdat er geen tweede richting is om de andere kant op te krommen.
Elk zadelpunt is een stationair punt, omdat de gradiënt daar nul is. Maar omgekeerd geldt dat niet. Een stationair punt is gewoon elk punt waar de gradiënt nul is – het kan een lokaal minimum, een lokaal maximum of een zadelpunt zijn. Je hebt krommingsinformatie uit de Hessiaan of de tweede-afgeleidentoets nodig om te weten welke je hebt.
Hier is een meer visueel overzicht van hoe ze zich verhouden:
| Krommingspatroon | Relatie met zadelpunten | |
|---|---|---|
| Lokaal minimum | Positief in elke richting | Nooit een zadelpunt |
| Lokaal maximum | Negatief in elke richting | Nooit een zadelpunt |
| Buigpunt | Verandering van concaviteit langs één variabele | Een ander concept, heeft slechts één variabele nodig |
| Stationair punt | Gradiënt is nul | Een zadelpunt is één soort stationair punt |
Zadelpunten vergeleken met andere concepten
Tot nu toe gebruikten we "zadelpunt" om de kromming van een kritisch punt te beschrijven. Er is een tweede, oudere betekenis uit de speltheorie, die ook in moderne machine learning opduikt.
In minimax-optimalisatie minimaliseert de ene speler een functie terwijl de andere die maximaliseert, en een zadelpunt is het paar waarden waarbij geen van beide spelers zijn uitkomst kan verbeteren door alleen zijn eigen zet te veranderen.
Speltheorie gebruikt dit om evenwichtsstrategieën in competitieve spellen te beschrijven. Adversariële optimalisatie leent dezelfde structuur voor problemen waarin één proces zoekt naar het slechtste geval waar een ander proces zich tegen moet verdedigen.
Generative adversarial networks (GAN’s) zijn het beste machine-learningvoorbeeld. Een generator minimaliseert zijn verlies door overtuigende nepdata te produceren, terwijl een discriminator zijn vermogen maximaliseert om echte van nepdata te onderscheiden. Een GAN trainen betekent zoeken naar een zadelpunt in deze minimax-betekenis, ofwel een balans waarbij generator en discriminator elk hun beste reactie op de ander hebben gevonden.
Dit minimax-zadelpunt is verwant aan het zadelpunt als kritisch punt van eerder in dit artikel, maar de twee zijn niet uitwisselbaar.
De versie met kritische punten beschrijft de kromming op één punt van één functie. De minimax-versie beschrijft een evenwicht tussen twee concurrerende doelstellingen. Ze gebruiken hetzelfde woord omdat beide een mix van "omhoog"- en "omlaag"-gedrag omvatten, maar ze verwarren helpt je niet als je een Hessiaan-toets probeert toe te passen op een tweespeler-game.
De meeste verwarring rond zadelpunten komt neer op een paar terugkerende fouten. Dit moet je weten.
Een nulgradiënt vertelt alleen dat je een kritisch punt hebt gevonden, niet welk type. Controleer de kromming voordat je aanneemt dat je klaar bent, want een zadelpunt heeft ook een nulgradiënt.
Eerste afgeleiden vinden kritische punten, maar kunnen ze niet classificeren. Je hebt de tweede afgeleiden nodig, via de Hessiaan of de tweede-afgeleidentoets, om minimum, maximum en zadelpunt van elkaar te onderscheiden.
Een functie kan langs de x-as omhoog krommen en toch in zijn geheel een zadelpunt zijn, als een andere richting omlaag kromt. Controleer elke richting, of gebruik de eigenwaarden van de Hessiaan, die ze allemaal tegelijk dekken.
Een buigpunt beschrijft een verandering van kromming in één variabele. Een zadelpunt beschrijft gemengde kromming over meerdere variabelen op hetzelfde punt. Ze zijn verwant in het algemene idee, maar ze gelden niet voor hetzelfde type functie, en de wiskunde erachter is niet uitwisselbaar.
Het zadelpunt als kritisch punt en het minimax-zadelpunt delen een naam, geen definitie. Voordat je een Hessiaan-toets of eigenwaardenargument toepast, controleer welke betekenis hier speelt – speltheorie en adversariële optimalisatie gebruiken de minimax-versie, en die reduceert niet tot een krommingscheck op één enkele functie.
Een zadelpunt kromt in sommige richtingen omhoog en in andere omlaag, op dezelfde coördinaten – daarom is het noch een minimum noch een maximum, ook al gaat de gradiënt er net zo naar nul als bij beide.
Gradiënten vinden het kritische punt. De eigenwaarden van de Hessiaan, of de tweede-afgeleidentoets, vertellen je welk type je hebt. In hoge dimensies is dat onderscheid erg belangrijk, omdat zadelpunten talrijker zijn dan lokale minima, en trainingsalgoritmen zoals SGD en momentum bestaan deels om er voorbij te komen.
Nog één ding om uit elkaar te houden: het minimax-zadelpunt uit de speltheorie en GAN’s deelt de naam maar niet de wiskunde – zorg dus dat je weet naar welke je verwijst.
Als je het idee achter zadelpunten interessant vindt, is onze Deep Learning Track in Python iets voor jou. Naast de theorie gebruik je PyTorch om neurale netwerken te bouwen voor verschillende soorten problemen.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

