Même si toutes les dérivées partielles de votre fonction sont nulles, rien ne garantit que vous soyez au voisinage d’un minimum.
L’optimisation consiste à rechercher la plus petite ou la plus grande valeur d’une fonction, et toutes les méthodes cherchent un endroit où le gradient est plat. Mais un gradient plat ne garantit pas d’avoir trouvé la meilleure réponse. Parfois, la fonction monte dans une direction et descend dans une autre, exactement au même point.
Ce point s’appelle un point selle : il descend d’un côté, monte de l’autre, tout en étant plat autour. Les identifier est essentiel, car votre algorithme peut s’y enliser et prendre un gradient plat pour un véritable minimum.
Dans cet article, je vous montre comment repérer un point selle mathématiquement et pourquoi il déroute souvent les algorithmes d’optimisation.
Qu’est-ce qu’un point selle ?
En un point selle, le gradient est nul, tout comme en un minimum ou un maximum. Mais un point selle n’est ni l’un ni l’autre.
La fonction est convexe dans certaines directions et concave dans d’autres, exactement au même point. Si vous avancez le long d’un axe, la valeur augmente, et le long d’un autre axe, elle diminue. Le nom vient de la selle de cheval : relevée à l’avant et à l’arrière, creusée sur les côtés.
Voici une fonction à deux variables qui va nous servir d’exemple :
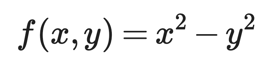
Fonction à deux variables
A l’origine (0, 0), les deux dérivées partielles sont nulles : c’est donc un point critique (ou point stationnaire). Le long de l’axe des x, f augmente à cause du terme x^2. Le long de l’axe des y, f diminue à cause du terme -y^2.
Si vous tracez cette fonction en 3D, la surface monte dans une direction et descend dans l’autre, formant la forme qui a donné son nom au point selle.
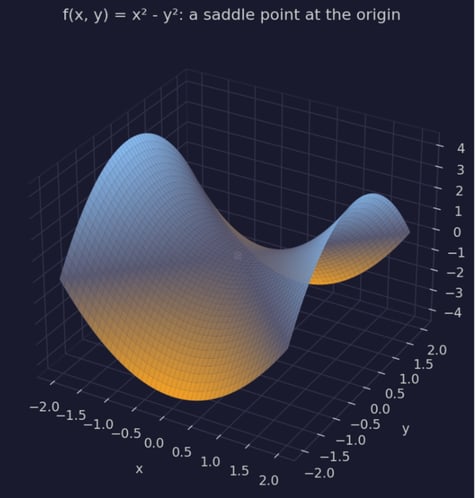
Représentation 3D de f(x, y) = x^2 - y^2
Une carte de niveaux de la même fonction raconte la même histoire vue de dessus. Autour de l’origine, les lignes de niveau ressemblent à des hyperboles, et non aux boucles fermées qu’on observe autour d’un minimum ou d’un maximum.
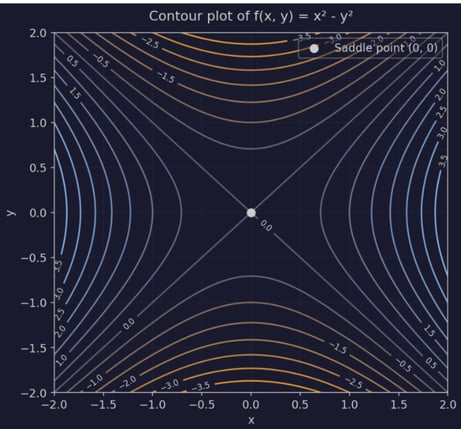
Carte de niveaux de f(x, y) = x^2 - y^2
La définition exacte varie selon le domaine. En calcul multivariable, un point selle est un point critique qui n’est ni un minimum local ni un maximum local. En optimisation et en théorie des jeux, le terme peut désigner autre chose, lié aux problèmes minimax plutôt qu’à la courbure. Je ferai cette distinction plus loin.
Points selles vs. minima et maxima
Avant de voir comment identifier un point selle mathématiquement, il est utile de le comparer aux deux autres types de points critiques.
Minimum local
En un minimum local, la fonction augmente dans toute direction voisine. Imaginez un bol : dès que vous vous éloignez du fond, vous montez. La fonction f(x, y) = x2 + y2 se comporte ainsi.
Maximum local
En un maximum local, la fonction diminue dans toute direction voisine. C’est l’image inversée d’un minimum : un dôme au lieu d’un bol. La fonction f(x, y) = -x2 - y2 diminue dans toutes les directions à mesure que vous vous éloignez de l’origine.
Point selle
En un point selle, la fonction augmente dans certaines directions et diminue dans d’autres. C’est ce qui fait de f(x, y) = x2 - y2, l’exemple précédent, un point selle plutôt qu’un minimum ou un maximum : elle monte le long de l’axe des x et descend le long de l’axe des y, au même point.
Voici une comparaison côte à côte des trois cas :
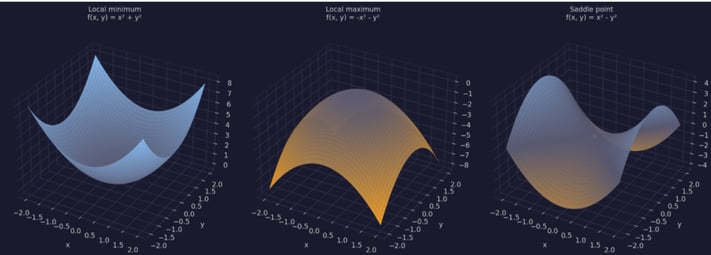
Surfaces 3D côte à côte d’un minimum local, d’un maximum local et d’un point selle
Trouver un point selle revient à calculer les dérivées, à localiser où elles s’annulent, puis à examiner la courbure de la fonction autour du point.
Je reprends la fonction précédente :
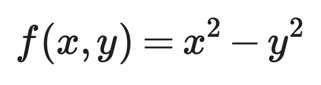
Fonction de référence
Voici la procédure, étape par étape.
1. Calculer les premières dérivées partielles
Dérivez f par rapport à x en traitant y comme constante, puis faites de même pour y :
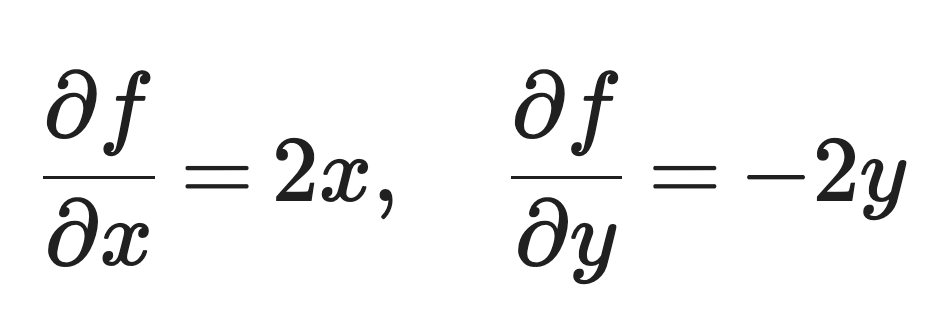
Calcul des premières dérivées partielles
2. Les annuler
Résolvez le point où les deux dérivées partielles s’annulent simultanément :
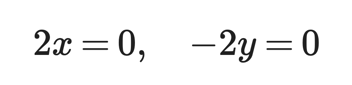
Annulation des dérivées
On obtient x = 0 et y = 0, donc (0, 0) est un point critique. Les premières dérivées ne suffisent pas à le classifier.
3. Calculer les secondes dérivées
Il en faut trois : la dérivée de f_x par rapport à x, celle de f_y par rapport à y, et la dérivée mixte :
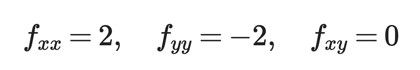
Secondes dérivées
4. Classer le point critique via la courbure
f_xx = 2 est positif : f est convexe le long de l’axe des x. f_yy = -2 est négatif : f est concave le long de l’axe des y. Une direction courbe vers le haut, l’autre vers le bas, au même point : c’est un point selle.
Ce processus en quatre étapes fonctionne pour toute fonction deux fois dérivable.
Dans les deux sections suivantes, je formalise l’étape 4 avec des outils qui passent à l’échelle au-delà de deux variables : la matrice hessienne et le test de la seconde dérivée.
La matrice hessienne regroupe toutes les secondes dérivées précédentes en un seul objet ; c’est l’outil qui indique si un point critique est un minimum, un maximum ou un point selle.
Pour une fonction de deux variables, la Hessienne s’écrit :
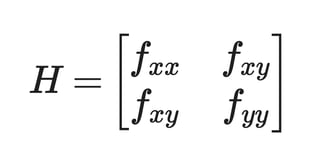
Hessienne pour une fonction à deux variables
Chaque terme décrit la courbure : f_xx et f_yy pour les axes x et y, et f_xy pour leur interaction. En injectant les secondes dérivées précédentes, la Hessienne de notre exemple devient :
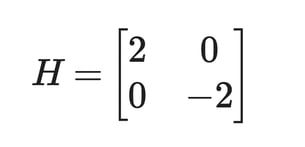
Hessienne de la fonction de référence
Une matrice seule dit peu de choses. Ce qui compte, ce sont ses valeurs propres — elles décrivent la courbure le long d’un ensemble particulier de directions, les vecteurs propres.
- Une valeur propre positive signifie que la fonction est convexe le long de la direction de son vecteur propre
- Une valeur propre négative signifie qu’elle est concave dans cette direction
- Un mélange de valeurs propres positives et négatives indique une courbure qui monte dans certaines directions et descend dans d’autres (un point selle)
Comme la Hessienne de notre exemple est diagonale, les valeurs propres sont celles de la diagonale : 2 et -2. Leurs vecteurs propres pointent le long des axes x et y, ce qui correspond exactement à la courbure constatée à la main. f est convexe le long de x (valeur propre positive) et concave le long de y (valeur propre négative).
La plupart des fonctions n’ont pas une Hessienne diagonale, les vecteurs propres ne s’alignent donc pas proprement sur les axes x et y. Il faut alors les calculer explicitement. Mais une valeur propre positive et une négative suffisent à conclure que vous êtes sur un point selle.
Le test de la seconde dérivée pour les points selles
Vous n’avez pas besoin de calculer les valeurs propres à la main à chaque fois. Pour les fonctions à deux variables, il existe un raccourci : le test de la seconde dérivée, basé sur le déterminant de la Hessienne.
Voici le déterminant, avec les mêmes secondes dérivées qu’avant :
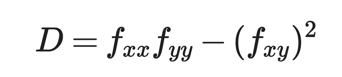
Le déterminant
D est le déterminant de la Hessienne. Son signe, combiné à celui de f_xx, permet de classer le point critique :
Dans notre exemple, f_xx = 2, f_yy = -2 et f_xy = 0 :
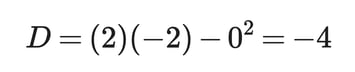
Test de la seconde dérivée pour la fonction de référence
D est négatif : le test confirme que (0, 0) est un point selle.
Ce test reformule la règle sur les valeurs propres sans avoir à les calculer : D est le produit des deux valeurs propres et f_xx + f_yy leur somme. Quand D est négatif, les valeurs propres ont des signes opposés : c’est un point selle. Quand D vaut zéro, au moins une valeur propre est nulle : la courbure est plate dans cette direction, et ni le test ni les valeurs propres seules ne suffisent à conclure.
Les points selles en optimisation
Jusqu’ici, il s’agissait d’identifier un point selle une fois la fonction donnée. En optimisation, vous cherchez le meilleur point sans le connaître à l’avance, et les méthodes basées sur le gradient s’arrêtent quand le gradient est nul.
C’est là que les points selles posent problème.
Un optimiseur fondé sur le gradient se déplace dans la direction qui réduit le plus vite la fonction objectif et continue jusqu’à ce que le gradient devienne proche de zéro. Mais un gradient quasi nul ne lui dit pas s’il a trouvé un minimum ou un point selle.
Les directions à courbure positive font remonter la fonction, et l’algorithme a appris qu’y aller empire la situation. Les directions à courbure négative existent toujours et constituent la sortie — mais un algorithme qui ne se fie qu’au gradient peut les manquer car, au point selle, le gradient y est aussi proche de zéro.
C’est aussi là que l’optimisation ralentit.
La norme du gradient diminue à l’approche de tout point stationnaire : un algorithme qui ajuste sa taille de pas à l’amplitude du gradient avance à petits pas près d’un point selle, qu’il soit ou non proche du minimum visé.
Trouver un point stationnaire n’est pas synonyme d’avoir terminé l’optimisation. Il faut encore distinguer un gradient quasi nul d’un point selle et d’un minimum, puis trouver la direction qui améliore encore l’objectif une fois la nature du point étayée.
Les points selles en apprentissage automatique
La fonction de perte d’un réseau de neurones dépend de tous ses poids et biais, parfois sur des millions ou des milliards de dimensions — bien loin d’un exemple à deux variables.
Dans une analyse de l’optimisation non convexe en grande dimension, Dauphin et coll. soutiennent qu’à mesure que le nombre de dimensions augmente, les points critiques sont bien plus susceptibles d’être des points selles que des minima ou maxima locaux. Chaque dimension ajoute une direction de courbure supplémentaire, et une seule direction à courbure négative suffit à transformer un point critique en point selle plutôt qu’en minimum.
Cela compte pendant l’entraînement parce que la descente de gradient ne voit que le gradient à l’endroit où elle se trouve.
Près d’un point selle, ce gradient devient faible dans toutes les directions — exactement le même signal que lorsque l’on approche d’un véritable minimum. L’entraînement peut ralentir ou stagner dans une région non optimale, et la courbe de perte seule ne permet pas de distinguer un minimum d’un point selle.
Voilà pourquoi les points selles apparaissent si souvent aux côtés des minima locaux quand on parle d’entraînement de réseaux de neurones. Mais ce ne sont pas les seuls obstacles : gradients évanescents, courbure mal conditionnée et échelle de l’espace de recherche compliquent l’optimisation en grande dimension.
Tout cela ne condamne pas pour autant les méthodes à base de gradient au voisinage d’un point selle. Plusieurs techniques permettent de les franchir, sous des angles différents.
Descente de gradient stochastique
La descente de gradient stochastique calcule le gradient sur un sous-ensemble aléatoire des données d’entraînement, qui change à chaque pas.
Le bruit ainsi introduit fait que le gradient estimé est rarement exactement nul, même quand le gradient véritable est proche de zéro. Ce bruit peut suffire à écarter l’optimiseur d’un point selle et à l’entraîner vers une direction à courbure négative, plutôt que de le laisser calé là où le gradient s’annule.
Momentum
Le momentum maintient une moyenne glissante des gradients passés et s’appuie dessus, plutôt que sur le seul gradient courant, pour choisir le prochain pas.
Autour d’un point selle, c’est crucial : l’optimiseur y arrive déjà en mouvement, porté par les gradients accumulés avant. Ce mouvement cumulé peut le faire traverser la zone plate autour du point selle, au lieu de ralentir dès que le gradient local approche zéro.
Méthodes du second ordre
Les méthodes du second ordre utilisent directement l’information de courbure.
En exploitant la Hessienne ou une approximation, elles distinguent directions à courbure positive et négative au point critique. C’est précisément ce qui caractérise un point selle, d’où la capacité à identifier une direction descendante et à s’y engager, au lieu de traiter tous les gradients quasi nuls de la même façon.
Points selles vs. notions voisines
Plusieurs termes sont souvent confondus avec les points selles ; clarifions-les.
Point selle vs. minimum local
Un minimum local courbe vers le haut dans toutes les directions proches : courbure positive partout. Un point selle n’est convexe que dans certaines directions et concave dans d’autres. Dès qu’une seule direction présente une courbure négative, vous n’êtes plus face à un minimum.
Point selle vs. maximum local
Le raisonnement symétrique vaut pour un maximum local : la courbure y est négative dans toutes les directions proches. Un point selle ajoute au moins une direction à courbure positive aux directions négatives.
Point selle vs. point d’inflection
Un point d’inflection est une notion unidimensionnelle : là où une courbe passe de concave à convexe (ou l’inverse) le long d’une seule variable.
Un point selle requiert au moins deux variables, car le concept repose sur la comparaison des courbures dans différentes directions au même point. Une fonction d’une variable peut avoir un point d’inflection, mais pas de point selle : il n’y a pas de seconde direction pour courber dans l’autre sens.
Point selle vs. point stationnaire
Tout point selle est stationnaire, puisque le gradient y est nul. L’inverse n’est pas vrai : un point stationnaire est simplement un point où le gradient est nul — il peut s’agir d’un minimum local, d’un maximum local ou d’un point selle. Il faut l’information de courbure (Hessienne ou test de la seconde dérivée) pour trancher.
Voici un récapitulatif visuel de ces comparaisons :
| | Profil de courbure | Lien avec les points selles |
|---|
| Minimum local | Positif dans toutes les directions | Jamais un point selle |
| Maximum local | Négatif dans toutes les directions | Jamais un point selle |
| Point d’inflection | Changement de concavité sur une variable | Concept différent, n’exige qu’une variable |
| Point stationnaire | Gradient nul | Un point selle est un type de point stationnaire |
Comparaison des points selles avec d’autres notions
Points selles en optimisation minimax
Jusqu’ici, « point selle » désignait la courbure d’un point critique. Il existe une seconde acception, plus ancienne, issue de la théorie des jeux, très présente en apprentissage moderne.
En optimisation minimax, un joueur minimise une fonction tandis qu’un autre la maximise. Un point selle est la paire de valeurs telle qu’aucun joueur ne peut améliorer son résultat en changeant seul son coup.
La théorie des jeux s’en sert pour décrire des stratégies d’équilibre dans les jeux compétitifs. L’optimisation adversariale reprend la même structure dans des problèmes où un processus cherche le pire cas que l’autre doit contrer.
Les generative adversarial networks (GANs) en sont le meilleur exemple en machine learning. Un générateur minimise sa perte en produisant de fausses données convaincantes, tandis qu’un discriminateur maximise sa capacité à distinguer le vrai du faux. Entraîner un GAN revient à chercher un point selle au sens minimax : un équilibre où chacun a trouvé sa meilleure réponse à l’autre.
Ce point selle minimax est lié au point selle de type point critique vu plus haut, mais les deux ne sont pas interchangeables.
La version « point critique » décrit la courbure locale d’une seule fonction. La version « minimax » décrit un équilibre entre deux objectifs antagonistes. Les deux partagent un vocabulaire car il est question de « haut » et « bas », mais les confondre ne vous mènera nulle part si vous tentez d’appliquer un test fondé sur la Hessienne à un jeu à deux joueurs.
Erreurs courantes avec les points selles
La plupart des confusions autour des points selles tiennent à quelques erreurs récurrentes. Voici l’essentiel.
Supposer qu’un gradient nul signifie un minimum
Un gradient nul indique un point critique, pas sa nature. Vérifiez la courbure avant de conclure : un point selle a, lui aussi, un gradient nul.
Classer un point avec les seules premières dérivées
Les premières dérivées repèrent les points critiques mais ne les classent pas. Il faut les secondes dérivées, via la Hessienne ou le test de la seconde dérivée, pour distinguer minimum, maximum et point selle.
Ignorer les différentes directions de courbure
Une fonction peut être convexe le long de l’axe des x tout en étant un point selle au global si une autre direction est concave. Examinez toutes les directions, ou utilisez les valeurs propres de la Hessienne, qui les couvrent toutes à la fois.
Confondre points selles et points d’inflection
Un point d’inflection décrit un changement de courbure sur une seule variable. Un point selle décrit une courbure mélangée sur plusieurs variables au même point. Les idées se ressemblent, mais ne s’appliquent pas aux mêmes fonctions et ne reposent pas sur la même analyse.
Traiter tous les sens de « point selle » comme identiques
Le point selle au sens « point critique » et le point selle minimax partagent un nom, pas une définition. Avant d’appliquer un test fondé sur la Hessienne ou un argument par valeurs propres, vérifiez de quel sens il s’agit : la théorie des jeux et l’optimisation adversariale utilisent le sens minimax, qui ne se résume pas à une vérification de la courbure d’une seule fonction.
Conclusion
Un point selle courbe vers le haut dans certaines directions et vers le bas dans d’autres, aux mêmes coordonnées : il n’est ni minimum ni maximum, même si le gradient s’y annule, comme dans les deux autres cas.
Les gradients trouvent le point critique. Les valeurs propres de la Hessienne, ou le test de la seconde dérivée, indiquent lequel. En grande dimension, cette distinction est cruciale : les points selles y dépassent en nombre les minima locaux, et des méthodes d’entraînement comme SGD et le momentum existent en partie pour les franchir.
Dernier point : le point selle minimax de la théorie des jeux et des GANs partage le nom mais pas les maths — assurez-vous de bien savoir de quel sens vous parlez.
Si le sujet des points selles vous intéresse, vous allez adorer notre Deep Learning Track in Python. Au-delà de la théorie, vous utiliserez PyTorch pour créer des réseaux de neurones adaptés à différents problèmes.







Même si toutes les dérivées partielles de votre fonction sont nulles, rien ne garantit que vous soyez au voisinage d’un minimum.
L’optimisation consiste à rechercher la plus petite ou la plus grande valeur d’une fonction, et toutes les méthodes cherchent un endroit où le gradient est plat. Mais un gradient plat ne garantit pas d’avoir trouvé la meilleure réponse. Parfois, la fonction monte dans une direction et descend dans une autre, exactement au même point.
Ce point s’appelle un point selle : il descend d’un côté, monte de l’autre, tout en étant plat autour. Les identifier est essentiel, car votre algorithme peut s’y enliser et prendre un gradient plat pour un véritable minimum.
Dans cet article, je vous montre comment repérer un point selle mathématiquement et pourquoi il déroute souvent les algorithmes d’optimisation.
Qu’est-ce qu’un point selle ?
En un point selle, le gradient est nul, tout comme en un minimum ou un maximum. Mais un point selle n’est ni l’un ni l’autre.
La fonction est convexe dans certaines directions et concave dans d’autres, exactement au même point. Si vous avancez le long d’un axe, la valeur augmente, et le long d’un autre axe, elle diminue. Le nom vient de la selle de cheval : relevée à l’avant et à l’arrière, creusée sur les côtés.
Voici une fonction à deux variables qui va nous servir d’exemple :
Fonction à deux variables
A l’origine
(0, 0), les deux dérivées partielles sont nulles : c’est donc un point critique (ou point stationnaire). Le long de l’axe des x,faugmente à cause du termex^2. Le long de l’axe des y,fdiminue à cause du terme-y^2.Si vous tracez cette fonction en 3D, la surface monte dans une direction et descend dans l’autre, formant la forme qui a donné son nom au point selle.
Représentation 3D de f(x, y) = x^2 - y^2
Une carte de niveaux de la même fonction raconte la même histoire vue de dessus. Autour de l’origine, les lignes de niveau ressemblent à des hyperboles, et non aux boucles fermées qu’on observe autour d’un minimum ou d’un maximum.
Carte de niveaux de f(x, y) = x^2 - y^2
La définition exacte varie selon le domaine. En calcul multivariable, un point selle est un point critique qui n’est ni un minimum local ni un maximum local. En optimisation et en théorie des jeux, le terme peut désigner autre chose, lié aux problèmes minimax plutôt qu’à la courbure. Je ferai cette distinction plus loin.
Points selles vs. minima et maxima
Avant de voir comment identifier un point selle mathématiquement, il est utile de le comparer aux deux autres types de points critiques.
Minimum local
En un minimum local, la fonction augmente dans toute direction voisine. Imaginez un bol : dès que vous vous éloignez du fond, vous montez. La fonction
f(x, y) = x2 + y2se comporte ainsi.Maximum local
En un maximum local, la fonction diminue dans toute direction voisine. C’est l’image inversée d’un minimum : un dôme au lieu d’un bol. La fonction
f(x, y) = -x2 - y2diminue dans toutes les directions à mesure que vous vous éloignez de l’origine.Point selle
En un point selle, la fonction augmente dans certaines directions et diminue dans d’autres. C’est ce qui fait de
f(x, y) = x2 - y2, l’exemple précédent, un point selle plutôt qu’un minimum ou un maximum : elle monte le long de l’axe des x et descend le long de l’axe des y, au même point.Voici une comparaison côte à côte des trois cas :
Surfaces 3D côte à côte d’un minimum local, d’un maximum local et d’un point selle
Comment trouver un point selle
Trouver un point selle revient à calculer les dérivées, à localiser où elles s’annulent, puis à examiner la courbure de la fonction autour du point.
Je reprends la fonction précédente :
Fonction de référence
Voici la procédure, étape par étape.
1. Calculer les premières dérivées partielles
Dérivez
fpar rapport àxen traitantycomme constante, puis faites de même poury:Calcul des premières dérivées partielles
2. Les annuler
Résolvez le point où les deux dérivées partielles s’annulent simultanément :
Annulation des dérivées
On obtient
x = 0ety = 0, donc(0, 0)est un point critique. Les premières dérivées ne suffisent pas à le classifier.3. Calculer les secondes dérivées
Il en faut trois : la dérivée de
f_xpar rapport àx, celle def_ypar rapport ày, et la dérivée mixte :Secondes dérivées
4. Classer le point critique via la courbure
f_xx = 2est positif :fest convexe le long de l’axe des x.f_yy = -2est négatif :fest concave le long de l’axe des y. Une direction courbe vers le haut, l’autre vers le bas, au même point : c’est un point selle.Ce processus en quatre étapes fonctionne pour toute fonction deux fois dérivable.
Dans les deux sections suivantes, je formalise l’étape 4 avec des outils qui passent à l’échelle au-delà de deux variables : la matrice hessienne et le test de la seconde dérivée.
Comment la matrice hessienne identifie les points selles
La matrice hessienne regroupe toutes les secondes dérivées précédentes en un seul objet ; c’est l’outil qui indique si un point critique est un minimum, un maximum ou un point selle.
Pour une fonction de deux variables, la Hessienne s’écrit :
Hessienne pour une fonction à deux variables
Chaque terme décrit la courbure :
f_xxetf_yypour les axesxety, etf_xypour leur interaction. En injectant les secondes dérivées précédentes, la Hessienne de notre exemple devient :Hessienne de la fonction de référence
Une matrice seule dit peu de choses. Ce qui compte, ce sont ses valeurs propres — elles décrivent la courbure le long d’un ensemble particulier de directions, les vecteurs propres.
Comme la Hessienne de notre exemple est diagonale, les valeurs propres sont celles de la diagonale :
2et-2. Leurs vecteurs propres pointent le long des axes x et y, ce qui correspond exactement à la courbure constatée à la main.fest convexe le long dex(valeur propre positive) et concave le long dey(valeur propre négative).La plupart des fonctions n’ont pas une Hessienne diagonale, les vecteurs propres ne s’alignent donc pas proprement sur les axes
xety. Il faut alors les calculer explicitement. Mais une valeur propre positive et une négative suffisent à conclure que vous êtes sur un point selle.Le test de la seconde dérivée pour les points selles
Vous n’avez pas besoin de calculer les valeurs propres à la main à chaque fois. Pour les fonctions à deux variables, il existe un raccourci : le test de la seconde dérivée, basé sur le déterminant de la Hessienne.
Voici le déterminant, avec les mêmes secondes dérivées qu’avant :
Le déterminant
Dest le déterminant de la Hessienne. Son signe, combiné à celui def_xx, permet de classer le point critique :D > 0etf_xx > 0: minimum localD > 0etf_xx < 0: maximum localD < 0: point selleD = 0: indéterminéDans notre exemple,
f_xx = 2,f_yy = -2etf_xy = 0:Test de la seconde dérivée pour la fonction de référence
Dest négatif : le test confirme que(0, 0)est un point selle.Ce test reformule la règle sur les valeurs propres sans avoir à les calculer :
Dest le produit des deux valeurs propres etf_xx + f_yyleur somme. QuandDest négatif, les valeurs propres ont des signes opposés : c’est un point selle. QuandDvaut zéro, au moins une valeur propre est nulle : la courbure est plate dans cette direction, et ni le test ni les valeurs propres seules ne suffisent à conclure.Les points selles en optimisation
Jusqu’ici, il s’agissait d’identifier un point selle une fois la fonction donnée. En optimisation, vous cherchez le meilleur point sans le connaître à l’avance, et les méthodes basées sur le gradient s’arrêtent quand le gradient est nul.
C’est là que les points selles posent problème.
Un optimiseur fondé sur le gradient se déplace dans la direction qui réduit le plus vite la fonction objectif et continue jusqu’à ce que le gradient devienne proche de zéro. Mais un gradient quasi nul ne lui dit pas s’il a trouvé un minimum ou un point selle.
Les directions à courbure positive font remonter la fonction, et l’algorithme a appris qu’y aller empire la situation. Les directions à courbure négative existent toujours et constituent la sortie — mais un algorithme qui ne se fie qu’au gradient peut les manquer car, au point selle, le gradient y est aussi proche de zéro.
C’est aussi là que l’optimisation ralentit.
La norme du gradient diminue à l’approche de tout point stationnaire : un algorithme qui ajuste sa taille de pas à l’amplitude du gradient avance à petits pas près d’un point selle, qu’il soit ou non proche du minimum visé.
Trouver un point stationnaire n’est pas synonyme d’avoir terminé l’optimisation. Il faut encore distinguer un gradient quasi nul d’un point selle et d’un minimum, puis trouver la direction qui améliore encore l’objectif une fois la nature du point étayée.
Les points selles en apprentissage automatique
La fonction de perte d’un réseau de neurones dépend de tous ses poids et biais, parfois sur des millions ou des milliards de dimensions — bien loin d’un exemple à deux variables.
Dans une analyse de l’optimisation non convexe en grande dimension, Dauphin et coll. soutiennent qu’à mesure que le nombre de dimensions augmente, les points critiques sont bien plus susceptibles d’être des points selles que des minima ou maxima locaux. Chaque dimension ajoute une direction de courbure supplémentaire, et une seule direction à courbure négative suffit à transformer un point critique en point selle plutôt qu’en minimum.
Cela compte pendant l’entraînement parce que la descente de gradient ne voit que le gradient à l’endroit où elle se trouve.
Près d’un point selle, ce gradient devient faible dans toutes les directions — exactement le même signal que lorsque l’on approche d’un véritable minimum. L’entraînement peut ralentir ou stagner dans une région non optimale, et la courbe de perte seule ne permet pas de distinguer un minimum d’un point selle.
Voilà pourquoi les points selles apparaissent si souvent aux côtés des minima locaux quand on parle d’entraînement de réseaux de neurones. Mais ce ne sont pas les seuls obstacles : gradients évanescents, courbure mal conditionnée et échelle de l’espace de recherche compliquent l’optimisation en grande dimension.
Comment les algorithmes d’optimisation gèrent les points selles
Tout cela ne condamne pas pour autant les méthodes à base de gradient au voisinage d’un point selle. Plusieurs techniques permettent de les franchir, sous des angles différents.
Descente de gradient stochastique
La descente de gradient stochastique calcule le gradient sur un sous-ensemble aléatoire des données d’entraînement, qui change à chaque pas.
Le bruit ainsi introduit fait que le gradient estimé est rarement exactement nul, même quand le gradient véritable est proche de zéro. Ce bruit peut suffire à écarter l’optimiseur d’un point selle et à l’entraîner vers une direction à courbure négative, plutôt que de le laisser calé là où le gradient s’annule.
Momentum
Le momentum maintient une moyenne glissante des gradients passés et s’appuie dessus, plutôt que sur le seul gradient courant, pour choisir le prochain pas.
Autour d’un point selle, c’est crucial : l’optimiseur y arrive déjà en mouvement, porté par les gradients accumulés avant. Ce mouvement cumulé peut le faire traverser la zone plate autour du point selle, au lieu de ralentir dès que le gradient local approche zéro.
Méthodes du second ordre
Les méthodes du second ordre utilisent directement l’information de courbure.
En exploitant la Hessienne ou une approximation, elles distinguent directions à courbure positive et négative au point critique. C’est précisément ce qui caractérise un point selle, d’où la capacité à identifier une direction descendante et à s’y engager, au lieu de traiter tous les gradients quasi nuls de la même façon.
Points selles vs. notions voisines
Plusieurs termes sont souvent confondus avec les points selles ; clarifions-les.
Point selle vs. minimum local
Un minimum local courbe vers le haut dans toutes les directions proches : courbure positive partout. Un point selle n’est convexe que dans certaines directions et concave dans d’autres. Dès qu’une seule direction présente une courbure négative, vous n’êtes plus face à un minimum.
Point selle vs. maximum local
Le raisonnement symétrique vaut pour un maximum local : la courbure y est négative dans toutes les directions proches. Un point selle ajoute au moins une direction à courbure positive aux directions négatives.
Point selle vs. point d’inflection
Un point d’inflection est une notion unidimensionnelle : là où une courbe passe de concave à convexe (ou l’inverse) le long d’une seule variable.
Un point selle requiert au moins deux variables, car le concept repose sur la comparaison des courbures dans différentes directions au même point. Une fonction d’une variable peut avoir un point d’inflection, mais pas de point selle : il n’y a pas de seconde direction pour courber dans l’autre sens.
Point selle vs. point stationnaire
Tout point selle est stationnaire, puisque le gradient y est nul. L’inverse n’est pas vrai : un point stationnaire est simplement un point où le gradient est nul — il peut s’agir d’un minimum local, d’un maximum local ou d’un point selle. Il faut l’information de courbure (Hessienne ou test de la seconde dérivée) pour trancher.
Voici un récapitulatif visuel de ces comparaisons :
Comparaison des points selles avec d’autres notions
Points selles en optimisation minimax
Jusqu’ici, « point selle » désignait la courbure d’un point critique. Il existe une seconde acception, plus ancienne, issue de la théorie des jeux, très présente en apprentissage moderne.
En optimisation minimax, un joueur minimise une fonction tandis qu’un autre la maximise. Un point selle est la paire de valeurs telle qu’aucun joueur ne peut améliorer son résultat en changeant seul son coup.
La théorie des jeux s’en sert pour décrire des stratégies d’équilibre dans les jeux compétitifs. L’optimisation adversariale reprend la même structure dans des problèmes où un processus cherche le pire cas que l’autre doit contrer.
Les generative adversarial networks (GANs) en sont le meilleur exemple en machine learning. Un générateur minimise sa perte en produisant de fausses données convaincantes, tandis qu’un discriminateur maximise sa capacité à distinguer le vrai du faux. Entraîner un GAN revient à chercher un point selle au sens minimax : un équilibre où chacun a trouvé sa meilleure réponse à l’autre.
Ce point selle minimax est lié au point selle de type point critique vu plus haut, mais les deux ne sont pas interchangeables.
La version « point critique » décrit la courbure locale d’une seule fonction. La version « minimax » décrit un équilibre entre deux objectifs antagonistes. Les deux partagent un vocabulaire car il est question de « haut » et « bas », mais les confondre ne vous mènera nulle part si vous tentez d’appliquer un test fondé sur la Hessienne à un jeu à deux joueurs.
Erreurs courantes avec les points selles
La plupart des confusions autour des points selles tiennent à quelques erreurs récurrentes. Voici l’essentiel.
Supposer qu’un gradient nul signifie un minimum
Un gradient nul indique un point critique, pas sa nature. Vérifiez la courbure avant de conclure : un point selle a, lui aussi, un gradient nul.
Classer un point avec les seules premières dérivées
Les premières dérivées repèrent les points critiques mais ne les classent pas. Il faut les secondes dérivées, via la Hessienne ou le test de la seconde dérivée, pour distinguer minimum, maximum et point selle.
Ignorer les différentes directions de courbure
Une fonction peut être convexe le long de l’axe des x tout en étant un point selle au global si une autre direction est concave. Examinez toutes les directions, ou utilisez les valeurs propres de la Hessienne, qui les couvrent toutes à la fois.
Confondre points selles et points d’inflection
Un point d’inflection décrit un changement de courbure sur une seule variable. Un point selle décrit une courbure mélangée sur plusieurs variables au même point. Les idées se ressemblent, mais ne s’appliquent pas aux mêmes fonctions et ne reposent pas sur la même analyse.
Traiter tous les sens de « point selle » comme identiques
Le point selle au sens « point critique » et le point selle minimax partagent un nom, pas une définition. Avant d’appliquer un test fondé sur la Hessienne ou un argument par valeurs propres, vérifiez de quel sens il s’agit : la théorie des jeux et l’optimisation adversariale utilisent le sens minimax, qui ne se résume pas à une vérification de la courbure d’une seule fonction.
Conclusion
Un point selle courbe vers le haut dans certaines directions et vers le bas dans d’autres, aux mêmes coordonnées : il n’est ni minimum ni maximum, même si le gradient s’y annule, comme dans les deux autres cas.
Les gradients trouvent le point critique. Les valeurs propres de la Hessienne, ou le test de la seconde dérivée, indiquent lequel. En grande dimension, cette distinction est cruciale : les points selles y dépassent en nombre les minima locaux, et des méthodes d’entraînement comme SGD et le momentum existent en partie pour les franchir.
Dernier point : le point selle minimax de la théorie des jeux et des GANs partage le nom mais pas les maths — assurez-vous de bien savoir de quel sens vous parlez.
Si le sujet des points selles vous intéresse, vous allez adorer notre Deep Learning Track in Python. Au-delà de la théorie, vous utiliserez PyTorch pour créer des réseaux de neurones adaptés à différents problèmes.