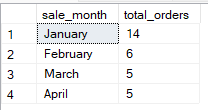

课程
PostgreSQL 汇总统计与窗口函数
4 小时
131.7K
实践并学习路径你的进步。
使用 Google 继续虽然按单列分组很常见,但按多列分组可以通过将具有共同取值的行分组来汇总大型数据集,从而更容易识别模式、趋势和异常值。
在本指南中,我将解释 GROUP BY 子句的工作原理、高级分组方法以及最佳实践。如果您是 SQL 新手,建议先学习我们的 Introduction to SQL 课程或 Intermediate SQL 课程来打好基础。另外,我认为可下载的 SQL Basics Cheat Sheet 非常实用,里面包含了最常用的 SQL 函数,便于随时查阅。
在解释如何在 SQL 中按多列分组之前,我们先来了解一下 GROUP BY 子句的基本概念。
GROUP BY 子句会将相同的数据组织成组。它扫描数据库中的行,然后将指定列中具有相同取值的行聚集成组,从而可以在这些组内进行数据聚合。
您可以将 GROUP BY 子句与 COUNT()、SUM()、AVG()、MIN() 和 MAX() 等聚合函数配合使用,对每个行组进行汇总计算。
假设您在分析销售数据并想知道每个地区的总收入。使用 GROUP BY,您可以按地区对销售进行分组,并在一条查询中计算每个地区的总和。
数据库在对单列执行 GROUP BY 时,会扫描各行并根据该列中的不同取值对其进行分段。每个不同取值形成一个组,聚合函数在每个组内计算结果。
然而,当引入多列时,SQL 会基于这些列的每一种唯一组合来分组数据。这意味着数据库会根据所有指定列的取值,将数据划分为更小、更细的组。
这种分区方式支持多维度聚合,对细致的商业智能与分析非常有用。它可以在多个维度的交叉点进行数据汇总,从而实现深入分析。例如,您可以按地区和产品类别对销售进行分组。
如您所见,按多列分组可以获得更多洞察。现在我们来看看 SQL 是如何处理这种分组的。
当您在 SQL 中按多个列分组时,数据库引擎会将列的组合视为复合键。每种唯一的组合都会形成一个独立的组。例如,按 region 和 product_type 对销售数据分组,会为每个唯一的二元组生成一个组,如 ('West', 'Electronics')、('East', 'Furniture') 等。
这会产生一种分层的子分组模式:第一列创建主要分组,第二列在这些主要分组内进一步划分为子组,依此类推。通过将信息细分到更具体的类别,这种分层分组增强了数据的粒度。
您还应注意分层分组与非分层分组的区别。分层分组遵循特定顺序的列分组与子分组;而非分层分组将每一列视为另一个维度,不遵循内在的层级关系。尽管如此,非分层分组也能为分析创造有用的组合,例如当您希望按季节对产品销售分组时。
在 SQL 中,您在 GROUP BY 子句中列出列的顺序非常重要。当按多列分组时,SQL 会将这些列一起视为一个组合键,就像把多个部件组合起来以唯一标识每个分组。
SQL 会从左到右处理列。这意味着它首先按您列出的第一列对数据进行分组,然后在每个组内,再按下一列进行分组,依次类推。这个顺序会影响数据库处理查询的效率、索引的使用方式以及中间分组的构建,尤其是在处理大型数据集时。
例如,如果您希望按地区和产品对数据分组,数据会先按地区分组,然后在每个地区内按产品分组。但如果将顺序切换为(产品、地区),您就改变了分组层级,这可能会导致报告中的结果与解读发生变化。
让我们来查看 SQL 中 GROUP BY 子句的语法及其变体,以便全面理解。
要在多列中使用 GROUP BY 子句,您必须在 SELECT 语句中用逗号列出每个列。随后数据库会基于这些列取值的唯一组合对行进行分组。
SELECT column1, column2, AGGREGATE_FUNCTION(column3)
FROM table_name
GROUP BY column1, column2;
请务必确保:所有在 SELECT 语句中出现但不在聚合函数内的列,都必须出现在 GROUP BY 子句中,以避免错误并确保聚合结果可读。
假设您有一个结构如下的 Sales 表:
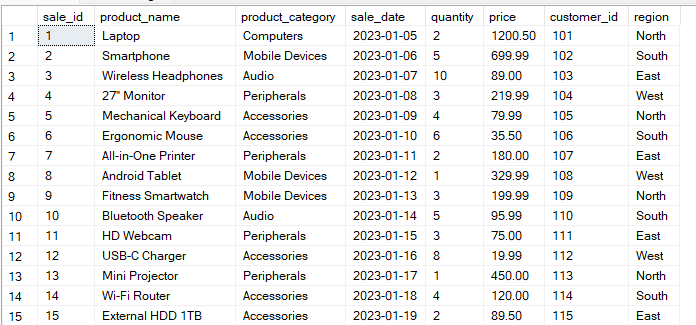
下面的查询按 region 和 product_category 两列对数据分组,然后计算每个组合的 total_sales。
-- Group Sales by region and product category
SELECT region, product_category, SUM(quantity) AS total_sales
FROM Sales
GROUP BY region, product_category;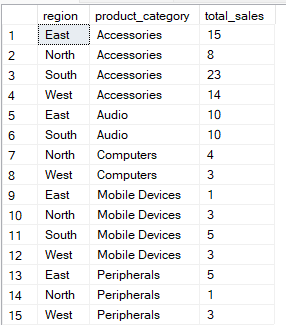
下面是一些在 SQL 中对多列使用 GROUP BY 子句的不同方法:
除了使用列名,SQL 还允许您在 GROUP BY 子句中用列的位置来指示列。在上面的示例中,1 指代 region 列,2 指代 product_category 列。该方法在 MySQL 和 PostgreSQL 中受支持,但在 SQL Server 中不支持。
-- Group Sales by region and product category
SELECT region, product_category, SUM(quantity) AS total_sales
FROM Sales
GROUP BY 1, 2;您也可以按派生表达式或计算值分组。这对于按转换后的数据进行分组很有用,例如从日期中提取年份或子串。例如,下面的查询按从 sale_date 派生的月份对销售进行分组。
-- Group Sales by month derived from date column
SELECT
    DATENAME(MONTH, sale_date) AS sale_month,
    COUNT(*) AS total_orders
FROM Sales
GROUP BY DATENAME(MONTH, sale_date), MONTH(sale_date)
ORDER BY MONTH(sale_date);
选择多列但仅按一列分组
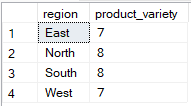
SQL 允许您选择多列但仅按一列分组,但附加列只能出现在聚合函数中。下面的示例中,只有 region 出现在 GROUP BY 子句中,而 product_id 在聚合函数 (COUNT(DISTINCT)) 中使用,因此该查询有效。
-- Group Sales by region only
SELECT region, COUNT(DISTINCT sale_id) AS product_variety
FROM Sales
GROUP BY region;
我建议您尝试我们的 Analyzing and Formatting PostgreSQL Sales Data 项目,了解如何在 PostgreSQL 中处理数据。此外,MySQL Basics Cheat Sheet 也是一个便捷的参考指南,适用于基本的表查询、数据筛选和数据聚合,尤其适合偏好使用 MySQL 的读者。
在 SQL 中,GROUP BY 子句的一大优势是可以与聚合函数结合使用,以获取分组数据的汇总。
当按多列分组时,聚合函数可以在不同数据组合上提供多维洞察。以下是与 GROUP BY 子句常搭配的函数:
SUM():对每个分组的数值列求和。
COUNT():统计每个分组的行数或非空值数量。
AVG():计算每个分组内的平均值。
MIN():找出每个分组中的最小值。
MAX():找出每个分组中的最大值。
例如,下面的查询会对每个地区与产品类别的组合,计算总销售量以及销售记录数。
-- Group by region, product_category then aggregate
SELECT region, product_category, SUM(quantity) AS total_sales, COUNT(*) AS sales_count
FROM Sales
GROUP BY region, product_category;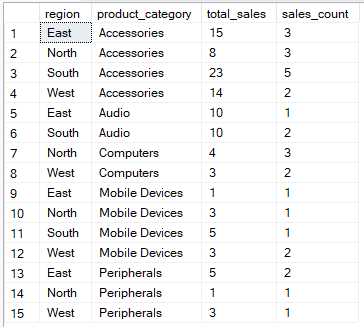
在上面的示例中,您已经看到 GROUP BY 子句与聚合函数一起使用。然而,如果您只想按指定列对行进行分组而不做汇总,也可以不使用聚合函数。
例如,下面的查询会在不做聚合的情况下输出地区与产品类别的唯一配对。因此,您可以用这种方法检查数据一致性。
--Group by multiple columns without aggregate
SELECT region, product_category
FROM Sales
GROUP BY region, product_category;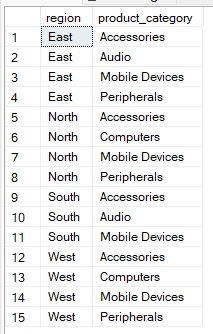
既然我们已经了解了如何按多列分组,接下来看看与 GROUP BY 子句配合使用的不同高级分组操作。
ROLLUP 操作在标准 GROUP BY 的基础上,沿指定列创建逐级汇总。除了展示明细分组外,它还会通过从右到左逐步聚合所分组的列,添加小计以及总计。
例如,在下面的查询中,您会得到 region 与 product_category 每种组合的 total_quantity。结果中包含每个地区的小计(此时 product_category 显示为 NULL),以及跨所有地区与类别求和的总计。
-- Group by region, product_category and ROLLUP by region
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY ROLLUP(region, product_category);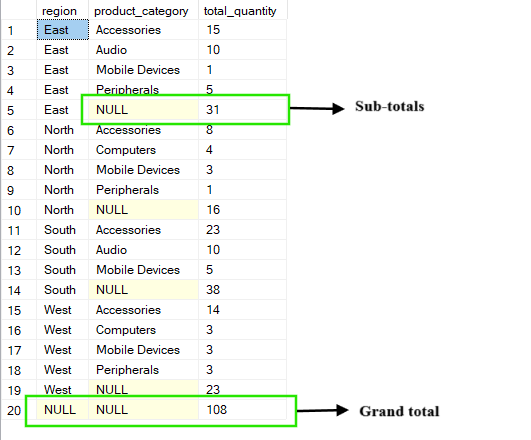
CUBE 操作会生成分组列的所有可能组合。与产生层级的 ROLLUP 不同,CUBE 会生成完整的数据立方体聚合。
它会对指定列的每个子集进行交叉汇总。CUBE 的输出包含每个列的汇总、每种列组合的汇总以及总计。
例如,如果我们对上表进行查询并按列(region、product_category)分组,CUBE 操作会产生以下组合:
(region,product_category)
(region,NULL)
(NULL,product_category)
(NULL,NULL),即总计
-- Group by multiple columns using CUBE operation
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY CUBE(region, product_category);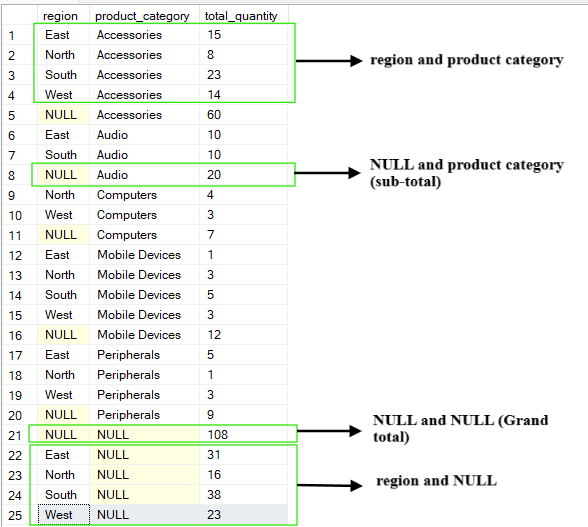
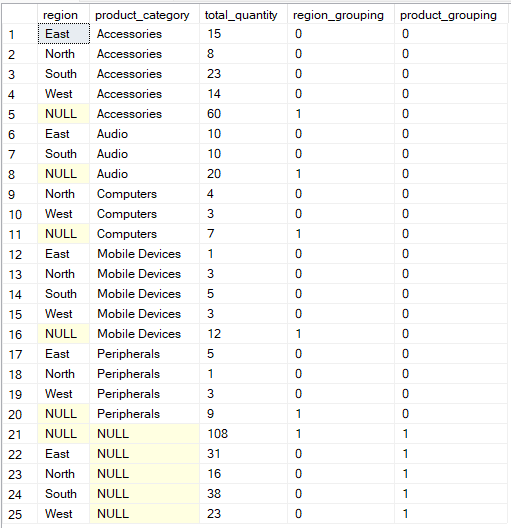
如果您希望更灵活地控制数据的分组方式,GROUPING SETS 操作允许您在一条查询中显式定义多个分组。
在这种情况下,GROUPING() 函数会提供关于结果中每一行所聚合列的元数据,用于识别表示小计或总计的 NULL,而非实际缺失数据。
-- Group by multiple columns using GROUPING SETS operation
SELECT region, product_category, SUM(quantity) AS total_quantity,
       GROUPING(region) AS region_grouping,
       GROUPING(product_category) AS product_grouping
FROM Sales
GROUP BY GROUPING SETS (
  (region, product_category),
  (region),
  (product_category),
  ()
);
在编写按多列分组的查询时,优化以提升效率和整体数据库性能非常重要。下面是一些我在查询优化和资源管理方面使用过的实用建议。
为了让您的查询运行顺畅并尽量少占用资源:
识别性能瓶颈:GROUP BY 查询在处理大型数据集时可能因为扫描、排序和聚合大量数据而变慢。为避免此问题,请务必使用 WHERE 子句尽早过滤,避免抓取不需要的数据。
有效使用索引:对列建立索引可以加速 GROUP BY 的执行。在 GROUP BY 子句所用列上创建复合索引,有助于数据库引擎快速定位并分组行,避免代价高昂的全表扫描或排序。
限制列数:只包含分组与分析所需的列,以降低复杂度并提升性能。
利用查询计划:在可用时,查看执行计划或使用查询提示,引导数据库优化器选择更优策略。
内存在 GROUP BY 查询性能中起着重要作用。排序与分组通常需要将中间数据保存在内存中。如果内存不足,性能会显著下降。
要更好地管理资源:
另外请记住,数据规模对性能影响很大。具有大量唯一分组组合的大型数据集会占用更多内存和算力。通过对大型表进行分区、预先创建汇总表或使用物化视图等技术,可以使之更易管理。
GROUP BY 子句可以与其他 SQL 子句良好配合,使查询更强大、更灵活。接下来,您将看到如何将 GROUP BY 与不同 SQL 子句结合的实用示例,以提升分析效果。
WHERE 子句在分组之前筛选行。它会限制数据集,使只有所需的行才参与聚合过程。例如,下面的查询按 region and product_category` 分组,但只包含地区为“North”的记录。
-- Group by multiple columns, filter using WHERE clause
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
WHERE region = 'North'
GROUP BY region, product_category;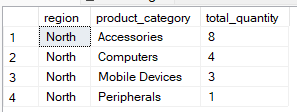
HAVING 子句则在聚合之后进行筛选。它根据聚合值来限制最终结果中出现的分组。下面的查询按 region and product_category 分组,但只包含 total_quantity` 大于 5 的记录。
-- Group by multiple columns, filter using HAVING clause
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY region, product_category
HAVING SUM(quantity) > 4;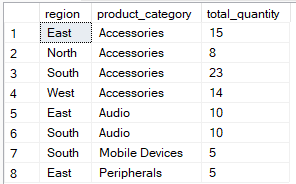
在 SQL 的执行顺序中,ORDER BY 子句位于 GROUP BY 之后,用于对分组结果进行排序,便于阅读或进一步处理。通过使用合适的索引,并在 ORDER BY 子句中谨慎选择列的顺序,您可以减少排序所需的工作量,从而加速查询。
例如,这条查询按 region 与 product_category 分组,然后按 total_quantity 从高到低排序,使得销量最高的分组优先显示。
-- Group by multiple columns, ORDER BY total_quantity
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY region, product_category
ORDER BY total_quantity DESC;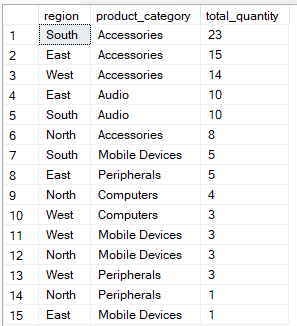
您还可以将 JOIN 操作与 GROUP BY 子句结合,跨多个相关表进行分组。使用该方法时需谨慎,因为连接更大规模的数据会引入复杂性。
-- Retrieve the number of sales per region and product category
SELECT
    c.region,
    p.product_category,
    COUNT(*) AS sales_count

-- Join customer, sales, and product data
FROM customers c
JOIN sales_data s
    ON c.customer_id = s.customer_id
JOIN products p
    ON s.product_id = p.product_id

-- Group results by region and product category
GROUP BY c.region, p.product_category

-- Order results by region first, then sales count in descending order
ORDER BY c.region, sales_count DESC;
我建议您学习我们的 Joining Data in SQL 课程,了解不同类型的连接以及如何在嵌套查询中使用它们。您也可以下载我们的 SQL Joins Cheat Sheet 作为参考,进一步了解在 SQL 中进行表连接。
GROUP BY 中的 CASE 表达式可以在分组过程中动态转换列值,实现自定义分组。
下面的查询按价格区间对产品进行分类,并统计每个地区与产品类别的总销量。
-- Categorize products by price range and count total quantity sold per region & product category
SELECT
  region,
  product_category,

  -- Categorize based on product price
  CASE
    WHEN price >= 1000 THEN 'High-Priced Products'
    WHEN price >= 500 THEN 'Mid-Priced Products'
    ELSE 'Low-Priced Products'
  END AS price_category,

  SUM(quantity) AS total_quantity

FROM Sales

-- Group by region, product category, and price category
GROUP BY
  region,
  product_category,
  CASE
    WHEN price >= 1000 THEN 'High-Priced Products'
    WHEN price >= 500 THEN 'Mid-Priced Products'
    ELSE 'Low-Priced Products'
  END

-- Sort results for easier interpretation
ORDER BY
  region,
  product_category,
  total_quantity DESC;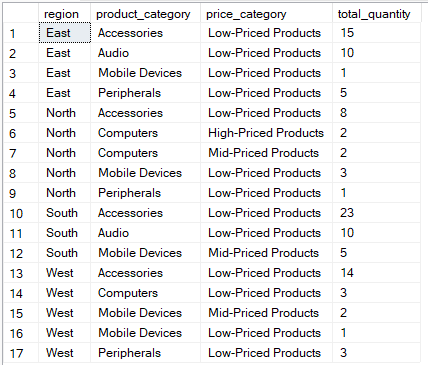
随着您持续使用 GROUP BY 对多列进行分组,您会逐渐识别出可提升使用效果的常见模式。我们将结合性能考量来讨论这些常见情形。
您可能已经注意到,大多数数据集都存在内在层级,例如地域(洲 → 国 → 城市)、产品类别或组织结构。因此,GROUP BY 非常适合在这些层级的不同层面进行汇总。
当面对包含日期和时间戳的数据时,按年、季度、月份或日期等时间组成部分进行分组的时间分析,有助于识别趋势、季节性和基于时间的行为。
前文我们提到了两种分组模式。分层分组涉及具有自然嵌套关系的列,例如先按部门分组,再在每个部门内按团队分组。相比之下,非分层分组会混合不相关的维度,如产品类型与支付方式,展示不含任何隐含顺序或结构的组合。
在使用多列 GROUP BY 时,遵循以下实用建议可提升性能:
减少分组列:务必确保只按分析所必需的列分组,以降低分组带来的计算开销。
索引优化:确保分组列建立了索引,以更高效地处理排序操作并加速查询性能。
尽早过滤:使用 WHERE 子句在分组前限制数据集,减少需要处理的数据量。
使用查询计划与提示:如果数据库支持,审阅执行计划或添加查询提示,以帮助优化分组过程。
利用高级 SQL 特性:考虑使用 ROLLUP 或 GROUPING SETS 等技术,更高效地创建汇总,避免重复运行查询,尤其是在处理分层或多维数据时。
GROUP BY 也可以作为清洗数据的实用手段,基于特定字段去除重复项。当数据集中存在多条完全相同或部分重复的记录时,这一点尤其有用。
例如,要移除重复的销售记录,您可以按 region、product_category 和 product_name 分组,然后为每个分组选择最高价格,以保留最具代表性的记录。
-- Remove duplicate sales records by keeping only unique combinations
-- of region, product_category, and product_name
SELECT
    region,
    product_category,
    product_name,
    MAX(price) AS price,
    SUM(quantity) AS total_quantity
FROM Sales
GROUP BY
    region,
    product_category,
    product_name
ORDER BY
    region,
    product_category,
product_name;在按多列使用 GROUP BY 时,请注意以下常见陷阱:
在 GROUP BY 查询中,最常见的错误之一与列指定不正确有关。SQL 要求 when selecting multiple columns not wrapped in an aggregate function, they must be included in the GROUP BY clause. Failing to do so results in an error. So, always include the non-aggregated columns in the GROUP BY clause if included in the SELECT statement.
当您按表达式分组时,如果数据存在不匹配情况,也可能会遇到错误。假设您按格式化日期分组,如果日期值的格式或精度层级不同,可能会导致意外或错误的结果。
使用 GROUP BY 查询有时会拖慢数据库,尤其是在按具有大量唯一值(高基数)的列分组或这些列未建立索引时。大型数据集在排序与分组阶段也需要足够的内存,这会进一步增加负载。
为避免这些问题,请始终为相关列建立索引,并使用 WHERE 进行过滤以限制查询数据。
此外,了解 SQL 在分组中如何处理 NULL 值也很重要:在分组列中,所有 NULL 都被视为同一组,无论出现多少个。然而,NULL 永远不等同于任何实际(非 NULL)值,因此这些分组始终彼此独立。
在 SQL 中使用 GROUP BY 按多列分组是一项强大的技术,它通过对字段组合进行聚合,实现更深入的多维分析。它使分析人员能够超越基础汇总,更好地洞察数据中的模式与关系。这一能力对于现代商业环境中的报告、绩效跟踪与决策制定至关重要。
随着数据在复杂性与规模上的增长,SQL 仍然是分析领域的基石。为进一步提升您的技能,建议探索窗口函数、公用表表达式(CTE)和物化视图,这些工具将为更高级的数据转换与报表流程打开大门。
我建议您学习我们的 PostgreSQL Summary Stats and Window Functions 课程,掌握如何像专业人士一样使用窗口函数编写商业分析查询。我也鼓励您挑战我们的项目:Analyzing Industry Carbon Emissions 和 Analyzing Motorcycle Part Sales,检验您的 SQL 技能,并展示您运用 SQL 解决商业问题的能力。
在 DataCamp 学习 SQL
课程
课程
实践并学习路径你的进步。
使用 Google 继续