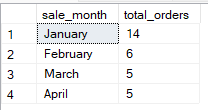

कोर्स
PostgreSQL Summary Stats और Window Functions
4 घंटा
131.3K
जहाँ एक ही कॉलम पर ग्रुप करना आम है, वहीं कई कॉलम पर ग्रुप करने से आप बड़े डेटा सेट्स का सारांश बना सकते हैं—ऐसी पंक्तियों को समूहबद्ध करके जिनके मान समान हों—जिससे पैटर्न, रुझान, और आउटलाईअर्स पहचानना आसान हो जाता है।
इस गाइड में, मैं बताऊँगा कि GROUP BY क्लॉज़ कैसे काम करता है, उन्नत ग्रुपिंग तरीके, और सर्वोत्तम प्रथाएँ। यदि आप SQL में नए हैं, तो हमारे Introduction to SQL कोर्स या Intermediate SQL कोर्स से शुरुआत करें ताकि मजबूत नींव बन सके। साथ ही, मुझे SQL Basics Cheat Sheet एक उपयोगी संदर्भ लगता है, जिसे आप डाउनलोड कर सकते हैं—इसमें सबसे सामान्य SQL फंक्शन्स एक जगह मिल जाते हैं।
इससे पहले कि मैं बताऊँ कि SQL में कई कॉलम पर ग्रुप कैसे करें, पहले GROUP BY क्लॉज़ की बुनियादी अवधारणाएँ समझते हैं।
SQL में GROUP BY क्लॉज़ समान डेटा को समूहों में संगठित करता है। यह डेटाबेस की पंक्तियों को स्कैन करता है और निर्दिष्ट कॉलमों में समान मान वाली पंक्तियों को एक साथ क्लस्टर करता है, जिससे इन समूहों के भीतर डेटा एग्रीगेशन संभव होता है।
आप GROUP BY को COUNT(), SUM(), AVG(), MIN(), और MAX() जैसे एग्रीगेट फंक्शन्स के साथ उपयोग कर सकते हैं ताकि हर समूह के लिए सारांश गणनाएँ की जा सकें।
मान लीजिए आप सेल्स डेटा का विश्लेषण कर रहे हैं और प्रति क्षेत्र कुल राजस्व जानना चाहते हैं। GROUP BY आपको क्षेत्र के आधार पर बिक्री को समूहबद्ध करने और एक ही क्वेरी में प्रत्येक के लिए योग निकालने देता है।
डेटाबेस एक कॉलम पर GROUP BY को पंक्तियों को स्कैन करके और उस कॉलम के विशिष्ट मानों के अनुसार उन्हें विभाजित करके प्रोसेस करता है। प्रत्येक विशिष्ट मान एक समूह बनाता है और एग्रीगेशन फंक्शन्स हर समूह के भीतर परिणाम निकालते हैं।
लेकिन जब आप कई कॉलम पेश करते हैं, तो SQL उन कॉलमों के हर अद्वितीय संयोजन के आधार पर डेटा को समूहबद्ध करता है। यानी डेटाबेस सभी निर्दिष्ट कॉलम मानों से परिभाषित छोटे, अधिक परिष्कृत समूहों में डेटा को विभाजित करता है।
यह विभाजन तरीका बहु-आयामी एग्रीगेशन की अनुमति देता है, जो विस्तृत बिजनेस इंटेलिजेंस और एनालिटिक्स के लिए उपयोगी है। यह कई आयामों के प्रतिच्छेदन पर डेटा का सारांश बनाकर गहन विश्लेषण सक्षम करता है। उदाहरण के लिए, आप बिक्री को क्षेत्र और उत्पाद श्रेणी के आधार पर समूहित कर सकते हैं।
जैसा कि आपने देखा, कई कॉलमों से डेटा को समूहबद्ध करने से आपको और अधिक अंतर्दृष्टि मिलती है। अब देखते हैं SQL इस ग्रुपिंग को कैसे संभालता है।
जब आप SQL में एक से अधिक कॉलम पर ग्रुप करते हैं, तो डेटाबेस इंजन कॉलम संयोजनों को कंपोज़िट कीज़ की तरह मानता है। इनमें से हर अद्वितीय संयोजन एक अलग समूह बनाता है। उदाहरण के लिए, region और product_type के आधार पर सेल्स डेटा ग्रुप करने से ('West', 'Electronics'), ('East', 'Furniture') जैसे प्रत्येक अद्वितीय जोड़े के लिए एक अलग समूह बनेगा।
इससे उप-समूहों का एक पदानुक्रमित पैटर्न बनता है, जहाँ पहला कॉलम प्राथमिक समूह बनाता है, दूसरा कॉलम उन प्राथमिक समूहों को और विभाजित करता है, और इसी तरह आगे। यह परतदार ग्रुपिंग सूचना को सूक्ष्म श्रेणियों में बाँटकर डेटा की ग्रैन्युलैरिटी बढ़ाती है।
ध्यान देने योग्य बात यह भी है कि पदानुक्रमित (hierarchical) और गैर-पदानुक्रमित (non-hierarchical) ग्रुपिंग में अंतर है। पदानुक्रमित ग्रुपिंग कॉलमों के एक विशिष्ट क्रम का पालन करती है—पहले समूह, फिर उप-समूह। दूसरी ओर, गैर-पदानुक्रमित ग्रुपिंग हर कॉलम को एक अलग आयाम मानती है और अंतर्निहित पदानुक्रम का पालन नहीं करती। फिर भी, गैर-पदानुक्रमित ग्रुपिंग विश्लेषण के लिए उपयोगी संयोजन बनाती है, जैसे जब आप उत्पाद बिक्री को सीज़न के आधार पर समूहित करना चाहते हैं।
SQL में, GROUP BY क्लॉज़ में कॉलमों को जिस क्रम में सूचीबद्ध करते हैं, वह वास्तव में मायने रखता है। जब आप कई कॉलमों पर ग्रुप करते हैं, तो SQL उन कॉलमों को एक संयुक्त कुंजी की तरह मानता है, जैसे कई टुकड़ों को जोड़कर हर समूह को विशिष्ट रूप से पहचानना।
SQL कॉलमों को बाएँ से दाएँ प्रोसेस करता है। यानी पहले वह आपके द्वारा सूचीबद्ध पहले कॉलम से डेटा को समूहित करता है, फिर हर समूह के भीतर अगले कॉलम से और समूह बनाता है, और इसी तरह। यह क्रम क्वेरी की दक्षता, इंडेक्स के उपयोग, और मध्यवर्ती ग्रुपिंग्स के निर्माण पर प्रभाव डाल सकता है, खासकर बड़े डेटा सेट्स पर काम करते समय।
उदाहरण के लिए, यदि आप अपने डेटा को क्षेत्र और उत्पाद के आधार पर समूहित करना चाहते हैं, तो डेटा पहले क्षेत्र के आधार पर समूहित होगा और फिर हर क्षेत्र के भीतर उत्पाद के आधार पर। लेकिन यदि आप क्रम को (उत्पाद, क्षेत्र) कर देते हैं, तो आप ग्रुपिंग का पदानुक्रम बदल देते हैं, जिससे आपकी रिपोर्टों में अलग-अलग परिणाम और व्याख्याएँ आ सकती हैं।
GROUP BY क्लॉज़ का पूरा अर्थ समझने के लिए इसके सिंटैक्स और विविधताओं पर नज़र डालते हैं।
एकाधिक कॉलमों के साथ GROUP BY का उपयोग करने के लिए, आपको हर कॉलम को SELECT स्टेटमेंट में कॉमा से अलग करके सूचीबद्ध करना होगा। फिर डेटाबेस उन कॉलम मानों के अद्वितीय संयोजनों के आधार पर पंक्तियों को समूहबद्ध करेगा।
SELECT column1, column2, AGGREGATE_FUNCTION(column3)
FROM table_name
GROUP BY column1, column2;
हमेशा सुनिश्चित करें कि SELECT स्टेटमेंट में प्रयुक्त वे सभी कॉलम जो एग्रीगेट फंक्शन्स का हिस्सा नहीं हैं, वे GROUP BY क्लॉज़ में अवश्य हों—ताकि त्रुटियाँ न आएँ और एग्रीगेशन पढ़ने योग्य रहे।
मान लीजिए आपके पास निम्नलिखित संरचना वाली Sales तालिका है:
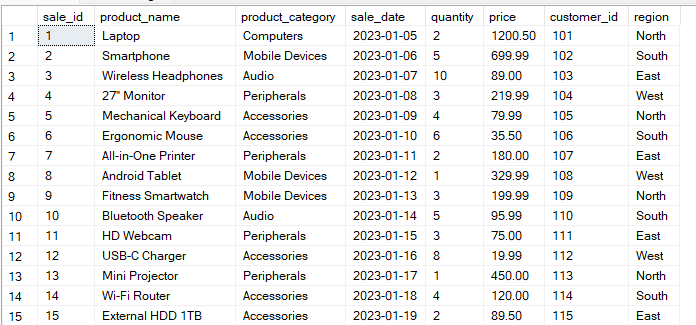
नीचे दी गई क्वेरी region और product_category कॉलम्स के आधार पर डेटा को समूहित करती है और फिर हर समूह संयोजन के लिए total_sales की गणना करती है।
-- Group Sales by region and product category
SELECT region, product_category, SUM(quantity) AS total_sales
FROM Sales
GROUP BY region, product_category;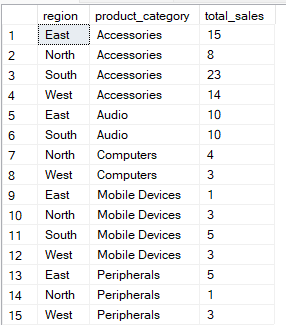
नीचे दिए गए तरीके दर्शाते हैं कि आप SQL में कई कॉलम्स पर GROUP BY क्लॉज़ का उपयोग कैसे कर सकते हैं:
कॉलम नामों के बजाय, SQL आपको GROUP BY क्लॉज़ में कॉलमों की स्थिति बताने की अनुमति देता है। हमारे पिछले उदाहरण में, 1 region कॉलम और 2 product_category कॉलम को संदर्भित करता है। यह तरीका MySQL और PostgreSQL में समर्थित है, लेकिन SQL Server में नहीं।
-- Group Sales by region and product category
SELECT region, product_category, SUM(quantity) AS total_sales
FROM Sales
GROUP BY 1, 2;आप व्युत्पन्न अभिव्यक्तियों या गणना किए गए मानों के आधार पर भी ग्रुप कर सकते हैं। यह परिवर्तित डेटा—जैसे किसी तिथि से वर्ष या सबस्ट्रिंग्स—के आधार पर ग्रुपिंग के लिए उपयोगी है। उदाहरण के लिए, नीचे दी गई क्वेरी sale_date से प्राप्त महीने के आधार पर बिक्री को समूहित करती है।
-- Group Sales by month derived from date column
SELECT
    DATENAME(MONTH, sale_date) AS sale_month,
    COUNT(*) AS total_orders
FROM Sales
GROUP BY DATENAME(MONTH, sale_date), MONTH(sale_date)
ORDER BY MONTH(sale_date);
कई कॉलम सेलेक्ट करना लेकिन केवल एक पर ग्रुप करना
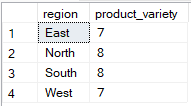
SQL आपको कई कॉलम सेलेक्ट करते हुए केवल एक पर ग्रुप करने की अनुमति देता है, बशर्ते अतिरिक्त कॉलम एग्रीगेट फंक्शन्स के अंदर उपयोग हों। नीचे के उदाहरण में केवल region GROUP BY में है, जबकि product_id एक एग्रीगेट फंक्शन (COUNT(DISTINCT)) में उपयोग हो रहा है, जिससे क्वेरी वैध रहती है।
-- Group Sales by region only
SELECT region, COUNT(DISTINCT sale_id) AS product_variety
FROM Sales
GROUP BY region;
मैं आपको हमारा Analyzing and Formatting PostgreSQL Sales Data प्रोजेक्ट आज़माने की सलाह देता/देती हूँ ताकि आप PostgreSQL में डेटा को कैसे मैनीपुलेट करें, यह समझ सकें। साथ ही MySQL Basics Cheat Sheet बेसिक क्वेरींग, डेटा फ़िल्टरिंग, और एग्रीगेशन के लिए एक बढ़िया संदर्भ है—खासकर यदि आप MySQL का उपयोग करना पसंद करते हैं।
SQL में GROUP BY क्लॉज़ का लाभ यह है कि आप इसे एग्रीगेट फंक्शन्स के साथ उपयोग करके समूहबद्ध डेटा का सारांश प्राप्त कर सकते हैं।
कई कॉलमों पर ग्रुपिंग करते समय एग्रीगेट फंक्शन्स विभिन्न डेटा संयोजनों में बहु-आयामी अंतर्दृष्टि देते हैं। GROUP BY क्लॉज़ के साथ आमतौर पर ये फंक्शन्स उपयोग होते हैं:
SUM(): प्रत्येक समूह के लिए किसी न्यूमेरिक कॉलम के सभी मानों का योग करता है।
COUNT(): प्रत्येक समूह में पंक्तियों या नॉन-NULL मानों की गिनती करता है।
AVG(): प्रत्येक समूह के भीतर औसत मान निकालता है।
MIN(): प्रत्येक समूह में सबसे छोटा मान ढूँढता है।
MAX(): प्रत्येक समूह में सबसे बड़ा मान ढूँढता है।
उदाहरण के लिए, नीचे दी गई क्वेरी हर क्षेत्र और उत्पाद श्रेणी के संयोजन के लिए कुल बिक्री और बिक्री रिकॉर्ड की गिनती निकालती है।
-- Group by region, product_category then aggregate
SELECT region, product_category, SUM(quantity) AS total_sales, COUNT(*) AS sales_count
FROM Sales
GROUP BY region, product_category;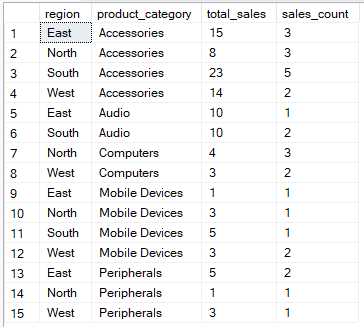
ऊपर दिए उदाहरणों में आपने देखा कि GROUP BY क्लॉज़ का उपयोग एग्रीगेट फंक्शन्स के साथ किया गया है। हालाँकि, यदि आप केवल निर्दिष्ट कॉलमों के आधार पर पंक्तियों को समूहबद्ध करना चाहते हैं, बिना सारांश निकाले, तो आप इसे एग्रीगेशन के बिना भी उपयोग कर सकते हैं।
उदाहरण के लिए, नीचे दी गई क्वेरी बिना एग्रीगेशन के क्षेत्र और उत्पाद श्रेणी के अद्वितीय जोड़े आउटपुट करती है। इस प्रकार आप डेटा स्थिरता की जाँच कर सकते हैं।
--Group by multiple columns without aggregate
SELECT region, product_category
FROM Sales
GROUP BY region, product_category;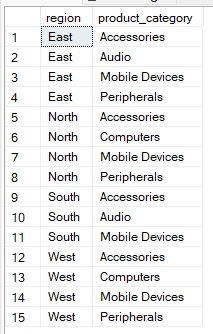
अब जब हमने देखा कि हम कई कॉलम पर कैसे ग्रुप कर सकते हैं, तो आइए GROUP BY क्लॉज़ के साथ उपयोग होने वाले उन्नत ग्रुपिंग ऑपरेशन्स पर नज़र डालें।
ROLLUP ऑपरेशन मानक GROUP BY पर आधारित है और निर्दिष्ट कॉलमों के साथ-साथ ऊपर की ओर जुड़ते हुए सारांश स्तर बनाता है। विस्तृत समूह दिखाने के अलावा, यह दाएँ से बाएँ क्रम में चरणबद्ध तरीके से एग्रीगेशन करके सबटोटल्स और एक ग्रैंड टोटल भी जोड़ता है।
उदाहरण के लिए, नीचे दी गई क्वेरी में, आपको region और product_category के प्रत्येक संयोजन के लिए total_quantity मिलता है। परिणामों में प्रत्येक क्षेत्र के लिए सबटोटल्स (जहाँ product_category NULL दिखाई देता है) और सभी क्षेत्रों व श्रेणियों में कुल योग का ग्रैंड टोटल शामिल होता है।
-- Group by region, product_category and ROLLUP by region
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY ROLLUP(region, product_category);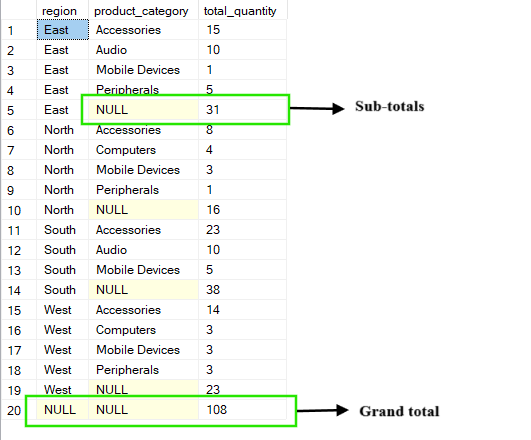
CUBE ऑपरेशन ग्रुपिंग कॉलम्स के सभी संभावित संयोजन उत्पन्न करता है। ROLLUP के विपरीत, जो एक पदानुक्रम बनाता है, CUBE एग्रीगेशन्स का एक पूरा डेटा क्यूब बनाता है।
यह निर्दिष्ट कॉलमों के हर सबसेट के लिए एग्रीगेशन का क्रॉस-टैबुलेशन प्रदान करता है। CUBE के आउटपुट में हर कॉलम के सारांश, कॉलम संयोजनों के सारांश, और ग्रैंड टोटल शामिल होते हैं।
उदाहरण के लिए, यदि हम ऊपर दी तालिका को क्वेरी करें और (region, product_category) कॉलम्स पर ग्रुप करें, तो CUBE ऑपरेशन निम्नलिखित संयोजन बनाएगा:
(region, product_category)
(region, NULL)
(NULL, product_category)
(NULL, NULL) जो ग्रैंड टोटल है
-- Group by multiple columns using CUBE operation
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY CUBE(region, product_category);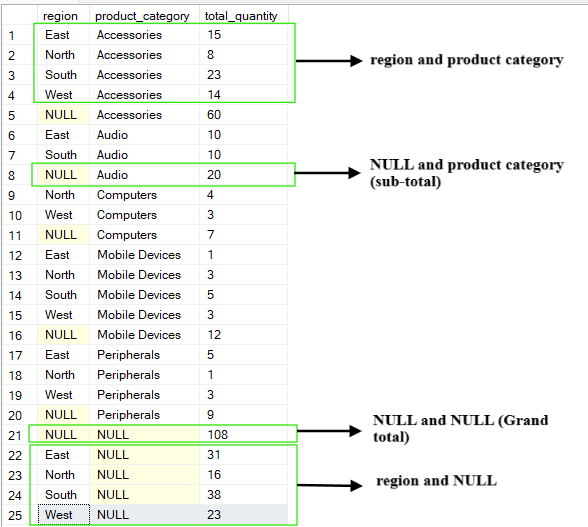
यदि आप डेटा की ग्रुपिंग पर अधिक लचीला नियंत्रण चाहते हैं, तो GROUPING SETS ऑपरेशन आपको एक ही क्वेरी में कई ग्रुपिंग्स स्पष्ट रूप से परिभाषित करने देता है।
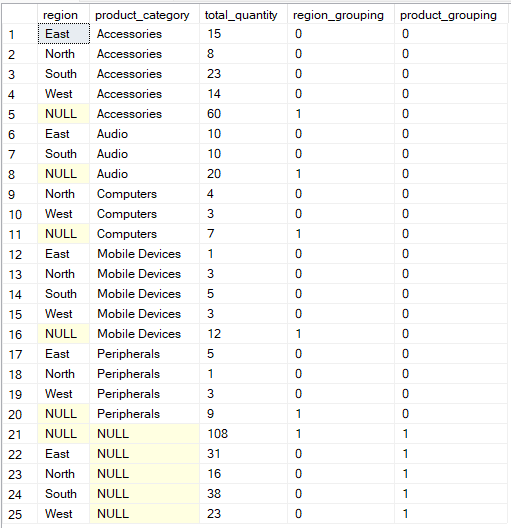
इसमें GROUPING() फंक्शन हर परिणाम पंक्ति में यह मेटाडेटा देता है कि किन कॉलमों पर एग्रीगेशन हुआ है, ताकि यह पहचाना जा सके कि कौन से NULL वास्तविक मिसिंग डेटा नहीं बल्कि सबटोटल या टोटल पंक्तियों का संकेत हैं।
-- Group by multiple columns using GROUPING SETS operation
SELECT region, product_category, SUM(quantity) AS total_quantity,
       GROUPING(region) AS region_grouping,
       GROUPING(product_category) AS product_grouping
FROM Sales
GROUP BY GROUPING SETS (
  (region, product_category),
  (region),
  (product_category),
  ()
);
जब आप कई कॉलम्स पर समूहबद्ध करने वाली क्वेरियाँ लिखते हैं, तो उन्हें बेहतर दक्षता और समग्र डेटाबेस परफ़ॉर्मेंस के लिए ऑप्टिमाइज़ करना महत्वपूर्ण है। नीचे कुछ व्यावहारिक टिप्स हैं जिनका उपयोग मैंने क्वेरी ऑप्टिमाइज़ेशन और संसाधन प्रबंधन में किया है।
अपनी क्वेरियों को सुचारू और कम संसाधनों में चलाने के लिए:
परफ़ॉर्मेंस बाधाओं की पहचान करें: बड़े डेटा सेट्स पर GROUP BY क्वेरियाँ स्कैनिंग, सॉर्टिंग, और बड़े पैमाने पर एग्रीगेशन के कारण धीमी हो सकती हैं। इससे बचने के लिए हमेशा WHERE क्लॉज़ के साथ शुरुआती फ़िल्टरिंग करें और गैर-ज़रूरी डेटा न फ़ेच करें।
इंडेक्सिंग का प्रभावी उपयोग करें: जिन कॉलमों पर GROUP BY होता है, उन्हें इंडेक्स करने से परफ़ॉर्मेंस तेज़ होती है। GROUP BY में प्रयुक्त कॉलम्स पर कम्पोज़िट इंडेक्स बनाने से डेटाबेस इंजन बिना महँगे फुल-टेबल स्कैन या सॉर्ट्स के, पंक्तियों को जल्दी ढूँढ और समूहित कर सकता है।
कॉलम सीमित रखें: केवल वही कॉलम शामिल करें जो आपके ग्रुपिंग और विश्लेषण के लिए आवश्यक हों—इससे जटिलता घटती है और परफ़ॉर्मेंस सुधरती है।
क्वेरी प्लान्स का लाभ लें: जहाँ उपलब्ध हो, एक्ज़ीक्यूशन प्लान्स देखें या क्वेरी हिंट्स का उपयोग करें ताकि ऑप्टिमाइज़र को बेहतर रणनीतियों की ओर मार्गदर्शन मिल सके।
मेमोरी GROUP BY क्वेरियों के परफ़ॉर्मेंस में बड़ी भूमिका निभाती है। सॉर्टिंग और ग्रुपिंग में अक्सर मध्यवर्ती डेटा को मेमोरी में रखना पड़ता है। यदि पर्याप्त मेमोरी नहीं है, तो चीजें काफी धीमी हो जाती हैं।
संसाधन बेहतर ढंग से प्रबंधित करने के लिए:
यह भी याद रखें कि आपके डेटा का आकार परफ़ॉर्मेंस पर बड़ा प्रभाव डालता है। कई अद्वितीय समूह संयोजनों वाले बड़े डेटा सेट्स अधिक मेमोरी और प्रोसेसिंग पावर इस्तेमाल करते हैं। बड़ी तालिकाओं का पार्टिशनिंग, पहले से सारांश तालिकाएँ बनाना, या मैटेरियलाइज़्ड व्यूज़ जैसी तकनीकें चीजों को प्रबंधनीय रखने में मदद करती हैं।
GROUP BY क्लॉज़ अन्य SQL क्लॉज़ के साथ अच्छी तरह काम करता है, जिससे आपकी क्वेरियाँ और शक्तिशाली और लचीली बनती हैं। आगे आप देखेंगे कि विश्लेषण को बेहतर बनाने के लिए GROUP BY को अलग-अलग SQL क्लॉज़ के साथ कैसे जोड़ा जाए।
WHERE क्लॉज़ ग्रुपिंग से पहले पंक्तियों को फ़िल्टर करता है। यह डेटा सेट को सीमित करता है ताकि एग्रीगेशन में केवल आवश्यक पंक्तियाँ ही शामिल हों। उदाहरण के लिए, नीचे दी गई क्वेरी region and product_category` के आधार पर ग्रुप करती है लेकिन केवल वे रिकॉर्ड शामिल करती है जहाँ क्षेत्र ‘North’ है।
-- Group by multiple columns, filter using WHERE clause
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
WHERE region = 'North'
GROUP BY region, product_category;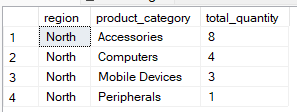
HAVING क्लॉज़, इसके विपरीत, एग्रीगेशन के बाद फ़िल्टर करता है। इसका उपयोग एग्रीगेट मानों के आधार पर अंतिम परिणाम में किन समूहों को शामिल किया जाए, यह सीमित करने के लिए होता है। नीचे की क्वेरी region and product_category पर ग्रुप करती है लेकिन केवल वे रिकॉर्ड शामिल करती है जहाँ total_quantity` 5 से अधिक है।
-- Group by multiple columns, filter using HAVING clause
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY region, product_category
HAVING SUM(quantity) > 4;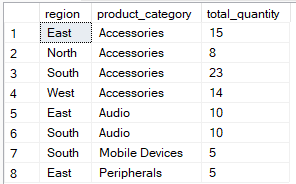
In SQL order of execution, the ORDER BY क्लॉज़ GROUP BY के बाद आता है और समूहित परिणामों को सॉर्ट करने के लिए उपयोग होता है, जिससे उन्हें पढ़ना या आगे प्रोसेस करना आसान हो जाता है। उचित इंडेक्स का उपयोग कर और ORDER BY में कॉलम क्रम सोच-समझकर चुनकर, आप डेटा सॉर्ट करने के काम को घटाकर अपनी क्वेरी तेज़ कर सकते हैं।
उदाहरण के लिए, यह क्वेरी region और product_category के आधार पर डेटा को समूहित करती है, फिर परिणामों को इस प्रकार सॉर्ट करती है कि सबसे अधिक total_quantity वाले समूह पहले आएँ।
-- Group by multiple columns, ORDER BY total_quantity
SELECT region, product_category, SUM(quantity) AS total_quantity
FROM Sales
GROUP BY region, product_category
ORDER BY total_quantity DESC;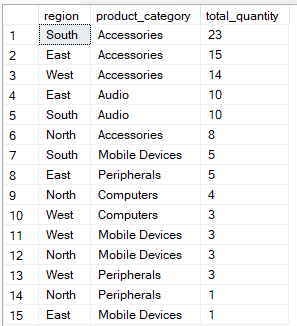
आप JOIN ऑपरेशन्स को GROUP BY के साथ मिलाकर कई संबद्ध तालिकाओं में फैले डेटा को भी समूहित कर सकते हैं। इस तरीके का उपयोग करते समय सावधानी रखें, क्योंकि बड़े आकार के डेटा को जोड़ने से जटिलता बढ़ सकती है।
-- Retrieve the number of sales per region and product category
SELECT
    c.region,
    p.product_category,
    COUNT(*) AS sales_count

-- Join customer, sales, and product data
FROM customers c
JOIN sales_data s
    ON c.customer_id = s.customer_id
JOIN products p
    ON s.product_id = p.product_id

-- Group results by region and product category
GROUP BY c.region, p.product_category

-- Order results by region first, then sales count in descending order
ORDER BY c.region, sales_count DESC;
मैं आपको हमारा Joining Data in SQL कोर्स लेने की सलाह देता/देती हूँ ताकि आप अलग-अलग प्रकार की जॉइन्स और उन्हें नेस्टेड क्वेरियों में कैसे उपयोग करें, सीख सकें। आप हमारा SQL Joins Cheat Sheet गाइड भी डाउनलोड कर सकते हैं, जिसमें SQL में डेटा जॉइन करने के बारे में संदर्भ सामग्री है।
GROUP BY में CASE अभिव्यक्ति समूह बनाने की प्रक्रिया के दौरान कॉलम मानों को गतिशील रूप से बदलकर कस्टम ग्रुपिंग की अनुमति देती है।
नीचे दी गई क्वेरी उत्पादों को मूल्य-श्रेणी के आधार पर वर्गीकृत करती है और प्रति क्षेत्र एवं उत्पाद श्रेणी कुल बेची गई मात्रा गिनती है।
-- Categorize products by price range and count total quantity sold per region & product category
SELECT
  region,
  product_category,

  -- Categorize based on product price
  CASE
    WHEN price >= 1000 THEN 'High-Priced Products'
    WHEN price >= 500 THEN 'Mid-Priced Products'
    ELSE 'Low-Priced Products'
  END AS price_category,

  SUM(quantity) AS total_quantity

FROM Sales

-- Group by region, product category, and price category
GROUP BY
  region,
  product_category,
  CASE
    WHEN price >= 1000 THEN 'High-Priced Products'
    WHEN price >= 500 THEN 'Mid-Priced Products'
    ELSE 'Low-Priced Products'
  END

-- Sort results for easier interpretation
ORDER BY
  region,
  product_category,
  total_quantity DESC;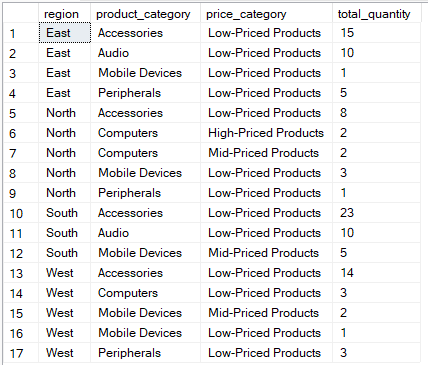
जैसे-जैसे आप कई कॉलम पर समूह बनाने के लिए GROUP BY का उपयोग जारी रखते हैं, आप उपयोग को बेहतर बनाने वाले बार-बार आने वाले पैटर्न पहचानने लगेंगे। हम इन सामान्य घटनाओं पर परफ़ॉर्मेंस विचारों के साथ चर्चा करेंगे।
आपने गौर किया होगा कि अधिकांश डेटा सेट्स में अंतर्निहित पदानुक्रम होते हैं, जैसे भूगोल (महाद्वीप → देश → शहर), उत्पाद श्रेणियाँ, या संगठनात्मक संरचनाएँ। इसलिए, GROUP BY इन पदानुक्रमों के विभिन्न स्तरों पर डेटा का सारांश बनाने के लिए उपयुक्त है।
तिथि और टाइमस्टैम्प वाले डेटा में, कालगत विश्लेषण वर्ष, तिमाही, माह, या दिन जैसे तिथि-भागों पर समूह बनाकर रुझान, मौसमीपन, और समय-आधारित व्यवहार पहचानने में मदद करता है।
पहले हमने दो प्रकार के ग्रुपिंग पैटर्न की बात की थी। पदानुक्रमित ग्रुपिंग में स्वाभाविक, नेस्टेड संबंध वाले कॉलम होते हैं—जैसे पहले विभाग के आधार पर, फिर हर विभाग के भीतर टीम के आधार पर। इसके विपरीत, गैर-पदानुक्रमित ग्रुपिंग असंबद्ध आयामों—जैसे उत्पाद प्रकार और भुगतान विधि—को मिलाती है और बिना किसी निहित क्रम या संरचना के संयोजन दिखाती है।
जब आप GROUP BY को कई कॉलम्स के साथ उपयोग करते हैं, तो इन व्यावहारिक सुझावों से परफ़ॉर्मेंस सुधार सकते हैं:
ग्रुपिंग कॉलम सीमित रखें: हमेशा सुनिश्चित करें कि आप केवल विश्लेषण के लिए आवश्यक कॉलम्स पर ही ग्रुप करें ताकि समूहों की संगणनात्मक ओवरहेड घटे।
इंडेक्स ऑप्टिमाइज़ेशन: समूहित कॉलम्स पर इंडेक्स सुनिश्चित करें ताकि डेटाबेस सॉर्टिंग ऑपरेशन्स को अधिक कुशलता से संभाल सके और क्वेरी परफ़ॉर्मेंस तेज़ हो।
शुरू में फ़िल्टर करें: ग्रुपिंग से पहले अपने डेटा सेट को सीमित करने के लिए WHERE क्लॉज़ का उपयोग करें ताकि प्रोसेस होने वाले डेटा की मात्रा घटे।
क्वेरी प्लान्स और हिंट्स का प्रयोग: यदि आपका डेटाबेस समर्थन करता है, तो एक्ज़ीक्यूशन प्लान्स की समीक्षा करें या क्वेरी हिंट्स जोड़ें ताकि ग्रुपिंग प्रक्रिया का ऑप्टिमाइज़ेशन हो सके।
एडवांस्ड SQL फीचर्स का लाभ लें: ROLLUP या GROUPING SETS जैसी तकनीकों का उपयोग करने पर विचार करें ताकि सारांश अधिक कुशलता से बन सकें और बार-बार क्वेरी चलाने से बचा जा सके—खासकर पदानुक्रमित या बहु-आयामी डेटा के साथ काम करते समय।
GROUP BY आपके डेटा को साफ़ करने का एक अच्छा तरीका भी हो सकता है—विशिष्ट फ़ील्ड्स के आधार पर डुप्लिकेट्स हटाने के लिए। यह तब उपयोगी है जब आपके डेटा सेट में एक जैसे या आंशिक रूप से डुप्लिकेट पंक्तियाँ हों।
उदाहरण के लिए, डुप्लिकेट सेल्स रिकॉर्ड्स हटाने के लिए, आप region, product_category, और product_name पर ग्रुप करेंगे और फिर हर समूह के लिए उच्चतम कीमत चुनेंगे ताकि सबसे प्रासंगिक रिकॉर्ड रखा जा सके।
-- Remove duplicate sales records by keeping only unique combinations
-- of region, product_category, and product_name
SELECT
    region,
    product_category,
    product_name,
    MAX(price) AS price,
    SUM(quantity) AS total_quantity
FROM Sales
GROUP BY
    region,
    product_category,
    product_name
ORDER BY
    region,
    product_category,
product_name;जब आप कई कॉलम्स पर GROUP BY के साथ काम करें, तो इन सामान्य गलतियों का ध्यान रखें:
GROUP BY क्वेरियों में सबसे आम त्रुटियाँ गलत कॉलम स्पेसिफिकेशन से जुड़ी होती हैं। SQL यह आवश्यक करता है कि when selecting multiple columns not wrapped in an aggregate function, they must be included in the GROUP BY clause. Failing to do so results in an error. इसलिए, यदि SELECT स्टेटमेंट में नॉन-एग्रीगेटेड कॉलम शामिल हैं, तो उन्हें हमेशा GROUP BY क्लॉज़ में शामिल करें।
यदि जिस डेटा को आप समूहित कर रहे हैं उसमें असंगतियाँ हैं—खासकर जब आप अभिव्यक्तियों के आधार पर समूह बना रहे हों—तो त्रुटियाँ आ सकती हैं। मान लीजिए आप अपने डेटा को फ़ॉर्मैटेड डेट के आधार पर समूहित कर रहे हैं; ऐसे में यदि दिनांक मानों के फ़ॉर्मेट या प्रिसीज़न अलग-अलग हैं, तो अप्रत्याशित या गलत परिणाम मिल सकते हैं।
GROUP BY क्वेरियाँ कभी-कभी आपके डेटाबेस को धीमा कर सकती हैं—खासकर यदि आप ऐसे कॉलम्स पर ग्रुप कर रहे हैं जिनमें बहुत सारे अद्वितीय मान (उच्च कार्डिनैलिटी) हैं या उन कॉलम्स पर इंडेक्स नहीं है। बड़े डेटा सेट्स को सॉर्टिंग और ग्रुपिंग चरणों के लिए पर्याप्त मेमोरी भी चाहिए, जिससे लोड बढ़ता है।
इन समस्याओं से बचने के लिए, हमेशा कॉलम्स को इंडेक्स करें और WHERE का उपयोग करके क्वेरी किए जाने वाले डेटा को सीमित करें।
साथ ही, यह जानना महत्वपूर्ण है कि SQL ग्रुपिंग में NULL मानों को कैसे संभालता है: किसी ग्रुपिंग कॉलम में जितने भी NULL हों, वे सभी एक ही समूह माने जाते हैं। हालाँकि, NULL कभी भी किसी वास्तविक (नॉन-NULL) मान के बराबर नहीं माना जाता, इसलिए वे समूह अलग-अलग ही रहते हैं।
SQL में GROUP BY क्लॉज़ का उपयोग करके कई कॉलम्स पर ग्रुप करना एक शक्तिशाली तकनीक है, जो फ़ील्ड संयोजनों में एग्रीगेशन के माध्यम से गहरी, बहु-आयामी विश्लेषण को सक्षम करती है। यह विश्लेषकों को बुनियादी सारांशों से आगे जाकर डेटा के भीतर पैटर्न और संबंधों पर अधिक अंतर्दृष्टि पाने देता है। यह क्षमता आधुनिक बिज़नेस वातावरण में रिपोर्टिंग, परफ़ॉर्मेंस ट्रैकिंग, और निर्णय-निर्माण के लिए महत्वपूर्ण है।
जैसे-जैसे डेटा जटिलता और मात्रा में बढ़ता है, SQL एनालिटिक्स का एक बुनियादी उपकरण बना रहता है। अपने कौशल को और निखारने के लिए, विंडो फंक्शन्स, कॉमन टेबल एक्सप्रेशन्स (CTEs), और मैटेरियलाइज़्ड व्यूज़ को एक्सप्लोर करें—जो और भी उन्नत डेटा ट्रांसफ़ॉर्मेशन्स और रिपोर्टिंग वर्कफ़्लोज़ का रास्ता खोलते हैं।
मैं आपको हमारा PostgreSQL Summary Stats and Window Functions कोर्स लेने की सलाह देता/देती हूँ ताकि आप विंडो फंक्शन्स का उपयोग करके बिज़नेस एनालिटिक्स वाली क्वेरियाँ प्रोफ़ेशनल की तरह लिखना सीख सकें। मैं आपको ये प्रोजेक्ट्स भी आज़माने की चुनौती देता/देती हूँ: Analyzing Industry Carbon Emissions और Analyzing Motorcycle Part Sales—ताकि आप अपने SQL कौशल का परीक्षण कर सकें और यह दिखा सकें कि आप बिज़नेस समस्याओं को SQL से कैसे हल करते हैं।
DataCamp के साथ SQL सीखें
कोर्स
कोर्स
कोर्स