

在 SQL 中将行透视为列是什么意思?
在 SQL 中,透视指的是把基于行的格式转换为基于列的格式。此转换有助于报告与数据分析,便于获得更结构化、更紧凑的数据视图。将行透视为列还能让用户以更清晰地突出关键信息的方式来分析与汇总数据。
请看以下示例:我有一张每日销售交易的表,每一行记录日期、产品名称和销售额。
| 日期 | 产品 | 销售额 |
|---|---|---|
| 2024-01-01 | 笔记本电脑 | 100 |
| 2024-01-01 | 鼠标 | 200 |
| 2024-01-02 | 笔记本电脑 | 150 |
| 2024-01-02 | 鼠标 | 250 |
通过对这张表进行透视,我可以把每个产品重塑为一列,各日期对应的销售数据置于相应列下。请注意,这里也进行了聚合。
| 日期 | 笔记本电脑 | 鼠标 |
|---|---|---|
| 2024-01-01 | 100 | 200 |
| 2024-01-02 | 150 | 250 |
传统上,透视操作需要使用条件聚合的复杂 SQL 查询。随着时间推移,SQL 的实现不断发展,许多现代数据库现在包含 PIVOT 和 UNPIVOT 运算符,使转换更高效、更直观。
理解 SQL 将行透视为列
SQL 透视操作通过将行值转换为列来重塑数据。以下是 SQL 透视的基本语法和结构,由以下部分组成:
-
SELECT:
SELECT语句引用要在 SQL 透视表中返回的列。 -
子查询: 子查询包含要纳入 SQL 透视表的数据源或表。
-
PIVOT:
PIVOT运算符包含要在透视表中应用的聚合与筛选。
-- Select static columns and pivoted columns
SELECT <static columns>, [pivoted columns]
FROM
(
-- Subquery defining source data for pivot
<subquery that defines data>
) AS source
PIVOT
(
-- Aggregate function applied to value column, creating new columns
<aggregation function>(<value column>)
FOR <column to pivot> IN ([list of pivoted columns])
) AS pivot_table;让我们通过以下循序渐进的示例来演示如何在 SQL 中将行透视为列。请看下面的 SalesData 表。
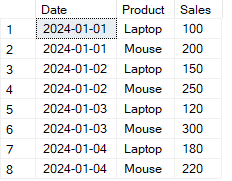
使用 SQL PIVOT 运算符进行转换的表示例。图片来源:作者。
我希望对这些数据进行透视,以比较各产品的每日销售。我将先选择结构化 PIVOT 运算符所需的子查询。
-- Subquery defining source data for pivot
SELECT Date, Product, Sales
FROM SalesData;现在,我将使用 PIVOT 运算符把 Product 的取值转换为列,并使用 SUM 对 Sales 进行聚合。
-- Select Date and pivoted columns for each product
SELECT Date, [Laptop], [Mouse]
FROM
(
-- Subquery to fetch Date, Product, and Sales columns
SELECT Date, Product, Sales FROM SalesData
) AS source
PIVOT
(
-- Aggregate Sales by Product, pivoting product values to columns
SUM(Sales)
FOR Product IN ([Laptop], [Mouse])
) AS pivot_table;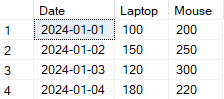
在 SQL 中将行透视为列的输出转换示例。图片来源:作者。
虽然透视能简化数据汇总,但也可能带来一些问题。以下是 SQL 透视可能遇到的挑战及其应对方法。
-
动态列名: 当要透视的取值(如产品类型)未知时,硬编码列名将不可行。某些数据库(如 SQL Server)支持结合存储过程的动态 SQL 以规避该问题,其他数据库则需要在应用层处理。
-
处理 NULL 值: 当某个透视列没有数据时,结果中可能出现
NULL。您可以使用COALESCE将NULL替换为 0 或其他占位符。 -
跨数据库兼容性: 并非所有数据库都直接支持
PIVOT运算符。如果您的 SQL 方言不支持,仍可通过CASE语句和条件聚合实现类似效果。
SQL 行转列:示例与用例
在 SQL 中进行透视的方法因所用数据库或其他需求而异。尽管 PIVOT 运算符在 SQL Server 中常用,其他技术(如 CASE 语句)也能在没有直接 PIVOT 支持的情况下实现类似的数据转换。我将介绍两种常见的透视方法,并讨论其优缺点。
使用 PIVOT 运算符
在 SQL Server 中可用的 PIVOT 运算符,通过指定聚合函数并定义要透视的列,提供了一种将行转为列的直接方式。
考虑下表 sales_data。
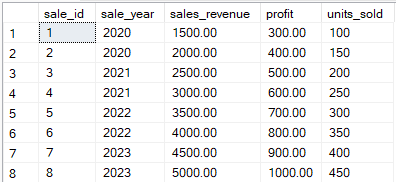
使用 PIVOT 运算符转换的订单表示例。图片来源:作者。
我将使用 PIVOT 来聚合数据,使每一年的总 sales_revenue 以列的形式展示。
-- Use PIVOT to aggregate sales revenue by year
SELECT *
FROM (
-- Select the relevant columns from the source table
SELECT sale_year, sales_revenue
FROM sales_data
) AS src
PIVOT (
-- Aggregate sales revenue for each year
SUM(sales_revenue)
-- Create columns for each year
FOR sale_year IN ([2020], [2021], [2022], [2023])
) AS piv;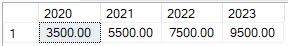
使用 SQL PIVOT 的输出转换示例。图片来源:作者。
使用 PIVOT 的优点与局限如下:
-
优点: 当列建立了合适索引时效率较高;语法简洁、可读性强。
-
局限: 并非所有数据库都支持
PIVOT;需要事先指定列名,动态透视会增加额外复杂度。
使用 CASE 语句手动透视
在不支持 PIVOT 的数据库(如 MySQL 和 PostgreSQL)中,您也可以使用 CASE 语句手动透视数据。该方法利用条件聚合,通过评估每一行并依据特定条件将值有条件地赋给新列来实现。
例如,我们可以在同一张 sales_data 表上用 CASE 语句手动透视。
-- Aggregate sales revenue by year using CASE statements
SELECT
-- Calculate total sales revenue for each year
SUM(CASE WHEN sale_year = 2020 THEN sales_revenue ELSE 0 END) AS sales_2020,
SUM(CASE WHEN sale_year = 2021 THEN sales_revenue ELSE 0 END) AS sales_2021,
SUM(CASE WHEN sale_year = 2022 THEN sales_revenue ELSE 0 END) AS sales_2022,
SUM(CASE WHEN sale_year = 2023 THEN sales_revenue ELSE 0 END) AS sales_2023
FROM
sales_data;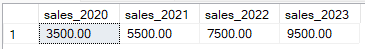
使用 SQL CASE 语句的输出转换示例。图片来源:作者。
使用 CASE 进行转换的优点与局限如下:
-
优点: 该方法适用于所有 SQL 数据库;即使产品名称未知或频繁变化,也可灵活动态生成新列。
-
局限: 若需透视的列很多,查询可能变得冗长且复杂;由于存在多次条件判断,其性能通常略慢于
PIVOT。
将行透视为列时的性能考量
在大型数据集上,将行透视为列可能会带来性能影响。以下是一些技巧与最佳实践,帮助您编写高效的透视查询、优化其性能并避免常见陷阱。
最佳实践
以下是优化查询并提升性能的最佳实践。
-
索引策略: 合理的索引对优化透视查询至关重要,可加速 SQL 的数据检索与处理。始终为经常用于
WHERE子句或用于分组的列建立索引,以降低扫描时间。 -
避免嵌套透视: 在一个查询中堆叠多个透视操作可读性差且执行更慢。可拆分查询或使用临时表简化处理。
-
限制透视的列与行: 仅透视分析所需的列。透视过多列会消耗大量资源并生成庞大表格。
避免常见陷阱
以下是透视查询中常见错误及其规避方法。
-
不必要的全表扫描: 透视查询可能触发全表扫描,尤其在缺乏相关索引时。通过为关键列建立索引并在透视前先筛选数据来避免全表扫描。
-
频繁透视使用动态 SQL: 动态 SQL 会因查询重新编译而拖慢性能。可通过缓存或仅在特定场景使用动态透视来避免,并在可能时考虑于应用层处理动态列。
-
在未预筛选的大数据集上进行聚合: 在大型数据集上对
SUM或COUNT等函数进行聚合会降低数据库性能。应先使用WHERE子句筛选,再对结果进行透视。 -
透视列中的 NULL 值: 当某列无数据时,透视操作常会产生
NULL。这会拖慢查询并使结果难以解读。可使用COALESCE等函数将NULL替换为默认值。 -
仅用样本数据测试: 由于内存与处理需求增加,透视查询在大数据集上的表现可能不同。务必在真实或具代表性的数据样本上进行测试,以准确评估性能影响。
试试我们的 SQL Server Developer 职业路径,涵盖从事务与错误处理到查询性能优化的各个方面。
面向不同数据库的实现
SQL Server、MySQL 和 Oracle 等数据库在透视操作上差异显著。每种数据库都有特定语法与限制。我将展示在不同数据库中进行数据透视的示例及其关键特性。
SQL Server
SQL Server 提供内置的 PIVOT 运算符,将行透视为列非常直观。PIVOT 易于使用,并可与 SQL Server 强大的聚合函数集成。其关键特性包括:
-
直接支持 PIVOT 与 UNPIVOT: SQL Server 的
PIVOT可快速实现行转列;UNPIVOT则可逆向完成该过程。 -
聚合选项:
PIVOT支持多种聚合函数,如SUM、COUNT与AVG。
SQL Server 中 PIVOT 的限制在于需要预先知道要透视的列值,对动态变化的数据不够灵活。
在下例中,PIVOT 将 Product 的取值转换为列,并使用 SUM 对 Sales 聚合。
-- Select Date and pivoted columns for each product
SELECT Date, [Laptop], [Mouse]
FROM
(
-- Subquery to fetch Date, Product, and Sales columns
SELECT Date, Product, Sales FROM SalesData
) AS source
PIVOT
(
-- Aggregate Sales by Product, pivoting product values to columns
SUM(Sales)
FOR Product IN ([Laptop], [Mouse])
) AS pivot_table;建议学习 DataCamp 的 Introduction to SQL Server 课程,掌握用于数据分析的 SQL Server 基础。
MySQL
MySQL 并不原生支持 PIVOT 运算符。不过,您可以使用 CASE 语句手动将行透视为列,并结合 SUM、AVG、COUNT 等聚合函数。尽管该方法灵活,但在需透视的列很多时会变得复杂。
下面的查询通过使用 CASE 条件聚合各产品的销售,实现了与 SQL Server PIVOT 示例相同的输出。
-- Select Date and pivoted columns for each product
SELECT
Date,
-- Use CASE to create a column for Laptop and Mouse sales
SUM(CASE WHEN Product = 'Laptop' THEN Sales ELSE 0 END) AS Laptop,
SUM(CASE WHEN Product = 'Mouse' THEN Sales ELSE 0 END) AS Mouse
FROM SalesData
GROUP BY Date;Oracle
Oracle 支持 PIVOT 运算符,可直接将行转换为列。与 SQL Server 类似,您需要显式指定要转换的列。
在下列查询中,PIVOT 将 ProductName 的取值转换为列,并使用 SUM 对 SalesAmount 聚合。
SELECT *
FROM (
-- Source data selection
SELECT SaleDate, ProductName, SaleAmount FROM SalesData
)
PIVOT (
-- Aggregate Sales by Product, creating pivoted columns
SUM(SaleAmount)
FOR ProductName IN ('Laptop' AS Laptop, 'Mouse' AS Mouse)
);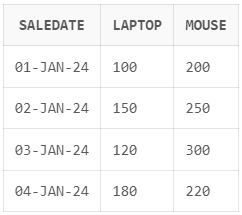
在 Oracle 中使用 SQL PIVOT 运算符的输出转换示例。图片来源:作者。
在 SQL 中将行透视为列的高级技巧
当您需要在处理复杂数据时具备更大灵活性,进阶的行转列技巧会非常有用。动态透视与同时处理多列的方法,能在静态透视受限的场景下完成数据转换。我们来详细探讨这两种方法。
动态透视
动态透视可让您的透视查询自动适应数据变化。该技巧在列值(如产品名称或类别)经常变化时尤为有用,查询可在无需手动更新的情况下自动包含新条目。
假设我们有一张 SalesData 表,可以创建一个随着新产品加入而自动调整的动态透视。下面的查询中,@columns 动态构建透视列列表,sp_executesql 则执行生成的 SQL。
DECLARE @columns NVARCHAR(MAX), @sql NVARCHAR(MAX);
-- Step 1: Generate a list of distinct products to pivot
SELECT @columns = STRING_AGG(QUOTENAME(Product), ', ')
FROM (SELECT DISTINCT Product FROM SalesData) AS products;
-- Step 2: Build the dynamic SQL query
SET @sql = N'
SELECT Date, ' + @columns + '
FROM
(SELECT Date, Product, Sales FROM SalesData) AS source
PIVOT
(
SUM(Sales)
FOR Product IN (' + @columns + ')
) AS pivot_table;';
-- Step 3: Execute the dynamic SQL
EXEC sp_executesql @sql;处理多列
当您需要同时对多列进行透视时,可结合 PIVOT 与额外的聚合技术,在同一查询中生成多组列。
在下例中,我按 Product 同时透视了 Sales 与 Quantity 两列。
-- Pivot Sales and Quantity for Laptop and Mouse by Date
SELECT
p1.Date,
p1.[Laptop] AS Laptop_Sales,
p2.[Laptop] AS Laptop_Quantity,
p1.[Mouse] AS Mouse_Sales,
p2.[Mouse] AS Mouse_Quantity
FROM
(
-- Pivot for Sales
SELECT Date, [Laptop], [Mouse]
FROM
(SELECT Date, Product, Sales FROM SalesData) AS source
PIVOT
(SUM(Sales) FOR Product IN ([Laptop], [Mouse])) AS pivot_sales
) p1
JOIN
(
-- Pivot for Quantity
SELECT Date, [Laptop], [Mouse]
FROM
(SELECT Date, Product, Quantity FROM SalesData) AS source
PIVOT
(SUM(Quantity) FOR Product IN ([Laptop], [Mouse])) AS pivot_quantity
) p2
ON p1.Date = p2.Date;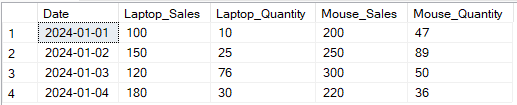
使用 SQL PIVOT 运算符对多列进行输出转换的示例。图片来源:作者。
对多列进行透视能按每个条目的多个属性生成更细致的报告,从而获得更丰富的洞察。但其语法也可能更复杂,尤其是在列很多的情况下。除非结合动态透视技巧,否则往往需要硬编码,进一步增加复杂度。
结论
将行透视为列是值得掌握的一项 SQL 技巧。我见过用 SQL 透视来构建分群留存表,用于跟踪用户在一段时间内的留存情况;也见过在分析问卷数据时使用 SQL 透视:每行代表一位受访者,每个问题可被透视为其各自的列。
如果您想进一步学习如何汇总并为展示和/或仪表板搭建准备数据,我们的 Reporting in SQL 课程是不错的选择。我们的 Associate Data Analyst in SQL 与 Associate Data Engineer in SQL 职业路径同样值得考虑,并能为您的简历增色,欢迎立即报名。

数据科学技术写作者,具备数据分析、商业智能和数据科学的一线实践经验。我撰写以行业为导向的实用内容,涵盖 SQL、Python、Power BI、Databricks 和数据工程,并以真实的分析工作为基础。我的写作兼顾技术深度与业务影响,帮助专业人士将数据转化为自信的决策。
在 SQL 中将行透视为列的常见问题
什么是 SQL 中的透视?
SQL 中的透视是指将行转换为列,并对数据进行汇总,以改进可视化与报告效果。
PIVOT 与 UNPIVOT 有何区别?
PIVOT 将行转换为列,而 UNPIVOT 则将列转换回行。两者互为逆操作。
所有 SQL 数据库都支持 PIVOT 运算符吗?
不是。虽然 SQL Server 与 Oracle 具有内置的 PIVOT 功能,但 MySQL 与 PostgreSQL 并不支持。对于没有 PIVOT 运算符的数据库,通常使用 CASE 等手动方法。
透视会影响查询性能吗?
会,尤其是在大型数据集上。透视通常涉及聚合操作,所需资源会随数据规模与透视列数量增加而上升。
我能一次透视多列吗?
可以,但多数数据库需要额外步骤,例如执行多次透视或合并不同聚合的结果。
将行透视为列,能把原始数据转化为结构清晰、含义明确且更易解读的格式。这也有助于对数据进行汇总与组织,便于报告、改进决策,并揭示那些可能被忽视的趋势。此类数据转换在金融、零售、医疗等领域尤为有用,快速获取有序数据能驱动关键业务决策。
在本指南中,我将结合实际示例和针对不同数据库的实现,带您探索强大的 SQL 透视技术。如果您希望深化 SQL 技能,建议学习 DataCamp 的 Intermediate SQL 课程,掌握数据聚合与分组。如果您是带领分析师和工程师团队的业务干系人,可考虑通过 DataCamp 的企业级解决方案 一次性为全员提升技能。