

SQL में पंक्तियों को स्तंभों में पिवट करने का क्या अर्थ है?
SQL में पिवटिंग का अर्थ है डेटा को पंक्ति‑आधारित प्रारूप से स्तंभ‑आधारित प्रारूप में बदलना। यह रूपांतरण रिपोर्टिंग और डेटा विश्लेषण के लिए उपयोगी है, क्योंकि यह अधिक संरचित और कॉम्पैक्ट डेटा दृश्य प्रदान करता है। पंक्तियों को स्तंभों में पिवट करने से उपयोगकर्ता डेटा का इस तरह से विश्लेषण और सारांश कर सकते हैं जो प्रमुख अंतर्दृष्टियों को अधिक स्पष्टता से उजागर करता है।
निम्न उदाहरण पर विचार करें: मेरे पास दैनिक बिक्री लेनदेन वाली एक तालिका है, और हर पंक्ति में तारीख, उत्पाद का नाम, और बिक्री राशि दर्ज है।
| तारीख | उत्पाद | बिक्री |
|---|---|---|
| 2024-01-01 | Laptop | 100 |
| 2024-01-01 | Mouse | 200 |
| 2024-01-02 | Laptop | 150 |
| 2024-01-02 | Mouse | 250 |
इस तालिका को पिवट करके, मैं इसे इस तरह पुनर्संरचित कर सकता हूँ कि हर उत्पाद एक स्तंभ बन जाए और प्रत्येक तारीख के लिए बिक्री डेटा संबंधित स्तंभ के अंतर्गत आ जाए। ध्यान दें कि यहाँ समेकन (aggregation) भी होता है।
| तारीख | Laptop | Mouse |
|---|---|---|
| 2024-01-01 | 100 | 200 |
| 2024-01-02 | 150 | 250 |
परंपरागत रूप से, पिवट संचालन के लिए सशर्त समेकन के साथ जटिल SQL क्वेरियों की आवश्यकता होती थी। समय के साथ, SQL इम्प्लीमेंटेशन विकसित हुए हैं, और कई आधुनिक डेटाबेस अब अधिक कुशल और सीधी ट्रांसफॉर्मेशन के लिए PIVOT और UNPIVOT ऑपरेटर प्रदान करते हैं।
SQL पिवट: पंक्तियों से स्तंभों तक को समझना
SQL पिवट ऑपरेशन पंक्ति मानों को स्तंभों में बदलकर डेटा को रूपांतरित करता है। नीचे SQL पिवट की मूल सिंटैक्स और संरचना के प्रमुख भाग दिए गए हैं:
-
SELECT: यह
SELECTस्टेटमेंट उन स्तंभों को संदर्भित करता है जिन्हें SQL पिवट टेबल में लौटाना है। -
Subquery: सबक्वेरी में वह डेटा स्रोत या तालिका होती है जिसे SQL पिवट टेबल में शामिल किया जाएगा।
-
PIVOT:
PIVOTऑपरेटर में वे समेकन और फ़िल्टर शामिल होते हैं जिन्हें पिवट टेबल में लागू करना है।
-- Select static columns and pivoted columns
SELECT <static columns>, [pivoted columns]
FROM
(
-- Subquery defining source data for pivot
<subquery that defines data>
) AS source
PIVOT
(
-- Aggregate function applied to value column, creating new columns
<aggregation function>(<value column>)
FOR <column to pivot> IN ([list of pivoted columns])
) AS pivot_table;आइए SQL में पंक्तियों को स्तंभों में पिवट करने के लिए निम्न चरणबद्ध उदाहरण देखें। नीचे SalesData तालिका दी गई है।
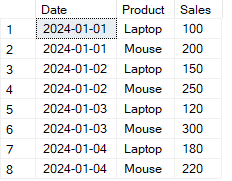
SQL PIVOT ऑपरेटर का उपयोग करके रूपांतरित करने हेतु तालिका का उदाहरण। चित्र: लेखक द्वारा।
मैं इस डेटा को पिवट करना चाहता हूँ ताकि प्रत्येक उत्पाद की दैनिक बिक्री की तुलना कर सकूँ। मैं उस सबक्वेरी का चयन करके शुरू करूँगा जो PIVOT ऑपरेटर की संरचना करेगी।
-- Subquery defining source data for pivot
SELECT Date, Product, Sales
FROM SalesData;अब, मैं PIVOT ऑपरेटर का उपयोग करके Product मानों को स्तंभों में बदलूँगा और Sales को SUM ऑपरेटर से समेकित करूँगा।
-- Select Date and pivoted columns for each product
SELECT Date, [Laptop], [Mouse]
FROM
(
-- Subquery to fetch Date, Product, and Sales columns
SELECT Date, Product, Sales FROM SalesData
) AS source
PIVOT
(
-- Aggregate Sales by Product, pivoting product values to columns
SUM(Sales)
FOR Product IN ([Laptop], [Mouse])
) AS pivot_table;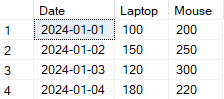
SQL पिवट (पंक्तियों से स्तंभ) का उपयोग करके निकास रूपांतरण का उदाहरण। चित्र: लेखक द्वारा।
हालाँकि पिवटिंग डेटा सारांश को सरल बनाती है, इस तकनीक में कुछ संभावित समस्याएँ हो सकती हैं। नीचे SQL पिवट की चुनौतियाँ और उनके समाधान दिए गए हैं।
-
डायनामिक कॉलम नाम: जब पिवट करने के लिए मान (जैसे, उत्पाद प्रकार) अज्ञात हों, तो कॉलम नाम हार्डकोड करना काम नहीं करता। कुछ डेटाबेस, जैसे SQL Server, इस समस्या से बचने के लिए स्टोर्ड प्रोसीजर के साथ डायनामिक SQL का समर्थन करते हैं, जबकि अन्य में इसे एप्लिकेशन लेयर पर संभालना पड़ता है।
-
NULL मानों से निपटना: किसी विशेष पिवटेड कॉलम के लिए डेटा न होने पर परिणाम में
NULLआ सकता है। आपCOALESCEका उपयोग करकेNULLमानों को शून्य या किसी अन्य प्लेसहोल्डर से बदल सकते हैं। -
डेटाबेस के बीच अनुकूलता: सभी डेटाबेस सीधे
PIVOTऑपरेटर का समर्थन नहीं करते। यदि आपके SQL डाइलेक्ट में समर्थन नहीं है, तोCASEस्टेटमेंट्स और सशर्त समेकन से समान परिणाम प्राप्त किए जा सकते हैं।
SQL पिवट: उदाहरण और उपयोग‑मामले
डेटा को पिवट करने के लिए प्रयुक्त विधियाँ उपयोग किए गए डेटाबेस या अन्य आवश्यकताओं पर निर्भर करती हैं। जहाँ PIVOT ऑपरेटर SQL Server में प्रचलित है, वहीं CASE स्टेटमेंट्स जैसी अन्य तकनीकें बिना प्रत्यक्ष PIVOT समर्थन के भी समान रूपांतरण संभव बनाती हैं। मैं SQL में पिवटिंग की दो सामान्य विधियाँ कवर करूँगा और उनके लाभ‑हानियों पर चर्चा करूँगा।
PIVOT ऑपरेटर का उपयोग
SQL Server में उपलब्ध PIVOT ऑपरेटर आपको समेकन फ़ंक्शन निर्दिष्ट करके और पिवट किए जाने वाले स्तंभों को परिभाषित करके पंक्तियों को स्तंभों में सरलता से बदलने की सुविधा देता है।
निम्न तालिका sales_data पर विचार करें।
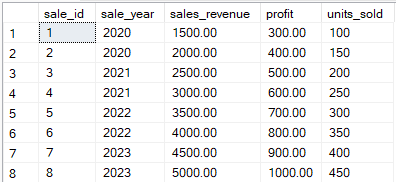
PIVOT ऑपरेटर का उपयोग करके रूपांतरण हेतु Orders तालिका का उदाहरण। चित्र: लेखक द्वारा।
मैं PIVOT ऑपरेटर का उपयोग करूँगा ताकि प्रत्येक वर्ष का कुल sales_revenue स्तंभों में दिखे।
-- Use PIVOT to aggregate sales revenue by year
SELECT *
FROM (
-- Select the relevant columns from the source table
SELECT sale_year, sales_revenue
FROM sales_data
) AS src
PIVOT (
-- Aggregate sales revenue for each year
SUM(sales_revenue)
-- Create columns for each year
FOR sale_year IN ([2020], [2021], [2022], [2023])
) AS piv;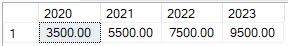
SQL PIVOT का उपयोग कर रूपांतरण के आउटपुट का उदाहरण। चित्र: लेखक द्वारा।
PIVOT ऑपरेटर के उपयोग के निम्न लाभ और सीमाएँ हैं:
-
लाभ: जब कॉलम सही तरीके से इंडेक्स किए गए हों तो यह विधि कुशल होती है। इसकी सिंटैक्स भी सरल और पठनीय है।
-
सीमाएँ: सभी डेटाबेस
PIVOTऑपरेटर का समर्थन नहीं करते। इसमें कॉलम पहले से निर्दिष्ट करने पड़ते हैं, और डायनामिक पिवटिंग के लिए अतिरिक्त जटिलता चाहिए।
CASE स्टेटमेंट्स से मैनुअल पिवटिंग
आप PIVOT ऑपरेटर का समर्थन न करने वाले डेटाबेस, जैसे MySQL और PostgreSQL, में CASE स्टेटमेंट्स का उपयोग करके डेटा को मैन्युअली पिवट कर सकते हैं। यह तरीका सशर्त समेकन का उपयोग करता है, जिसमें प्रत्येक पंक्ति का मूल्यांकन किया जाता है और विशिष्ट मानदंडों के आधार पर नए स्तंभों को शर्तानुसार मान सौंपे जाते हैं।
उदाहरण के लिए, हम इसी sales_data तालिका में CASE स्टेटमेंट्स से डेटा को मैन्युअली पिवट कर सकते हैं।
-- Aggregate sales revenue by year using CASE statements
SELECT
-- Calculate total sales revenue for each year
SUM(CASE WHEN sale_year = 2020 THEN sales_revenue ELSE 0 END) AS sales_2020,
SUM(CASE WHEN sale_year = 2021 THEN sales_revenue ELSE 0 END) AS sales_2021,
SUM(CASE WHEN sale_year = 2022 THEN sales_revenue ELSE 0 END) AS sales_2022,
SUM(CASE WHEN sale_year = 2023 THEN sales_revenue ELSE 0 END) AS sales_2023
FROM
sales_data;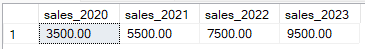
SQL CASE स्टेटमेंट का उपयोग कर आउटपुट रूपांतरण का उदाहरण। चित्र: लेखक द्वारा।
CASE स्टेटमेंट से रूपांतरण के निम्न लाभ और सीमाएँ हैं:
-
लाभ: यह विधि सभी SQL डेटाबेस में काम करती है और नए कॉलम्स को डायनामिक रूप से जनरेट करने में लचीली है, भले ही उत्पाद नाम अज्ञात हों या अक्सर बदलते हों।
-
सीमाएँ: यदि पिवट करने के लिए बहुत से कॉलम हों, तो क्वेरियाँ जटिल और लंबी हो सकती हैं। बहु‑सशर्त जाँच के कारण यह तरीका
PIVOTऑपरेटर से थोड़ा धीमा चल सकता है।
पंक्तियों को स्तंभों में पिवट करते समय प्रदर्शन संबंधी विचार
SQL में पंक्तियों को स्तंभों में पिवट करने से प्रदर्शन पर असर पड़ सकता है, खासकर बड़े डेटा सेट्स पर काम करते समय। कुशल पिवट क्वेरियाँ लिखने, उनके प्रदर्शन को ऑप्टिमाइज़ करने और सामान्य गलतियों से बचने के लिए यहाँ कुछ टिप्स और सर्वोत्तम अभ्यास दिए गए हैं।
सर्वोत्तम अभ्यास
अपनी क्वेरियों को ऑप्टिमाइज़ करने और प्रदर्शन सुधारने के लिए निम्न सर्वोत्तम अभ्यास अपनाएँ।
-
इंडेक्सिंग रणनीतियाँ: उचित इंडेक्सिंग पिवट क्वेरियों के लिए अत्यंत महत्वपूर्ण है, जिससे SQL डेटा को तेज़ी से प्राप्त और संसाधित कर सके। हमेशा उन कॉलम्स को इंडेक्स करें जो अक्सर
WHEREक्लॉज़ में आते हैं या जिन्हें आप समूहित कर रहे हैं, ताकि स्कैन समय घटे। -
नेस्टेड पिवट से बचें: एक ही क्वेरी में कई पिवट ऑपरेशनों को स्टैक करना पढ़ने में कठिन और चलाने में धीमा हो सकता है। क्वेरी को भागों में विभाजित करें या अस्थायी तालिका का उपयोग करें।
-
पिवट में कॉलम और पंक्तियों को सीमित रखें: केवल विश्लेषण के लिए आवश्यक कॉलम्स को ही पिवट करें, क्योंकि बहुत से कॉलम्स को पिवट करना संसाधन‑गहन हो सकता है और बड़ी तालिकाएँ बना सकता है।
आम गलतियों से बचना
पिवट क्वेरियों में मिलने वाली आम गलतियाँ और उनसे बचाव के तरीके नीचे दिए गए हैं।
-
अनावश्यक फुल टेबल स्कैन: प्रासंगिक इंडेक्स न होने पर पिवट क्वेरियाँ फुल टेबल स्कैन ट्रिगर कर सकती हैं। प्रमुख कॉलम्स को इंडेक्स करके और पिवट लगाने से पहले डेटा को फ़िल्टर करके इससे बचें।
-
बार‑बार पिवटिंग के लिए डायनामिक SQL का उपयोग: डायनामिक SQL क्वेरी री‑कम्पाइलेशन के कारण प्रदर्शन धीमा कर सकता है। इस समस्या से बचने के लिए डायनामिक पिवट्स को कैश करें या विशेष परिदृश्यों तक सीमित रखें, और जहाँ संभव हो, डायनामिक कॉलम्स को एप्लिकेशन लेयर में संभालने पर विचार करें।
-
प्री‑फिल्टरिंग के बिना बड़े डेटा सेट्स पर समेकन: बड़े डेटा सेट्स पर
SUMयाCOUNTजैसे समेकन फ़ंक्शन डेटाबेस प्रदर्शन को धीमा कर सकते हैं। पूरे डेटा सेट को पिवट करने के बजाय, पहलेWHEREक्लॉज़ से डेटा फ़िल्टर करें। -
पिवटेड कॉलम्स में NULL मान: किसी विशेष कॉलम के लिए डेटा न होने पर पिवट ऑपरेशन अक्सर
NULLमान उत्पन्न करता है। ये क्वेरियों को धीमा कर सकते हैं और परिणामों की व्याख्या कठिन बना सकते हैं। इससे बचने के लिएCOALESCEजैसी फ़ंक्शंस सेNULLको डिफ़ॉल्ट मान से बदलें। -
केवल नमूना डेटा पर परीक्षण करना: बड़े डेटा सेट्स पर स्मृति और प्रोसेसिंग माँग बढ़ने से पिवट क्वेरियाँ अलग तरह से व्यवहार कर सकती हैं। प्रदर्शन प्रभावों का सटीक आकलन करने के लिए हमेशा वास्तविक या प्रतिनिधि डेटा नमूनों पर परीक्षण करें।
हमारा SQL Server Developer करियर ट्रैक आज़माएँ, जिसमें ट्रांज़ैक्शंस और एरर हैंडलिंग से लेकर क्वेरी प्रदर्शन सुधार तक सब कुछ शामिल है।
डेटाबेस‑विशिष्ट क्रियान्वयन
SQL Server, MySQL, और Oracle जैसे डेटाबेस में पिवट ऑपरेशन उल्लेखनीय रूप से भिन्न होते हैं। प्रत्येक डेटाबेस की अपनी सिंटैक्स और सीमाएँ हैं। मैं विभिन्न डेटाबेस में डेटा को पिवट करने के उदाहरण और उनकी प्रमुख विशेषताएँ कवर करूँगा।
SQL Server
SQL Server एक बिल्ट‑इन PIVOT ऑपरेटर प्रदान करता है, जो पंक्तियों को स्तंभों में पिवट करते समय सीधा है। PIVOT ऑपरेटर का उपयोग आसान है और यह SQL Server के शक्तिशाली समेकन फ़ंक्शंस के साथ एकीकृत होता है। SQL में पिवटिंग की प्रमुख विशेषताएँ निम्नलिखित हैं:
-
PIVOT और UNPIVOT के लिए प्रत्यक्ष समर्थन: SQL Server का
PIVOTऑपरेटर पंक्तियों को स्तंभों में तेज़ रूपांतरण की सुविधा देता है।UNPIVOTऑपरेटर इस प्रक्रिया को उलट भी सकता है। -
समेकन विकल्प:
PIVOTऑपरेटरSUM,COUNT, औरAVGजैसे विभिन्न समेकन फ़ंक्शंस की अनुमति देता है।
SQL Server में PIVOT ऑपरेटर की सीमा यह है कि पिवट किए जाने वाले कॉलम मान पहले से ज्ञात होने चाहिए, जिससे यह डायनामिक रूप से बदलते डेटा के लिए कम लचीला हो जाता है।
नीचे दिए गए उदाहरण में, PIVOT ऑपरेटर Product मानों को स्तंभों में बदलता है और Sales को SUM ऑपरेटर से समेकित करता है।
-- Select Date and pivoted columns for each product
SELECT Date, [Laptop], [Mouse]
FROM
(
-- Subquery to fetch Date, Product, and Sales columns
SELECT Date, Product, Sales FROM SalesData
) AS source
PIVOT
(
-- Aggregate Sales by Product, pivoting product values to columns
SUM(Sales)
FOR Product IN ([Laptop], [Mouse])
) AS pivot_table;मैं DataCamp का Introduction to SQL Server कोर्स लेने की सलाह देता हूँ ताकि आप डेटा विश्लेषण के लिए SQL Server की बुनियादों में निपुण हो सकें।
MySQL
MySQL में PIVOT ऑपरेटर का नैटिव समर्थन नहीं है। हालाँकि, आप CASE स्टेटमेंट का उपयोग करके पंक्तियों को स्तंभों में मैन्युअली पिवट कर सकते हैं और SUM, AVG, और COUNT जैसे अन्य समेकन फ़ंक्शंस के साथ संयोजन कर सकते हैं। यह तरीका लचीला है, लेकिन यदि बहुत से कॉलम पिवट करने हों तो जटिल हो सकता है।
नीचे दी गई क्वेरी CASE स्टेटमेंट का उपयोग करके प्रत्येक उत्पाद के लिए बिक्री को सशर्त रूप से समेकित करती है और SQL Server PIVOT उदाहरण जैसा ही आउटपुट देती है।
-- Select Date and pivoted columns for each product
SELECT
Date,
-- Use CASE to create a column for Laptop and Mouse sales
SUM(CASE WHEN Product = 'Laptop' THEN Sales ELSE 0 END) AS Laptop,
SUM(CASE WHEN Product = 'Mouse' THEN Sales ELSE 0 END) AS Mouse
FROM SalesData
GROUP BY Date;Oracle
Oracle PIVOT ऑपरेटर का समर्थन करता है, जो पंक्तियों को स्तंभों में सीधे रूपांतरित करने की अनुमति देता है। ठीक SQL Server की तरह, आपको रूपांतरण के लिए कॉलम्स को स्पष्ट रूप से निर्दिष्ट करना होगा।
नीचे दी गई क्वेरी में, PIVOT ऑपरेटर ProductName मानों को स्तंभों में बदलता है और SalesAmount को SUM ऑपरेटर से समेकित करता है।
SELECT *
FROM (
-- Source data selection
SELECT SaleDate, ProductName, SaleAmount FROM SalesData
)
PIVOT (
-- Aggregate Sales by Product, creating pivoted columns
SUM(SaleAmount)
FOR ProductName IN ('Laptop' AS Laptop, 'Mouse' AS Mouse)
);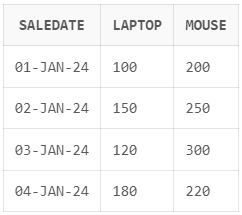
Oracle में SQL PIVOT ऑपरेटर का उपयोग कर आउटपुट रूपांतरण का उदाहरण। चित्र: लेखक द्वारा।
SQL में पंक्तियों को स्तंभों में पिवट करने की उन्नत तकनीकें
जब आपको जटिल डेटा को संभालने में लचीलापन चाहिए, तब पंक्तियों को स्तंभों में पिवट करने की उन्नत तकनीकें उपयोगी होती हैं। डायनामिक तकनीकें और एक साथ अनेक कॉलम्स को संभालना उन परिदृश्यों में रूपांतरण संभव बनाते हैं जहाँ स्थिर पिवटिंग सीमित होती है। आइए इन दोनों तरीकों को विस्तार से समझें।
डायनामिक पिवट्स
डायनामिक पिवट्स आपको ऐसी पिवट क्वेरियाँ बनाने देते हैं जो डेटा में होने वाले परिवर्तनों के अनुसार स्वतः अनुकूलित हो जाएँ। यह तकनीक तब विशेष रूप से उपयोगी है जब आपके कॉलम्स, जैसे उत्पाद नाम या श्रेणियाँ, अक्सर बदलते हैं और आप चाहते हैं कि आपकी क्वेरी बिना मैन्युअल अपडेट के नए एंट्रीज़ को स्वतः शामिल कर ले।
मान लीजिए हमारे पास SalesData तालिका है और हम ऐसा डायनामिक पिवट बनाना चाहते हैं जो नए उत्पाद जुड़ने पर समायोजित हो जाए। नीचे की क्वेरी में, @columns पिवटेड कॉलम्स की सूची को डायनामिक रूप से बनाता है, और sp_executesql जनरेटेड SQL चलाता है।
DECLARE @columns NVARCHAR(MAX), @sql NVARCHAR(MAX);
-- Step 1: Generate a list of distinct products to pivot
SELECT @columns = STRING_AGG(QUOTENAME(Product), ', ')
FROM (SELECT DISTINCT Product FROM SalesData) AS products;
-- Step 2: Build the dynamic SQL query
SET @sql = N'
SELECT Date, ' + @columns + '
FROM
(SELECT Date, Product, Sales FROM SalesData) AS source
PIVOT
(
SUM(Sales)
FOR Product IN (' + @columns + ')
) AS pivot_table;';
-- Step 3: Execute the dynamic SQL
EXEC sp_executesql @sql;एकाधिक कॉलम्स को संभालना
ऐसे परिदृश्यों में जहाँ आपको एक साथ कई कॉलम्स को पिवट करना हो, आप PIVOT ऑपरेटर और अतिरिक्त समेकन तकनीकों का उपयोग करके एक ही क्वेरी में अनेक कॉलम्स बना सकते हैं।
नीचे दिए उदाहरण में, मैंने Sales और Quantity कॉलम्स को Product के आधार पर पिवट किया है।
-- Pivot Sales and Quantity for Laptop and Mouse by Date
SELECT
p1.Date,
p1.[Laptop] AS Laptop_Sales,
p2.[Laptop] AS Laptop_Quantity,
p1.[Mouse] AS Mouse_Sales,
p2.[Mouse] AS Mouse_Quantity
FROM
(
-- Pivot for Sales
SELECT Date, [Laptop], [Mouse]
FROM
(SELECT Date, Product, Sales FROM SalesData) AS source
PIVOT
(SUM(Sales) FOR Product IN ([Laptop], [Mouse])) AS pivot_sales
) p1
JOIN
(
-- Pivot for Quantity
SELECT Date, [Laptop], [Mouse]
FROM
(SELECT Date, Product, Quantity FROM SalesData) AS source
PIVOT
(SUM(Quantity) FOR Product IN ([Laptop], [Mouse])) AS pivot_quantity
) p2
ON p1.Date = p2.Date;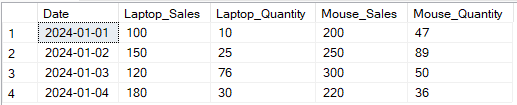
SQL PIVOT ऑपरेटर का उपयोग कर एकाधिक कॉलम्स के आउटपुट रूपांतरण का उदाहरण। चित्र: लेखक द्वारा।
एकाधिक कॉलम्स को पिवट करना अधिक विस्तृत रिपोर्ट प्रदान करता है, क्योंकि यह प्रति आइटम कई गुणों को पिवट करके समृद्ध अंतर्दृष्टि सक्षम करता है। हालाँकि, यदि बहुत से कॉलम हों तो सिंटैक्स जटिल हो सकता है। हार्डकोडिंग की आवश्यकता पड़ सकती है, जब तक कि इसे डायनामिक पिवट तकनीकों के साथ न जोड़ा जाए—जो अतिरिक्त जटिलता जोड़ता है।
निष्कर्ष
पंक्तियों को स्तंभों में पिवट करना एक ऐसी SQL तकनीक है जिसे सीखना सार्थक है। मैंने SQL पिवट तकनीकों का उपयोग कोहोर्ट रिटेंशन टेबल बनाने में होते देखा है, जहाँ आप समय के साथ उपयोगकर्ता प्रतिधारण को ट्रैक कर सकते हैं। मैंने सर्वे डेटा के विश्लेषण में भी SQL पिवट तकनीकों का उपयोग होते देखा है, जहाँ प्रत्येक पंक्ति एक उत्तरदाता का प्रतिनिधित्व करती है और प्रत्येक प्रश्न को उसके अपने स्तंभ में पिवट किया जा सकता है।
यदि आप डेटा को सारांशित करने और प्रस्तुति या डैशबोर्ड निर्माण के लिए तैयार करने के बारे में अधिक सीखना चाहते हैं, तो हमारा Reporting in SQL कोर्स एक बेहतरीन विकल्प है। हमारे Associate Data Analyst in SQL और Associate Data Engineer in SQL करियर ट्रैक्स भी एक बढ़िया विचार हैं, और वे किसी भी रेज़्यूमे में काफ़ी मूल्य जोड़ते हैं—तो आज ही नामांकन करें।

डेटा एनालिटिक्स, बिज़नेस इंटेलिजेंस और डेटा साइंस में व्यावहारिक अनुभव रखने वाला डेटा साइंस तकनीकी लेखक। मैं SQL, Python, Power BI, Databricks और डेटा इंजीनियरिंग पर व्यावहारिक, उद्योग-केंद्रित सामग्री लिखता/लिखती हूँ, जो वास्तविक दुनिया की एनालिटिक्स कार्य से जुड़ी होती है। मेरी लेखनी तकनीकी गहराई और व्यावसायिक प्रभाव के बीच पुल का काम करती है, जिससे पेशेवरों को डेटा को आत्मविश्वासपूर्ण निर्णयों में बदलने में मदद मिलती है.
SQL में पंक्तियों को स्तंभों में पिवट करते समय सामान्य प्रश्न
SQL में पिवटिंग क्या है?
SQL में पिवटिंग का अर्थ है पंक्तियों को स्तंभों में बदलना और बेहतर डेटा विज़ुअलाइज़ेशन तथा रिपोर्टिंग के लिए डेटा का सारांश बनाना।
PIVOT और UNPIVOT में क्या अंतर है?
PIVOT पंक्तियों को स्तंभों में बदलता है, जबकि UNPIVOT स्तंभों को वापस पंक्तियों में बदलता है। ये प्रक्रियाएँ एक‑दूसरे की उलट हैं।
क्या सभी SQL डेटाबेस PIVOT ऑपरेटर का समर्थन करते हैं?
नहीं। जहाँ SQL Server और Oracle में बिल्ट‑इन PIVOT फ़ंक्शनलिटी है, वहीं MySQL और PostgreSQL में नहीं है। CASE स्टेटमेंट्स जैसी मैनुअल तकनीकें उन डेटाबेस में प्रचलित हैं जहाँ PIVOT ऑपरेटर उपलब्ध नहीं है।
क्या पिवटिंग से क्वेरी प्रदर्शन प्रभावित होता है?
हाँ, खासकर बड़े डेटा सेट्स पर। पिवटिंग में अक्सर समेकन शामिल होता है और डेटा आकार तथा पिवट किए जा रहे कॉलम्स की संख्या के आधार पर अतिरिक्त संसाधनों की आवश्यकता हो सकती है।
क्या मैं एक समय में एक से अधिक कॉलम पिवट कर सकता/सकती हूँ?
हाँ, लेकिन अधिकांश डेटाबेस में इसके लिए अतिरिक्त चरणों की आवश्यकता होती है, जैसे कई पिवट्स करना या विभिन्न समेकनों के परिणामों को मिलाना।
पंक्तियों को स्तंभों में पिवट करने से विश्लेषकों को कच्चे डेटा को सुव्यवस्थित, सार्थक प्रारूपों में बदलने में मदद मिलती है, जिन्हें समझना आसान होता है। यह रिपोर्टिंग के लिए डेटा को समेकित और व्यवस्थित करने, निर्णय‑निर्माण में सुधार करने, और उन प्रवृत्तियों को उजागर करने में भी सहायक है जो अन्यथा नज़रअंदाज़ हो सकती हैं। इस तरह का रूपांतरण वित्त, खुदरा, और स्वास्थ्य सेवा में उपयोगी है, जहाँ सुव्यवस्थित डेटा तक त्वरित पहुँच महत्वपूर्ण व्यावसायिक निर्णयों को प्रेरित कर सकती है।
इस गाइड में, मैं व्यावहारिक उदाहरणों और डेटाबेस‑विशिष्ट क्रियान्वयन के साथ SQL पिवट तकनीकों की सशक्त दुनिया का अन्वेषण करूंगा। यदि आप अपनी SQL कौशल को गहरा करना चाहते हैं, तो DataCamp का Intermediate SQL कोर्स लेने की सलाह देता हूँ, जहाँ आप डेटा एग्रीगेशन और ग्रुपिंग के बारे में सीखेंगे। यदि आप ऐसे व्यवसाय हितधारक हैं जिनकी टीम में विश्लेषक और इंजीनियर शामिल हैं, तो एक साथ सभी को अपस्किल करने के लिए DataCamp की एंटरप्राइज़ सॉल्यूशंस पर विचार करें।