多年来,您的团队一直通过控制台点击和 shell 脚本来部署云资源。如今您希望采用基础设施即代码(IaC),但从零重建一切又让人望而却步。我也经历过这种情况,Terraform 的导入(import)功能正是解决这一难题的利器。
“ClickOps”和人工运维的风险会随时间累积:资源缺乏文档、配置偏离标准、口口相传取代了正式记录。一旦同事离职,他做过的基础设施决策也随之消失。
这正是组织引入基础设施即代码(IaC)的原因。在本教程中,我将带您把现有基础设施导入到 Terraform 中。
我们将比较基于 CLI 的 import 命令与 Terraform 1.5 引入的声明式 import 块,探讨两种方法的实用工作流,并处理那些可能把一次简单导入变成生产事故的常见陷阱。读完后,您将有信心将现有基础设施纳入代码管理。
如果您刚接触 IaC 和云服务商,建议先学习我们的课程,如 AWS Concepts、Understanding Cloud Computing 或 Understanding Microsoft Azure。
当您从Terraform 起步创建基础设施时,一切井然有序。您编写配置,运行 terraform plan,审阅变更并应用。Terraform 在其状态文件中跟踪一切,在代码与云资源之间建立完美映射。
但如果资源早已存在于 Terraform 之外会怎样?先来弄清 import 的作用及其存在的理由。
核心定义与目的
Terraform import 会将现有的真实基础设施映射到 Terraform 状态文件中的条目,而不会创建新资源。可以把它理解为“收养”:您告诉 Terraform 开始管理一个已在运行的资源。
这解决了“影子 IT”的问题。组织往往通过多种方式累积基础设施:故障期间的控制台部署、临时测试资源永久化、或早于 IaC 采用的遗留系统。Import 将这种现实与 IaC 原则对齐。
关键点在于:import 主要是一项状态操作。除非使用 Terraform 1.5+ 的代码生成功能,否则它不会自动编写配置代码。您有责任确保 HCL 配置准确反映导入的资源。
既然了解了 import 的作用,我们再来看何时该用、何时不该用。
我建议在三种主要情形下进行导入:
- 迁移无法在不造成显著停机或数据丢失的情况下重建的遗留基础设施。例如拥有多年数据的生产数据库,或正在承载在线流量的负载均衡器。
- 找回丢失的状态文件——即便使用远程后端,如果备份未正确配置也可能发生。
- 纳入绕过了变更管理流程的手动改动,例如故障期间的紧急修复。
不过,import 并非总是最佳选择。对于临时测试资源或标准化程度很差的基础设施,我常建议直接干净重建。
从头开始可以应用当前最佳实践、实施规范的命名约定,并添加遗留资源可能缺失的安全配置。前期重建投入,往往能在长期可维护性上获得回报。
务必将 import 与 Terraform 数据源区分开。数据源允许您引用现有基础设施的只读信息,而不是管理它。例如,您可以用数据源查询由另一团队创建的现有 VPC,然后将您的资源部署到其中。
相反,import 会将资源完全纳入 Terraform 管理,包括修改或销毁它的能力。当您需要管理资源的完整生命周期而非仅作引用时,才选择 import。
开始导入之前,您需要了解一些基本约束。
关键约束与基础知识
每个被导入的资源都需要一个唯一的、由提供商定义的标识符。对于 AWS,可能是 i-0123456789abcdef0。对于 Azure,是完整的资源路径,如 /subscriptions/{id}/resourceGroups/{rg}/providers/{provider}/{resource}。标识符错误是导入失败的首要原因。
导入操作会直接修改您的状态文件,因此务必备份。若使用 S3 等版本化后端,请确认开启了版本控制。若使用本地状态,请手动复制为 terraform.tfstate.backup。
导入后您会遇到“漂移”——导入状态与本地配置不匹配。您需要迭代更新 HCL 代码,直到 terraform plan 显示没有待处理变更为止。
在导入任何内容之前,确保准备到位。我见过不少失败案例都是因为团队跳过了准备步骤。
第一步是确保 Terraform 环境配置正确。
验证环境
先用 terraform version 验证 Terraform 安装。如果您想使用声明式 import 块和自动代码生成,请确保版本为 Terraform 1.5 或更高。这些功能能显著简化复杂资源的导入流程。
导入前,请核对以下前提条件:
-
提供商凭证有效:在 AWS 上,检查是否设置了 AWS_ACCESS_KEY_ID 和 AWS_SECRET_ACCESS_KEY,或已配置 AWS CLI 配置文件。用 aws sts get-caller-identity 测试。
-
工作区正确:运行 terraform workspace show,确认未误将资源导入错误环境。
-
状态文件未被锁定:与团队成员协调,并检查 CI/CD 流水线,确保没有并发操作。
-
后端可达:若使用远程状态,验证可连接至 S3、Azure Storage 或 Terraform Cloud。
被锁定的状态文件会立即导致导入失败并报“获取锁”错误,因此在团队环境中,这一步协调至关重要。
在验证环境后,下一关键步骤是找到要导入资源的精确标识符。
定位资源 ID
资源 ID 会因提供商与资源类型而异,这一步比想象中更棘手。以下是常见提供商示例:
|
提供商
|
资源类型
|
ID 格式
|
示例
|
|
AWS
|
EC2 实例
|
实例 ID
|
i-0123456789abcdef0
|
|
AWS
|
S3 存储桶
|
桶名称
|
my-bucket-name
|
|
AWS
|
安全组
|
组 ID
|
sg-0123456789abcdef0
|
|
Azure
|
虚拟机
|
完整资源路径
|
/subscriptions/{guid}/resourceGroups/{name}/providers/Microsoft.Compute/virtualMachines/{vm}
|
|
GCP
|
计算实例
|
项目/区域/名称
|
projects/{project}/zones/{zone}/instances/{name}
|
对于 AWS 资源,您可以直接在控制台找到 ID。进入对应服务(EC2、S3 等),选择资源,从详情面板复制标识符。
对于 Azure,使用 Azure CLI 获取完整资源路径:
az resource show --name myresource --resource-group mygroup技术支持
输出将包含导入所需的完整资源 ID。
我常踩的一个坑是:尝试从错误的区域或订阅导入资源。如果您的 Terraform 提供商配置指向 us-east-1,而 EC2 实例却在 us-west-2,即便实例 ID 正确,导入也会报“找不到资源”。
在继续之前,务必确认作用域与您的提供商配置一致。一旦获得正确的 ID,您需要决定使用哪种导入方式。
选择导入策略
您有两条路径:terraform import CLI 命令或 import 块。对比如下:
|
特性
|
CLI 命令
|
Import 块(1.5+)
|
|
Terraform 版本
|
所有版本
|
1.5 或更高
|
|
最佳适用
|
快速、一次性导入
|
团队协作、批量导入
|
|
版本控制
|
代码中无记录
|
以 HCL 完整记录
|
|
代码生成
|
不可用
|
配合 -generate-config-out 自动生成
|
|
代码评审
|
不易审阅
|
标准 PR 流程
|
|
可复现性
|
需手动重跑
|
声明式、可重复
|
我建议:需要代码评审与可复现计划的团队使用 import 块;老版本上的快速修复使用 CLI。
这为何重要?Import 块将“接管现有基础设施”也作为代码来处理,使导入成为版本控制工作流的一部分,与其他基础设施变更享有同等严谨性。这降低出错风险,并形成合规与团队协作所需的审计轨迹。
Import 块能无缝融入现有 Git 流程,让团队像审阅其他基础设施变更一样审阅并批准导入。而 CLI 虽然更快,但不会留下审计轨迹,也难以在不同环境中轻松复现。
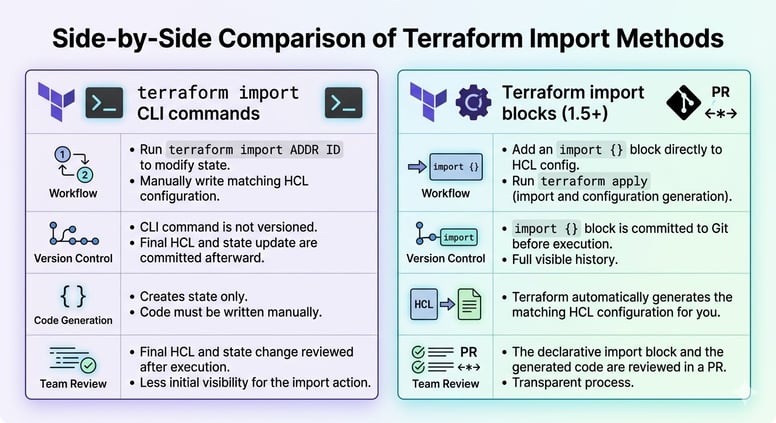
确定策略后,我们先从传统的 CLI 方法深入讲解各自的工作流。
下面带您走一遍基于 CLI 的传统导入流程。尽管声明式 import 块日渐成为首选,了解 CLI 方法对老版本 Terraform 和一次性快速导入仍然很有价值。
CLI 工作流的第一步是设置配置文件。
准备目标资源块
在运行 terraform import 之前,您必须在配置中定义一个资源块。这是硬性要求:Terraform 需要知道把导入的状态映射到哪里。该块可以为空或部分填写。
以下示例演示导入一个 AWS S3 存储桶:
resource "aws_s3_bucket" "legacy_data" {
  # Configuration to be filled after import
}技术支持
资源类型(aws_s3_bucket)必须与您要导入的基础设施类型完全一致。资源名称(legacy_data)应遵循项目命名规范。使用 production_data_bucket 这类具描述性的名字,而非 bucket1 这种泛化名称。
准备好资源块后,就可以运行导入命令了。
执行导入
运行 terraform import <resource_address> <resource_id>。以我们的 S3 存储桶为例:
terraform import aws_s3_bucket.legacy_data my-existing-bucket-name技术支持
Terraform 将通过提供商 API 拉取存储桶的当前属性,并记录到状态中。您将看到:
aws_s3_bucket.legacy_data: Import complete!
Imported aws_s3_bucket技术支持
状态中已包含该资源,但您的配置仍为空或不完整。
接下来才是关键——让代码与导入的状态一致。
对齐配置
运行 terraform plan 查看状态与配置之间的差异。您会看到计算属性(只读值,如时间戳)以及需要声明的显式配置项。
根据 plan 输出逐步更新配置。如果计划显示要“替换”资源,请停止。这通常意味着不可变参数不匹配,如区域或可用区。请调整配置以匹配现有资源的不可变属性。
现在来看看 Terraform 1.5 引入的现代方法。Import 块将导入从命令式操作转变为与基础设施代码并存的声明式配置。
其关键优势是可复现与团队可见性。使用 CLI 导入,代码中没有任何被导入内容的记录;使用 import 块,每次导入都有文档、有版本,并可通过 Pull Request 审阅。
先来创建 import 块。
定义 import 块
一个 import 块包含两个部分:to(目标地址)和 id(资源标识符):
import {
  to = aws_instance.web_server
  id = "i-0123456789abcdef0"
}技术支持
这样便于版本控制可见性。团队可以在执行前通过 Pull Request 审阅 import 块。建议将 import 块放在 imports.tf,便于导入成功后清理。
Import 块真正出彩之处在于:Terraform 可以为您自动生成配置代码,免去从零手写 HCL 的繁琐试错。
Import 块支持自动生成配置。运行 terraform plan -generate-config-out=generated.tf,即可在规划导入的同时写出完整 HCL 代码。
生成的文件包含所有属性及其当前值。请审阅、删去冗长的默认值,并将有意义的配置合并进代码库。这能避免常见错误:属性名误写、类型不对、缺少必填项。尤其对复杂资源,价值巨大。
准备好配置后,就可以执行导入了。
应用并收尾
最后运行 terraform apply 来执行导入,并使状态与配置对齐。Terraform 会在修改状态文件之前,准确展示将要导入的内容。
应用成功后,请从配置中移除 import 块。它们的使命已完成,保留会干扰后续运行。最后再运行一次 terraform plan,确认没有待处理变更,以确保配置与状态完全同步。
以上工作流非常适合简单、独立的资源。但生产环境很少如此单纯。下面来处理模块、迭代与依赖等真实世界的复杂性。
真实环境中的基础设施很少由简单独立的资源构成。由模块管理的资源需要特殊的寻址语法,这是我们的第一个挑战。
导入到子模块
模块资源需要完整路径寻址:module.<module_name>.<resource_type>.<resource_name>,例如:
terraform import module.network.aws_vpc.main vpc-0abcdef123456789技术支持
要找到正确的地址,可在常规 apply 之后使用 terraform state list。它能准确展示 Terraform 如何引用模块资源。地址错误会造成重复的状态条目,Terraform 会在下次 apply 时尝试再次创建它们。
此外,在将资源导入带有 count 或 for_each 的模块实例时,需要在引号中包含实例标识符:
terraform import 'module.network[0].aws_vpc.main' vpc-0abcdef123456789技术支持
除了模块寻址外,使用 count 或 for_each 元参数的资源也有其特殊挑战。
处理 count 与 for_each
当 Terraform 配置使用 count 创建多个资源实例时,导入需要数组语法。例如,若您的配置如下:
resource "aws_instance" "server" {
  count         = 3
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}技术支持
则需按索引逐个导入:
terraform import 'aws_instance.server[0]' i-0123456789abcdef0
terraform import 'aws_instance.server[1]' i-1234567890abcdef1
terraform import 'aws_instance.server[2]' i-2345678901abcdef2技术支持
另一方面,使用 for_each 的资源需要字符串键。如下示例:
resource "aws_instance" "server" {
  for_each      = toset(["web", "api", "worker"])
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}技术支持
这里需要用键名导入:
terraform import 'aws_instance.server["web"]' i-0123456789abcdef0
terraform import 'aws_instance.server["api"]' i-1234567890abcdef1
terraform import 'aws_instance.server["worker"]' i-2345678901abcdef2技术支持
若遇到“index out of range”错误,说明 count 值与您导入的资源数量不符。解决方法很直接:先设置正确的 count,或在导入前为配置定义合适的 for_each 键。
此外,处理复杂架构时,您还需要考虑资源之间的关系。
管理依赖与副作用
有些云资源并非作为单个实体导入,而会以多个 Terraform 资源的形式导入:常见示例包括:
在这些情况下,应始终先导入“父级”资源。例如先导入 VPC 再导入子网,先导入 IAM 角色再导入策略关联,先导入安全组再导入具体规则。这样能在状态文件中建立正确的依赖链。
导入后,审阅配置,对提供商无法自动识别的依赖显式声明 depends_on。这能确保后续 apply 按正确顺序执行,避免例如在 VPC 存在之前尝试创建子网等错误。
成功导入并正确配置资源后,下一阶段应关注长期维护与组织重构。
状态管理与重构
导入只是起点。长期成功有赖于正确的状态管理与必要的重构。
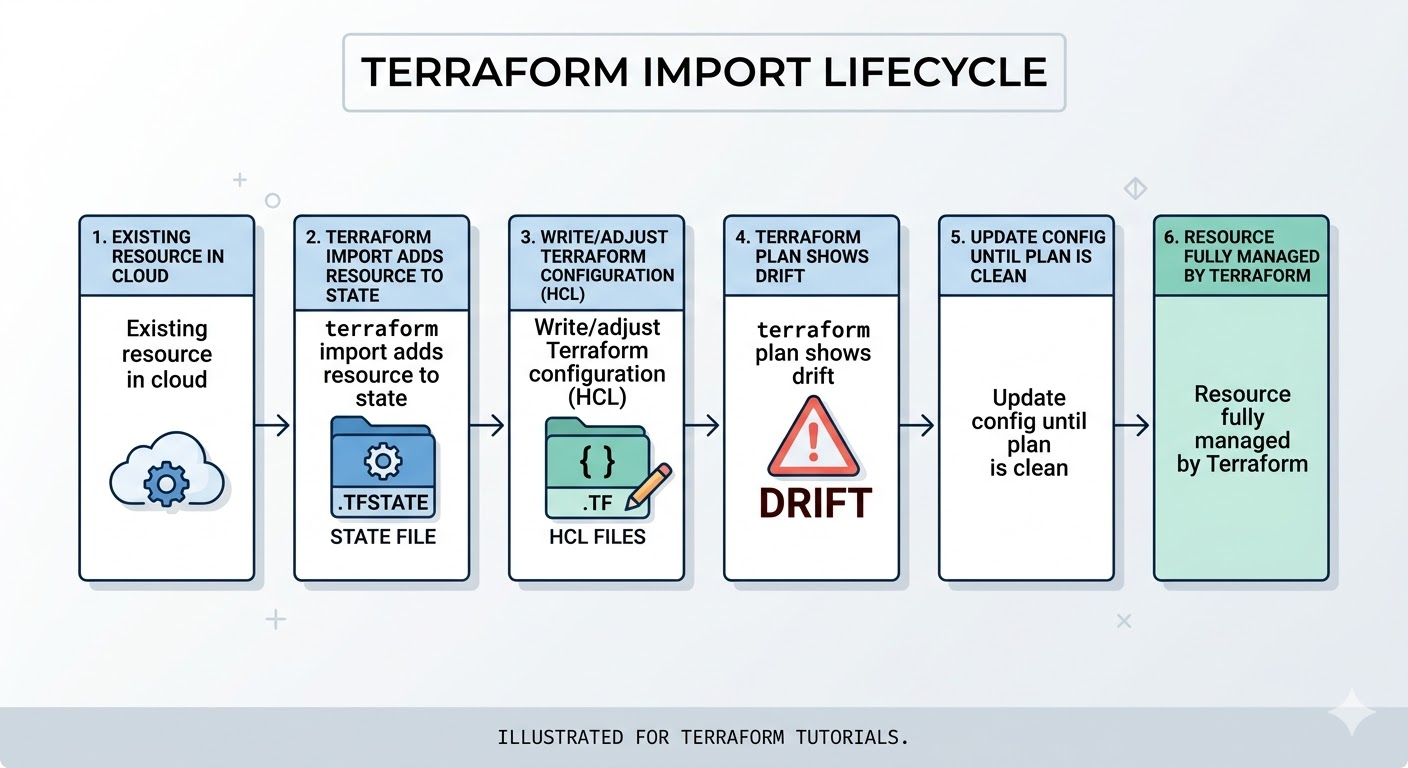
在导入生产资源时,安全应当是首要考虑。
保护敏感状态
很多团队会被这点打个措手不及:导入数据库或加密密钥会把口令、私钥、连接字符串等敏感值,以明文形式拉入状态文件。这是一个必须立即应对的关键安全问题。
解决方案是使用加密的远程后端。对 AWS 而言,使用 S3 并启用 encrypt = true,可选配合 KMS 加密。对 Azure 使用具备静态加密的 Azure Storage。若使用 HCP Terraform / Terraform Cloud,状态在静态与传输中默认加密,但仍需核查访问控制。
此外,在导入包含敏感数据的生产资源后,请再做两件事:核实状态存储的访问控制配置正确,并开启审计日志以追踪谁在何时访问状态。这些措施能形成对合规非常有价值的安全审计轨迹。
随着基础设施的发展,您可能需要重新组织并重命名已导入的资源。
重构已导入资源
重命名资源有两种方式:terraform state mv(命令式)或 moved 块(声明式)。我更偏好 moved 块,因为它会在版本历史中记录变更:
moved {
  from = aws_instance.old_name
  to   = aws_instance.new_name
}技术支持
除了重命名,还应将硬编码的 ID 替换为资源引用。与其写 vpc_id = "vpc-123456",不如使用 vpc_id = aws_vpc.main.id。这能构建正确的依赖图,便于 Terraform 确定正确的执行顺序。
状态管理的最后一环,是防止未来的漂移。
加固以防漂移
导入后,最重要的政策是:所有变更都通过 Terraform,而非云控制台。这是避免代码与现实脱节的唯一途径。
不过,有些属性会频繁变化但无需纳入管理。对这些属性,可使用 ignore_changes 生命周期参数:
lifecycle {
  ignore_changes = [tags["LastModified"]]
}技术支持
最后,建立“干净 plan”标准,即 terraform plan 仅显示有意的变更。即便不部署,也要养成定期运行 plan 的习惯,尽早发现漂移,避免演变为大问题。
即便准备充分,导入操作仍可能失败。下面诊断并解决您最可能遇到的问题。
地址与 ID 不匹配是最常见的问题。
解决地址与 ID 错误
以下是最常见的导入错误及其解决方案:
Resource address does not exist
- 原因:Terraform 在配置中找不到您的资源块
- CLI 导入修复:在运行命令前先创建一个空资源块
- Import 块修复:检查 to 地址是否有拼写错误或模块路径不正确
Cannot import non-existent remote object
- 原因:ID 格式错误,或提供商区域/订阅不正确
- 修复:确认提供商配置指向正确的 AWS 区域、Azure 订阅或 GCP 项目
- 另请检查:提供商文档中的资源 ID 格式
Resource already managed
防止意外替换
成功导入资源后,要警惕计划中出现的替换操作。
如果 terraform plan 在导入后显示“forces replacement”,需要找出导致重建的参数。常见原因是不可变参数,如 EC2 的 AMI ID 或可用区,这些在资源创建后无法更改。
解决方法很直接:让配置与现实对齐。从 plan 输出中复制实际值到配置文件中即可。
还有一条关键安全规则:如果计划提议销毁关键资源,绝不要确认或应用。这就是警示,表明某处不对劲。
处理提供商问题
有时问题并非出在您的配置,而是提供商配置方式上。
当提供商块在导入期间依赖已计算值时,会出现“Provider configuration depends on non-var”错误。Terraform 需要静态的提供商配置来定位要导入的资源。
权宜之计是临时硬编码:将动态提供商设置替换为字面量,完成导入后再恢复动态配置。或者,您也可以使用环境变量进行提供商认证,Terraform 能在导入过程中解析它们。
如果资源 ID 看似正确但导入仍失败,请查阅提供商文档中的“Import”章节,确认精确的 ID 格式要求。有些资源使用带斜杠或冒号分隔的复合 ID,格式必须完全匹配。
结语
您已学会使用 CLI 命令与 import 块将现有基础设施纳入 Terraform 管理。每次导入前,请遵循此安全清单:
- 核实资源 ID 与提供商要求一致
- 备份状态文件(为远程后端启用版本控制)
- 仔细审阅计划,留意意外替换
- 确认处于正确的工作区/环境
- 先在非关键资源上试运行
不过,导入并不在 terraform apply 结束。真正的工作在其后:建立防漂移策略、按您的标准重构已导入资源,并教育团队仅通过代码来管理基础设施。这种文化转变与技术落地同样重要。
下一步,我建议您学习 terraform state mv 与 terraform state rm 的状态操作。这些命令与导入互补,能帮助您在基础设施演进时重组与重构状态文件。
也推荐查看我们的 Terraform 搭配 Docker 指南,以及为下一次面试做准备的热门 Terraform 面试题。


多年来,您的团队一直通过控制台点击和 shell 脚本来部署云资源。如今您希望采用基础设施即代码(IaC),但从零重建一切又让人望而却步。我也经历过这种情况,Terraform 的导入(import)功能正是解决这一难题的利器。
“ClickOps”和人工运维的风险会随时间累积:资源缺乏文档、配置偏离标准、口口相传取代了正式记录。一旦同事离职,他做过的基础设施决策也随之消失。
这正是组织引入基础设施即代码(IaC)的原因。在本教程中,我将带您把现有基础设施导入到 Terraform 中。
我们将比较基于 CLI 的 import 命令与 Terraform 1.5 引入的声明式 import 块,探讨两种方法的实用工作流,并处理那些可能把一次简单导入变成生产事故的常见陷阱。读完后,您将有信心将现有基础设施纳入代码管理。
如果您刚接触 IaC 和云服务商,建议先学习我们的课程,如 AWS Concepts、Understanding Cloud Computing 或 Understanding Microsoft Azure。
什么是 Terraform Import?
当您从Terraform 起步创建基础设施时,一切井然有序。您编写配置,运行
terraform plan,审阅变更并应用。Terraform 在其状态文件中跟踪一切,在代码与云资源之间建立完美映射。但如果资源早已存在于 Terraform 之外会怎样?先来弄清 import 的作用及其存在的理由。
核心定义与目的
Terraform import 会将现有的真实基础设施映射到 Terraform 状态文件中的条目,而不会创建新资源。可以把它理解为“收养”:您告诉 Terraform 开始管理一个已在运行的资源。
这解决了“影子 IT”的问题。组织往往通过多种方式累积基础设施:故障期间的控制台部署、临时测试资源永久化、或早于 IaC 采用的遗留系统。Import 将这种现实与 IaC 原则对齐。
关键点在于:import 主要是一项状态操作。除非使用 Terraform 1.5+ 的代码生成功能,否则它不会自动编写配置代码。您有责任确保 HCL 配置准确反映导入的资源。
既然了解了 import 的作用,我们再来看何时该用、何时不该用。
Terraform import 与替代方案
我建议在三种主要情形下进行导入:
不过,import 并非总是最佳选择。对于临时测试资源或标准化程度很差的基础设施,我常建议直接干净重建。
从头开始可以应用当前最佳实践、实施规范的命名约定,并添加遗留资源可能缺失的安全配置。前期重建投入,往往能在长期可维护性上获得回报。
务必将 import 与 Terraform 数据源区分开。数据源允许您引用现有基础设施的只读信息,而不是管理它。例如,您可以用数据源查询由另一团队创建的现有 VPC,然后将您的资源部署到其中。
相反,import 会将资源完全纳入 Terraform 管理,包括修改或销毁它的能力。当您需要管理资源的完整生命周期而非仅作引用时,才选择 import。
开始导入之前,您需要了解一些基本约束。
关键约束与基础知识
每个被导入的资源都需要一个唯一的、由提供商定义的标识符。对于 AWS,可能是
i-0123456789abcdef0。对于 Azure,是完整的资源路径,如/subscriptions/{id}/resourceGroups/{rg}/providers/{provider}/{resource}。标识符错误是导入失败的首要原因。导入操作会直接修改您的状态文件,因此务必备份。若使用 S3 等版本化后端,请确认开启了版本控制。若使用本地状态,请手动复制为
terraform.tfstate.backup。导入后您会遇到“漂移”——导入状态与本地配置不匹配。您需要迭代更新 HCL 代码,直到
terraform plan显示没有待处理变更为止。Terraform Import 的先决条件与准备
在导入任何内容之前,确保准备到位。我见过不少失败案例都是因为团队跳过了准备步骤。
第一步是确保 Terraform 环境配置正确。
验证环境
先用
terraform version验证 Terraform 安装。如果您想使用声明式 import 块和自动代码生成,请确保版本为 Terraform 1.5 或更高。这些功能能显著简化复杂资源的导入流程。导入前,请核对以下前提条件:
提供商凭证有效:在 AWS 上,检查是否设置了
AWS_ACCESS_KEY_ID和AWS_SECRET_ACCESS_KEY,或已配置 AWS CLI 配置文件。用aws sts get-caller-identity测试。工作区正确:运行
terraform workspace show,确认未误将资源导入错误环境。状态文件未被锁定:与团队成员协调,并检查 CI/CD 流水线,确保没有并发操作。
后端可达:若使用远程状态,验证可连接至 S3、Azure Storage 或 Terraform Cloud。
被锁定的状态文件会立即导致导入失败并报“获取锁”错误,因此在团队环境中,这一步协调至关重要。
在验证环境后,下一关键步骤是找到要导入资源的精确标识符。
定位资源 ID
资源 ID 会因提供商与资源类型而异,这一步比想象中更棘手。以下是常见提供商示例:
提供商
资源类型
ID 格式
示例
AWS
EC2 实例
实例 ID
i-0123456789abcdef0AWS
S3 存储桶
桶名称
my-bucket-nameAWS
安全组
组 ID
sg-0123456789abcdef0Azure
虚拟机
完整资源路径
/subscriptions/{guid}/resourceGroups/{name}/providers/Microsoft.Compute/virtualMachines/{vm}GCP
计算实例
项目/区域/名称
projects/{project}/zones/{zone}/instances/{name}对于 AWS 资源,您可以直接在控制台找到 ID。进入对应服务(EC2、S3 等),选择资源,从详情面板复制标识符。
对于 Azure,使用 Azure CLI 获取完整资源路径:
输出将包含导入所需的完整资源 ID。
我常踩的一个坑是:尝试从错误的区域或订阅导入资源。如果您的 Terraform 提供商配置指向
us-east-1,而 EC2 实例却在us-west-2,即便实例 ID 正确,导入也会报“找不到资源”。在继续之前,务必确认作用域与您的提供商配置一致。一旦获得正确的 ID,您需要决定使用哪种导入方式。
选择导入策略
您有两条路径:
terraform importCLI 命令或import块。对比如下:特性
CLI 命令
Import 块(1.5+)
Terraform 版本
所有版本
1.5 或更高
最佳适用
快速、一次性导入
团队协作、批量导入
版本控制
代码中无记录
以 HCL 完整记录
代码生成
不可用
配合
-generate-config-out自动生成代码评审
不易审阅
标准 PR 流程
可复现性
需手动重跑
声明式、可重复
我建议:需要代码评审与可复现计划的团队使用 import 块;老版本上的快速修复使用 CLI。
这为何重要?Import 块将“接管现有基础设施”也作为代码来处理,使导入成为版本控制工作流的一部分,与其他基础设施变更享有同等严谨性。这降低出错风险,并形成合规与团队协作所需的审计轨迹。
Import 块能无缝融入现有 Git 流程,让团队像审阅其他基础设施变更一样审阅并批准导入。而 CLI 虽然更快,但不会留下审计轨迹,也难以在不同环境中轻松复现。
确定策略后,我们先从传统的 CLI 方法深入讲解各自的工作流。
核心工作流 A:Terraform Import CLI 命令
下面带您走一遍基于 CLI 的传统导入流程。尽管声明式 import 块日渐成为首选,了解 CLI 方法对老版本 Terraform 和一次性快速导入仍然很有价值。
CLI 工作流的第一步是设置配置文件。
准备目标资源块
在运行
terraform import之前,您必须在配置中定义一个资源块。这是硬性要求:Terraform 需要知道把导入的状态映射到哪里。该块可以为空或部分填写。以下示例演示导入一个 AWS S3 存储桶:
资源类型(
aws_s3_bucket)必须与您要导入的基础设施类型完全一致。资源名称(legacy_data)应遵循项目命名规范。使用production_data_bucket这类具描述性的名字,而非bucket1这种泛化名称。准备好资源块后,就可以运行导入命令了。
执行导入
运行
terraform import <resource_address> <resource_id>。以我们的 S3 存储桶为例:Terraform 将通过提供商 API 拉取存储桶的当前属性,并记录到状态中。您将看到:
状态中已包含该资源,但您的配置仍为空或不完整。
接下来才是关键——让代码与导入的状态一致。
对齐配置
运行
terraform plan查看状态与配置之间的差异。您会看到计算属性(只读值,如时间戳)以及需要声明的显式配置项。根据 plan 输出逐步更新配置。如果计划显示要“替换”资源,请停止。这通常意味着不可变参数不匹配,如区域或可用区。请调整配置以匹配现有资源的不可变属性。
核心工作流 B:Terraform Import 块
现在来看看 Terraform 1.5 引入的现代方法。Import 块将导入从命令式操作转变为与基础设施代码并存的声明式配置。
其关键优势是可复现与团队可见性。使用 CLI 导入,代码中没有任何被导入内容的记录;使用 import 块,每次导入都有文档、有版本,并可通过 Pull Request 审阅。
先来创建 import 块。
定义 import 块
一个 import 块包含两个部分:
to(目标地址)和id(资源标识符):这样便于版本控制可见性。团队可以在执行前通过 Pull Request 审阅 import 块。建议将 import 块放在
imports.tf,便于导入成功后清理。Import 块真正出彩之处在于:Terraform 可以为您自动生成配置代码,免去从零手写 HCL 的繁琐试错。
生成配置(Terraform 1.5+)
Import 块支持自动生成配置。运行
terraform plan -generate-config-out=generated.tf,即可在规划导入的同时写出完整 HCL 代码。生成的文件包含所有属性及其当前值。请审阅、删去冗长的默认值,并将有意义的配置合并进代码库。这能避免常见错误:属性名误写、类型不对、缺少必填项。尤其对复杂资源,价值巨大。
准备好配置后,就可以执行导入了。
应用并收尾
最后运行
terraform apply来执行导入,并使状态与配置对齐。Terraform 会在修改状态文件之前,准确展示将要导入的内容。应用成功后,请从配置中移除 import 块。它们的使命已完成,保留会干扰后续运行。最后再运行一次
terraform plan,确认没有待处理变更,以确保配置与状态完全同步。以上工作流非常适合简单、独立的资源。但生产环境很少如此单纯。下面来处理模块、迭代与依赖等真实世界的复杂性。
复杂资源与模块的 Terraform 导入
真实环境中的基础设施很少由简单独立的资源构成。由模块管理的资源需要特殊的寻址语法,这是我们的第一个挑战。
导入到子模块
模块资源需要完整路径寻址:
module.<module_name>.<resource_type>.<resource_name>,例如:要找到正确的地址,可在常规 apply 之后使用
terraform state list。它能准确展示 Terraform 如何引用模块资源。地址错误会造成重复的状态条目,Terraform 会在下次 apply 时尝试再次创建它们。此外,在将资源导入带有
count或for_each的模块实例时,需要在引号中包含实例标识符:除了模块寻址外,使用
count或for_each元参数的资源也有其特殊挑战。处理 count 与 for_each
当 Terraform 配置使用
count创建多个资源实例时,导入需要数组语法。例如,若您的配置如下:则需按索引逐个导入:
另一方面,使用
for_each的资源需要字符串键。如下示例:这里需要用键名导入:
若遇到“index out of range”错误,说明 count 值与您导入的资源数量不符。解决方法很直接:先设置正确的 count,或在导入前为配置定义合适的
for_each键。此外,处理复杂架构时,您还需要考虑资源之间的关系。
管理依赖与副作用
有些云资源并非作为单个实体导入,而会以多个 Terraform 资源的形式导入:常见示例包括:
在这些情况下,应始终先导入“父级”资源。例如先导入 VPC 再导入子网,先导入 IAM 角色再导入策略关联,先导入安全组再导入具体规则。这样能在状态文件中建立正确的依赖链。
导入后,审阅配置,对提供商无法自动识别的依赖显式声明
depends_on。这能确保后续apply按正确顺序执行,避免例如在 VPC 存在之前尝试创建子网等错误。成功导入并正确配置资源后,下一阶段应关注长期维护与组织重构。
状态管理与重构
导入只是起点。长期成功有赖于正确的状态管理与必要的重构。
在导入生产资源时,安全应当是首要考虑。
保护敏感状态
很多团队会被这点打个措手不及:导入数据库或加密密钥会把口令、私钥、连接字符串等敏感值,以明文形式拉入状态文件。这是一个必须立即应对的关键安全问题。
解决方案是使用加密的远程后端。对 AWS 而言,使用 S3 并启用
encrypt = true,可选配合 KMS 加密。对 Azure 使用具备静态加密的 Azure Storage。若使用 HCP Terraform / Terraform Cloud,状态在静态与传输中默认加密,但仍需核查访问控制。此外,在导入包含敏感数据的生产资源后,请再做两件事:核实状态存储的访问控制配置正确,并开启审计日志以追踪谁在何时访问状态。这些措施能形成对合规非常有价值的安全审计轨迹。
随着基础设施的发展,您可能需要重新组织并重命名已导入的资源。
重构已导入资源
重命名资源有两种方式:
terraform state mv(命令式)或moved块(声明式)。我更偏好moved块,因为它会在版本历史中记录变更:除了重命名,还应将硬编码的 ID 替换为资源引用。与其写
vpc_id = "vpc-123456",不如使用vpc_id = aws_vpc.main.id。这能构建正确的依赖图,便于 Terraform 确定正确的执行顺序。状态管理的最后一环,是防止未来的漂移。
加固以防漂移
导入后,最重要的政策是:所有变更都通过 Terraform,而非云控制台。这是避免代码与现实脱节的唯一途径。
不过,有些属性会频繁变化但无需纳入管理。对这些属性,可使用
ignore_changes生命周期参数:最后,建立“干净 plan”标准,即
terraform plan仅显示有意的变更。即便不部署,也要养成定期运行 plan 的习惯,尽早发现漂移,避免演变为大问题。排查常见的 Terraform 导入错误
即便准备充分,导入操作仍可能失败。下面诊断并解决您最可能遇到的问题。
地址与 ID 不匹配是最常见的问题。
解决地址与 ID 错误
以下是最常见的导入错误及其解决方案:
Resource address does not exist
Cannot import non-existent remote object
Resource already managed
原因:状态条目重复。该资源已以其他名称被跟踪
修复:运行
terraform state list查找重复项,然后用terraform state rm移除旧条目后再导入防止意外替换
成功导入资源后,要警惕计划中出现的替换操作。
如果
terraform plan在导入后显示“forces replacement”,需要找出导致重建的参数。常见原因是不可变参数,如 EC2 的 AMI ID 或可用区,这些在资源创建后无法更改。解决方法很直接:让配置与现实对齐。从 plan 输出中复制实际值到配置文件中即可。
还有一条关键安全规则:如果计划提议销毁关键资源,绝不要确认或应用。这就是警示,表明某处不对劲。
处理提供商问题
有时问题并非出在您的配置,而是提供商配置方式上。
当提供商块在导入期间依赖已计算值时,会出现“Provider configuration depends on non-var”错误。Terraform 需要静态的提供商配置来定位要导入的资源。
权宜之计是临时硬编码:将动态提供商设置替换为字面量,完成导入后再恢复动态配置。或者,您也可以使用环境变量进行提供商认证,Terraform 能在导入过程中解析它们。
如果资源 ID 看似正确但导入仍失败,请查阅提供商文档中的“Import”章节,确认精确的 ID 格式要求。有些资源使用带斜杠或冒号分隔的复合 ID,格式必须完全匹配。
结语
您已学会使用 CLI 命令与 import 块将现有基础设施纳入 Terraform 管理。每次导入前,请遵循此安全清单:
不过,导入并不在
terraform apply结束。真正的工作在其后:建立防漂移策略、按您的标准重构已导入资源,并教育团队仅通过代码来管理基础设施。这种文化转变与技术落地同样重要。下一步,我建议您学习
terraform state mv与terraform state rm的状态操作。这些命令与导入互补,能帮助您在基础设施演进时重组与重构状态文件。也推荐查看我们的 Terraform 搭配 Docker 指南,以及为下一次面试做准备的热门 Terraform 面试题。