
Cours
Comprendre le cloud
2 h
253.8K
Votre équipe déploie des ressources cloud depuis des années via l'interface console et des scripts shell. Vous souhaitez maintenant adopter l'Infrastructure as Code, mais tout recréer de zéro semble insurmontable. J'ai déjà vécu cette situation : la fonctionnalité d'import de Terraform est la réponse à ce défi.
Les risques du « ClickOps » et de la gestion manuelle de l'infrastructure s'accumulent avec le temps. Les ressources ne sont plus documentées, les configurations s'écartent des standards, et le savoir informel remplace la documentation. Quand des membres quittent l'équipe, leurs choix d'infrastructure partent avec eux.
C'est pourquoi les organisations adoptent l'Infrastructure as Code (IaC). Dans ce tutoriel, je vous guide pour importer une infrastructure existante dans Terraform.
Nous comparerons la commande d'import en CLI avec les blocs d'import déclaratifs introduits avec Terraform 1.5, nous verrons des workflows concrets pour les deux approches, et nous traiterons les pièges courants qui peuvent transformer un simple import en incident de production. À la fin, vous serez en mesure d'intégrer sereinement votre infrastructure existante sous gestion par le code.
Si vous débutez en IaC et chez les fournisseurs cloud, pensez à suivre l'un de nos cours, comme AWS Concepts, Understanding Cloud Computing ou Understanding Microsoft Azure.
Quand vous créez une infrastructure avec Terraform dès le départ, tout est fluide : vous écrivez la configuration, lancez terraform plan, revoyez les changements, puis appliquez. Terraform suit tout dans son fichier d'état, créant une correspondance parfaite entre votre code et vos ressources cloud.
Mais que se passe-t-il quand des ressources existent déjà en dehors de Terraform ? Commençons par comprendre ce que fait exactement l'import et pourquoi il existe.
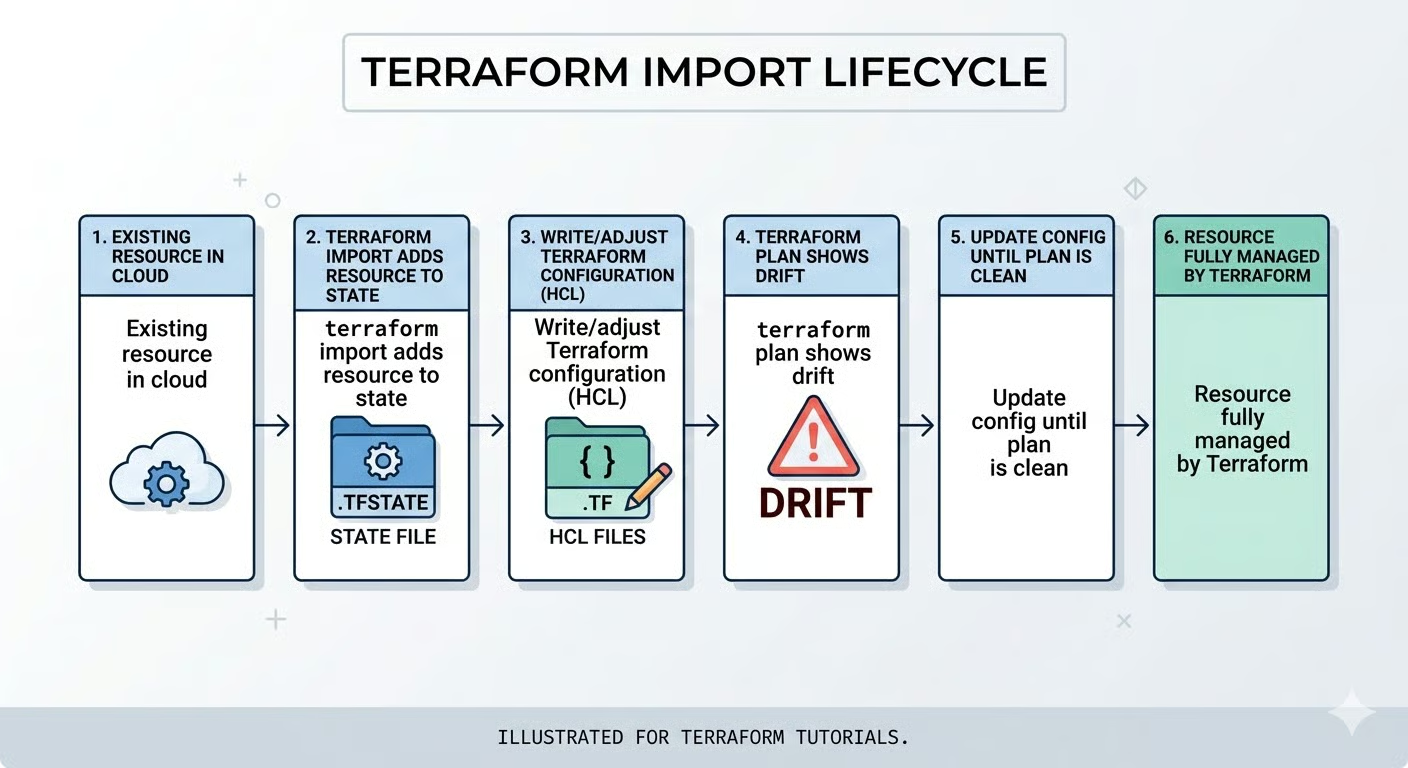
Terraform import fait correspondre une infrastructure existante à des entrées dans le fichier d'état de Terraform sans créer de nouvelles ressources. Voyez cela comme une adoption : vous demandez à Terraform de commencer à gérer une ressource déjà en service.
Cela résout le problème de la « shadow IT ». Les organisations accumulent des ressources de multiples façons : déploiements en console lors d'incidents, ressources de test devenues permanentes, ou systèmes historiques antérieurs à l'adoption de l'IaC. L'import réconcilie cette réalité avec les principes de l'Infrastructure as Code.
Point crucial : l'import est avant tout une opération sur l'état. Il n'écrit pas automatiquement le code de configuration, sauf si vous utilisez les fonctionnalités de génération apparues avec Terraform 1.5+. C'est à vous de garantir que votre configuration HCL reflète fidèlement la ressource importée.
Maintenant que nous savons ce que fait l'import, voyons quand l'utiliser… ou pas.
Je recommande l'import dans trois cas de figure principaux :
Cependant, l'import n'est pas toujours le bon choix. Pour des ressources de test temporaires ou une infrastructure mal standardisée, je recommande souvent une recréation propre.
Repartir à neuf permet d'appliquer les bonnes pratiques actuelles, d'imposer des conventions de nommage, et d'ajouter des configurations de sécurité qui manquent parfois aux ressources historiques. L'effort initial est souvent rentabilisé par la maintenabilité à long terme.
Il est essentiel de distinguer l'import des data sources Terraform. Les data sources vous permettent de référencer en lecture seule des informations issues de ressources existantes, sans les gérer. Par exemple, vous pouvez rechercher un VPC existant créé par une autre équipe, puis y déployer vos ressources.
L'import, à l'inverse, place les ressources sous gestion complète de Terraform, avec la possibilité de les modifier ou de les détruire. Choisissez l'import quand vous devez gérer tout le cycle de vie d'une ressource, pas seulement la référencer.
Avant de commencer, gardez à l'esprit quelques contraintes fondamentales.
Chaque ressource importée requiert un identifiant unique propre au provider. Pour AWS, ce peut être i-0123456789abcdef0. Pour Azure, il s'agit d'un chemin complet de ressource tel que /subscriptions/{id}/resourceGroups/{rg}/providers/{provider}/{resource}. Se tromper est la première cause d'échec d'import.
Les opérations d'import modifient directement votre état : les sauvegardes sont donc essentielles. Si vous utilisez des backends versionnés comme S3, vérifiez que la gestion de versions est activée. Avec un état local, copiez manuellement vers terraform.tfstate.backup.
Après l'import, vous constaterez du « drift » : l'écart entre l'état importé et votre configuration locale. Mettez à jour votre HCL de façon itérative jusqu'à ce que terraform plan n'affiche plus aucun changement en attente.
Avant tout import, assurez-vous de mettre toutes les chances de votre côté. J'ai vu des imports échouer parce que des équipes ont sauté des étapes de préparation.
Première étape : valider la bonne configuration de votre environnement Terraform.
Commencez par vérifier votre installation Terraform avec terraform version. Si vous souhaitez utiliser les blocs d'import déclaratifs et la génération automatique de code, assurez-vous d'être en Terraform 1.5 ou version ultérieure. Ces fonctionnalités simplifient grandement l'import de ressources complexes.
Avant d'importer, vérifiez ces prérequis :
Identifiants provider actifs : pour AWS, assurez-vous que AWS_ACCESS_KEY_ID et AWS_SECRET_ACCESS_KEY sont définis, ou que votre profil AWS CLI est configuré. Testez avec aws sts get-caller-identity.
Espace de travail correct sélectionné : lancez terraform workspace show pour vérifier que vous n'importez pas par erreur dans le mauvais environnement.
Fichier d'état déverrouillé : coordonnez-vous avec l'équipe et vérifiez les pipelines CI/CD pour éviter des opérations concurrentes.
Backend accessible : si vous utilisez un état distant, vérifiez la connectivité à S3, Azure Storage ou Terraform Cloud.
Un état verrouillé fera échouer l'import immédiatement avec une erreur d'acquisition de verrou. Cette coordination est donc critique en équipe.
Une fois l'environnement validé, l'étape suivante consiste à trouver l'identifiant exact de la ressource à importer.
Les IDs varient fortement selon les providers et les types de ressources, ce qui rend cette étape plus subtile qu'il n'y paraît. Voici des exemples courants :
|
Provider |
Type de ressource |
Format d'ID |
Exemple |
|
AWS |
Instance EC2 |
ID d'instance |
|
|
AWS |
Bucket S3 |
Nom du bucket |
|
|
AWS |
Security group |
ID de groupe |
|
|
Azure |
Machine virtuelle |
Chemin complet |
|
|
GCP |
Instance Compute |
Projet/zone/nom |
|
Pour les ressources AWS, vous pouvez récupérer les IDs directement dans la console : accédez au service (EC2, S3, etc.), sélectionnez votre ressource, et copiez l'identifiant depuis le panneau de détails.
Pour Azure, utilisez Azure CLI pour récupérer le chemin complet :
az resource show --name myresource --resource-group mygroupLa sortie inclut l'ID complet de ressource nécessaire à l'import.
Un piège fréquent : tenter d'importer une ressource dans la mauvaise région ou souscription. Si votre configuration provider pointe vers us-east-1 mais que votre instance EC2 vit en us-west-2, l'import échouera avec « resource not found » même si l'ID est correct.
Vérifiez toujours que le périmètre correspond à votre configuration provider avant de continuer. Une fois l'ID validé, choisissez votre méthode d'import.
Deux options s'offrent à vous : la commande CLI terraform import ou les blocs import. Comparatif :
|
Fonctionnalité |
Commande CLI |
Blocs d'import (1.5+) |
|
Version Terraform |
Toutes versions |
1.5 ou ultérieure |
|
Idéal pour |
Imports rapides, ponctuels |
Travail en équipe, imports en masse |
|
Contrôle de version |
Aucune trace dans le code |
Entièrement documenté en HCL |
|
Génération de code |
Non disponible |
Automatique avec |
|
Revue de code |
Difficile à revoir |
Processus PR standard |
|
Reproductibilité |
Ré-exécution manuelle |
Déclaratif et répétable |
Je recommande les blocs d'import pour les équipes exigeant des revues de code et des plans reproductibles, et la CLI pour des correctifs rapides sur des versions anciennes.
Pourquoi est-ce important ? Les blocs d'import traitent l'adoption d'infrastructure comme du code : vos imports intègrent le workflow versionné avec la même rigueur que tout autre changement d'infra. Vous réduisez le risque d'erreur et bénéficiez d'une traçabilité essentielle pour la conformité et la coordination d'équipe.
Les blocs d'import s'intègrent naturellement à votre workflow Git : vos coéquipiers peuvent revoir et approuver les imports comme n'importe quel autre changement. La CLI, bien que rapide pour des tâches individuelles, ne laisse pas de trace et n'est pas aisément reproductible entre environnements.
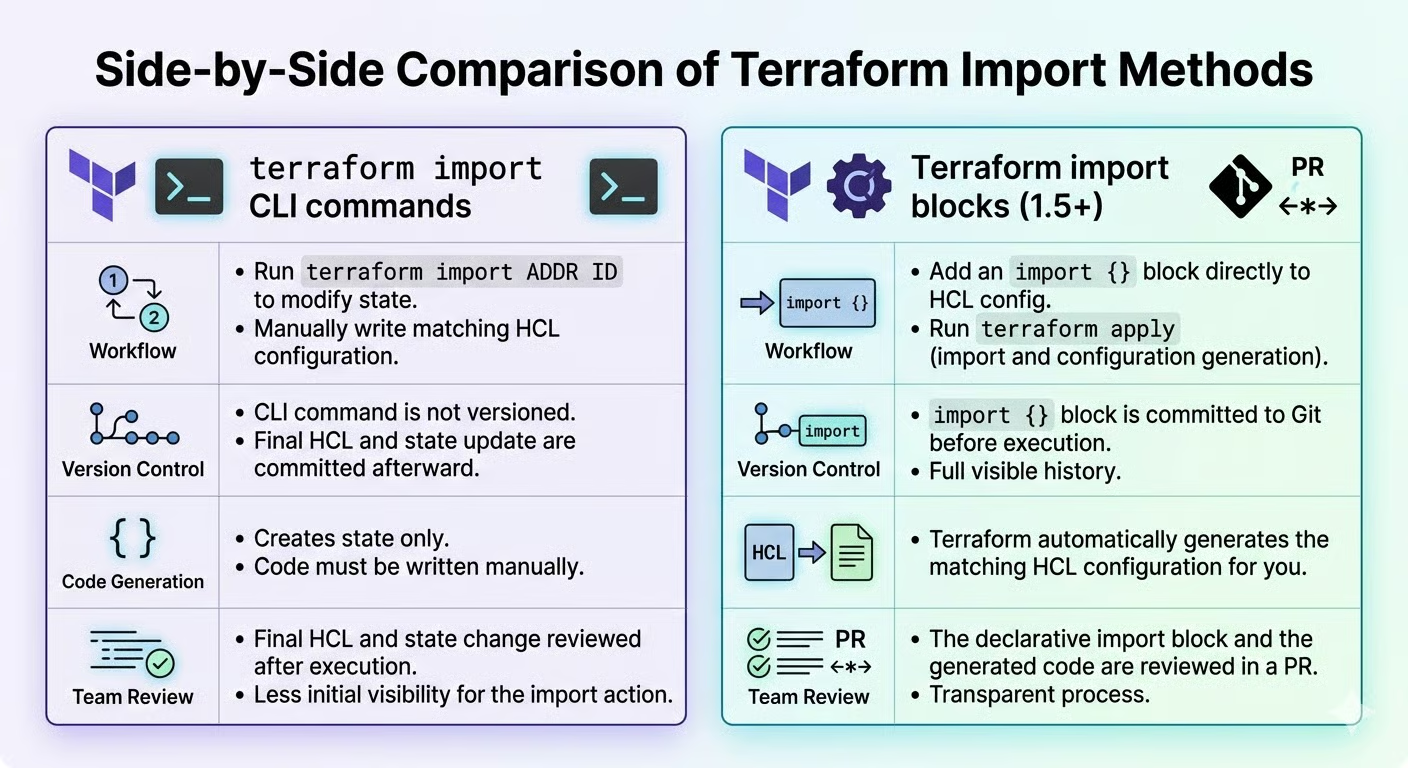
Votre stratégie arrêtée, voyons chaque workflow en détail, en commençant par l'approche CLI traditionnelle.
Voici le processus d'import classique en CLI. Même si les blocs d'import déclaratifs deviennent la norme, comprendre la méthode CLI reste utile pour les versions historiques de Terraform et les imports ponctuels rapides.
Première étape du workflow CLI : préparer votre bloc de configuration.
Avant d'exécuter terraform import, vous devez définir un bloc resource dans votre configuration. C'est une obligation : Terraform doit savoir où cartographier l'état importé. Le bloc peut être vide ou partiel.
Exemple pour importer un bucket S3 AWS :
resource "aws_s3_bucket" "legacy_data" {
  # Configuration à compléter après import
}
Le type (aws_s3_bucket) doit correspondre exactement à la ressource importée. Le nom (legacy_data) doit respecter vos conventions de nommage. Préférez des noms explicites comme production_data_bucket plutôt que bucket1.
Votre bloc en place, vous pouvez lancer la commande d'import.
Exécutez terraform import <resource_address> <resource_id>. Pour notre bucket S3 :
terraform import aws_s3_bucket.legacy_data my-existing-bucket-nameTerraform récupère les attributs actuels auprès de l'API du provider et les enregistre dans l'état. Vous verrez :
aws_s3_bucket.legacy_data: Import complete!
Imported aws_s3_bucket
L'état contient désormais la ressource, mais votre configuration reste vide ou incomplète.
C'est ici que commence le vrai travail : aligner le code sur l'état importé.
Exécutez terraform plan pour voir les différences entre état et configuration. Vous verrez des attributs calculés (valeurs en lecture seule comme des horodatages) et des exigences explicites à déclarer.
Mettez à jour progressivement votre configuration avec les valeurs du plan. Si le plan propose de « remplacer » la ressource, stoppez. Cela indique un écart sur un argument immuable (région, zone de dispo, etc.). Ajustez pour refléter les attributs immuables de la ressource existante.
Voyons maintenant l'approche moderne introduite avec Terraform 1.5. Les blocs d'import transforment l'import d'une commande impérative en une configuration déclarative qui vit au côté de votre code d'infrastructure.
L'avantage clé : reproductibilité et visibilité équipe. Avec la CLI, aucune trace de ce qui a été importé. Avec les blocs, chaque import est documenté, versionné et soumis à revue via des pull requests.
Commençons par créer le bloc d'import.
Un bloc d'import comporte deux éléments : to (adresse cible) et id (identifiant de ressource) :
import {
  to = aws_instance.web_server
  id = "i-0123456789abcdef0"
}
Cela apporte de la visibilité dans le contrôle de version. L'équipe peut revoir les blocs d'import en pull request avant exécution. Placez-les dans imports.tf pour les nettoyer facilement après succès.
Et voici où ils excellent : Terraform peut générer automatiquement le code de configuration, évitant la corvée de rédiger du HCL à partir de zéro.
Les blocs d'import permettent la génération automatique. Lancez terraform plan -generate-config-out=generated.tf pour planifier l'import et écrire en même temps un HCL complet.
Le fichier généré contient chaque attribut avec sa valeur actuelle. Relisez, supprimez les valeurs par défaut verbeuses, et intégrez la configuration utile dans votre code. Cela évite les erreurs courantes : attributs mal nommés, types incorrects, champs requis manquants. Inestimable pour les ressources complexes.
Configuration prête : il est temps d'exécuter l'import.
Exécutez terraform apply pour réaliser l'import et aligner l'état avec la configuration. Terraform affiche précisément ce qui sera importé avant toute modification de l'état.
Après succès, supprimez les blocs d'import de votre configuration. Ils ont rempli leur rôle et les conserver créerait de la confusion plus tard. Lancez enfin terraform plan pour vérifier qu'aucun changement n'est en attente : signe que configuration et état sont synchronisés.
Les workflows vus jusque-là conviennent aux ressources simples et isolées. Mais une production réelle est rarement si linéaire. Abordons la complexité des modules, de l'itération et des dépendances.
Dans la réalité, l'infrastructure ne se résume pas à des ressources isolées. Les ressources gérées par module exigent une syntaxe d'adressage complète : premier défi.
Les ressources de module requièrent un chemin complet : module.<module_name>.<resource_type>.<resource_name>, ce qui peut ressembler à :
terraform import module.network.aws_vpc.main vpc-0abcdef123456789Pour trouver la bonne adresse, utilisez terraform state list après un apply normal. Vous verrez comment Terraform référence les ressources de module. Une mauvaise adresse crée des doublons d'état que Terraform tentera ensuite de créer à nouveau.
En outre, lors d'un import dans des instances de module avec count ou for_each, incluez l'identifiant d'instance entre guillemets :
terraform import 'module.network[0].aws_vpc.main' vpc-0abcdef123456789Au-delà de l'adressage des modules, les ressources qui utilisent count ou for_each posent aussi leurs propres défis.
Quand votre configuration Terraform utilise count pour créer plusieurs instances d'une ressource, vous aurez besoin d'une syntaxe de tableau pour l'import. Par exemple, si votre configuration ressemble à ceci :
resource "aws_instance" "server" {
  count         = 3
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Vous importerez chaque instance individuellement avec son index :
terraform import 'aws_instance.server[0]' i-0123456789abcdef0
terraform import 'aws_instance.server[1]' i-1234567890abcdef1
terraform import 'aws_instance.server[2]' i-2345678901abcdef2
Pour les ressources avec for_each, vous utiliserez des clés chaînes. Par exemple :
resource "aws_instance" "server" {
  for_each      = toset(["web", "api", "worker"])
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Ici, vous importerez avec les noms de clés :
terraform import 'aws_instance.server["web"]' i-0123456789abcdef0
terraform import 'aws_instance.server["api"]' i-1234567890abcdef1
terraform import 'aws_instance.server["worker"]' i-2345678901abcdef2
Si vous voyez des erreurs « index out of range », c'est que votre valeur de count ne correspond pas au nombre de ressources à importer. Corrigez simplement : définissez le bon count ou les clés for_each adéquates avant l'import.
Pensez également aux relations entre ressources, surtout dans des architectures complexes.
Certaines ressources cloud ne s'importent pas en un seul bloc, mais en plusieurs ressources Terraform. Exemples fréquents :
Dans ces cas, importez toujours d'abord les ressources « parent ». Importez par exemple les VPC avant les subnets, les rôles IAM avant les attachements de politiques, et les security groups avant leurs règles. Vous établissez ainsi la bonne chaîne de dépendances dans l'état.
Après import, déclarez explicitement les dépendances avec depends_on là où le provider ne les détecte pas automatiquement. Vous garantissez ainsi l'ordre d'exécution lors des futurs apply et évitez des erreurs comme la création d'un subnet avant son VPC.
Une fois vos ressources importées et correctement configurées, la phase suivante concerne la gestion de l'état et le refactoring.
Importer des ressources n'est que le début. La réussite à long terme repose sur une bonne gestion de l'état et des refactorings ponctuels.
La sécurité doit rester votre priorité lors de l'import de ressources de production.
Piège classique : importer des bases de données ou des clés de chiffrement fait apparaître des valeurs sensibles (mots de passe, clés privées, chaînes de connexion) en clair dans le fichier d'état. C'est un enjeu critique à traiter immédiatement.
La solution : utilisez des backends distants chiffrés. Sur AWS, S3 avec encrypt = true et éventuellement KMS. Sur Azure, Azure Storage avec chiffrement au repos. Avec HCP Terraform / Terraform Cloud, l'état est chiffré au repos et en transit par défaut, mais vérifiez tout de même les contrôles d'accès.
Après l'import de ressources de production sensibles, faites deux choses : vérifiez minutieusement les droits d'accès au stockage de l'état, et activez la journalisation d'audit pour tracer qui accède à l'état et quand. Vous disposerez ainsi d'une piste d'audit utile pour la conformité.
Au fil de l'évolution, vous voudrez réorganiser et renommer des ressources importées.
Deux options pour renommer : terraform state mv (impératif) ou les blocs moved (déclaratif). Je préfère moved car cela documente le changement dans l'historique de version :
moved {
  from = aws_instance.old_name
  to   = aws_instance.new_name
}
Au-delà du renommage, remplacez les IDs en dur par des références de ressources. Au lieu de vpc_id = "vpc-123456", utilisez vpc_id = aws_vpc.main.id. Vous construisez ainsi des graphes de dépendances exploitables par Terraform pour l'ordre d'exécution.
Dernier volet de la gestion d'état : prévenir le drift futur.
Après import, imposez une règle fondamentale : tous les changements passent par Terraform, pas par la console cloud. C'est le seul moyen d'éviter l'écart entre code et réalité.
Cependant, certains attributs dérivent en permanence sans nécessité d'être gérés. Pour ceux-là, utilisez l'argument de cycle de vie ignore_changes :
lifecycle {
  ignore_changes = [tags["LastModified"]]
}
Enfin, établissez un standard de « plan propre » où terraform plan n'affiche que des modifications intentionnelles. Prenez l'habitude de lancer des plans régulièrement, même hors déploiement, pour détecter tôt le drift avant qu'il ne devienne un problème majeur.
Malgré une bonne préparation, un import peut échouer. Diagnostic et résolutions des cas les plus fréquents.
Les erreurs d'adresse et d'ID sont les plus courantes.
Voici les erreurs d'import les plus fréquentes et leurs correctifs :
Cause : Doublons d'état. La ressource est déjà suivie sous un autre nom
Correctif : Exécutez terraform state list pour trouver les doublons, puis terraform state rm pour supprimer l'ancienne entrée avant de réimporter
Après un import réussi, méfiez-vous des plans qui souhaitent remplacer les ressources.
Si terraform plan affiche « forces replacement » après import, identifiez l'argument qui impose la recréation. Les causes courantes sont des arguments immuables (AMI EC2, zone de disponibilité, etc.). Ils ne peuvent pas être modifiés après création.
Le correctif est simple : alignez la configuration sur la réalité. Copiez les valeurs effectives depuis le plan dans votre fichier de configuration.
Règle de sécurité critique : n'appliquez jamais si cela propose de détruire des ressources critiques. C'est le signe qu'il y a un problème.
Parfois, le souci ne vient pas de votre configuration, mais de la façon dont vos providers sont configurés.
Les erreurs « Provider configuration depends on non-var » surviennent quand vos blocks provider utilisent des valeurs calculées pendant l'import. Terraform a besoin d'une configuration statique du provider pour localiser la ressource.
Le contournement est de durcir temporairement : remplacez les paramètres dynamiques du provider par des valeurs littérales, exécutez l'import, puis restaurez la configuration dynamique. Vous pouvez aussi utiliser des variables d'environnement pour l'authentification, que Terraform sait résoudre pendant l'import.
Si l'ID semble correct mais que l'import échoue toujours, consultez la section « Import » de la documentation du provider pour le format exact : certaines ressources utilisent des IDs composés avec des barres obliques ou des deux-points.
Vous avez appris à placer une infrastructure existante sous gestion Terraform avec la CLI et les blocs d'import. Avant chaque import, suivez cette check-list de sécurité :
Mais l'import ne s'arrête pas à terraform apply. Le vrai travail commence après : définir des politiques anti-drift, refactoriser les ressources importées pour les aligner sur vos standards, et sensibiliser l'équipe à une gestion exclusivement par le code. Ce changement culturel est aussi important que l'implémentation technique.
Pour aller plus loin, explorez la manipulation d'état avec terraform state mv et terraform state rm. Ces commandes complètent l'import en vous aidant à réorganiser et refactoriser l'état au fil de l'évolution de votre infrastructure.
Consultez aussi notre guide sur l'utilisation de Terraform avec Docker, et préparez votre prochain entretien avec nos meilleures questions d'entretien Terraform.
Cours sur le cloud
Cours
Cours
Cours