
Curso
Entendendo a computação em nuvem
2 h
254K
Seu time vem criando recursos na nuvem há anos com cliques no console e scripts de shell. Agora você quer adotar Infrastructure as Code, mas recriar tudo do zero parece inviável. Já passei por isso, e a funcionalidade de import do Terraform é a saída para esse desafio.
Os riscos do "ClickOps" e da gestão manual de infraestrutura aumentam com o tempo. Os recursos ficam sem documentação, as configurações se distanciam dos padrões e o conhecimento fica na cabeça das pessoas em vez de estar documentado. Quando alguém sai da equipe, suas decisões de infraestrutura vão embora junto.
É por isso que as organizações adotam Infrastructure as Code (IaC). Neste tutorial, vou mostrar como importar infraestrutura existente para o Terraform.
Vamos comparar o comando de import pela CLI com os import blocks declarativos introduzidos no Terraform 1.5, explorar fluxos práticos para ambas as abordagens e enfrentar armadilhas comuns que podem transformar um simples import em incidente de produção. No fim, você vai ter segurança para colocar sua infraestrutura atual sob gestão por código.
Se você é novo em IaC e provedores de nuvem, considere fazer um dos nossos cursos, como AWS Concepts, Understanding Cloud Computing ou Understanding Microsoft Azure.
Quando você cria a infraestrutura com o Terraform desde o início, tudo flui. Você escreve a configuração, roda terraform plan, revisa as mudanças e aplica. O Terraform rastreia tudo no state file, criando um mapeamento perfeito entre seu código e os recursos na nuvem.
Mas o que acontece quando os recursos já existem fora do conhecimento do Terraform? Vamos começar entendendo exatamente o que o import faz e por que ele existe.
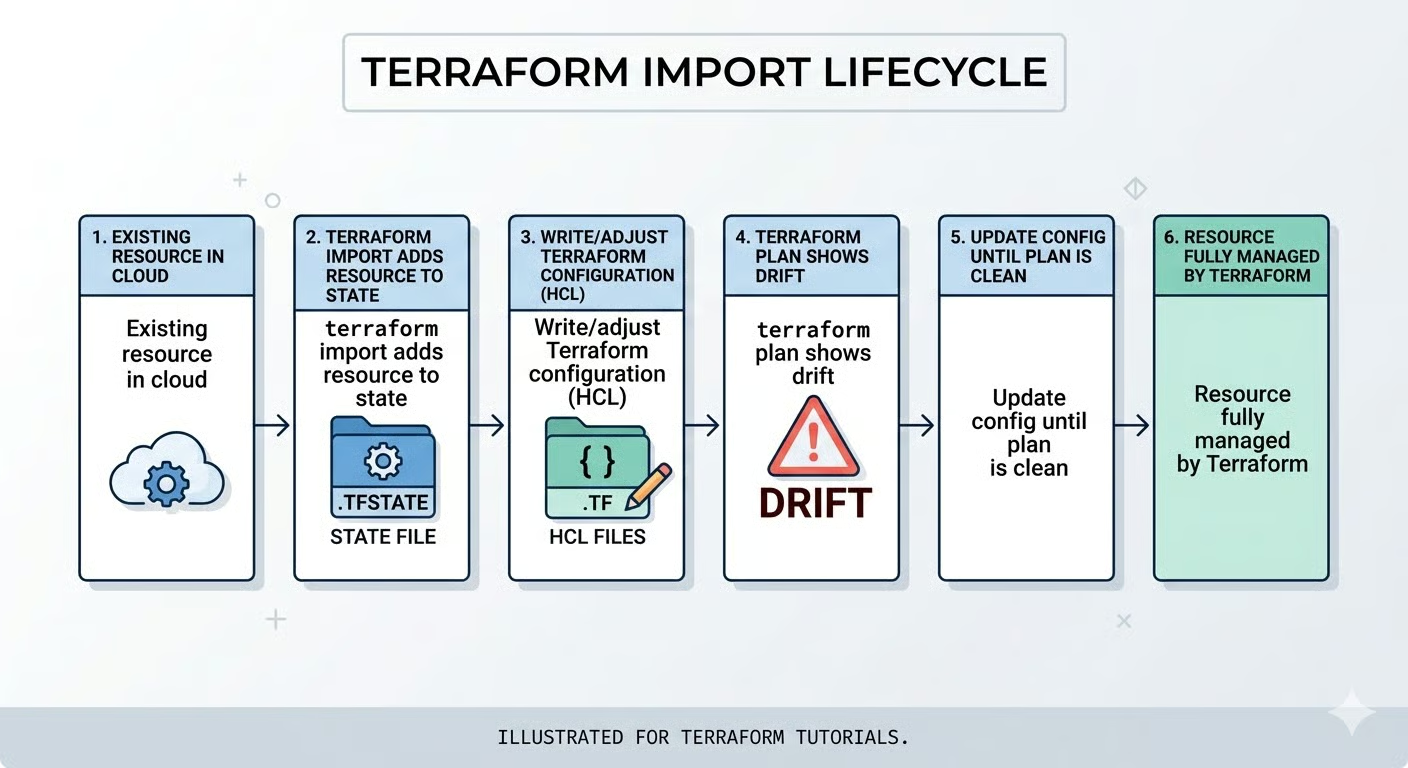
O Terraform import associa a infraestrutura real já existente a entradas no state file do Terraform sem criar novos recursos. Pense como uma adoção: você está dizendo ao Terraform para começar a gerenciar um recurso que já está em execução.
Isso resolve o problema de "TI sombra". As organizações acumulam infraestrutura de várias formas: deploys pelo console durante incidentes, recursos de teste que viraram permanentes ou sistemas legados anteriores à adoção de IaC. O import reconcilia essa realidade com os princípios de Infrastructure as Code.
Aqui está o ponto crucial: import é principalmente uma operação de estado. Ele não escreve o código de configuração automaticamente, a menos que você use os recursos de geração no Terraform 1.5+. É sua responsabilidade garantir que sua configuração HCL reflita corretamente o recurso importado.
Agora que entendemos o que o import faz, vamos ver quando você deve e quando não deve usá-lo.
Eu recomendo importar em três cenários principais:
Porém, o import nem sempre é a melhor escolha. Para recursos temporários de teste ou infraestrutura com baixa padronização, muitas vezes recomendo recriar do zero.
Começar do início permite aplicar boas práticas atuais, implementar convenções de nomenclatura adequadas e adicionar configurações de segurança que recursos legados podem não ter. O esforço inicial costuma se pagar em manutenção no longo prazo.
É essencial diferenciar import de data sources do Terraform. Data sources permitem referenciar informações somente leitura de infraestrutura existente sem gerenciá-la. Por exemplo, você pode usar um data source para buscar uma VPC existente criada por outro time e então implantar seus recursos dentro dela.
O import, por sua vez, coloca os recursos sob gestão completa do Terraform, incluindo a capacidade de modificá-los ou destruí-los. Escolha import quando você precisa gerenciar todo o ciclo de vida do recurso, não apenas referenciá-lo.
Antes de começar a importar, há limitações fundamentais que você precisa entender.
Todo recurso importado exige um identificador único específico do provedor. Para AWS, pode ser i-0123456789abcdef0. Para Azure, é um caminho completo do recurso, como /subscriptions/{id}/resourceGroups/{rg}/providers/{provider}/{resource}. Errar isso é a principal causa de falhas de import.
As operações de import modificam diretamente seu state file, portanto, backups são essenciais. Se usar backends versionados como S3, verifique se a versioning está habilitada. Com state local, copie manualmente para terraform.tfstate.backup.
Depois do import, você vai se deparar com "drift": o descompasso entre o estado importado e a configuração local. Você atualizará seu HCL de forma iterativa até que o terraform plan mostre zero mudanças pendentes.
Antes de importar qualquer coisa, garanta que você está preparado para o sucesso. Já vi imports darem errado porque as equipes pularam etapas de preparação.
O primeiro passo é garantir que seu ambiente Terraform esteja configurado corretamente.
Comece verificando sua instalação do Terraform com terraform version. Se quiser usar import blocks declarativos e geração automática de código, garanta que está no Terraform 1.5 ou superior. Esses recursos simplificam bastante o processo de import para recursos complexos.
Antes de importar, verifique estes pré-requisitos:
Credenciais do provider ativas: Para AWS, confira se AWS_ACCESS_KEY_ID e AWS_SECRET_ACCESS_KEY estão definidos, ou se seu perfil da AWS CLI está configurado. Teste com aws sts get-caller-identity.
Workspace correto selecionado: Rode terraform workspace show para garantir que você não vai importar no ambiente errado.
State file desbloqueado: Coordene com os colegas e verifique pipelines de CI/CD para garantir que não há operações concorrentes.
Backend acessível: Se usar state remoto, valide a conectividade com S3, Azure Storage ou Terraform Cloud.
Um state file bloqueado fará seu import falhar imediatamente com erro de lock, então essa coordenação é crítica em ambientes de time.
Com o ambiente validado, o próximo passo é encontrar o identificador exato do recurso que você quer importar.
Os IDs de recursos variam bastante por provedor e tipo de recurso, tornando essa etapa mais traiçoeira do que parece. Aqui vão exemplos de provedores comuns:
|
Provider |
Resource Type |
ID Format |
Example |
|
AWS |
EC2 Instance |
Instance ID |
|
|
AWS |
S3 Bucket |
Bucket name |
|
|
AWS |
Security Group |
Group ID |
|
|
Azure |
Virtual Machine |
Full resource path |
|
|
GCP |
Compute Instance |
Project/zone/name |
|
Para recursos da AWS, você encontra IDs direto no console. Acesse o serviço (EC2, S3 etc.), selecione seu recurso e copie o identificador no painel de detalhes.
Para a Azure, use a Azure CLI para recuperar o caminho completo do recurso:
az resource show --name myresource --resource-group mygroupA saída inclui o ID completo de recurso que você vai precisar para o import.
Aqui vai uma armadilha comum pela qual já passei: tentar importar um recurso da região ou assinatura errada. Se a configuração do seu provider no Terraform aponta para us-east-1, mas sua instância EC2 está em us-west-2, o import falhará com "resource not found" mesmo com o ID correto.
Sempre confirme que o escopo corresponde à configuração do provider antes de prosseguir. Com o ID correto em mãos, você precisa decidir qual método de import usar.
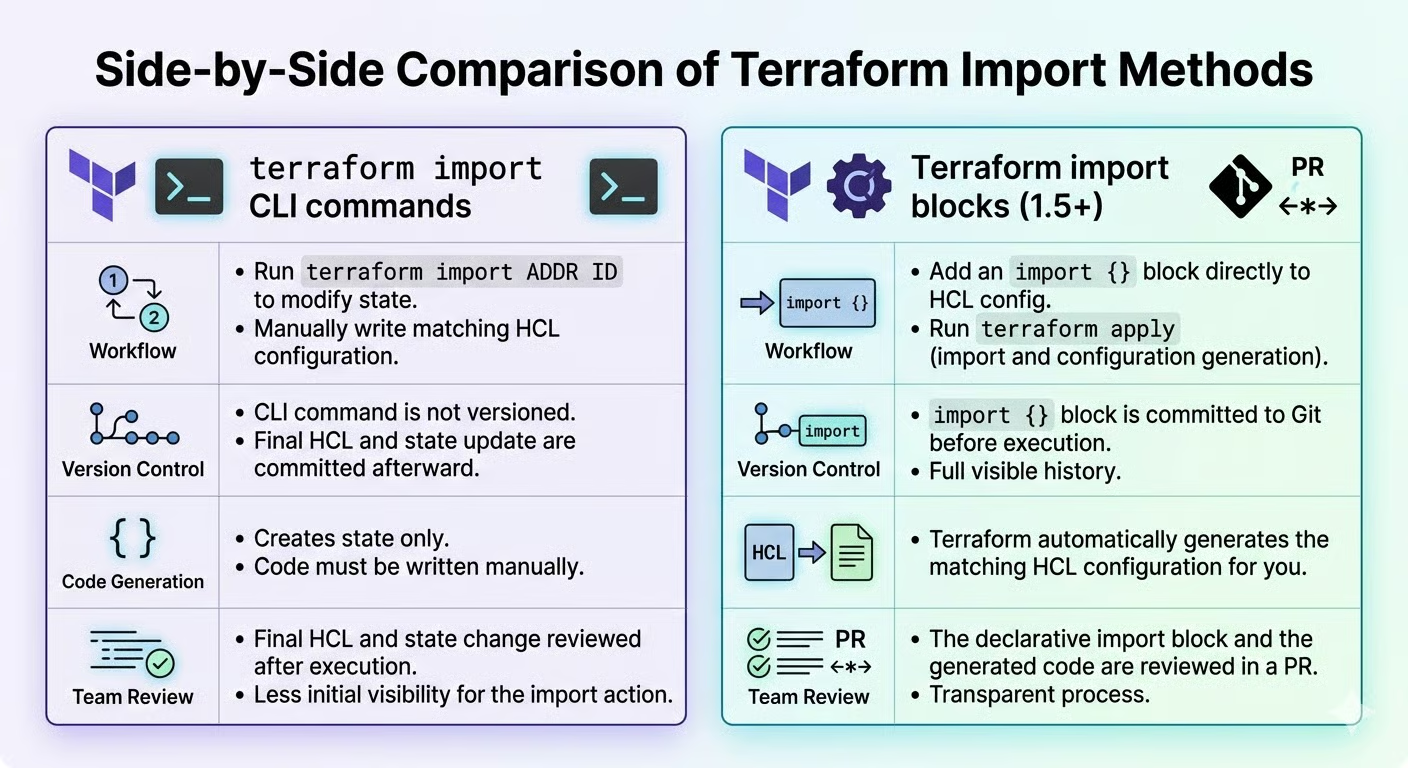
Você tem dois caminhos: o comando de CLI terraform import ou os blocos import. Veja a comparação:
|
Feature |
CLI Command |
Import Blocks (1.5+) |
|
Terraform Version |
All versions |
1.5 or later |
|
Best For |
Quick, one-off imports |
Team workflows, bulk imports |
|
Version Control |
No record in code |
Fully documented in HCL |
|
Code Generation |
Not available |
Automatic with |
|
Code Review |
Difficult to review |
Standard PR process |
|
Reproducibility |
Manual re-execution |
Declarative, repeatable |
Eu recomendo import blocks para times que precisam de code reviews e planos reprodutíveis, e a CLI para correções rápidas em versões legadas.
Por que isso importa? Os import blocks tratam a adoção de infraestrutura como código, o que significa que seus imports passam a fazer parte do fluxo versionado com o mesmo rigor de qualquer outra mudança. Isso reduz riscos e cria uma trilha de auditoria essencial para compliance e coordenação do time.
Os import blocks se integram perfeitamente ao seu workflow no Git, permitindo que colegas revisem e aprovem imports como qualquer outra mudança. A CLI, embora mais rápida para tarefas individuais, não deixa rastro de auditoria e não é facilmente reproduzível entre ambientes.
Com a estratégia escolhida, vamos mergulhar em cada fluxo de trabalho em detalhes, começando pela abordagem tradicional via CLI.
Vou te guiar pelo processo tradicional baseado em CLI. Embora os import blocks declarativos estejam se tornando preferidos, entender o método via CLI continua valioso para versões legadas do Terraform e imports rápidos e pontuais.
O primeiro passo no fluxo da CLI é configurar seu arquivo de configuração.
Antes de executar terraform import, você deve definir um resource block na sua configuração. Isso é obrigatório: o Terraform precisa saber para onde mapear o estado importado. O bloco pode estar vazio ou parcialmente preenchido.
Veja um exemplo para importar um bucket S3 da AWS:
resource "aws_s3_bucket" "legacy_data" {
  # Configuration to be filled after import
}
O tipo do recurso (aws_s3_bucket) deve corresponder exatamente ao tipo de infraestrutura que você está importando. O nome do recurso (legacy_data) deve seguir as convenções do seu projeto. Use nomes descritivos como production_data_bucket em vez de genéricos como bucket1.
Com o resource block pronto, você pode rodar o comando de import.
Execute terraform import <resource_address> <resource_id>. Para nosso bucket S3:
terraform import aws_s3_bucket.legacy_data my-existing-bucket-nameO Terraform obtém os atributos atuais do bucket pela API do provider e os registra no state. Você verá:
aws_s3_bucket.legacy_data: Import complete!
Imported aws_s3_bucket
O state agora contém o recurso, mas sua configuração segue vazia ou incompleta.
É aqui que começa o trabalho de verdade: alinhar seu código ao state importado.
Rode terraform plan para ver as diferenças entre state e configuração. Você verá atributos computados (valores somente leitura como timestamps) e requisitos explícitos de configuração que precisam ser declarados.
Atualize sua configuração incrementalmente usando valores do plan. Se o plano propuser "replacing" o recurso, pare. Isso indica divergências em argumentos imutáveis, como região ou zona de disponibilidade. Ajuste sua configuração para corresponder aos atributos imutáveis do recurso existente.
Agora vamos ver a abordagem moderna introduzida no Terraform 1.5. Os import blocks transformam o import de um comando imperativo para uma configuração declarativa que vive junto do seu código de infraestrutura.
A grande vantagem é reprodutibilidade e visibilidade do time. Com imports via CLI, não há registro em código do que foi importado. Com import blocks, cada import é documentado, versionado e revisável via pull requests.
Vamos começar criando o próprio import block.
Um import block tem dois componentes: to (endereço de destino) e id (identificador do recurso):
import {
  to = aws_instance.web_server
  id = "i-0123456789abcdef0"
}
Isso traz visibilidade para o versionamento. Os times podem revisar import blocks em pull requests antes da execução. Coloque os import blocks em imports.tf para facilitar a limpeza após imports bem-sucedidos.
E aqui está onde os import blocks brilham: o Terraform pode gerar o código de configuração automaticamente, eliminando o trabalho tedioso de escrever HCL do zero.
Os import blocks permitem geração automática de configuração. Rode terraform plan -generate-config-out=generated.tf para planejar o import e escrever o HCL completo ao mesmo tempo.
O arquivo gerado contém cada atributo com seus valores atuais. Revise, remova padrões verbosos e incorpore a configuração relevante ao seu repositório. Isso evita erros comuns: atributos com nomes errados, tipos incorretos e campos obrigatórios ausentes. Especialmente para recursos complexos, isso é valioso.
Com a configuração pronta, é hora de executar o import.
Por fim, rode terraform apply para executar o import e alinhar o state com a configuração. O Terraform mostrará exatamente o que está sendo importado antes de alterar seu state file.
Após a aplicação bem-sucedida, remova os import blocks da sua configuração. Eles já cumpriram o papel e mantê-los pode confundir execuções futuras. Por fim, rode terraform plan mais uma vez para verificar que não há mudanças pendentes, confirmando que sua configuração e o state estão perfeitamente sincronizados.
Os fluxos que cobrimos até aqui funcionam bem para recursos simples e isolados. Mas a infraestrutura de produção raramente é tão direta. Vamos encarar a complexidade real de módulos, iteração e dependências.
Infraestruturas reais raramente são compostas de recursos simples e isolados. Recursos gerenciados por módulos exigem uma sintaxe especial de endereçamento, que é nosso primeiro desafio.
Recursos de módulos exigem endereçamento com caminho completo: module.<module_name>.<resource_type>.<resource_name>, o que pode ficar assim:
terraform import module.network.aws_vpc.main vpc-0abcdef123456789Para encontrar o endereço correto, use terraform state list após um apply normal. Isso mostra exatamente como o Terraform referencia recursos de módulos. Errar o endereço cria entradas duplicadas no state, que o Terraform tentará criar no próximo apply.
Além disso, ao importar para instâncias de módulo com count ou for_each, você precisará incluir o identificador da instância entre aspas:
terraform import 'module.network[0].aws_vpc.main' vpc-0abcdef123456789Além do endereçamento de módulos, recursos que usam os meta-argumentos count ou for_each trazem seus próprios desafios.
Quando sua configuração Terraform usa count para criar múltiplas instâncias de um recurso, você usará sintaxe de array no import. Por exemplo, se sua configuração estiver assim:
resource "aws_instance" "server" {
  count         = 3
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Você importará cada instância individualmente usando seu índice:
terraform import 'aws_instance.server[0]' i-0123456789abcdef0
terraform import 'aws_instance.server[1]' i-1234567890abcdef1
terraform import 'aws_instance.server[2]' i-2345678901abcdef2
Já recursos que usam for_each na configuração exigem chaves string. Considere este exemplo:
resource "aws_instance" "server" {
  for_each      = toset(["web", "api", "worker"])
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Aqui, você importaria usando os nomes das chaves:
terraform import 'aws_instance.server["web"]' i-0123456789abcdef0
terraform import 'aws_instance.server["api"]' i-1234567890abcdef1
terraform import 'aws_instance.server["worker"]' i-2345678901abcdef2
Se você encontrar erros de "index out of range", significa que o valor de count não corresponde ao número de recursos que você está importando. A correção é simples: defina o count correto ou as chaves for_each apropriadas na configuração antes de executar o import.
Além disso, pense nas relações entre recursos, especialmente em arquiteturas complexas.
Alguns recursos de nuvem não são importados como entidades únicas. Em vez disso, entram como múltiplos recursos no Terraform. Exemplos comuns incluem:
Nesses casos, sempre importe os recursos "pais" primeiro. Por exemplo, importe VPCs antes de subnets, funções do IAM antes de anexos de políticas e security groups antes das regras individuais. Isso estabelece a cadeia de dependências correta no seu state.
Depois do import, revise sua configuração e declare dependências explicitamente com depends_on onde o provider não as detecta automaticamente. Isso garante que futuros apply ocorram na ordem correta, evitando erros como o Terraform tentar criar uma subnet antes da VPC existir.
Com os recursos importados e configurados corretamente, a próxima fase foca em manutenção e organização de longo prazo.
Importar recursos é só o começo. O sucesso no longo prazo exige boa gestão de state e refatorações ocasionais.
Segurança deve ser sua primeira preocupação ao importar recursos de produção.
Aqui está algo que pega muitos times de surpresa: importar bancos de dados ou chaves de criptografia traz valores sensíveis — como senhas, chaves privadas e strings de conexão — para seu state file em texto claro. Isso é uma consideração crítica de segurança que você deve tratar imediatamente.
A solução é usar backends remotos criptografados. Na AWS, use S3 com encrypt = true e, opcionalmente, KMS habilitado. No Azure, use Azure Storage com criptografia em repouso. Se você usa HCP Terraform / Terraform Cloud, o state é criptografado em repouso e em trânsito por padrão, mas ainda vale verificar os controles de acesso.
Além disso, após importar recursos de produção com dados sensíveis, faça duas ações adicionais: verifique se os controles de acesso ao armazenamento do state estão corretamente configurados e habilite audit logging para rastrear quem acessa o state e quando. Essas medidas criam uma trilha de auditoria valiosa para compliance.
Conforme sua infraestrutura evolui, você vai querer reorganizar e renomear recursos importados.
Você tem duas opções para renomear recursos: terraform state mv (imperativo) ou blocos moved (declarativo). Eu prefiro moved porque documenta a mudança no histórico de versionamento:
moved {
  from = aws_instance.old_name
  to   = aws_instance.new_name
}
Além de renomear, substitua IDs fixos por referências de recursos. Em vez de vpc_id = "vpc-123456", use vpc_id = aws_vpc.main.id. Essa abordagem constrói grafos de dependência que o Terraform usa para determinar a ordem correta das operações.
A última peça da gestão de state é prevenir drift futuro.
Depois do import, a política mais importante é: todas as mudanças passam pelo Terraform, não pelo console da nuvem. Esse é o único jeito de evitar drift entre seu código e a realidade.
Porém, alguns atributos mudam constantemente e não precisam de gestão. Para esses, use o argumento de lifecycle ignore_changes:
lifecycle {
  ignore_changes = [tags["LastModified"]]
}
Por fim, estabeleça o padrão de "plano limpo", em que o terraform plan mostra apenas mudanças intencionais. Torne rotina rodar planos com frequência, mesmo sem deploys, para detectar drift cedo antes que vire problema grande.
Mesmo com preparo, operações de import podem falhar. Vamos diagnosticar e resolver os problemas mais comuns que você pode encontrar.
Endereços e IDs divergentes são os problemas mais frequentes.
Aqui estão os erros de import mais comuns e como corrigir:
Cause: Entradas duplicadas no state. O recurso já está sendo rastreado com outro nome
Fix: Rode terraform state list para encontrar duplicatas e então use terraform state rm para remover a entrada antiga antes de reimportar
Depois de importar com sucesso, fique atento a planos que querem substituir recursos.
Se o terraform plan mostrar "forces replacement" após o import, você precisa identificar qual argumento está causando a recriação. Causas comuns são argumentos imutáveis como IDs de AMI do EC2 ou zonas de disponibilidade. Eles não podem ser alterados após a criação do recurso.
A correção é simples: alinhe sua configuração à realidade. Copie os valores reais do plan para seu arquivo de configuração.
E aqui vai uma regra de ouro: nunca confirme ou aplique se houver proposta de destruir recursos críticos. Esse é o sinal de alerta de que algo está errado.
Às vezes, o problema não está na sua configuração, mas em como seus providers estão configurados.
Erros "Provider configuration depends on non-var" acontecem quando seu bloco de provider usa valores computados durante o import. O Terraform precisa de configuração estática do provider para localizar o recurso a ser importado.
O contorno é um hard-code temporário: substitua configurações dinâmicas do provider por valores literais, rode o import e depois restaure sua configuração dinâmica. Alternativamente, use variáveis de ambiente para autenticação do provider, que o Terraform consegue resolver durante o import.
Se o ID do recurso parece correto mas o import continua falhando, confira a seção "Import" na documentação do provider para os requisitos exatos de formato do ID. Alguns recursos usam IDs compostos com barras ou dois-pontos como separadores, e acertar o formato é essencial.
Você aprendeu a colocar infraestrutura existente sob gestão do Terraform usando comandos de CLI e import blocks. Antes de cada import, siga este checklist de segurança:
No entanto, o trabalho não termina no terraform apply. O trabalho real começa depois: estabelecer políticas de prevenção de drift, refatorar recursos importados para alinhá-los aos seus padrões e educar o time para gerenciar infraestrutura exclusivamente por código. Essa mudança cultural é tão importante quanto a implementação técnica.
Como próximo passo, recomendo explorar a manipulação de state no Terraform com terraform state mv e terraform state rm. Esses comandos complementam o import ajudando você a reorganizar e refatorar o state conforme sua infraestrutura evolui.
Também recomendo conferir nosso guia sobre usar Terraform com Docker e se preparar para a próxima entrevista com nossas principais perguntas de entrevistas sobre Terraform.
Cursos de nuvem
Curso
Curso
Curso
blog
Srujana Maddula
13 min
blog
Matt Crabtree
9 min
Tutorial
Tim Lu
15 min
Tutorial
Tutorial
Zoumana Keita
14 min
Tutorial


