
Curso
Comprender la computación en la nube
2 h
253.8K
Tu equipo lleva años desplegando recursos en la nube con clics en la consola y scripts de shell. Ahora quieres adoptar Infrastructure as Code, pero recrearlo todo desde cero impone. He estado ahí, y la funcionalidad de import de Terraform es la solución a este reto.
Con el tiempo, los riesgos del "ClickOps" y la gestión manual se agravan. Los recursos quedan sin documentar, las configuraciones se alejan de los estándares y el conocimiento tribal sustituye a la documentación adecuada. Cuando alguien se va, sus decisiones sobre infraestructura se van con esa persona.
Por eso las organizaciones adoptan Infrastructure as Code (IaC). En este tutorial, te guiaré para importar infraestructura existente en Terraform.
Compararemos el comando de import basado en CLI con los bloques declarativos import introducidos en Terraform 1.5, veremos flujos de trabajo prácticos para ambos enfoques y abordaremos errores comunes que pueden convertir un import sencillo en un incidente en producción. Al final, te sentirás con confianza para llevar tu infraestructura actual a la gestión como código.
Si estás empezando con IaC y proveedores cloud, planteate hacer alguno de nuestros cursos, como AWS Concepts, Understanding Cloud Computing o Understanding Microsoft Azure.
Cuando creas infraestructura con Terraform desde el principio, todo fluye: escribes la configuración, ejecutas terraform plan, revisas los cambios y los aplicas. Terraform lo registra todo en su archivo de estado, creando un mapa perfecto entre tu código y tus recursos en la nube.
Pero ¿qué pasa cuando los recursos ya existen fuera del conocimiento de Terraform? Empecemos entendiendo exactamente qué hace import y por qué existe.
Terraform import mapea infraestructura real existente a entradas en el archivo de estado de Terraform sin crear recursos nuevos. Piénsalo como una adopción: le indicas a Terraform que empiece a gestionar un recurso que ya está en funcionamiento.
Esto soluciona el problema del "shadow IT". Las organizaciones acumulan infraestructura de muchas formas: despliegues desde la consola durante incidencias, recursos de prueba que se vuelven permanentes o sistemas heredados anteriores a la adopción de IaC. Import reconcilia esta realidad con los principios de Infrastructure as Code.
Aquí está lo crucial: import es ante todo una operación sobre el estado. No escribe automáticamente código de configuración salvo que uses funciones de generación en Terraform 1.5+. Tú eres responsable de que tu configuración HCL refleje con exactitud el recurso importado.
Ahora que entendemos qué hace import, veamos cuándo deberías usarlo (y cuándo no).
Recomiendo importar en tres escenarios principales:
Sin embargo, import no siempre es la mejor opción. Para recursos de prueba temporales o infraestructura con poca estandarización, a menudo recomiendo una recreación limpia.
Empezar desde cero te permite aplicar las mejores prácticas actuales, implementar convenciones de nombres adecuadas y añadir configuraciones de seguridad que quizá falten en recursos heredados. El esfuerzo inicial suele compensar en mantenibilidad a largo plazo.
Es clave distinguir import de las data sources de Terraform. Las data sources te permiten referenciar información de solo lectura de infraestructura existente sin gestionarla. Por ejemplo, puedes usar una data source para consultar una VPC existente creada por otro equipo y desplegar tus recursos dentro de ella.
Import, en cambio, pone los recursos bajo gestión completa de Terraform, incluida la posibilidad de modificarlos o destruirlos. Elige import cuando necesites gestionar todo el ciclo de vida de un recurso, no solo referenciarlo.
Antes de empezar a importar, hay algunas limitaciones fundamentales que debes conocer.
Cada recurso importado requiere un identificador único específico del proveedor. En AWS puede ser i-0123456789abcdef0. En Azure, es una ruta completa del recurso como /subscriptions/{id}/resourceGroups/{rg}/providers/{provider}/{resource}. Equivocarte aquí es la causa principal de fallos de import.
Las operaciones de import modifican directamente tu archivo de estado, así que las copias de seguridad son esenciales. Si usas backends versionados como S3, verifica que la versioning esté habilitada. Con estado local, copia manualmente a terraform.tfstate.backup.
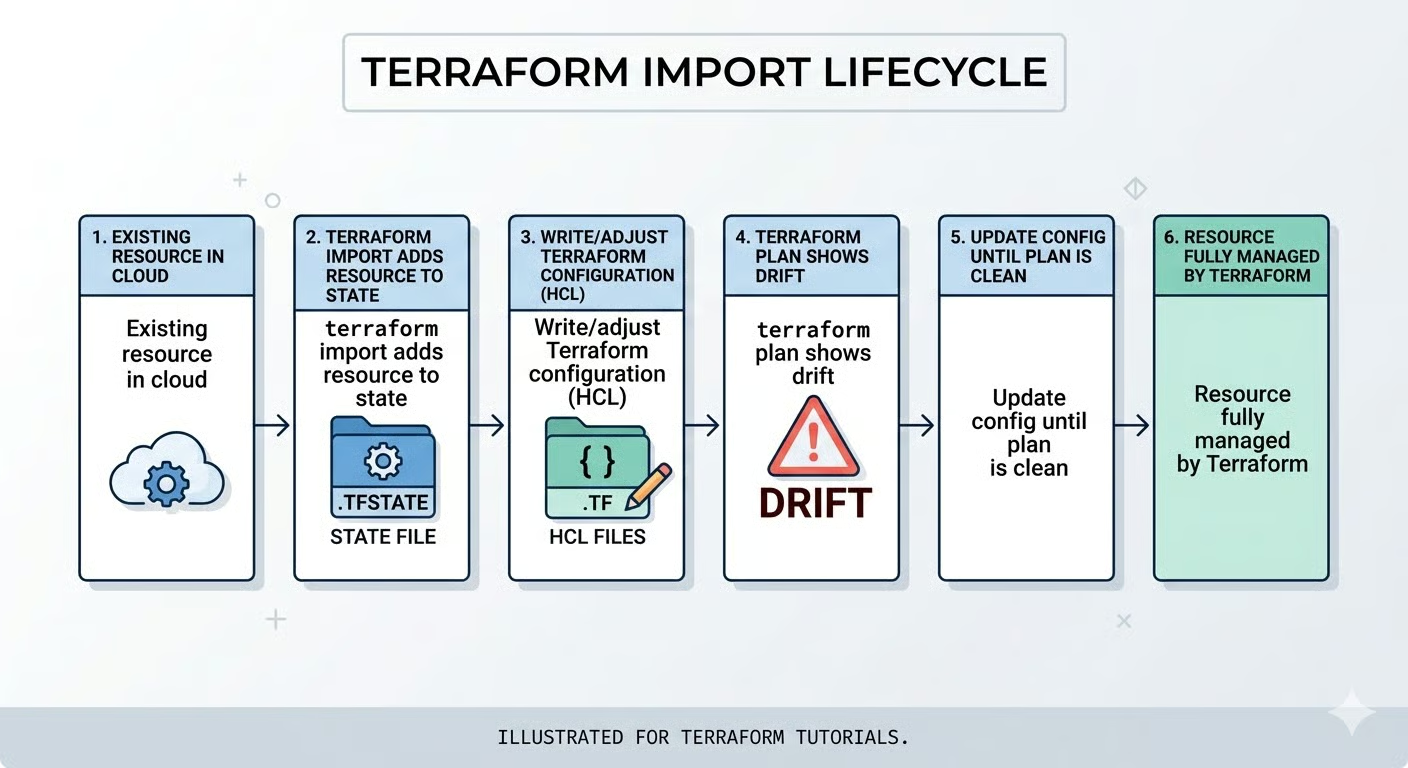
Tras importar, te encontrarás con "drift": el desajuste entre el estado importado y la configuración local. Actualizarás tu HCL iterativamente hasta que terraform plan muestre cero cambios pendientes.
Antes de importar nada, asegúrate de preparar el terreno. He visto imports fallar porque los equipos se saltaron pasos de preparación.
El primer paso es confirmar que tu entorno de Terraform está bien configurado.
Empieza comprobando tu instalación con terraform version. Si quieres usar bloques import declarativos y generación automática de código, asegúrate de estar en Terraform 1.5 o posterior. Estas funciones simplifican mucho el proceso de import para recursos complejos.
Antes de importar, verifica estos requisitos:
Credenciales del proveedor activas: en AWS, comprueba que AWS_ACCESS_KEY_ID y AWS_SECRET_ACCESS_KEY están definidos o que tu perfil de AWS CLI está configurado. Prueba con aws sts get-caller-identity.
Workspace correcto seleccionado: ejecuta terraform workspace show para asegurarte de no importar por error en el entorno equivocado.
Archivo de estado desbloqueado: coordínate con el equipo y revisa las pipelines de CI/CD para evitar operaciones concurrentes.
Backend accesible: si usas estado remoto, verifica la conectividad con S3, Azure Storage o Terraform Cloud.
Un archivo de estado bloqueado hará que el import falle de inmediato con un error de adquisición de bloqueo, así que esta coordinación es crítica en equipos.
Con el entorno validado, el siguiente paso clave es encontrar el identificador exacto del recurso que quieres importar.
Los IDs de recursos varían mucho según proveedor y tipo, lo que hace este paso más delicado de lo que parece. Aquí tienes ejemplos de proveedores comunes:
|
Proveedor |
Tipo de recurso |
Formato de ID |
Ejemplo |
|
AWS |
Instancia EC2 |
ID de instancia |
|
|
AWS |
Bucket S3 |
Nombre del bucket |
|
|
AWS |
Security group |
ID del grupo |
|
|
Azure |
Máquina virtual |
Ruta completa del recurso |
|
|
GCP |
Instancia de Compute |
Proyecto/zona/nombre |
|
Para recursos de AWS, puedes encontrar los IDs directamente en la consola. Ve al servicio (EC2, S3, etc.), selecciona tu recurso y copia el identificador del panel de detalles.
En Azure, usa Azure CLI para obtener la ruta completa del recurso:
az resource show --name myresource --resource-group mygroupLa salida incluye el ID completo del recurso que necesitarás para importar.
Hay una trampa común en la que he caído: intentar importar un recurso de la región o suscripción equivocada. Si tu configuración del proveedor en Terraform apunta a us-east-1 pero tu instancia de EC2 vive en us-west-2, el import fallará con "resource not found" aunque el ID sea correcto.
Verifica siempre que el alcance coincide con tu configuración del proveedor antes de seguir. Una vez tengas el ID correcto, debes decidir qué método de import usar.
Tienes dos caminos: el comando CLI terraform import o los bloques import. Así se comparan:
|
Función |
Comando CLI |
Bloques import (1.5+) |
|
Versión de Terraform |
Todas las versiones |
1.5 o posterior |
|
Mejor para |
Imports rápidos y puntuales |
Trabajo en equipo, imports en lote |
|
Control de versiones |
Sin registro en el código |
Totalmente documentado en HCL |
|
Generación de código |
No disponible |
Automática con |
|
Revisión de código |
Difícil de revisar |
Proceso estándar de PR |
|
Reproducibilidad |
Reejecución manual |
Declarativo y repetible |
Recomiendo bloques import para equipos que necesitan revisiones de código y planes reproducibles, y la CLI para arreglos rápidos en versiones heredadas.
¿Por qué importa? Los bloques import tratan la adopción de infraestructura como código, de modo que tus imports pasan a formar parte del flujo de trabajo con control de versiones, con el mismo rigor que cualquier otro cambio. Esto reduce errores y crea una trazabilidad esencial para el cumplimiento y la coordinación del equipo.
Los bloques import se integran sin fricción con tu flujo de trabajo en Git, permitiendo que tus compañeros revisen y aprueben imports como cualquier cambio de infraestructura. La CLI, aunque más rápida para tareas individuales, no deja rastro de auditoría y es difícil de reproducir entre entornos.
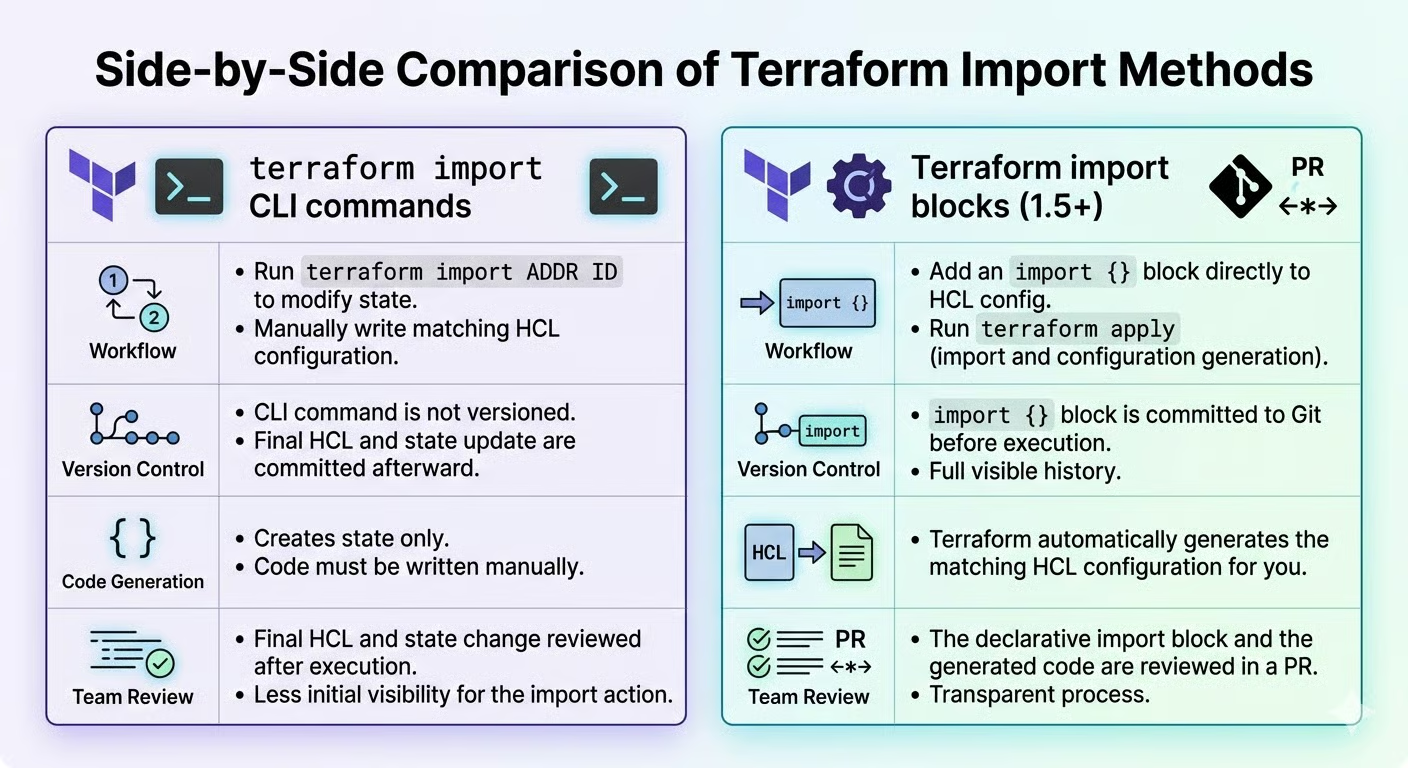
Con la estrategia elegida, vamos a cada flujo de trabajo en detalle, empezando por el enfoque tradicional con CLI.
Te explico el proceso tradicional basado en CLI. Aunque los bloques import declarativos ganan terreno, entender el método CLI sigue siendo valioso para versiones heredadas de Terraform y imports rápidos y puntuales.
El primer paso en el flujo con CLI es preparar tu archivo de configuración.
Antes de ejecutar terraform import, debes definir un bloque resource en tu configuración. Es un requisito: Terraform necesita saber dónde mapear el estado importado. El bloque puede estar vacío o parcialmente rellenado.
Este es un ejemplo para importar un bucket S3 de AWS:
resource "aws_s3_bucket" "legacy_data" {
  # Configuration to be filled after import
}
El tipo de recurso (aws_s3_bucket) debe coincidir exactamente con el tipo que estás importando. El nombre (legacy_data) debería seguir las convenciones de tu proyecto. Usa nombres descriptivos como production_data_bucket mejor que genéricos como bucket1.
Con el bloque de recurso listo, ya puedes ejecutar el comando de import.
Ejecuta terraform import <resource_address> <resource_id>. Para nuestro bucket S3:
terraform import aws_s3_bucket.legacy_data my-existing-bucket-nameTerraform recupera los atributos actuales del bucket desde la API del proveedor y los guarda en el estado. Verás:
aws_s3_bucket.legacy_data: Import complete!
Imported aws_s3_bucket
El estado ya contiene el recurso, pero tu configuración sigue vacía o incompleta.
Aquí empieza el trabajo de verdad: alinear tu código con el estado importado.
Ejecuta terraform plan para ver diferencias entre estado y configuración. Verás atributos calculados (valores de solo lectura como marcas de tiempo) y requisitos explícitos que debes declarar.
Actualiza tu configuración de forma incremental usando valores de la salida del plan. Si el plan propone "reemplazar" el recurso, detente. Esto indica discrepancias en argumentos inmutables, como región o zona de disponibilidad. Ajusta tu configuración para que coincida con los atributos inmutables del recurso existente.
Ahora veamos el enfoque moderno introducido en Terraform 1.5. Los bloques import convierten el import de un comando imperativo a una configuración declarativa que vive junto a tu código de infraestructura.
La gran ventaja es la reproducibilidad y la visibilidad para el equipo. Con imports por CLI no queda registro en el código. Con bloques import, cada import está documentado, versionado y se revisa vía pull requests.
Empecemos creando el propio bloque de import.
Un bloque import tiene dos componentes: to (dirección de destino) e id (identificador del recurso):
import {
  to = aws_instance.web_server
  id = "i-0123456789abcdef0"
}
Esto aporta visibilidad en control de versiones. Los equipos pueden revisar los bloques import en pull requests antes de ejecutarlos. Coloca los bloques en imports.tf para limpiarlos fácilmente tras completar los imports.
Y aquí es donde brillan: Terraform puede generar la configuración por ti, evitando el tedio y las conjeturas al escribir HCL desde cero.
Los bloques import permiten generar configuración automáticamente. Ejecuta terraform plan -generate-config-out=generated.tf para planificar el import y escribir a la vez el HCL completo.
El archivo generado contiene cada atributo con sus valores actuales. Revísalo, elimina valores por defecto verbosos y fusiona la configuración relevante en tu repositorio. Esto previene errores comunes: atributos mal nombrados, tipos incorrectos y campos obligatorios ausentes. Es especialmente útil para recursos complejos.
Con la configuración lista, toca ejecutar el import.
Por último, ejecuta terraform apply para realizar el import y alinear el estado con la configuración. Terraform te mostrará exactamente qué se va a importar antes de cambiar el archivo de estado.
Tras completar, elimina los bloques import de tu configuración. Ya cumplieron su función y mantenerlos podría confundir futuras ejecuciones. Finalmente, ejecuta terraform plan de nuevo para verificar que no hay cambios pendientes y confirmar que configuración y estado están perfectamente sincronizados.
Lo visto funciona perfecto para recursos simples y aislados. Pero la producción rara vez es tan sencilla. Veamos la complejidad real de módulos, iteraciones y dependencias.
La infraestructura real rara vez son recursos sueltos. Los recursos gestionados por módulos requieren una sintaxis de direccionamiento especial: primer reto.
Los recursos en módulos requieren la ruta completa: module.<module_name>.<resource_type>.<resource_name>, que podría verse así:
terraform import module.network.aws_vpc.main vpc-0abcdef123456789Para encontrar la dirección correcta, usa terraform state list tras un apply normal. Te muestra exactamente cómo referencia Terraform a los recursos en módulos. Si te equivocas, crearás entradas duplicadas en el estado y Terraform intentará crearlas de nuevo en el siguiente apply.
Además, al importar en instancias de módulo con count o for_each, debes incluir el identificador de instancia entre comillas:
terraform import 'module.network[0].aws_vpc.main' vpc-0abcdef123456789Más allá del direccionamiento de módulos, los recursos que usan los metaargumentos count o for_each presentan retos propios.
Cuando tu configuración usa count para crear varias instancias de un recurso, necesitarás sintaxis de array para importar. Por ejemplo, si tu configuración es:
resource "aws_instance" "server" {
  count         = 3
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Importarías cada instancia individualmente usando su índice:
terraform import 'aws_instance.server[0]' i-0123456789abcdef0
terraform import 'aws_instance.server[1]' i-1234567890abcdef1
terraform import 'aws_instance.server[2]' i-2345678901abcdef2
Por otro lado, los recursos que usan for_each requieren claves de tipo string. Considera este ejemplo:
resource "aws_instance" "server" {
  for_each      = toset(["web", "api", "worker"])
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Aquí, importarías usando los nombres de clave:
terraform import 'aws_instance.server["web"]' i-0123456789abcdef0
terraform import 'aws_instance.server["api"]' i-1234567890abcdef1
terraform import 'aws_instance.server["worker"]' i-2345678901abcdef2
Si ves errores de "index out of range", significa que el valor de count no coincide con el número de recursos que importas. La solución es sencilla: ajusta el count o define las claves for_each adecuadas en tu configuración antes de ejecutar el import.
Además, tendrás que pensar en cómo se relacionan los recursos, especialmente en arquitecturas complejas.
Algunos recursos cloud no se importan como una sola entidad. Se importan como varios recursos de Terraform. Ejemplos comunes incluyen:
En estos casos, importa siempre primero los recursos "padre". Por ejemplo, importa VPCs antes que subnets, roles de IAM antes que anexos de políticas y security groups antes que reglas individuales. Así estableces la cadena de dependencias correcta en tu estado.
Tras importar, revisa tu configuración y declara dependencias explícitas con depends_on cuando el proveedor no las detecte automáticamente. Así te aseguras de que futuros apply se ejecuten en el orden correcto y evitas errores como que Terraform intente crear una subnet antes de que exista su VPC.
Con los recursos importados y bien configurados, la siguiente fase se centra en el mantenimiento y la organización a largo plazo.
Importar recursos es solo el principio. El éxito a largo plazo requiere gestionar bien el estado y refactorizar de vez en cuando.
La seguridad debe ser tu primera preocupación al importar recursos de producción.
Algo que pilla a muchos equipos desprevenidos: importar bases de datos o claves de cifrado vuelca valores sensibles (contraseñas, claves privadas, cadenas de conexión) en tu archivo de estado en texto plano. Es una consideración crítica de seguridad que debes abordar de inmediato.
La solución es usar backends remotos cifrados. En AWS, S3 con encrypt = true y, opcionalmente, KMS habilitado. En Azure, Azure Storage con cifrado en reposo. Si usas HCP Terraform / Terraform Cloud, el estado está cifrado en reposo y en tránsito por defecto, pero conviene verificar los controles de acceso.
Además, tras importar recursos de producción con datos sensibles, da dos pasos más: verifica que los accesos al almacenamiento del estado están bien configurados y habilita el logging de auditoría para registrar quién accede al estado y cuándo. Esta trazabilidad es oro para el cumplimiento.
A medida que tu infraestructura evolucione, querrás reorganizar y renombrar recursos importados.
Tienes dos opciones para renombrar recursos: terraform state mv (imperativo) o bloques moved (declarativo). Prefiero moved porque documenta el cambio en el historial de control de versiones:
moved {
  from = aws_instance.old_name
  to   = aws_instance.new_name
}
Más allá de renombrar, sustituye IDs hardcodeados por referencias a recursos. En lugar de vpc_id = "vpc-123456", usa vpc_id = aws_vpc.main.id. Así construyes grafos de dependencias que Terraform usa para ordenar correctamente las operaciones.
La última pieza de la gestión del estado es prevenir el drift futuro.
Tras importar, la política más importante es esta: todos los cambios pasan por Terraform, no por la consola del proveedor. Es la única forma de evitar el drift entre tu código y la realidad.
Sin embargo, algunos atributos cambian constantemente y no necesitas gestionarlos. Para ellos, usa el argumento de ciclo de vida ignore_changes:
lifecycle {
  ignore_changes = [tags["LastModified"]]
}
Por último, establece un estándar de "plan limpio" donde terraform plan solo muestre cambios intencionales. Haz planes con regularidad, incluso si no despliegas, para detectar drift pronto antes de que sea un problema mayor.
A pesar de una buena preparación, los imports pueden fallar. Diagnostiquemos y resolvamos los problemas más habituales.
Las discrepancias entre direcciones e IDs son las más frecuentes.
Estos son los errores más comunes y sus soluciones:
Causa: Entradas de estado duplicadas. El recurso ya está registrado con otro nombre
Solución: Ejecuta terraform state list para localizar duplicados y usa terraform state rm para eliminar la entrada antigua antes de reimportar
Una vez importes con éxito, vigila los planes que intenten reemplazar recursos.
Si terraform plan muestra "forces replacement" tras el import, identifica qué argumento provoca la recreación. Las causas comunes son argumentos inmutables como IDs de AMI de EC2 o zonas de disponibilidad. No se pueden cambiar tras la creación.
La solución es simple: alinea tu configuración con la realidad. Copia los valores reales desde la salida del plan a tu archivo de configuración.
Y una regla de oro: nunca confirmes ni apliques si se propone destruir recursos críticos. Es la señal de que algo va mal.
A veces el problema no está en tu configuración, sino en cómo están configurados los proveedores.
Los errores "Provider configuration depends on non-var" aparecen cuando tu bloque del proveedor utiliza valores calculados durante el import. Terraform necesita configuración estática del proveedor para localizar el recurso.
La solución temporal es hardcodear: sustituye ajustes dinámicos por valores literales, ejecuta el import y luego restaura la configuración dinámica. Alternativamente, usa variables de entorno para la autenticación del proveedor, que Terraform puede resolver durante el proceso.
Si el ID del recurso parece correcto pero el import falla, revisa la sección "Import" de la documentación del proveedor para el formato exacto del ID. Algunos recursos usan IDs compuestos con barras o dos puntos como separadores, y el formato debe ser exacto.
Has aprendido a poner tu infraestructura existente bajo gestión de Terraform con comandos CLI y bloques import. Antes de cada import, sigue esta lista de seguridad:
Sin embargo, el import no termina con terraform apply. El trabajo real empieza después: establecer políticas para prevenir el drift, refactorizar recursos importados para alinearlos con tus estándares y concienciar al equipo para gestionar la infraestructura exclusivamente a través de código. Este cambio cultural es tan importante como la implantación técnica.
Como siguiente paso, te recomiendo explorar la manipulación del estado de Terraform con terraform state mv y terraform state rm. Estos comandos complementan el import y te ayudan a reorganizar y refactorizar el estado a medida que tu infraestructura evoluciona.
También te recomiendo nuestra guía sobre usar Terraform con Docker y prepararte para tu próxima entrevista con nuestras principales preguntas de entrevista sobre Terraform.
Cursos de cloud
Curso
Curso
Curso
blog
Joleen Bothma
12 min
blog
Srujana Maddula
13 min
Tutorial
Tutorial
Tim Lu
15 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Zoumana Keita
8 min





