
Cursus
Cloud Computing begrijpen
2 uur
256.3K
Jouw team levert al jaren cloudresources op via consoleklikjes en shellscripts. Nu wil je Infrastructure as Code gaan gebruiken, maar alles vanaf nul opnieuw opbouwen voelt overweldigend. Ik heb in dezelfde situatie gezeten, en de importfunctionaliteit van Terraform is de oplossing voor deze uitdaging.
De risico's van "ClickOps" en handmatig infrastructuurbeheer stapelen zich in de loop der tijd op. Resources raken ongedocumenteerd, configuraties wijken af van standaarden en stamkennis vervangt degelijke documentatie. Wanneer teamleden vertrekken, verdwijnen hun infrastructuurbeslissingen met hen mee.
Daarom stappen organisaties over op Infrastructure as Code (IaC). In deze tutorial laat ik je zien hoe je bestaande infrastructuur in Terraform importeert.
We vergelijken het CLI-gebaseerde importcommando met declaratieve importblokken die zijn geïntroduceerd in Terraform 1.5, onderzoeken praktische workflows voor beide benaderingen en pakken veelvoorkomende valkuilen aan die van een simpele import een productie-incident kunnen maken. Aan het einde breng je met vertrouwen je bestaande infrastructuur onder codebeheer.
Als je nieuw bent met IaC en cloudproviders, overweeg dan een van onze cursussen, zoals AWS Concepts, Understanding Cloud Computing of Understanding Microsoft Azure.
Als je infrastructuur met Terraform vanaf het begin opzet, verloopt alles soepel. Je schrijft de configuratie, voert terraform plan uit, bekijkt de wijzigingen en past ze toe. Terraform volgt alles in het state-bestand en creëert zo een perfecte mapping tussen je code en je cloudresources.
Maar wat gebeurt er als resources al bestaan buiten de kennis van Terraform? Laten we beginnen met precies te begrijpen wat import doet en waarom het bestaat.
Terraform import koppelt bestaande infrastructuur in de echte wereld aan entries in het state-bestand van Terraform, zonder nieuwe resources te creëren. Zie het als adoptie: je vertelt Terraform om een resource te gaan beheren die al draait.
Dit lost het "shadow IT"-probleem op. Organisaties verzamelen infrastructuur op allerlei manieren: console-deployments tijdens storingen, testresources die permanent zijn geworden of legacy-systemen van vóór de invoering van IaC. Import verzoent deze realiteit met de principes van Infrastructure as Code.
Hier is het cruciale punt: import is primair een state-operatie. Het schrijft niet automatisch configuratiecode, tenzij je generatiefuncties in Terraform 1.5+ gebruikt. Jij bent verantwoordelijk om ervoor te zorgen dat je HCL-configuratie de geïmporteerde resource nauwkeurig weerspiegelt.
Nu we begrijpen wat import doet, bekijken we wanneer je het wel en niet moet gebruiken.
Ik raad import aan voor drie primaire scenario's:
Toch is import niet altijd de juiste keuze. Voor tijdelijke testresources of infrastructuur met slechte standaardisatie raad ik vaak aan om schoon te hercreëren.
Opnieuw beginnen stelt je in staat om huidige best practices toe te passen, juiste naamgevingsconventies door te voeren en securityconfiguraties toe te voegen die legacy-resources mogelijk missen. De initiële inspanning betaalt zich vaak terug in langdurig beter onderhoud.
Het is cruciaal om import te onderscheiden van Terraform data sources. Data sources laten je read-only informatie uit bestaande infrastructuur refereren zonder die te beheren. Je kunt bijvoorbeeld een data source gebruiken om een bestaande VPC van een ander team op te zoeken en vervolgens jouw resources daarin te plaatsen.
Import daarentegen brengt resources onder volledig Terraform-beheer, inclusief de mogelijkheid om ze te wijzigen of te vernietigen. Kies import wanneer je de volledige levenscyclus van een resource wilt beheren, niet alleen ernaar wilt verwijzen.
Voordat je begint met importeren, zijn er enkele fundamentele beperkingen die je moet begrijpen.
Elke geïmporteerde resource vereist een unieke, providerspecifieke identifier. Voor AWS kan dit i-0123456789abcdef0 zijn. Voor Azure is het een volledig resourcepad zoals /subscriptions/{id}/resourceGroups/{rg}/providers/{provider}/{resource}. Dit verkeerd doen is de belangrijkste oorzaak van importfouten.
Importbewerkingen wijzigen direct je state-bestand, dus back-ups zijn essentieel. Als je versiegestuurde backends zoals S3 gebruikt, controleer dan of versioning is ingeschakeld. Bij lokale state kopieer je handmatig naar terraform.tfstate.backup.
Na import krijg je te maken met "drift": de mismatch tussen de geïmporteerde state en de lokale configuratie. Je werkt je HCL-code iteratief bij totdat terraform plan nul openstaande wijzigingen laat zien.
Zorg ervoor dat je goed bent voorbereid voordat je iets importeert. Ik heb imports zien mislukken omdat teams voorbereidende stappen oversloegen.
Je eerste stap is controleren dat je Terraform-omgeving correct is geconfigureerd.
Begin met het verifiëren van je Terraform-installatie met terraform version. Als je toegang wilt tot declaratieve importblokken en automatische codegeneratie, zorg dan dat je Terraform 1.5 of later gebruikt. Deze functies vereenvoudigen het importproces voor complexe resources aanzienlijk.
Controleer vóór het importeren deze vereisten:
Providercredentials zijn actief: Controleer voor AWS dat AWS_ACCESS_KEY_ID en AWS_SECRET_ACCESS_KEY zijn ingesteld, of dat je AWS CLI-profiel is geconfigureerd. Test met aws sts get-caller-identity.
Juiste workspace geselecteerd: Voer terraform workspace show uit om te controleren dat je niet per ongeluk in de verkeerde omgeving importeert.
State-bestand is niet vergrendeld: Stem af met teamleden en controleer CI/CD-pijplijnen om te zorgen dat er geen gelijktijdige bewerkingen zijn.
Backend is bereikbaar: Controleer bij remote state de connectiviteit met S3, Azure Storage of Terraform Cloud.
Een vergrendeld state-bestand zorgt ervoor dat je import onmiddellijk faalt met een lock acquisition error, dus deze afstemming is cruciaal in teamomgevingen.
Met je omgeving gevalideerd is de volgende kritieke stap het vinden van de exacte identifier voor de resource die je wilt importeren.
Resource-ID's verschillen sterk per provider en resourcetype, waardoor deze stap lastiger is dan het lijkt. Hier zijn voorbeelden van veelgebruikte providers:
|
Provider |
Resourcetype |
ID-formaat |
Voorbeeld |
|
AWS |
EC2-instance |
Instance-ID |
|
|
AWS |
S3-bucket |
Bucketnaam |
|
|
AWS |
Security group |
Group-ID |
|
|
Azure |
Virtuele machine |
Volledig resourcepad |
|
|
GCP |
Compute-instance |
Project/zone/naam |
|
Voor AWS-resources kun je ID's rechtstreeks in de console vinden. Navigeer naar de service (EC2, S3, enz.), selecteer je resource en kopieer de identifier uit het detailvenster.
Voor Azure gebruik je de Azure CLI om het volledige resourcepad op te halen:
az resource show --name myresource --resource-group mygroupDe output bevat de volledige resource-ID die je nodig hebt voor import.
Hier is een veelvoorkomende valkuil waar ik ben ingetrapt: proberen een resource uit de verkeerde regio of subscription te importeren. Als je Terraform-providerconfiguratie naar us-east-1 wijst, maar je EC2-instance in us-west-2 draait, mislukt de import met "resource not found", ook al is je instance-ID correct.
Controleer altijd of de scope overeenkomt met je providerconfiguratie voordat je doorgaat. Zodra je de juiste ID hebt, moet je bepalen welke importmethode je gaat gebruiken.
Je hebt twee paden: het terraform import CLI-commando of import-blokken. Zo vergelijken ze:
|
Feature |
CLI-commando |
Importblokken (1.5+) |
|
Terraform-versie |
Alle versies |
1.5 of later |
|
Beste voor |
Snel, eenmalige imports |
Teamworkflows, bulkimports |
|
Versiebeheer |
Geen vastlegging in code |
Volledig gedocumenteerd in HCL |
|
Codegeneratie |
Niet beschikbaar |
Automatisch met |
|
Code review |
Moeilijk te reviewen |
Standaard PR-proces |
|
Reproduceerbaarheid |
Handmatig opnieuw uitvoeren |
Declaratief, herhaalbaar |
Ik raad importblokken aan voor teams die code reviews en reproduceerbare plannen nodig hebben, en de CLI voor snelle fixes op legacy-versies.
Waarom is dit belangrijk? Importblokken behandelen infrastructuuradoptie als code, wat betekent dat je imports onderdeel worden van je versiebeheerde workflow met dezelfde discipline als elke andere infrastructuurwijziging. Dit verkleint de kans op fouten en creëert een audittrail die essentieel is voor compliance en teamafstemming.
Importblokken integreren naadloos met je bestaande Git-workflow, zodat teamgenoten imports kunnen reviewen en goedkeuren zoals elke andere infrastructuurwijziging. De CLI is sneller voor individuele taken, maar laat geen audittrail achter en is niet eenvoudig te reproduceren tussen omgevingen.
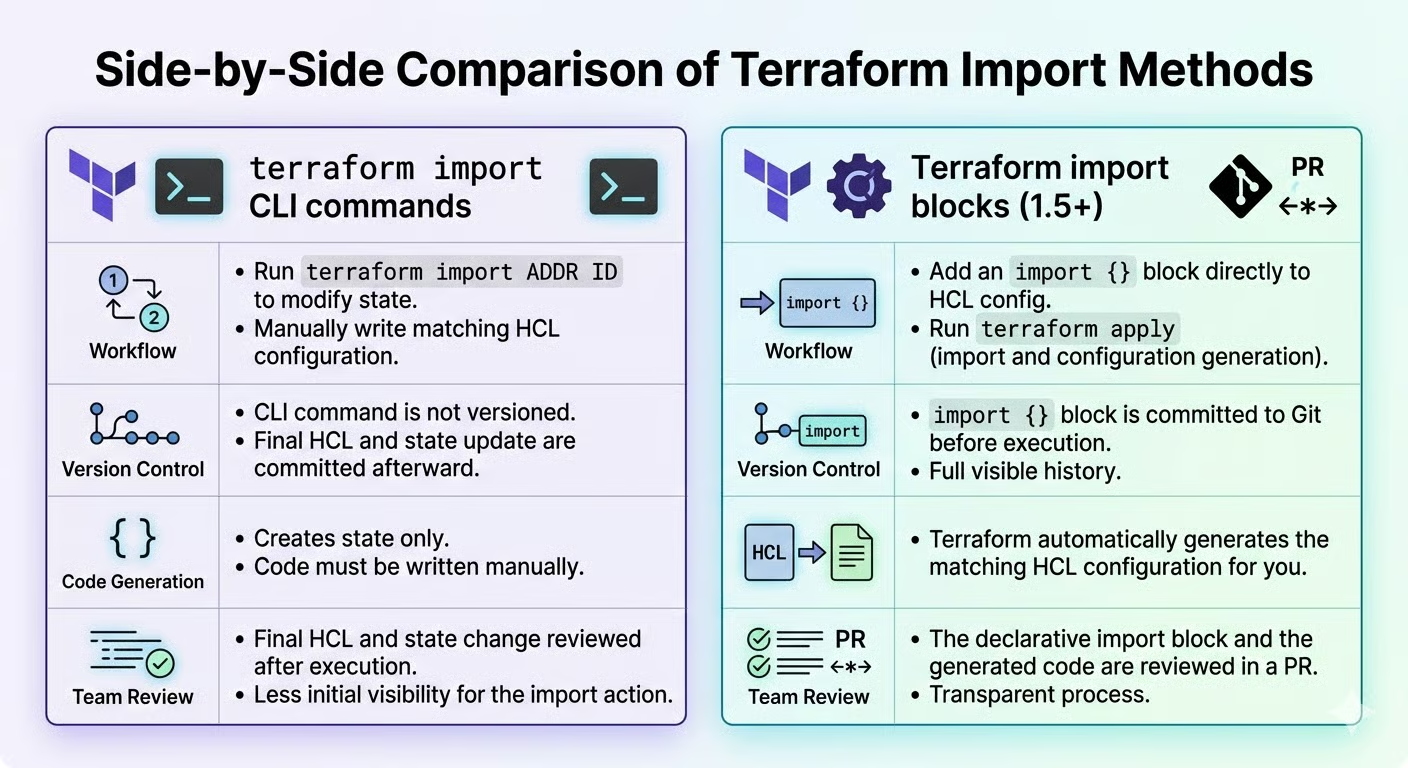
Met je strategie gekozen, duiken we in elke workflow, te beginnen met de traditionele CLI-aanpak.
Ik neem je mee door het traditionele, CLI-gebaseerde importproces. Hoewel declaratieve importblokken de voorkeur krijgen, blijft het begrijpen van de CLI-methode waardevol voor legacy Terraform-versies en snelle, eenmalige imports.
De eerste stap in de CLI-workflow is het opzetten van je configuratiebestand.
Voordat je terraform import uitvoert, moet je een resourceblok in je configuratie definiëren. Dit is een harde vereiste: Terraform moet weten waar de geïmporteerde state aan gekoppeld wordt. Het blok kan leeg of gedeeltelijk ingevuld zijn.
Hier is een voorbeeld voor het importeren van een AWS S3-bucket:
resource "aws_s3_bucket" "legacy_data" {
  # Configuration to be filled after import
}
Het resourcetype (aws_s3_bucket) moet exact overeenkomen met het type infrastructuur dat je importeert. De resourcenaam (legacy_data) moet je projectconventies volgen. Gebruik beschrijvende namen zoals production_data_bucket in plaats van generiek bucket1.
Met je resourceblok op zijn plek ben je klaar om het importcommando uit te voeren.
Voer terraform import <resource_address> <resource_id> uit. Voor onze S3-bucket:
terraform import aws_s3_bucket.legacy_data my-existing-bucket-nameTerraform haalt de huidige attributen van de bucket op via de provider-API en legt ze vast in de state. Je ziet:
aws_s3_bucket.legacy_data: Import complete!
Imported aws_s3_bucket
De state bevat nu de resource, maar je configuratie is nog leeg of onvolledig.
Hier begint het echte werk: je code in lijn brengen met de geïmporteerde state.
Voer terraform plan uit om verschillen tussen state en configuratie te zien. Je ziet berekende attributen (read-only waarden zoals tijdstempels) en expliciete configuratievereisten die je moet declareren.
Werk je configuratie stapsgewijs bij met waarden uit de planoutput. Als het plan voorstelt om de resource te "vervangen", stop dan. Dit duidt op mismatches bij onveranderlijke argumenten, zoals regio of availability zone. Pas je configuratie aan zodat die overeenkomt met de onveranderlijke attributen van de bestaande resource.
Laten we nu de moderne aanpak verkennen die is geïntroduceerd in Terraform 1.5. Importblokken maken van import een declaratieve configuratie die naast je infrastructuurcode leeft.
Het belangrijkste voordeel is reproduceerbaarheid en teamzichtbaarheid. Bij CLI-imports is er geen coderecord van wat is geïmporteerd. Met importblokken is elke import gedocumenteerd, versiebeheerd en te reviewen via pull requests.
We beginnen met het aanmaken van het importblok zelf.
Een importblok heeft twee onderdelen: to (doeladres) en id (resource-identifier):
import {
  to = aws_instance.web_server
  id = "i-0123456789abcdef0"
}
Dit geeft zichtbaarheid in versiebeheer. Teams kunnen importblokken in pull requests reviewen voordat ze worden uitgevoerd. Plaats importblokken in imports.tf voor eenvoudig opruimen na succesvolle imports.
Maar hier schitteren importblokken echt: Terraform kan automatisch de configuratiecode voor je genereren, waardoor het moeizame gokwerk van HCL vanaf nul schrijven verdwijnt.
Importblokken maken automatische codegeneratie mogelijk. Voer terraform plan -generate-config-out=generated.tf uit om de import te plannen en tegelijk volledige HCL-code weg te schrijven.
Het gegenereerde bestand bevat elk attribuut met zijn huidige waarden. Review het, verwijder overbodige defaults en merge betekenisvolle configuratie in je codebase. Dit voorkomt veelvoorkomende fouten: verkeerd benoemde attributen, verkeerde types en ontbrekende vereiste velden. Zeker voor complexe resources is dit waardevol.
Met je configuratie klaar is het tijd om de import uit te voeren.
Voer tot slot terraform apply uit om de import uit te voeren en de state in lijn te brengen met de configuratie. Terraform laat je precies zien wat er wordt geïmporteerd voordat er iets aan je state-bestand wordt gewijzigd.
Verwijder na een geslaagde toepassing de importblokken uit je configuratie. Ze hebben hun doel gediend en laten staan zou toekomstige runs verwarren. Voer ten slotte nog eens terraform plan uit om te verifiëren dat er nul openstaande wijzigingen zijn, zodat je bevestigt dat configuratie en state perfect zijn gesynchroniseerd.
De workflows die we tot nu toe hebben behandeld, werken perfect voor eenvoudige, op zichzelf staande resources. Maar productie-infrastructuur is zelden zo rechttoe rechtaan. Laten we de echte complexiteit aanpakken van modules, iteratie en afhankelijkheden.
Echte infrastructuur bestaat zelden uit simpele, losse resources. Door modules beheerde resources vereisen speciale adresseringssyntax; dat is onze eerste uitdaging.
Module-resources vereisen volledige padadressering: module.<module_name>.<resource_type>.<resource_name>, wat er zo uit kan zien:
terraform import module.network.aws_vpc.main vpc-0abcdef123456789Gebruik terraform state list na een normale apply om het juiste adres te vinden. Dit laat exact zien hoe Terraform naar moduleresources verwijst. Een verkeerd adres zorgt voor dubbele state-entries, die Terraform bij de volgende apply probeert aan te maken.
Bovendien moet je bij het importeren in module-instanties met count of for_each de instantie-identifier tussen quotes opnemen:
terraform import 'module.network[0].aws_vpc.main' vpc-0abcdef123456789Naast module-adressering leveren resources die de meta-argumenten count of for_each gebruiken hun eigen uitdagingen op.
Wanneer je Terraform-configuratie count gebruikt om meerdere instanties van een resource te maken, heb je arraysyntax nodig voor import. Als je configuratie er bijvoorbeeld zo uitziet:
resource "aws_instance" "server" {
  count         = 3
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Importeer je elke instantie afzonderlijk met de index:
terraform import 'aws_instance.server[0]' i-0123456789abcdef0
terraform import 'aws_instance.server[1]' i-1234567890abcdef1
terraform import 'aws_instance.server[2]' i-2345678901abcdef2
Resources die daarentegen for_each gebruiken, vereisen stringkeys in hun configuratie. Bekijk dit voorbeeld:
resource "aws_instance" "server" {
  for_each      = toset(["web", "api", "worker"])
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Hier importeer je met de sleutelnamen:
terraform import 'aws_instance.server["web"]' i-0123456789abcdef0
terraform import 'aws_instance.server["api"]' i-1234567890abcdef1
terraform import 'aws_instance.server["worker"]' i-2345678901abcdef2
Als je "index out of range"-fouten tegenkomt, betekent dit dat je count-waarde niet overeenkomt met het aantal resources dat je importeert. De oplossing is eenvoudig: stel de juiste count in of definieer passende for_each-keys in je configuratie voordat je de import uitvoert.
Verder moet je nadenken over hoe resources zich tot elkaar verhouden, zeker bij complexe architecturen.
Sommige cloudresources worden niet als één entiteit geïmporteerd, maar als meerdere Terraform-resources. Veelvoorkomende voorbeelden zijn:
Importeer in deze gevallen altijd eerst "ouder"-resources. Importeer bijvoorbeeld VPC's vóór subnets, IAM-rollen vóór policykoppelingen en security groups vóór individuele regels. Zo leg je de juiste afhankelijkheidsketen vast in je state-bestand.
Bekijk na de import je configuratie en declareer afhankelijkheden expliciet met depends_on waar de provider ze niet automatisch detecteert. Zo zorg je dat toekomstige apply-bewerkingen in de juiste volgorde worden uitgevoerd en voorkom je fouten zoals het proberen aan te maken van een subnet voordat de VPC bestaat.
Met je resources succesvol geïmporteerd en juist geconfigureerd, richt de volgende fase zich op langetermijnbeheer en organisatie.
Resources importeren is nog maar het begin. Langetermijnsucces vraagt om goed statebeheer en af en toe refactoring.
Security moet je eerste zorg zijn bij het importeren van productie-resources.
Dit verrast veel teams: het importeren van databases of encryptiesleutels haalt gevoelige waarden, zoals wachtwoorden, privésleutels en connection strings, als platte tekst in je state-bestand. Dit is een cruciale securityoverweging die je direct moet adresseren.
De oplossing is versleutelde remote backends gebruiken. Voor AWS betekent dit S3 met de optie encrypt = true en optioneel KMS-versleuteling ingeschakeld. Voor Azure gebruik je Azure Storage met encryptie-at-rest. Als je HCP Terraform / Terraform Cloud gebruikt, is state standaard versleuteld at rest en in transit, maar je wilt nog steeds de toegangscontroles verifiëren.
Neem na het importeren van productie-resources met gevoelige data bovendien twee extra stappen: verifieer dat toegangscontroles voor state-opslag correct zijn ingesteld en schakel auditlogging in om bij te houden wie wanneer toegang heeft tot de state. Deze maatregelen creëren een security-audittrail die van onschatbare waarde is voor compliance.
Naarmate je infrastructuur zich ontwikkelt, wil je geïmporteerde resources herorganiseren en hernoemen.
Je hebt twee opties om resources te hernoemen: terraform state mv (imperatief) of moved-blokken (declaratief). Ik geef de voorkeur aan moved-blokken omdat ze de wijziging documenteren in je versiegeschiedenis:
moved {
  from = aws_instance.old_name
  to   = aws_instance.new_name
}
Naast hernoemen vervang je ook hardgecodeerde ID's door resourcereferenties. Gebruik in plaats van vpc_id = "vpc-123456" vpc_id = aws_vpc.main.id. Deze aanpak bouwt correcte afhankelijkheidsgrafen op die Terraform gebruikt om de juiste volgorde van operaties te bepalen.
Het laatste onderdeel van statebeheer is toekomstige drift voorkomen.
Na import is dit de belangrijkste policy: alle wijzigingen verlopen via Terraform, niet via de cloudconsole. Dit is de enige manier om drift tussen je code en de werkelijkheid te voorkomen.
Sommige attributen veranderen echter constant maar hoef je niet te beheren. Gebruik hiervoor het ignore_changes-lifecycleargument:
lifecycle {
  ignore_changes = [tags["LastModified"]]
}
Stel tenslotte een "clean plan"-standaard in waarbij terraform plan alleen bedoelde wijzigingen laat zien. Maak er een gewoonte van om regelmatig plannen te draaien, ook als je niet uitrolt, zodat je drift vroegtijdig onderschept voordat het een groot probleem wordt.
Ondanks zorgvuldige voorbereiding kunnen importbewerkingen falen. Laten we de meest voorkomende issues diagnosticeren en oplossen.
Adres- en ID-mismatches zijn het vaakst.
Dit zijn de meest voorkomende importfouten en hun oplossingen:
Oorzaak: Dubbele state-entries. De resource wordt al gevolgd onder een andere naam
Fix: Voer terraform state list uit om dubbelen te vinden en gebruik vervolgens terraform state rm om de oude entry te verwijderen voordat je opnieuw importeert
Let na succesvolle import op plannen die resources willen vervangen.
Als terraform plan na import "forces replacement" laat zien, moet je identificeren welk argument de recreatie veroorzaakt. Veelvoorkomende oorzaken zijn onveranderlijke argumenten zoals EC2 AMI-ID's of availability zones. Deze kun je na creatie niet wijzigen.
De oplossing is eenvoudig: breng je configuratie in lijn met de werkelijkheid. Kopieer de werkelijke waarden uit de planoutput naar je configuratiebestand.
En hier is een cruciale veiligheidsregel: bevestig of pas nooit toe als het voorstelt om kritieke resources te vernietigen. Dat is het waarschuwingssignaal dat er iets mis is.
Soms ligt het probleem niet bij je configuratie, maar bij hoe je providers zijn geconfigureerd.
"Provider configuration depends on non-var"-fouten treden op wanneer je providerblokken berekende waarden gebruiken tijdens import. Terraform heeft statische providerconfig nodig om de resource voor import te lokaliseren.
De workaround is tijdelijk hardcoden: vervang dynamische providersettings door letterlijke waarden, voer de import uit en herstel daarna je dynamische configuratie. Alternatief kun je omgevingsvariabelen gebruiken voor providerauthenticatie, die Terraform tijdens de import kan resolven.
Als je resource-ID correct lijkt maar de import nog steeds faalt, bekijk dan in de providerdocumentatie de sectie "Import" voor exacte vereisten aan het ID-formaat. Sommige resources gebruiken samengestelde ID's met slashes of dubbele punten als scheidingsteken; het formaat exact goed krijgen is essentieel.
Je hebt geleerd om bestaande infrastructuur onder Terraform-beheer te brengen met zowel CLI-commando's als importblokken. Volg vóór elke import deze veiligheidschecklist:
Import eindigt echter niet bij terraform apply. Het echte werk begint na de import: beleid opstellen om drift te voorkomen, geïmporteerde resources refactoren zodat ze aansluiten op je standaarden en je team opleiden om infrastructuur uitsluitend via code te beheren. Deze cultuurverandering is net zo belangrijk als de technische implementatie.
Als volgende stap raad ik aan om Terraform-statebewerking te verkennen met terraform state mv en terraform state rm. Deze commando's vullen import aan door je te helpen je state-bestand te reorganiseren en te refactoren naarmate je infrastructuur zich ontwikkelt.
Bekijk ook onze gids over Terraform gebruiken met Docker, en bereid je voor op je volgende sollicitatiegesprek met onze topvragen over Terraform-interviews.
Cloudcursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

