
Kurs
Cloud Computing verstehen
2 Std.
253.8K
Dein Team stellt seit Jahren Cloud-Ressourcen per Konsolen-Klicks und Shell-Skripten bereit. Jetzt wollt ihr auf Infrastructure as Code umsteigen, aber alles von Grund auf neu aufzusetzen wirkt überwältigend. Ich war in genau dieser Situation – und die Import-Funktion von Terraform ist die Lösung für diese Herausforderung.
Die Risiken von „ClickOps“ und manueller Infrastrukturbewirtschaftung summieren sich über die Zeit. Ressourcen sind nicht dokumentiert, Konfigurationen weichen von Standards ab, und Stammeswissen ersetzt saubere Doku. Wenn Teammitglieder gehen, verschwinden ihre Infrastrukturentscheidungen mit ihnen.
Darum setzen Organisationen auf Infrastructure as Code (IaC). In diesem Tutorial zeige ich dir, wie du bestehende Infrastruktur in Terraform importierst.
Wir vergleichen den CLI-basierten Import-Befehl mit den deklarativen Import-Blöcken aus Terraform 1.5, schauen uns praxistaugliche Workflows für beide Ansätze an und gehen typische Stolperfallen an, die aus einem simplen Import einen Produktionsvorfall machen können. Am Ende bringst du deine bestehende Infrastruktur souverän unter Code-Verwaltung.
Wenn du neu bei IaC und Cloud-Anbietern bist, empfehle ich dir Kurse wie AWS Concepts, Understanding Cloud Computing oder Understanding Microsoft Azure.
Wenn du Infrastruktur mit Terraform von Anfang an aufbaust, läuft alles rund: Du schreibst die Konfiguration, führst terraform plan aus, prüfst die Änderungen und wendest sie an. Terraform verfolgt alles in seiner State-Datei und bildet so eine perfekte Zuordnung zwischen deinem Code und deinen Cloud-Ressourcen.
Aber was passiert, wenn Ressourcen bereits existieren und Terraform nichts von ihnen weiß? Lass uns damit starten, genau zu verstehen, was Import macht und warum es diese Funktion gibt.
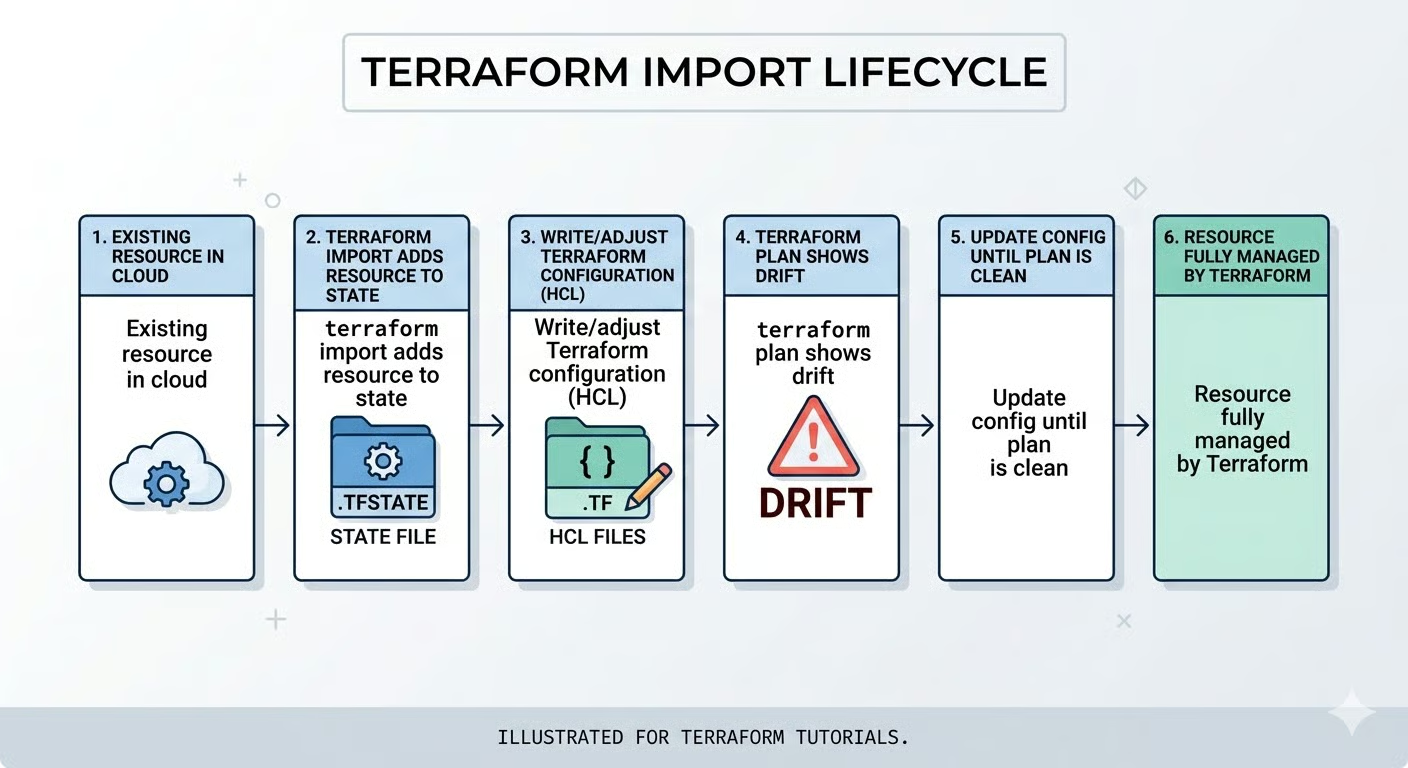
Terraform Import ordnet bestehende Infrastruktur-Einheiten Einträgen in der Terraform-State-Datei zu, ohne neue Ressourcen zu erstellen. Denk an Adoption: Du sagst Terraform, dass es eine bereits laufende Ressource künftig managen soll.
Damit löst du das „Shadow-IT“-Problem. Organisationen sammeln Infrastruktur auf vielen Wegen an: Bereitstellungen über die Konsole während Störungen, Testressourcen, die dauerhaft wurden, oder Altsysteme von vor der IaC-Einführung. Import bringt diese Realität mit den Prinzipien von Infrastructure as Code in Einklang.
Wichtig ist: Import ist primär ein State-Vorgang. Er schreibt nicht automatisch Konfigurationscode, außer du nutzt die Generierungsfunktionen in Terraform 1.5+. Du bist dafür verantwortlich, dass deine HCL-Konfiguration die importierte Ressource korrekt abbildet.
Jetzt, da wir wissen, was Import leistet, schauen wir, wann du ihn einsetzen solltest – und wann nicht.
Ich empfehle Import vor allem in drei Szenarien:
Import ist jedoch nicht immer die beste Wahl. Für temporäre Testressourcen oder wenig standardisierte Infrastruktur empfehle ich oft eine saubere Neuerstellung.
Ein Neustart erlaubt dir, aktuelle Best Practices umzusetzen, saubere Namenskonventionen einzuführen und Sicherheitskonfigurationen zu ergänzen, die Legacy-Ressourcen oft fehlen. Der Mehraufwand am Anfang zahlt sich durch bessere Wartbarkeit aus.
Wichtig ist die Abgrenzung zu Terraform-Datenquellen. Datenquellen erlauben es, schreibgeschützte Informationen aus bestehender Infrastruktur zu referenzieren, ohne sie zu managen. Du kannst z. B. ein bestehendes, von einem anderen Team erstelltes VPC nachschlagen und deine Ressourcen darin bereitstellen.
Import hingegen stellt Ressourcen vollständig unter Terraform-Verwaltung – inklusive Änderungs- und Löschrechten. Wähle Import, wenn du den kompletten Lebenszyklus einer Ressource verwalten willst, nicht nur Referenzen brauchst.
Bevor du importierst, solltest du ein paar grundlegende Einschränkungen verstehen.
Jede importierte Ressource braucht eine eindeutige, providerspezifische Kennung. Für AWS kann das i-0123456789abcdef0 sein. Für Azure ist es ein vollständiger Ressourcenpfad wie /subscriptions/{id}/resourceGroups/{rg}/providers/{provider}/{resource}. Falsche IDs sind der häufigste Grund für Importfehler.
Import-Operationen ändern direkt deine State-Datei – Backups sind also Pflicht. Wenn du versionierte Backends wie S3 nutzt, prüfe, ob Versionierung aktiv ist. Bei lokalem State kopiere manuell nach terraform.tfstate.backup.
Nach dem Import triffst du auf „Drift“: eine Abweichung zwischen importiertem State und lokaler Konfiguration. Du passt deine HCL-Konfiguration iterativ an, bis terraform plan keine offenen Änderungen mehr zeigt.
Bevor du irgendetwas importierst, sorge für die richtigen Rahmenbedingungen. Ich habe fehlgeschlagene Importe gesehen, weil Teams die Vorbereitungsschritte übersprungen haben.
Der erste Schritt ist, deine Terraform-Umgebung korrekt zu konfigurieren.
Überprüfe zunächst deine Terraform-Installation mit terraform version. Wenn du deklarative Import-Blöcke und automatische Codegenerierung nutzen willst, stelle sicher, dass du Terraform 1.5 oder neuer einsetzt. Diese Funktionen vereinfachen den Import komplexer Ressourcen enorm.
Vor dem Import prüfe diese Voraussetzungen:
Provider-Zugänge sind aktiv: Für AWS prüfe, ob AWS_ACCESS_KEY_ID und AWS_SECRET_ACCESS_KEY gesetzt sind oder dein AWS-CLI-Profil konfiguriert ist. Teste mit aws sts get-caller-identity.
Richtiges Workspace gewählt: Mit terraform workspace show sicherstellen, dass du nicht versehentlich in die falsche Umgebung importierst.
State-Datei ist nicht gesperrt: Mit Teammitgliedern und CI/CD-Pipelines abstimmen, damit keine gleichzeitigen Operationen laufen.
Backend erreichbar: Bei Remote-State die Konnektivität zu S3, Azure Storage oder Terraform Cloud prüfen.
Eine gesperrte State-Datei führt sofort zu einem Fehler bei der Sperrübernahme. Diese Abstimmung ist in Team-Setups entscheidend.
Nach der Umweltprüfung folgt der nächste kritische Schritt: die exakte Kennung der zu importierenden Ressource zu finden.
Ressourcen-IDs unterscheiden sich stark je nach Provider und Ressourcentyp – dieser Schritt ist trickreicher als gedacht. Hier ein paar Beispiele gängiger Provider:
|
Provider |
Ressourcentyp |
ID-Format |
Beispiel |
|
AWS |
EC2-Instance |
Instance ID |
|
|
AWS |
S3-Bucket |
Bucket-Name |
|
|
AWS |
Security Group |
Group ID |
|
|
Azure |
Virtuelle Maschine |
Voller Ressourcenpfad |
|
|
GCP |
Compute Instance |
Project/zone/name |
|
Für AWS-Ressourcen findest du IDs direkt in der Konsole. Navigiere zum Dienst (EC2, S3 etc.), wähle deine Ressource und kopiere die Kennung aus dem Detailbereich.
Für Azure nutzt du die Azure CLI, um den vollständigen Ressourcenpfad abzurufen:
az resource show --name myresource --resource-group mygroupDie Ausgabe enthält die komplette Ressourcen-ID, die du für den Import brauchst.
Eine häufige Falle, in die ich selbst getappt bin: der Versuch, eine Ressource aus der falschen Region oder Subscription zu importieren. Wenn deine Terraform-Provider-Konfiguration auf us-east-1 zeigt, deine EC2-Instance aber in us-west-2 liegt, schlägt der Import mit „resource not found“ fehl – selbst wenn die Instance-ID stimmt.
Prüfe immer, dass der Scope zu deiner Provider-Konfiguration passt, bevor du fortfährst. Sobald du die korrekte ID hast, musst du die Import-Methode wählen.
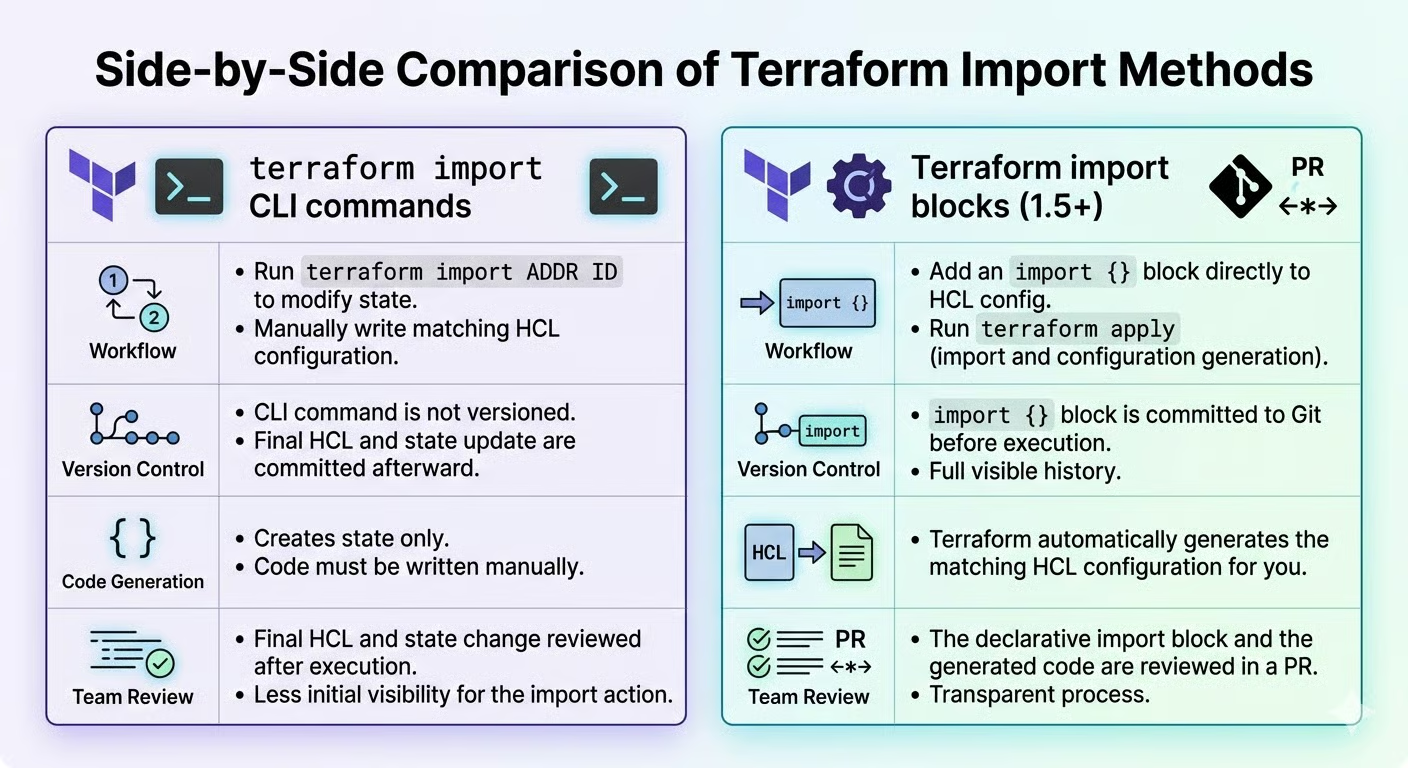
Du hast zwei Wege: den terraform import-CLI-Befehl oder import-Blöcke. So schneiden sie ab:
|
Feature |
CLI-Befehl |
Import-Blöcke (1.5+) |
|
Terraform-Version |
Alle Versionen |
1.5 oder neuer |
|
Am besten geeignet für |
Schnelle Einzel-Imports |
Team-Workflows, Bulk-Imports |
|
Versionierung |
Kein Code-Nachweis |
Vollständig in HCL dokumentiert |
|
Codegenerierung |
Nicht verfügbar |
Automatisch mit |
|
Code-Review |
Schwer prüfbar |
Standard-PR-Prozess |
|
Reproduzierbarkeit |
Manuelle Wiederholung |
Deklarativ, wiederholbar |
Ich empfehle Import-Blöcke für Teams mit Code-Reviews und reproduzierbaren Plänen und die CLI für schnelle Fixes auf Legacy-Versionen.
Warum ist das wichtig? Import-Blöcke behandeln die Übernahme von Infrastruktur als Code. Deine Imports werden Teil des versionierten Workflows und erhalten die gleiche Sorgfalt wie jede andere Infrastrukturänderung. Das senkt Fehlerrisiken und schafft eine Audit-Historie – essenziell für Compliance und Teamabstimmung.
Import-Blöcke integrieren sich nahtlos in deinen Git-Workflow. Teammitglieder können Imports per Pull Request prüfen und freigeben – wie jede andere Änderung. Die CLI ist zwar schneller für Einzelschritte, hinterlässt aber keine Spur im Code und lässt sich schwer über Umgebungen hinweg reproduzieren.
Mit der gewählten Strategie tauchen wir nun in die jeweiligen Workflows ein – beginnend mit dem klassischen CLI-Ansatz.
Ich führe dich durch den traditionellen, CLI-basierten Import-Prozess. Auch wenn deklarative Import-Blöcke bevorzugt werden, bleibt die CLI-Methode wertvoll für ältere Terraform-Versionen und schnelle Einzel-Imports.
Der erste Schritt im CLI-Workflow ist das Anlegen deines Konfigurationsblocks.
Bevor du terraform import ausführst, musst du einen Resource-Block in deiner Konfiguration definieren. Das ist zwingend: Terraform muss wissen, wohin der importierte State gemappt wird. Der Block kann leer oder teilweise gefüllt sein.
Beispiel für den Import eines AWS S3-Buckets:
resource "aws_s3_bucket" "legacy_data" {
  # Konfiguration wird nach dem Import ergänzt
}
Der Ressourcentyp (aws_s3_bucket) muss exakt zum Ziel passen. Der Ressourcenname (legacy_data) sollte deinen Namenskonventionen folgen. Nutze aussagekräftige Namen wie production_data_bucket statt generischem bucket1.
Mit dem Resource-Block an Ort und Stelle kannst du den Import-Befehl ausführen.
Führe terraform import <resource_address> <resource_id> aus. Für unseren S3-Bucket:
terraform import aws_s3_bucket.legacy_data my-existing-bucket-nameTerraform ruft die aktuellen Attribute des Buckets über die Provider-API ab und schreibt sie in den State. Du siehst etwa:
aws_s3_bucket.legacy_data: Import complete!
Imported aws_s3_bucket
Der State enthält nun die Ressource, aber deine Konfiguration ist noch leer oder unvollständig.
Jetzt beginnt die eigentliche Arbeit: Code und importierten State in Einklang bringen.
Führe terraform plan aus, um Unterschiede zwischen State und Konfiguration zu sehen. Du wirst berechnete Attribute (schreibgeschützte Werte wie Zeitstempel) und explizite Konfigurationsanforderungen sehen, die du deklarieren musst.
Aktualisiere deine Konfiguration schrittweise anhand der Plan-Ausgabe. Wenn der Plan vorschlägt, die Ressource zu „ersetzen“, halte an. Das weist auf Unstimmigkeiten bei unveränderlichen Argumenten hin, z. B. Region oder Availability Zone. Passe deine Konfiguration an die unveränderlichen Attribute der existierenden Ressource an.
Jetzt schauen wir uns den modernen Ansatz aus Terraform 1.5 an. Import-Blöcke machen aus einem imperativen Befehl eine deklarative Konfiguration, die neben deinem Infrastrukturcode lebt.
Der Hauptvorteil ist Reproduzierbarkeit und Team-Transparenz. Bei CLI-Imports gibt es keinen Code-Nachweis. Mit Import-Blöcken ist jeder Import dokumentiert, versioniert und per Pull Request überprüfbar.
Beginnen wir mit dem Anlegen des Import-Blocks.
Ein Import-Block hat zwei Bestandteile: to (Zieladresse) und id (Ressourcenkennung):
import {
  to = aws_instance.web_server
  id = "i-0123456789abcdef0"
}
So wird der Import in der Versionskontrolle sichtbar. Teams können Import-Blöcke vor der Ausführung per Pull Request prüfen. Lege Import-Blöcke in imports.tf ab – so lassen sie sich nach erfolgreichem Import leicht entfernen.
Hier glänzen Import-Blöcke besonders: Terraform kann die Konfiguration automatisch generieren – das lästige, fehleranfällige HCL-Schreiben entfällt.
Import-Blöcke ermöglichen automatische Codegenerierung. Führe terraform plan -generate-config-out=generated.tf aus, um den Import zu planen und gleichzeitig vollständige HCL zu schreiben.
Die generierte Datei enthält alle Attribute mit aktuellen Werten. Prüfe sie, entferne überflüssige Defaults und übernimm die sinnvollen Teile in deinen Code. So vermeidest du typische Fehler: falsch benannte Attribute, inkorrekte Typen oder fehlende Pflichtfelder. Gerade bei komplexen Ressourcen ist das Gold wert.
Mit der fertigen Konfiguration kannst du den Import ausführen.
Führe terraform apply aus, um den Import durchzuführen und State und Konfiguration abzugleichen. Terraform zeigt dir genau, was importiert wird, bevor der State verändert wird.
Nach erfolgreicher Ausführung entferne die Import-Blöcke. Sie haben ihren Zweck erfüllt, und ein Verbleib würde zukünftige Runs verwirren. Führe zum Abschluss noch einmal terraform plan aus, um sicherzustellen, dass keine Änderungen offen sind – Konfiguration und State sind dann perfekt synchron.
Die bisherigen Workflows funktionieren hervorragend für einfache, isolierte Ressourcen. Produktivumgebungen sind jedoch selten so simpel. Gehen wir die reale Komplexität mit Modulen, Iteration und Abhängigkeiten an.
Reale Infrastrukturen bestehen selten aus einfachen Einzelressourcen. Von Modulen verwaltete Ressourcen benötigen eine spezielle Adressierung – das ist unsere erste Herausforderung.
Modulressourcen erfordern vollständige Pfad-Adressen: module.<module_name>.<resource_type>.<resource_name>, z. B. so:
terraform import module.network.aws_vpc.main vpc-0abcdef123456789Finde die korrekte Adresse mit terraform state list nach einem normalen Apply. So siehst du genau, wie Terraform Modulressourcen referenziert. Eine falsche Adresse erzeugt doppelte State-Einträge, die Terraform beim nächsten Apply zu erstellen versucht.
Beim Import in Modulinstanzen mit count oder for_each musst du zusätzlich die Instanzkennung in Anführungszeichen angeben:
terraform import 'module.network[0].aws_vpc.main' vpc-0abcdef123456789Neben der Moduladressierung bringen Ressourcen mit den Meta-Argumenten count oder for_each eigene Herausforderungen mit.
Wenn deine Terraform-Konfiguration per count mehrere Instanzen einer Ressource erstellt, brauchst du für den Import Array-Syntax. Sieht deine Konfiguration z. B. so aus:
resource "aws_instance" "server" {
  count         = 3
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Importierst du jede Instanz einzeln über ihren Index:
terraform import 'aws_instance.server[0]' i-0123456789abcdef0
terraform import 'aws_instance.server[1]' i-1234567890abcdef1
terraform import 'aws_instance.server[2]' i-2345678901abcdef2
Ressourcen, die for_each nutzen, erfordern String-Keys. Beispiel:
resource "aws_instance" "server" {
  for_each      = toset(["web", "api", "worker"])
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
Hier importierst du anhand der Keys:
terraform import 'aws_instance.server["web"]' i-0123456789abcdef0
terraform import 'aws_instance.server["api"]' i-1234567890abcdef1
terraform import 'aws_instance.server["worker"]' i-2345678901abcdef2
Wenn „index out of range“-Fehler auftreten, stimmt dein count-Wert nicht mit der Zahl zu importierender Ressourcen überein. Die Lösung: den korrekten Count setzen oder passende for_each-Keys definieren, bevor du importierst.
Außerdem musst du das Zusammenspiel der Ressourcen berücksichtigen – insbesondere bei komplexen Architekturen.
Einige Cloud-Ressourcen werden nicht als einzelne Entität importiert, sondern als mehrere Terraform-Ressourcen. Häufige Beispiele:
Importiere in solchen Fällen immer zuerst „Eltern“-Ressourcen. Also VPCs vor Subnetzen, IAM-Rollen vor Policy-Attachments und Security Groups vor einzelnen Regeln. So legst du die korrekte Abhängigkeitskette im State an.
Prüfe nach dem Import deine Konfiguration und deklariere Abhängigkeiten explizit mit depends_on, wo der Provider sie nicht automatisch erkennt. So stellt apply zukünftig die richtige Reihenfolge sicher und verhindert Fehler, etwa wenn Terraform versucht, ein Subnetz vor seiner VPC zu erstellen.
Sind die Ressourcen importiert und korrekt konfiguriert, geht es um langfristige Pflege und Struktur.
Der Import ist nur der Anfang. Langfristiger Erfolg verlangt sauberes State-Management und gelegentliches Refactoring.
Sicherheit steht an erster Stelle, wenn du produktive Ressourcen importierst.
Ein häufiger Stolperstein: Beim Import von Datenbanken oder Schlüsseln landen sensible Werte wie Passwörter, Private Keys und Connection Strings im Klartext in der State-Datei. Das ist ein kritischer Sicherheitsaspekt, den du sofort adressieren musst.
Die Lösung sind verschlüsselte Remote-Backends. Für AWS bedeutet das S3 mit encrypt = true und optional KMS-Verschlüsselung. Für Azure nutzt du Azure Storage mit Verschlüsselung im Ruhezustand. In HCP Terraform / Terraform Cloud ist der State standardmäßig verschlüsselt (at rest und in transit) – prüfe dennoch die Zugriffssteuerungen.
Zusätzlich solltest du nach dem Import produktiver Ressourcen zwei Dinge tun: Zugriffsrechte auf den State-Speicher verifizieren und Audit-Logging aktivieren, um nachzuvollziehen, wer wann auf den State zugreift. Das schafft eine Audit-Spur, die für Compliance Gold wert ist.
Wenn sich deine Infrastruktur weiterentwickelt, willst du importierte Ressourcen umorganisieren und umbenennen.
Für Umbenennungen gibt es zwei Wege: terraform state mv (imperativ) oder moved-Blöcke (deklarativ). Ich bevorzuge moved-Blöcke, weil sie die Änderung in der Versionshistorie dokumentieren:
moved {
  from = aws_instance.old_name
  to   = aws_instance.new_name
}
Ersetze darüber hinaus hart codierte IDs durch Ressourcenreferenzen. Statt vpc_id = "vpc-123456" nutze vpc_id = aws_vpc.main.id. So entsteht ein sauberer Abhängigkeitsgraph, den Terraform für die korrekte Ausführungsreihenfolge nutzt.
Der letzte Baustein im State-Management ist das Absichern gegen Drift.
Nach dem Import gilt die wichtigste Regel: Alle Änderungen laufen über Terraform, nicht über die Cloud-Konsole. Nur so vermeidest du Drift zwischen Code und Realität.
Einige Attribute driften ständig, müssen aber nicht gemanagt werden. Für diese nutzt du ignore_changes im Lifecycle:
lifecycle {
  ignore_changes = [tags["LastModified"]]
}
Etabliere außerdem den Standard eines „sauberen Plans“, bei dem terraform plan nur beabsichtigte Änderungen zeigt. Gewöhne dir an, Pläne regelmäßig laufen zu lassen – auch ohne Deployment –, um Drift früh zu erkennen.
Trotz sorgfältiger Vorbereitung können Importe scheitern. Lass uns die häufigsten Probleme diagnostizieren und lösen.
Adress- und ID-Fehler sind die häufigsten Ursachen.
Das sind die gängigsten Importfehler und ihre Lösungen:
Ursache: Doppelte State-Einträge. Die Ressource wird bereits unter einem anderen Namen verfolgt
Fix: terraform state list ausführen, Duplikate finden und mit terraform state rm den alten Eintrag entfernen, dann erneut importieren
Nach einem erfolgreichen Import solltest du auf Pläne achten, die Ressourcen ersetzen wollen.
Wenn terraform plan „forces replacement“ zeigt, identifiziere das auslösende Argument. Häufig sind es unveränderliche Parameter wie EC2-AMI-IDs oder Availability Zones. Diese lassen sich nach Erstellung nicht ändern.
Die Lösung ist simpel: Konfiguration der Realität anpassen. Übernimm die tatsächlichen Werte aus der Plan-Ausgabe in deine Konfiguration.
Und eine wichtige Sicherheitsregel: Bestätige oder wende nie an, wenn kritische Ressourcen zerstört werden sollen. Das ist dein Warnsignal, dass etwas nicht stimmt.
Manchmal liegt das Problem nicht an deiner Konfiguration, sondern an der Provider-Konfiguration.
„Provider configuration depends on non-var“-Fehler treten auf, wenn dein Provider-Block berechnete Werte während des Imports nutzt. Terraform benötigt statische Provider-Konfiguration, um die Ressource zu finden.
Der Workaround ist temporäres Hardcoding: Ersetze dynamische Provider-Einstellungen durch feste Werte, führe den Import durch und stelle anschließend die dynamische Konfiguration wieder her. Alternativ kannst du Umgebungsvariablen für die Provider-Authentifizierung nutzen, die Terraform während des Imports auflöst.
Wenn die Ressourcen-ID korrekt wirkt und der Import dennoch fehlschlägt, prüfe im „Import“-Abschnitt der Provider-Doku die exakten ID-Format-Anforderungen. Einige Ressourcen nutzen zusammengesetzte IDs mit Schrägstrichen oder Doppelpunkten – das exakte Format ist entscheidend.
Du hast gelernt, bestehende Infrastruktur mit Terraform zu verwalten – per CLI-Befehlen und Import-Blöcken. Befolge vor jedem Import diese Sicherheits-Checkliste:
Aber der Import endet nicht bei terraform apply. Die eigentliche Arbeit beginnt danach: Richtlinien gegen Drift etablieren, importierte Ressourcen im Sinne deiner Standards refaktorisieren und dein Team darauf einschwören, Infrastruktur ausschließlich über Code zu managen. Dieser kulturelle Wandel ist genauso wichtig wie die technische Umsetzung.
Als nächsten Schritt empfehle ich dir, Terraform-State-Manipulation mit terraform state mv und terraform state rm zu erkunden. Diese Befehle ergänzen den Import und helfen dir, deinen State beim weiteren Ausbau der Infrastruktur umzustrukturieren.
Schau dir außerdem unseren Leitfaden zum Einsatz von Terraform mit Docker an und bereite dich mit unseren Top-Fragen für Terraform-Interviews auf dein nächstes Vorstellungsgespräch vor.
Cloud-Kurse
Kurs
Kurs
Kurs
Blog
Zoumana Keita
15 Min.
Blog
Blog
Nisha Arya Ahmed
15 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Mark Pedigo
10 Min.


