Curso
Introducción al Deep Learning en Python
4 h
264.6K
Nota: este tutorial se centra principalmente en la implementación práctica de la clasificación usando una red neuronal convolucional y un autoencoder convolucional. Si aún no estás familiarizado con las CNN y los autoencoders, quizá te interese consultar los tutoriales de CNN y Autoencoder.
En concreto, hoy verás estos temas:
Antes de cargar y procesar el conjunto de datos, conviene entender brevemente de qué tipo de datos se trata, cuáles son sus dimensiones y cuántas clases incluye.
El conjunto de datos Fashion-MNIST contiene 70.000 imágenes en escala de grises de 28x28 píxeles de productos de moda de 10 categorías, con 7.000 imágenes por categoría. El conjunto de entrenamiento tiene 60.000 imágenes y el de prueba 10.000. Fashion-MNIST sustituye al MNIST original para obtener resultados más sólidos; las dimensiones de imagen y las particiones de entrenamiento y prueba son similares a las de MNIST. Está disponible libremente en esta URL y puede cargarse con tensorflow o keras sin necesidad de descargarlo localmente.
Al igual que MNIST, Fashion-MNIST también consta de 10 clases, pero en lugar de dígitos escritos a mano, tenemos 10 tipos de artículos de moda como sandalias, camisas, pantalones, etc.
La tarea consiste en entrenar un autoencoder convolucional y usar la parte de encoder del autoencoder combinada con capas totalmente conectadas para reconocer correctamente nuevas muestras del conjunto de prueba.
Consejo: si quieres aprender a implementar un perceptrón multicapa (MLP) para tareas de clasificación con el conjunto MNIST, echa un vistazo a este tutorial.
En el siguiente código defines variables de entorno en el notebook usando os.environ. Es buena práctica hacerlo antes de inicializar Keras para limitar que el backend TensorFlow use la primera GPU. Si la máquina en la que entrenas tiene la GPU en 0, asegúrate de usar 0 en lugar de 1. Puedes comprobarlo ejecutando en la terminal, por ejemplo, nvidia-smi.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
A continuación importa todos los módulos necesarios como numpy, matplotlib y, sobre todo, Keras, ya que en este tutorial usarás Keras como framework.
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Aquí defines una función que abre el archivo gzip y lo lee con bytestream.read(). Le pasas la dimensión de la imagen y el número total de imágenes. Después, con np.frombuffer(), conviertes la cadena almacenada en la variable buf en un array de NumPy de tipo float32.
Una vez convertido en array de NumPy, lo reestructuras en un array tridimensional o tensor donde la primera dimensión es el número de imágenes y la segunda y tercera son las dimensiones de la imagen. Por último, devuelves el array data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Ahora llamarás a la función extract_data() pasando los archivos de entrenamiento y prueba junto con su número correspondiente de imágenes.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
De forma similar, defines una función para extraer etiquetas que abre el archivo gzip y lo lee con bytestream.read(), al que le pasas la dimensión de la etiqueta (1) y el número total de imágenes. Luego, con np.frombuffer(), conviertes la cadena almacenada en buf en un array de NumPy de tipo int64.
En este caso no necesitas reestructurar el array, ya que labels devolverá un vector columna de dimensión 60.000 x 1. Por último, devuelves el array labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Ahora llamarás a la función de extracción de etiquetas pasando los archivos de etiquetas de entrenamiento y prueba junto con su número correspondiente de imágenes.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Una vez cargados los datos de entrenamiento y prueba, ya puedes analizarlos para hacerte una idea del conjunto con el que trabajarás en este tutorial.
Analicemos cómo son las imágenes del conjunto y veamos sus dimensiones con el atributo .shape de NumPy:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Como ves, los datos de entrenamiento tienen forma 60000 x 28 x 28 porque hay 60.000 muestras de entrenamiento, cada una con una matriz de 28 x 28. Del mismo modo, los datos de prueba tienen forma 10000 x 28 x 28 porque hay 10.000 muestras.
Nota: en la tarea de reconstrucción con un autoencoder convolucional no necesitarás etiquetas de entrenamiento ni de prueba. Tus imágenes de entrenamiento actuarán tanto como entrada como verdad de terreno, igual que las etiquetas en una tarea de clasificación.
Pero para la clasificación sí necesitarás las etiquetas además de las imágenes, cosa que harás más adelante en el tutorial. Aunque la tarea inmediata solo use imágenes de entrenamiento y prueba, para explorar y entender mejor los datos también usaremos las etiquetas.
Creemos un diccionario con los nombres de clase y sus etiquetas categóricas correspondientes:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Ahora, veamos un par de imágenes del conjunto:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
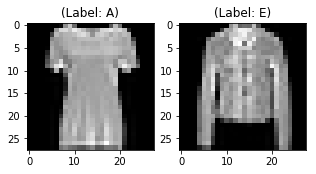
El resultado de las dos gráficas anteriores son muestras de entrenamiento y prueba, con etiquetas de clase 0 o A por un lado y 4 o E por otro. Las demás letras tendrán etiquetas diferentes, pero las mismas letras comparten etiqueta. Es decir, las 6.000 imágenes de la clase E tendrán la etiqueta 4.
Las imágenes son en escala de grises con valores de píxel entre 0 y 255 y tamaño 28 x 28, así que antes de alimentar el modelo es importante preprocesarlas. Primero convertirás cada imagen 28 x 28 de entrenamiento y prueba en una matriz de 28 x 28 x 1 para poder pasarla a la red:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Comprueba también el tipo de datos de los arrays de NumPy de entrenamiento y prueba: debería ser float32. Si no lo fuera, conviértelo; como ya lo hiciste al leer los datos, no hace falta repetirlo. Además, hay que reescalar los valores de píxel al rango 0–1. ¡Vamos a ello!
No olvides verificar los tipos de datos de entrenamiento y prueba:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Ahora reescala los datos de entrenamiento y prueba usando el valor máximo de píxel:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Verifiquemos que el valor máximo queda en 1.0 tras el reescalado:
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Después de esto, toca particionar los datos. Para que el modelo generalice bien, divide el conjunto de entrenamiento en dos partes: entrenamiento y validación. Entrenarás con el 80% y validarás con el 20% restante.
Esto también ayuda a reducir el sobreajuste, ya que validarás con datos que el modelo no ve durante el entrenamiento.
Puedes usar train_test_split de scikit-learn para dividirlos correctamente:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Nota: usarás esta división dos veces: una para la reconstrucción con el autoencoder convolucional, para lo que no necesitas etiquetas (por eso pasas dos veces las imágenes de entrenamiento, como entrada y como verdad de terreno), y otra para la clasificación, donde sí pasarás imágenes y etiquetas.
Ya puedes definir la red y alimentar los datos. ¡Vamos al siguiente paso!
Las imágenes son de tamaño 28 x 28 x 1. Conviertes la matriz de imagen en array, la reescalas entre 0 y 1, le das forma 28 x 28 x 1 y la usas como entrada de la red.
Usarás un batch size de 128 (o 256/512 si tu sistema lo permite). Este hiperparámetro influye en el aprendizaje y en la precisión de las predicciones.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Como sabrás, un autoencoder se divide en dos partes: encoder y decoder.
Encoder: 4 bloques convolucionales; cada bloque tiene una capa de convolución seguida de batch normalization. Se aplica max pooling tras el primer y segundo bloque.
Decoder: 3 bloques convolucionales; cada bloque tiene una capa de convolución seguida de batch normalization. Se aplica upsampling tras el segundo y tercer bloque.
El max pooling reduce a la mitad las dimensiones cada vez que se aplica; el upsampling las duplica.
Nota: el número y tamaño de filtros, número de capas, epochs, etc., son hiperparámetros que debes ajustar según tu criterio. Prueba distintas configuraciones y mide el rendimiento: así aprenderás el arte del deep learning.
Creemos funciones separadas de encoder y decoder, ya que luego reutilizarás los pesos del encoder para clasificar.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Una vez creado el modelo, compílalo usando el optimizador RMSProp.
También debes especificar el tipo de pérdida mediante el argumento loss. En este caso es el error cuadrático medio, ya que tras cada batch se calcula la pérdida entre la salida predicha y la verdad de terreno píxel a píxel:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualicemos las capas que acabas de crear con la función summary. Verás el número de parámetros (pesos y sesgos) por capa y el total del modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
¡Es hora de entrenar el modelo con fit() de Keras! El modelo entrena durante 200 epochs. fit() devuelve un objeto history; al guardarlo en autoencoder_train podrás usarlo para trazar las curvas de pérdida de entrenamiento y validación y analizar visualmente el rendimiento.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
¡Listo! Has entrenado el modelo con Fashion-MNIST durante 100 epochs. Ahora, tracemos la curva de pérdida de entrenamiento y validación para visualizar el rendimiento.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
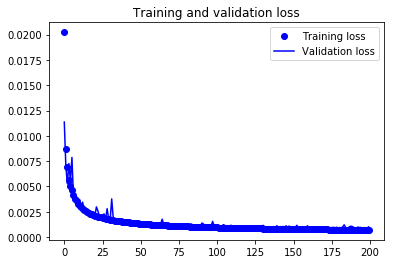
Como puedes ver, la pérdida de validación y la de entrenamiento van en sintonía. El modelo no está sobreajustando: la pérdida de validación disminuye y apenas hay separación entre ambas curvas durante el entrenamiento.
Podemos decir que la capacidad de generalización del modelo es buena.
Pero recuerda que la tarea es usar el encoder del modelo entrenado para clasificar imágenes de Fashion-MNIST. ¡Pasemos a ello!
Como necesitarás los pesos del encoder para la clasificación, primero guarda los pesos completos del autoencoder. Verás enseguida cómo extraer los del encoder.
autoencoder.save_weights('autoencoder.h5')
Ahora usarás la cabeza del autoencoder entrenado, es decir, el encoder, y cargarás en él los pesos del autoencoder que acabas de entrenar.
Añadirás unas capas densas o totalmente conectadas al encoder para clasificar las imágenes de Fashion-MNIST.
En el one-hot encoding conviertes datos categóricos en un vector numérico. Los algoritmos de machine learning no trabajan directamente con categorías, por eso generas una columna booleana por categoría o clase. Para cada muestra, solo una de esas columnas toma el valor 1. De ahí el nombre one-hot.
En nuestro caso, el one-hot será un vector fila de dimensión 1 x 10 por imagen. Importa notar que el vector tiene todo ceros salvo un 1 en la posición de su clase.
Convirtamos las etiquetas:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Claro, ¿verdad?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Una última comprobación de las formas de los conjuntos de entrenamiento y validación.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Definamos ahora el modelo de clasificación. Recuerda que reutilizarás exactamente la parte de encoder del autoencoder.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Definamos las capas totalmente conectadas que apilarás sobre el encoder.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Nota: el siguiente paso es importante. Para asegurarte de que los pesos del encoder del autoencoder coinciden con los que has cargado en el encoder del modelo de clasificación, imprime los pesos de una misma capa en ambos modelos. Si no son iguales, no tiene sentido usar esta estrategia.
Imprimamos los pesos de la primera capa en ambos modelos.
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
¡Voilà! Ambos arrays son idénticos. Sin más, compilemos el modelo y empecemos a entrenar.
Ahora vas a congelar la parte del encoder, es decir, las primeras diecinueve capas del modelo. Como ya está entrenada, no necesitas volver a entrenarla. Solo entrenarás la parte totalmente conectada.
for layer in full_model.layers[0:19]:
    layer.trainable = False
¡Compilemos el modelo!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Imprimamos también el summary. Deberías ver parámetros no entrenables al haber congelado las primeras capas.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
De nuevo entrenaremos el modelo con fit() de Keras. Esta vez durante 10 epochs. Guardando el resultado en fashion_train podrás trazar después las curvas de accuracy y pérdida de entrenamiento y validación para analizar el rendimiento visualmente.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
¡Listo! Has entrenado el modelo en Fashion-MNIST durante solo 10 epochs y, viendo la accuracy y la pérdida de entrenamiento, el rendimiento es excelente: tras 10 epochs la accuracy de entrenamiento es del 99% y la de validación del 98%.
Guardemos el modelo de clasificación.
full_model.save_weights('autoencoder_classification.h5')
A continuación reentrenarás el modelo haciendo entrenables las primeras diecinueve capas (True) en lugar de mantenerlas congeladas. Hagámoslo.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Ahora entrenemos el modelo completo por última vez.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Guardemos el modelo por última vez.
full_model.save_weights('classification_complete.h5')
Pongamos en contexto la evaluación del modelo y tracemos las curvas de accuracy y pérdida de entrenamiento y validación:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
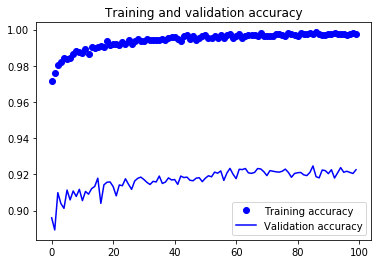
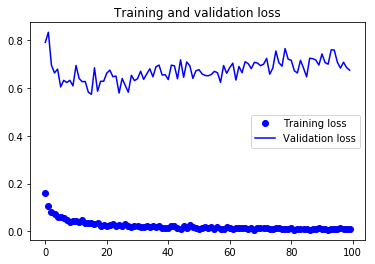
En las dos gráficas se aprecia sobreajuste: hay una brecha notable entre la pérdida de entrenamiento y la de validación. Para mitigarlo, quizá debas aplicar técnicas de regularización como Dropout. Puedes seguir este tutorial de CNN en Python con Keras.
Evaluemos también el modelo con los datos de prueba para ver cómo se comporta.
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Como las predicciones son valores en coma flotante, no es práctico compararlas tal cual con las etiquetas reales. Redondearemos la salida para convertir los floats en enteros y luego usaremos np.argmax() para seleccionar el índice con el valor más alto de cada fila.
Por ejemplo, si para una imagen la predicción es [0 1 0 0 0 0 0 0 0 0], la salida será la clase 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
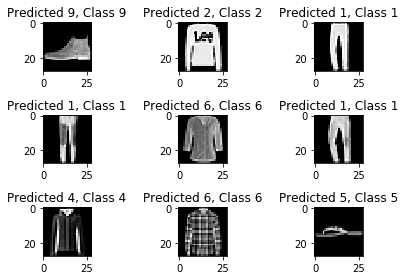
Found 9204 correct labels
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
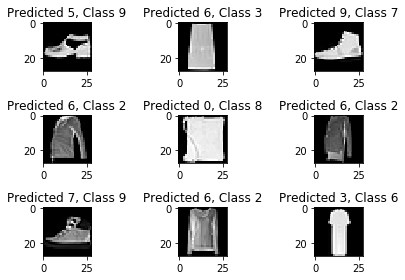
El informe de clasificación te ayudará a identificar con más detalle las clases mal clasificadas. Podrás ver en qué clases el modelo rinde peor de entre las diez disponibles.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Este tutorial es un buen inicio para usar tanto autoencoders como redes neuronales convolucionales totalmente conectadas con Python y Keras. Si has podido seguirlo sin problemas (o con un poco de esfuerzo), ¡enhorabuena! Prueba a hacer experimentos con la misma arquitectura pero usando otros conjuntos de datos públicos.
Aún queda mucho por explorar, así que ¿por qué no hacer el curso Deep Learning in Python de DataCamp? Mientras tanto, asegúrate de revisar la documentación de Keras, si no lo has hecho ya. Encontrarás más ejemplos e información sobre funciones, argumentos, más capas, etc. ¡Te será un recurso imprescindible cuando aprendas a trabajar con redes neuronales en Python!
Si prefieres leer un libro que explique los fundamentos del deep learning (con Keras) y su aplicación práctica, te recomendamos el libro de François Chollet Deep Learning in Python.
Cursos de Python
Curso
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
Avinash Navlani
12 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Aditya Sharma
15 min