Curso
Introducción al Deep Learning con Keras
4 h
46.3K
Usarás el conjunto de datos de MRI cerebral 3T para entrenar tu red. Para comprobar la eficacia del modelo, lo probarás con:
Este tutorial no entra en las particularidades del diagnóstico por imagen, sino que se centra en la parte de deep learning. Nota: el objetivo principal es la implementación práctica de autoencoders convolucionales. Si aún no conoces las redes neuronales convolucionales (CNN) ni los autoencoders, quizá te interese revisar los tutoriales de CNN y Autoencoder. La mejor parte es que cargarás volúmenes 3D como imágenes 2D para alimentarlas al modelo. En resumen, hoy verás:
En imagen médica se emplean distintos sistemas: desde equipos de RM abiertos con intensidades de campo magnético de 0,3 teslas (T), a sistemas para extremidades de hasta 1,0 T y escáneres de cuerpo completo de hasta 3,0 T (en uso clínico). El tesla es la unidad que mide la intensidad del campo magnético en RM. Los escáneres de RM de alto campo (7T, 11,5T) ofrecen mayor SNR (relación señal‑ruido) incluso con vóxeles más pequeños (parches o rejillas tridimensionales) y, por tanto, se prefieren para diagnósticos más precisos.
Un vóxel más pequeño implica mejor resolución, lo que puede ayudar al diagnóstico clínico. Sin embargo, la intensidad del campo magnético del escáner impone un límite inferior al tamaño del vóxel para mantener una buena SNR y preservar los detalles de la imagen.
Pese a la superior calidad de imagen de 7T y 11,5T, rara vez se usan en producción por su coste.
Según trabajos recientes, hay ~20.000 escáneres de 3T frente a solo ~40 de 7T.
El dataset de MRI cerebral está formado por volúmenes 3D; cada volumen contiene 207 cortes/imágenes de MRI obtenidas a diferentes alturas del cerebro. Cada corte tiene dimensiones 173 × 173. Las imágenes son en escala de grises de un solo canal. Hay 30 sujetos en total, cada uno con la RM de un paciente. El formato de imagen no es jpeg, png, etc., sino NIfTI. Más adelante verás cómo leer imágenes en formato NIfTI.
El conjunto contiene imágenes de RM en modalidad T1, tradicionalmente adecuadas para evaluar estructuras anatómicas. El dataset con el que trabajarás hoy es de MRI cerebral 3T.
El dataset es público y puedes descargarlo desde esta fuente.
Truco: si quieres aprender a implementar un perceptrón multicapa (MLP) para tareas de clasificación con el dataset MNIST, echa un vistazo a este tutorial.
Nota : antes de empezar, ten en cuenta que el modelo se entrenará en un sistema con GPU Nvidia 1080 Ti, procesador Xeon e5 GeForce y 32 GB de RAM. Si usas Jupyter Notebook, tendrás que añadir tres líneas de código para especificar el orden del dispositivo CUDA y los dispositivos visibles de CUDA con el módulo os.
En el siguiente código defines variables de entorno en el notebook con os.environ. Es recomendable hacerlo antes de inicializar Keras para limitar el backend TensorFlow a la primera GPU. Si el equipo con el que entrenas tiene la GPU en 0, usa 0 en lugar de 1. Puedes comprobarlo con un comando en tu terminal, por ejemplo: nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Primero, importa todos los módulos necesarios: cv2, numpy, matplotlib y, sobre todo, Keras, ya que será el framework que usarás hoy.
Para leer imágenes en formato NIfTI, también necesitas el módulo nibabel.
import os
import cv2
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
Using TensorFlow backend.
import numpy as np
import scipy.misc
import numpy.random as rng
from PIL import Image, ImageDraw, ImageFont
from sklearn.utils import shuffle
import nibabel as nib #reading MR images
from sklearn.cross_validation import train_test_split
import math
import glob
from matplotlib import pyplot as plt
%matplotlib inline
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:44: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also note that the interface of the new CV iterators are different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Usarás el módulo glob, que devolverá una lista con todos los volúmenes de la carpeta que indiques.
ff = glob.glob('ground3T/*')
Imprimamos el primer elemento de la lista y comprobemos su longitud: en nuestro caso debería ser 30.
ff[0]
'ground3T/181232.nii.gz'
len(ff)
30
Ya puedes cargar los volúmenes 3D con nibabel. Ten en cuenta que al cargar un volumen NIfTI, Nibabel no obtiene inmediatamente el array de imagen: espera a que se lo pidas con el método get_data().
Como te interesan los cortes 2D en lugar del 3D completo, inicializarás una lista en la que, cada vez que leas un volumen, iterarás por los 207 cortes del volumen 3D y añadirás cada corte a la lista.
images = []
Imprimamos también la forma de uno de los volúmenes 3D: debería ser 173 × 207 × 173 (coordenadas x, y, z).
Nota: usarás solo los 51 cortes centrales del cerebro, no los 207. Veamos cómo seleccionar y cargar esos cortes centrales.
for f in range(len(ff)):
    a = nib.load(ff[f])
    a = a.get_data()
    a = a[:,78:129,:]
    for i in range(a.shape[1]):
        images.append((a[:,i,:]))
print (a.shape)
(173, 51, 173)
Analicemos la forma de un corte de esos 207.
a[:,0,:].shape
(173, 173)
Dado que images es una lista, usarás NumPy para convertirla en un array.
images = np.asarray(images)
Comprueba la forma del array: la primera dimensión debería ser 207 × 30 = 6210 y las otras dos, 173 × 173.
images.shape
(1530, 173, 173)
Las imágenes son en escala de grises de 173 × 173, así que antes de alimentar los datos al modelo conviene preprocesarlos. Primero, convierte cada imagen 173 × 173 en una matriz de 173 × 173 × 1 para poder pasarla a la red:
images = images.reshape(-1, 173,173,1)
images.shape
(1530, 173, 173, 1)
A continuación, reescala los datos con normalización máx‑mín:
m = np.max(images)
mi = np.min(images)
m, mi
(3599.0959, -341.83853)
images = (images - mi) / (m - mi)
Verifica que el mínimo y el máximo tras el reescalado sean 0,0 y 1,0:
np.min(images), np.max(images)
(0.0, 1.0)
Paso importante: rellenar con ceros los bordes para tener dimensiones pares y poder reducir a la mitad al pasar por el modelo. Añadamos tres filas y tres columnas de ceros para obtener 176 × 176.
temp = np.zeros([1530,176,176,1])
temp[:,3:,3:,:] = images
images = temp
Después, es clave particionar los datos. Para que el modelo generalice bien, divide en entrenamiento y validación. Entrenarás con el 80% y validarás con el 20% restante.
Esto reduce el riesgo de sobreajuste, ya que validarás con datos no vistos durante el entrenamiento.
Puedes usar train_test_split de scikit‑learn para hacerlo correctamente:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images,
                                                             images,
                                                             test_size=0.2,
                                                             random_state=13)
Nota: para esta tarea no necesitas etiquetas de entrenamiento ni prueba. Por eso pasas las imágenes de entrenamiento dos veces: actúan como entrada y como ground truth, igual que las etiquetas en clasificación.
Veamos cómo son las imágenes del dataset y confirmemos sus dimensiones tras añadir las tres filas y columnas extra usando el atributo .shape de NumPy:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images.shape))
Dataset (images) shape: (1530, 176, 176, 1)
Como ves, los datos tienen forma 6210 × 176 × 176, pues hay 6210 muestras de matrices 176 × 176 × 1.
Ahora, veamos un par de imágenes de entrenamiento y validación:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(valid_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7ff67d5d59b0>
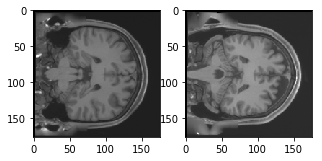
Las dos salidas corresponden a entrenamiento y validación. Verás que son diferentes; será interesante comprobar si el autoencoder convolucional aprende las características y reconstruye correctamente.
Ya puedes definir la red y alimentar los datos. ¡Vamos al lío!
Las imágenes son de 176 × 176 × 1 (un vector de 30.976 dimensiones). Convertirás la matriz en array, la reescalarás entre 0 y 1, la reformatearás a 176 × 176 × 1 y la pasarás como entrada a la red.
Usarás un tamaño de lote de 128; también podrías usar 256 o 512 según tu máquina, lo que influye en el aprendizaje y la precisión. Entrenarás 50 épocas.
batch_size = 128
epochs = 300
inChannel = 1
x, y = 176, 176
input_img = Input(shape = (x, y, inChannel))
Como sabrás, un autoencoder tiene dos partes: encoder y decoder.
Encoder: 3 bloques convolucionales; cada bloque tiene una capa de convolución seguida de batch normalization. Tras el primer y segundo bloque, hay max‑pooling.
Decoder: 2 bloques convolucionales; cada uno con convolución y batch normalization. Tras el primero y el segundo, hay upsampling.
Max‑pooling reduce a la mitad cada vez que lo aplicas; upsampling duplica cada vez que se aplica.
Nota: número y tamaño de filtros, capas, épocas de entrenamiento… son hiperparámetros. Ajústalos, prueba variaciones y mide el rendimiento: así desarrollarás tu intuición en deep learning.
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)


    #decoder
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Tras crear el modelo, compílalo con el optimizador RMSProp.
También debes especificar la función de pérdida mediante el argumento loss. Aquí será el error cuadrático medio, calculado píxel a píxel entre la predicción del lote y el ground truth:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualicemos las capas con summary: verás el número de parámetros (pesos y sesgos) por capa y el total del modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 176, 176, 1)       0
_________________________________________________________________
conv2d_18 (Conv2D)           (None, 176, 176, 32)      320
_________________________________________________________________
batch_normalization_11 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
conv2d_19 (Conv2D)           (None, 176, 176, 32)      9248
_________________________________________________________________
batch_normalization_12 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
max_pooling2d_5 (MaxPooling2 (None, 88, 88, 32)        0
_________________________________________________________________
conv2d_20 (Conv2D)           (None, 88, 88, 64)        18496
_________________________________________________________________
batch_normalization_13 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
conv2d_21 (Conv2D)           (None, 88, 88, 64)        36928
_________________________________________________________________
batch_normalization_14 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
max_pooling2d_6 (MaxPooling2 (None, 44, 44, 64)        0
_________________________________________________________________
conv2d_22 (Conv2D)           (None, 44, 44, 128)       73856
_________________________________________________________________
batch_normalization_15 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_23 (Conv2D)           (None, 44, 44, 128)       147584
_________________________________________________________________
batch_normalization_16 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_24 (Conv2D)           (None, 44, 44, 64)        73792
_________________________________________________________________
batch_normalization_17 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 44, 44, 64)        36928
_________________________________________________________________
batch_normalization_18 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
up_sampling2d_5 (UpSampling2 (None, 88, 88, 64)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 88, 88, 32)        18464
_________________________________________________________________
batch_normalization_19 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 88, 88, 32)        9248
_________________________________________________________________
batch_normalization_20 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
up_sampling2d_6 (UpSampling2 (None, 176, 176, 32)      0
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 176, 176, 1)       289
=================================================================
Total params: 427,713
Trainable params: 426,433
Non-trainable params: 1,280
_________________________________________________________________
¡Hora de entrenar el modelo con fit() de Keras! Entrenaremos 50 épocas. fit() devuelve un history; si lo guardas, podrás trazar después la pérdida de entrenamiento y validación para analizar el rendimiento visualmente.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 1224 samples, validate on 306 samples
Epoch 1/300
1224/1224 [==============================] - 7s - loss: 0.1201 - val_loss: 0.0838
Epoch 2/300
1224/1224 [==============================] - 7s - loss: 0.0492 - val_loss: 0.0534
...
Epoch 299/300
1224/1224 [==============================] - 7s - loss: 1.3101e-04 - val_loss: 6.1086e-04
Epoch 300/300
1224/1224 [==============================] - 7s - loss: 1.0711e-04 - val_loss: 3.9641e-04
¡Listo! Has entrenado el modelo con este dataset durante 200 épocas. Ahora, representemos la pérdida de entrenamiento y validación para visualizar el rendimiento.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(300)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
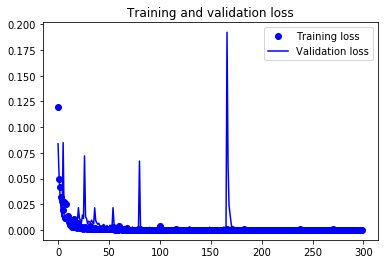
La pérdida de validación y de entrenamiento se mantienen alineadas. No hay sobreajuste: la pérdida de validación disminuye y apenas hay brecha entre ambas durante el entrenamiento.
Por tanto, la capacidad de generalización del modelo es buena.
Ahora, vamos a reconstruir las imágenes de test con predict() de Keras y ver qué tal rinde el modelo.
Guardemos el modelo entrenado. Es un paso importante en deep learning: ¡los pesos son el corazón de tu solución!
Podrás cargar los pesos guardados en el mismo modelo y continuar el entrenamiento donde lo dejaste. Por ejemplo, si vuelves a entrenar, parámetros como pesos, sesgos y la pérdida no empezarán de cero.
Con una sola línea puedes guardar y cargar los pesos.
autoencoder = autoencoder.save_weights('autoencoder_mri.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder_mri.h5')
Como no tienes un conjunto de test separado, usaremos la validación para predecir con el modelo recién entrenado.
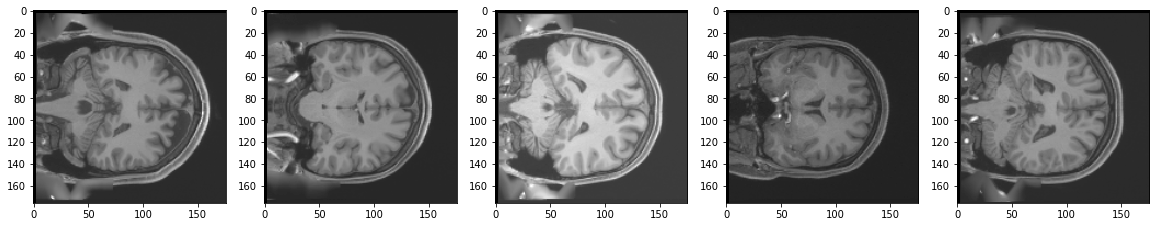
Vas a predecir sobre las 306 imágenes de validación y a trazar algunas reconstrucciones para ver la calidad de los resultados.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
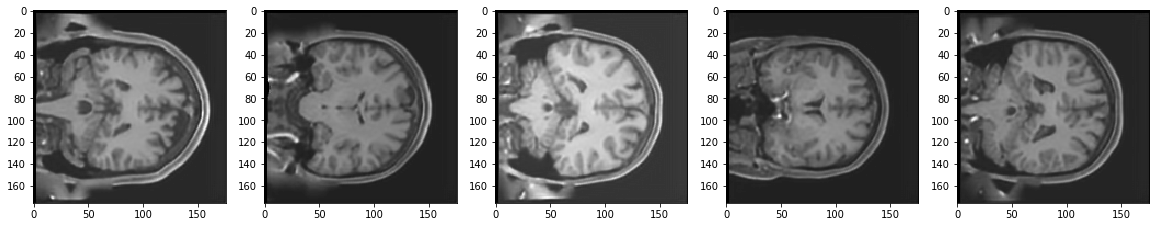
Como puedes observar, el modelo hace un gran trabajo reconstruyendo las imágenes de test. Al menos cualitativamente, las originales y las reconstruidas son casi idénticas.
Quizá podría mejorar un poco en algunos detalles locales de las imágenes 3T originales.
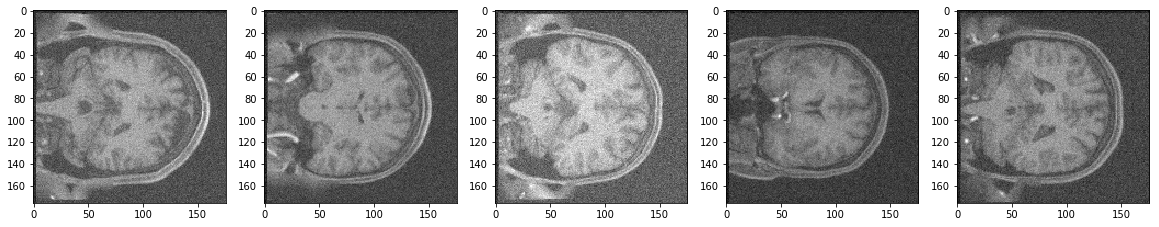
Primero añadiremos ruido a las imágenes de validación con media cero y desviación estándar 0,03.
[a,b,c,d]= np.shape(valid_X)
mean = 0
sigma = 0.03
gauss = np.random.normal(mean,sigma,(a,b,c,d))
noisy_images = valid_X + gauss
Es momento de predecir sobre las imágenes ruidosas. Veamos qué tal rinde el modelo pese a no haber visto ruido durante el entrenamiento.
pred_noisy = autoencoder.predict(noisy_images)
plt.figure(figsize=(20, 4))
print("Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(noisy_images[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred_noisy[i, ..., 0], cmap='gray')
plt.show()
Noisy Test Images
Reconstruction of Noisy Test Images
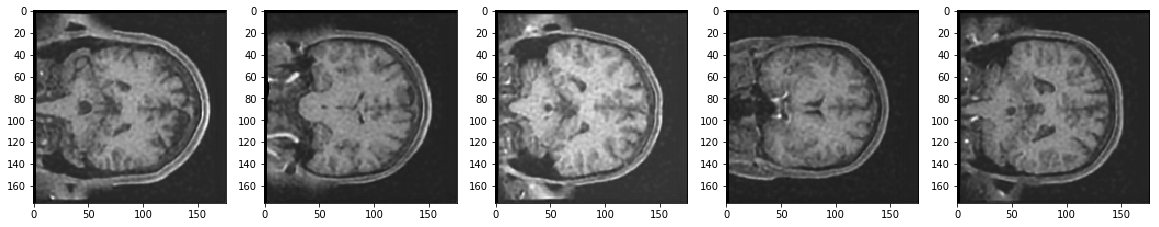
Parece que el modelo se comporta bastante bien, ¿verdad? Las reconstrucciones se ven mejor que las imágenes con ruido, y eso sin haber sido entrenado para manejarlo.
El bloque PSNR calcula la relación señal‑ruido de pico, en decibelios (dB), entre dos imágenes. Es una medida habitual de la calidad entre la original y la reconstruida. Cuanto mayor sea el PSNR, mejor calidad tendrá la reconstrucción.
Primero, calculemos el rendimiento entre las imágenes de validación y sus reconstrucciones.
valid_pred = autoencoder.predict(valid_X)
mse =  np.mean((valid_X - valid_pred) ** 2)
psnr = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr,2)))
PSNR of reconstructed validation images: 34.02dB
Ahora, calculemos el PSNR entre las originales de validación y las imágenes predichas a partir de las ruidosas.
noisy_pred = autoencoder.predict(noisy_images)
mse =  np.mean((valid_X - noisy_pred) ** 2)
psnr_noisy = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr_noisy,2)))
PSNR of reconstructed validation images: 32.48dB
Cuantitativamente, la diferencia es de apenas 1,54 dB entre reconstrucciones sin ruido y con ruido. Y ni siquiera entrenaste el modelo para gestionar ruido. ¿No es sorprendente?
Este tutorial es un buen punto de partida para aprender a leer imágenes MRI en formato NIfTI, analizarlas, preprocesarlas y alimentarlas a un modelo usando un dataset cerebral 3T. Te mostró una aplicación práctica y potente de los autoencoders. Si has podido seguirlo, aunque sea con algo de esfuerzo, ¡enhorabuena!
Puedes experimentar con la arquitectura y tratar de mejorar las predicciones, tanto cuantitativa como cualitativamente. ¿Quizá añadiendo capas? ¿O entrenando más tiempo? Prueba combinaciones y comprueba si ayudan.
Aún queda mucho por explorar, así que ¿por qué no haces el curso de DataCamp Deep Learning in Python si aún no lo has hecho? Empezarás por lo básico y avanzarás hasta dominar el área: será un recurso imprescindible para aprender a trabajar con redes convolucionales en Python, detección de caras, objetos, etc.
Cursos de deep learning
Curso
Curso
Curso
Tutorial
Zoumana Keita
14 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Bharath K
13 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Moez Ali
14 min
Tutorial
Natassha Selvaraj
8 min