Cours
Introduction au Deep Learning en Python
4 h
264.6K
Remarque : ce tutoriel se concentre principalement sur la mise en pratique de la classification avec un réseau de neurones convolutifs et un autoencoder convolutif. Si vous ne maîtrisez pas encore les réseaux de neurones convolutifs (CNN) et les autoencoders, nous vous conseillons de consulter d’abord les tutoriels CNN et Autoencoder.
Plus précisément, voici ce que vous verrez aujourd’hui :
Avant de charger et de traiter le jeu de données, il est utile de comprendre rapidement de quel type de données il s’agit, leurs dimensions et le nombre de classes disponibles.
Le jeu de données Fashion‑MNIST contient 70 000 images en niveaux de gris de 28x28 représentant des articles de mode répartis en 10 catégories, avec 7 000 images par catégorie. L’ensemble d’entraînement comporte 60 000 images et l’ensemble de test 10 000. Fashion‑MNIST remplace le jeu MNIST d’origine pour obtenir des résultats plus représentatifs ; les dimensions d’image et la répartition entraînement/test sont similaires à MNIST. Le jeu est librement disponible à cette adresse et peut être chargé directement via tensorflow ou keras sans téléchargement préalable.
Comme MNIST, Fashion‑MNIST comporte 10 classes, mais au lieu de chiffres manuscrits, on y trouve des accessoires et vêtements (sandales, chemises, pantalons, etc.).
Votre objectif est d’entraîner un autoencoder convolutif, puis d’utiliser la partie encodeur combinée à des couches fully‑connected pour reconnaître correctement de nouveaux échantillons du jeu de test.
Astuce : si vous souhaitez apprendre à implémenter un perceptron multicouche (MLP) pour des tâches de classification avec MNIST, consultez ce tutoriel.
Dans le code ci‑dessous, vous définissez des variables d’environnement dans le notebook avec os.environ. C’est utile avant d’initialiser Keras pour limiter le backend TensorFlow à un GPU spécifique. Si la machine d’entraînement dispose d’un GPU en position 0, utilisez 0 plutôt que 1. Vous pouvez le vérifier via une simple commande dans votre terminal, par exemple nvidia-smi.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
Importez ensuite tous les modules requis comme numpy, matplotlib et surtout Keras, puisque vous utiliserez Keras comme framework dans ce tutoriel.
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Ici, vous définissez une fonction qui ouvre le fichier gzip, lit le contenu avec bytestream.read(). Vous lui passez la dimension d’image et le nombre total d’images. Ensuite, avec np.frombuffer(), vous convertissez la chaîne stockée dans buf en un tableau NumPy de type float32.
Une fois converti en tableau NumPy, vous le remodelez en tenseur 3D où la première dimension est le nombre d’images, et les deuxième et troisième sont les dimensions de l’image. Enfin, vous retournez le tableau NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Appelez maintenant la fonction extract_data() en lui passant les fichiers d’entraînement et de test avec leur nombre d’images correspondant.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
De façon similaire, vous définissez une fonction d’extraction des étiquettes qui ouvre le fichier gzip, lit le contenu avec bytestream.read() en lui passant la dimension du label (1) et le nombre total d’images. Puis, avec np.frombuffer(), vous convertissez la chaîne stockée dans buf en un tableau NumPy de type int64.
Cette fois, vous n’avez pas besoin de remodeler le tableau, car labels renverra un vecteur colonne de dimension 60 000 x 1. Enfin, vous retournez le tableau NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Appelez maintenant la fonction d’extraction des labels en lui passant les fichiers d’étiquettes d’entraînement et de test avec leur nombre d’images correspondant.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Une fois les données d’entraînement et de test chargées, vous pouvez analyser les données pour vous faire une idée du jeu avec lequel vous allez travailler.
Analysons l’aspect des images et vérifions aussi leurs dimensions à l’aide de l’attribut NumPy .shape :
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Comme on le voit ci‑dessus, les images d’entraînement ont une forme 60000 x 28 x 28, car il y a 60 000 échantillons de dimension 28 x 28. De même, le jeu de test a une forme 10000 x 28 x 28 pour 10 000 échantillons.
Remarque : pour la reconstruction avec un autoencoder convolutif, vous n’avez pas besoin des étiquettes d’entraînement et de test. Vos images d’entraînement servent à la fois d’entrée et de vérité terrain, comme des labels en classification.
En revanche, pour la classification, vous aurez aussi besoin des étiquettes, ce que vous ferez plus tard dans le tutoriel. Même si, dans un premier temps, vous ne manipulerez que les images d’entraînement et de test, vous utiliserez les labels pour l’exploration.
Créons un dictionnaire qui associe les noms de classes à leurs libellés catégoriels :
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Jetons maintenant un œil à quelques images du jeu :
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
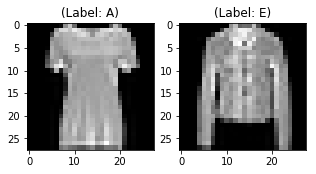
Le résultat de ces deux tracés montre un échantillon d’image de l’entraînement et du test, avec des étiquettes comme 0 ou A d’un côté, et 4 ou E de l’autre. Les autres lettres auront des étiquettes différentes, mais les mêmes lettres partageront la même étiquette. Par exemple, les 6 000 images de la classe E auront l’étiquette 4.
Les images sont en niveaux de gris, de 0 à 255, avec une dimension de 28 x 28. Avant d’alimenter le modèle, il est essentiel de les prétraiter. Vous convertirez d’abord chaque image 28 x 28 des jeux entraînement et test en tenseur 28 x 28 x 1, exploitable par le réseau :
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Vérifiez ensuite le type des tableaux NumPy d’entraînement et de test : ils doivent être en float32. Si ce n’est pas le cas, convertissez‑les. Ici, c’est déjà fait lors de la lecture. Il faut aussi ramener les pixels dans l’intervalle 0–1. Allons‑y !
N’oubliez pas de vérifier les types d’entraînement et de test :
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Ensuite, mettez à l’échelle les données d’entraînement et de test par la valeur maximale de pixel :
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Vérifions que la valeur maximale vaut bien 1,0 après mise à l’échelle :
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Après cela, il est important de partitionner les données. Pour que le modèle généralise bien, séparez 80 % des données pour l’entraînement et 20 % pour la validation.
Cela réduit aussi le risque de surapprentissage, puisque vous validez sur des données non vues pendant l’entraînement.
Utilisez le module train_test_split de scikit‑learn pour une division correcte :
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Remarque : vous utiliserez cette division deux fois. Une fois pour la reconstruction avec l’autoencoder convolutif (sans labels), d’où le passage des images deux fois : elles servent d’entrée et de vérité terrain, comme des étiquettes en classification.
Puis pour la classification, vous passerez aussi les étiquettes, que vous traiterez plus loin.
Vous êtes prêt à définir le réseau et y envoyer les données. Passons à la suite !
Les images sont de taille 28 x 28 x 1. Vous convertissez la matrice en tableau, mettez à l’échelle entre 0 et 1, reformez en 28 x 28 x 1, puis fournissez cette entrée au réseau.
Vous utiliserez un batch size de 128 (des tailles de 256 ou 512 peuvent aussi convenir selon votre machine). Cela influence fortement l’apprentissage et la précision finale.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Comme vous le savez, un autoencoder se compose de deux parties : un encodeur et un décodeur.
Encodeur : 4 blocs convolutifs, chacun avec une couche de convolution suivie d’une normalisation de lot. Une couche de max‑pooling est utilisée après les 1er et 2e blocs.
Décodeur : 3 blocs convolutifs, chacun avec une couche de convolution suivie d’une normalisation de lot. Une couche d’upsampling est utilisée après les 2e et 3e blocs.
Chaque max‑pooling réduit par 2 les dimensions spatiales, chaque upsampling les multiplie par 2.
Remarque : le nombre et la taille des filtres, le nombre de couches, le nombre d’époques, etc. sont des hyperparamètres à ajuster selon votre intuition. Testez, itérez et mesurez : c’est ainsi que l’on progresse en deep learning.
Créons des fonctions séparées pour l’encodeur et le décodeur, car vous réutiliserez les poids de l’encodeur pour la classification.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Après création du modèle, compilez‑le avec l’optimiseur RMSProp.
Indiquez aussi la fonction de perte via l’argument loss. Ici, l’erreur quadratique moyenne, calculée pixel par pixel entre la sortie prédite et la vérité terrain pour chaque batch :
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualisons les couches créées grâce à summary. Vous verrez le nombre de paramètres (poids et biais) par couche et au total.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
Il est temps d’entraîner le modèle avec la fonction fit() de Keras. Le modèle s’entraîne sur 200 époques. fit() retourne un objet history ; en le stockant dans autoencoder_train, vous pourrez tracer ensuite les courbes de perte entraînement/validation et analyser visuellement les performances.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
Parfait ! Vous avez entraîné le modèle sur Fashion‑MNIST pendant 100 époques. Traçons maintenant la courbe de perte entraînement/validation pour visualiser les performances.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
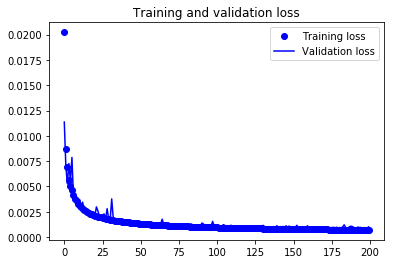
On observe que les pertes d’entraînement et de validation évoluent de concert. Votre modèle ne sur‑apprend pas : la perte de validation diminue et reste proche de la perte d’entraînement tout au long de l’apprentissage.
On peut donc dire que la capacité de généralisation du modèle est bonne.
Mais l’objectif est d’utiliser l’encodeur du modèle ci‑dessus pour classer les images Fashion‑MNIST. Passons donc à la suite.
Puisque vous aurez besoin des poids de l’encodeur pour la classification, sauvegardons d’abord les poids complets de l’autoencoder. Vous verrez ensuite comment extraire ceux de l’encodeur.
autoencoder.save_weights('autoencoder.h5')
Vous allez maintenant utiliser la tête du modèle entraîné, c’est‑à‑dire la partie encodeur, et charger les poids de l’autoencoder uniquement dans l’encodeur du nouveau modèle.
Vous ajouterez ensuite quelques couches denses (fully‑connected) à l’encodeur pour classer les images Fashion‑MNIST.
Le one‑hot encoding convertit une catégorie en un vecteur binaire. Les algorithmes de machine learning ne pouvant pas exploiter directement des catégories, on crée une colonne booléenne par classe, avec une seule valeur à 1 par échantillon. D’où le terme « one‑hot ».
Dans notre cas, le vecteur one‑hot est de dimension 1 x 10 pour chaque image, avec des zéros partout sauf pour l’indice de la classe, mis à 1.
Convertissons les étiquettes :
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Clair, n’est‑ce pas ?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Vérifions une dernière fois les formes des jeux d’entraînement et de validation.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Définissons à présent le modèle de classification. Vous allez réutiliser exactement la même partie encodeur que dans l’autoencoder.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Définissons les couches fully‑connected qui seront empilées après l’encodeur.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Remarque : étape importante. Pour vérifier que les poids de l’encodeur de l’autoencoder correspondent bien à ceux chargés dans l’encodeur du modèle de classification, imprimez les poids d’une même couche dans les deux modèles. S’ils diffèrent, la stratégie de classification par autoencoder perd son intérêt.
Imprimons les poids de la première couche des deux modèles.
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
Voila ! Les deux tableaux sont identiques. Passons sans tarder à la compilation et à l’entraînement.
Vous allez maintenant geler la partie encodeur, c’est‑à‑dire les dix‑neuf premières couches. Comme elle est déjà entraînée, inutile de la réentraîner. Vous n’entraînerez que la partie fully‑connected.
for layer in full_model.layers[0:19]:
    layer.trainable = False
Compilons le modèle.
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Affichons aussi son résumé. Il doit comporter des paramètres non entraînables, puisque vous avez gelé les premières couches.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
Entraînons le modèle avec fit() de Keras. Le modèle s’entraîne sur 10 époques. fit() retourne un objet history ; en stockant le résultat dans fashion_train, vous pourrez ensuite tracer les courbes de précision et de perte entraînement/validation pour une analyse visuelle.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
Super ! Vous avez entraîné le modèle sur Fashion‑MNIST en seulement 10 époques, et à la lecture des métriques on constate une excellente performance : environ 99 % de précision en entraînement et 98 % en validation.
Sauvegardons le modèle de classification.
full_model.save_weights('autoencoder_classification.h5')
Vous allez maintenant ré‑entraîner le modèle en rendant les dix‑neuf premières couches à nouveau entraînables (True) au lieu de les garder gelées. Allons‑y.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Entraînons maintenant l’ensemble du modèle une dernière fois.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Sauvegardons une dernière fois les poids du modèle.
full_model.save_weights('classification_complete.h5')
Mettons en perspective l’évaluation du modèle et traçons les courbes de précision et de perte pour l’entraînement et la validation :
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
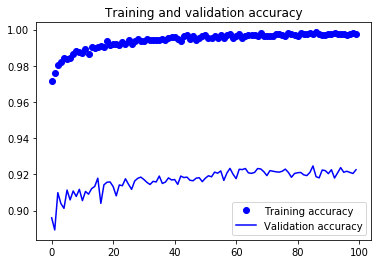
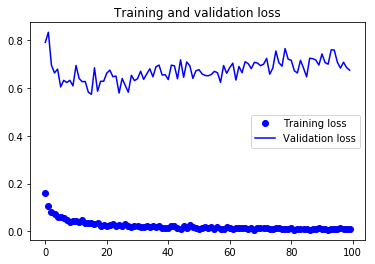
On constate un surapprentissage : un écart important subsiste entre les pertes d’entraînement et de validation. Pour y remédier, envisagez des techniques de régularisation comme le Dropout. Vous pouvez suivre ce tutoriel sur les CNN en Python avec Keras.
Évaluons enfin votre modèle sur les données de test pour voir ses performances.
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Les prédictions sont des valeurs flottantes ; il n’est pas pratique de les comparer telles quelles aux vraies étiquettes. Vous allez donc arrondir la sortie pour obtenir des entiers, puis utiliser np.argmax() afin de sélectionner, pour chaque ligne, l’indice de la valeur la plus élevée.
Par exemple, si la prédiction pour une image de test est [0 1 0 0 0 0 0 0 0 0], la classe prédite doit être 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
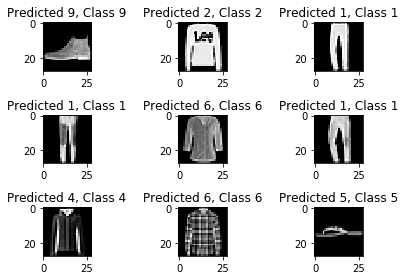
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
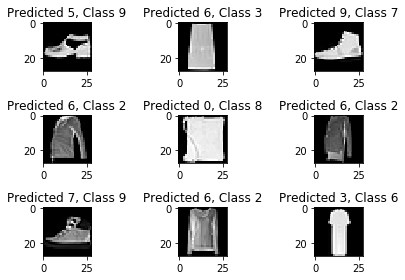
Le rapport de classification vous aide à identifier plus finement les classes mal classées. Vous verrez pour quelles classes le modèle se comporte le moins bien parmi les dix disponibles.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Ce tutoriel constitue une excellente introduction à l’utilisation conjointe d’un autoencoder et d’un réseau convolutif avec Python et Keras. Si vous avez pu suivre sans difficulté (ou avec un léger effort), bravo ! Tentez des expériences : gardez la même architecture et explorez d’autres jeux de données publics.
Il reste encore beaucoup à couvrir : pourquoi ne pas suivre le cours Deep Learning in Python de DataCamp ? En attendant, consultez la documentation Keras si ce n’est pas déjà fait. Vous y trouverez des exemples, la description des fonctions, arguments, couches, etc. Une ressource incontournable pour apprendre à travailler avec les réseaux de neurones en Python.
Si vous préférez un livre qui explique les fondamentaux du deep learning (avec Keras) et leurs applications pratiques, nous vous recommandons Deep Learning in Python de François Chollet.
Python courses
Cours
Cours
Cours