Kurs
Einführung in Deep Learning mit Python
4 Std.
264.6K
Hinweis: Dieses Tutorial konzentriert sich vor allem auf die praktische Umsetzung der Klassifikation mit einem Convolutional Neural Network und einem Convolutional Autoencoder. Falls du mit Convolutional Neural Networks (CNN) und Autoencodern noch nicht vertraut bist, wirf zuerst einen Blick auf das CNN- und das Autoencoder-Tutorial.
Im heutigen Tutorial gehst du im Kern diese Themen an:
Bevor wir den Datensatz laden und verarbeiten, ist es sinnvoll, ein Gefühl dafür zu bekommen, um welche Art von Daten es sich handelt, welche Dimensionen sie haben und wie viele Klassen enthalten sind.
Der Fashion-MNIST-Datensatz umfasst 70.000 Graustufenbilder in 28x28 Pixeln aus 10 Kategorien mit jeweils 7.000 Bildern. Das Trainingsset enthält 60.000, das Testset 10.000 Bilder. Fashion-MNIST ist als moderner Ersatz für den ursprünglichen MNIST-Datensatz gedacht; Bildgrößen sowie Train-/Test-Splits sind identisch. Du findest den Datensatz frei verfügbar unter dieser URL und kannst ihn in tensorflow wie auch keras direkt laden, ohne ihn lokal herunterzuladen.
Wie bei MNIST gibt es 10 Klassen, jedoch statt handschriftlicher Ziffern zehn Kategorien von Modeartikeln wie Sandalen, Hemd, Hose usw.
Die Aufgabe: Trainiere einen Convolutional Autoencoder und nutze den Encoder-Teil zusammen mit vollverbundenen Schichten, um Proben aus dem Testset korrekt zu erkennen.
Tipp: Wenn du lernen willst, wie man ein Multi-Layer Perceptron (MLP) für Klassifikationsaufgaben mit dem MNIST-Datensatz implementiert, schau dir dieses Tutorial an.
Im folgenden Code setzt du Umgebungsvariablen im Notebook via os.environ. Es ist sinnvoll, das vor der Initialisierung von Keras zu tun, um TensorFlow (Keras-Backend) auf eine bestimmte GPU zu beschränken. Falls die Trainingsmaschine die GPU unter Index 0 nutzt, verwende 0 statt 1. Prüfen kannst du das z. B. mit dem Terminal-Befehl nvidia-smi.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
Als Nächstes importierst du die benötigten Module wie numpy, matplotlib und vor allem Keras, denn in diesem Tutorial verwenden wir Keras als Framework!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Hier definierst du eine Funktion, die die gzip-Datei öffnet und mit bytestream.read() einliest. Du übergibst der Funktion die Bilddimensionen und die Gesamtzahl der Bilder. Mit np.frombuffer() wandelst du anschließend den in buf gespeicherten String in ein NumPy-Array vom Typ float32 um.
Danach formst du das Array in einen dreidimensionalen Tensor um: Die erste Dimension entspricht der Anzahl Bilder, die zweite und dritte der Bildgröße. Am Ende gibst du das NumPy-Array data zurück.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Nun rufst du extract_data() für Trainings- und Testdateien mit der jeweiligen Bildanzahl auf.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
In ähnlicher Weise definierst du eine Funktion zum Laden der Labels: Die gzip-Datei wird geöffnet, mit bytestream.read() eingelesen, wobei du die Labeldimension (1) und die Bildanzahl übergibst. Mit np.frombuffer() wandelst du den in buf gespeicherten String in ein NumPy-Array vom Typ int64 um.
Diesmal musst du nicht reshapen, da labels einen Spaltenvektor der Dimension 60.000 x 1 zurückgibt. Am Ende gibst du labels zurück.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Jetzt rufst du die Funktion für die Trainings- und Testlabels mit der jeweiligen Bildanzahl auf.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Sobald Trainings- und Testdaten geladen sind, kannst du mit der Analyse beginnen, um ein besseres Verständnis für den Datensatz zu entwickeln.
Schauen wir uns an, wie die Bilder aussehen und prüfen die Dimensionen per .shape des NumPy-Arrays:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Wie du siehst, hat das Trainingsset die Form 60000 x 28 x 28, da 60.000 Trainingsbeispiele mit je 28 x 28 Pixeln vorliegen. Analog hat das Testset die Form 10000 x 28 x 28.
Wichtig: Für die Rekonstruktion mit dem Convolutional Autoencoder brauchst du keine Trainings- und Testlabels. Die Trainingsbilder dienen sowohl als Eingabe als auch als Ground Truth, ähnlich wie Labels in der Klassifikation.
Für die Klassifikation benötigst du später zusätzlich die Labels. Für die Exploration, die dir mehr Intuition über die Daten gibt, nutzen wir sie jedoch bereits jetzt.
Erstellen wir ein Dictionary mit Klassennamen und den zugehörigen kategorischen Labels:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Werfen wir einen Blick auf ein paar Bilder im Datensatz:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
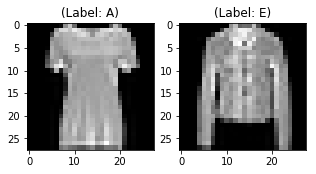
Das Ergebnis zeigt je ein Beispielbild aus Training und Test. Diese Bilder sind etwa mit 0 bzw. A und 4 bzw. E gelabelt. Unterschiedliche Buchstaben haben unterschiedliche Labels, gleiche Buchstaben dasselbe. Alle 6.000 Bilder der Klasse E tragen also das Label 4.
Die Bilder sind Graustufen mit Pixelwerten von 0 bis 255 und 28 x 28 Pixel groß. Bevor wir sie in das Modell einspeisen, ist Vorverarbeitung wichtig. Du wandelst jedes 28 x 28 Bild aus Train und Test in eine 28 x 28 x 1-Matrix um, die du dem Netzwerk übergibst:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Prüfe als Nächstes die Datentypen der Arrays. Sie sollten float32 sein. Da wir das bereits beim Einlesen erledigt haben, ist keine Konvertierung mehr nötig. Außerdem skalieren wir die Pixelwerte in den Bereich 0–1. Los geht’s!
Vergiss nicht, die Datentypen zu verifizieren:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Jetzt skalieren wir Trainings- und Testdaten anhand des maximalen Pixelwerts:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Überprüfen wir, dass der Maximalwert nun 1,0 ist:
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Danach teilen wir die Daten auf. Damit das Modell gut generalisiert, splitten wir die Trainingsdaten in Trainings- und Validierungsset. Wir trainieren auf 80% der Daten und validieren auf den restlichen 20%.
So reduzierst du das Risiko von Overfitting, da du auf Daten validierst, die das Modell im Training nicht sieht.
Nutze dafür train_test_split aus scikit-learn:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Hinweis: Dieses Splitting nutzt du zweimal: Einmal für die Rekonstruktion mit dem Convolutional Autoencoder, wofür du keine Labels brauchst – deshalb übergibst du die Trainingsbilder doppelt (als Eingabe und Ground Truth).
Für die Klassifikation ergänzt du später zusätzlich die Labels.
Jetzt definieren wir das Netzwerk und füttern die Daten hinein. Weiter geht’s!
Die Bilder haben die Größe 28 x 28 x 1. Du wandelst die Bildmatrix in ein Array, skalierst auf 0 bis 1, formst zu 28 x 28 x 1 und übergibst das als Input an das Netzwerk.
Wir verwenden eine Batchgröße von 128; auch 256 oder 512 sind je nach System sinnvoll. Die Batchgröße beeinflusst die Lernparameter und hat Auswirkungen auf die Genauigkeit.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Ein Autoencoder besteht aus zwei Teilen: Encoder und Decoder.
Encoder: 4 Convolution-Blöcke, jeweils mit Convolution- und Batch-Normalization-Schicht. Nach Block 1 und 2 folgt Max-Pooling.
Decoder: 3 Convolution-Blöcke, jeweils mit Convolution und Batch Normalization. Nach Block 2 und 3 folgt Upsampling.
Max-Pooling halbiert bei jeder Anwendung die räumliche Auflösung, Upsampling verdoppelt sie.
Hinweis: Anzahl und Größe der Filter, die Zahl der Schichten, die Epochenzahl etc. sind Hyperparameter. Probiere ruhig Varianten aus und miss die Performance – so entwickelst du Schritt für Schritt ein Gefühl für Deep Learning.
Lass uns Encoder- und Decoder-Funktionen separat anlegen, da du die Encoder-Gewichte später für die Klassifikation nutzen wirst.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Nach dem Erstellen des Modells kompilierst du es mit dem Optimizer RMSProp.
Außerdem musst du die Loss-Funktion angeben. Hier nutzen wir Mean Squared Error, der nach jedem Batch die Differenz zwischen Vorhersage und Ground Truth pixelweise berechnet:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Mit summary() kannst du dir die Schichten anzeigen lassen – inklusive Anzahl an Parametern (Gewichten und Biases) je Schicht und im gesamten Modell.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
Jetzt wird trainiert – mit Keras’ fit()-Funktion für 200 Epochen. fit() gibt ein History-Objekt zurück; wenn du es in autoencoder_train speicherst, kannst du später Trainings- und Validierungsverlust visualisieren.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
Geschafft! Du hast das Modell auf Fashion-MNIST 200 Epochen trainiert. Lass uns nun die Loss-Kurven für Training und Validierung plotten, um die Performance visuell zu beurteilen.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
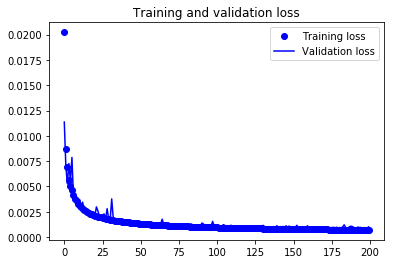
Man sieht, dass Trainings- und Validierungsverlust eng beieinander liegen und abnehmen. Das deutet darauf hin, dass dein Modell nicht überfitttet.
Die Generalisierungsfähigkeit ist also gut.
Unser eigentliches Ziel ist jedoch, den Encoder-Teil des oben trainierten Modells zur Klassifikation der Fashion-MNIST-Bilder zu nutzen. Weiter geht’s!
Da du die Encoder-Gewichte für die Klassifikation brauchst, speichern wir zunächst die kompletten Autoencoder-Gewichte. Wie du die Encoder-Gewichte extrahierst, siehst du gleich.
autoencoder.save_weights('autoencoder.h5')
Jetzt nutzt du den Kopf des trainierten Autoencoders, also den Encoder-Teil, und lädst die Gewichte des gerade trainierten Autoencoders ausschließlich in diesen Encoder-Teil.
Anschließend fügst du einige dichte, also vollverbundene Schichten hinzu, um die Fashion-MNIST-Bilder zu klassifizieren.
Beim One-Hot-Encoding wandelst du kategoriale Daten in Vektoren um. Da ML-Algorithmen nicht direkt mit Kategorien arbeiten, erzeugst du für jede Kategorie eine boolesche Spalte. Pro Sample steht genau eine dieser Spalten auf 1. Daher der Name One-Hot-Encoding.
In unserem Fall ist der One-Hot-Vektor eine Zeile mit Dimension 1 x 10. Wichtig: Der Vektor ist überall 0, außer bei der zugehörigen Klasse, dort ist er 1.
Also los:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Soweit klar, oder?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Zur Sicherheit prüfen wir noch die Shapes von Training und Validierung.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Jetzt definieren wir das Klassifikationsmodell. Dabei verwenden wir exakt den gleichen Encoder wie in der Autoencoder-Architektur.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Nun definieren wir die vollverbundenen Schichten, die wir an den Encoder anhängen.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Wichtig: Prüfe, ob die Encoder-Gewichte des Autoencoders tatsächlich mit denen im Klassifikationsmodell übereinstimmen. Drucke dazu die Gewichte einer identischen Schicht beider Modelle. Falls sie nicht übereinstimmen, ist der Autoencoder-Ansatz hier nicht sinnvoll.
Drucken wir die Gewichte der ersten Schicht beider Modelle:
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
Voila! Beide Arrays sind identisch. Also kompilieren wir das Modell und starten das Training.
Als Nächstes frierst du den Encoder-Teil, also die ersten neunzehn Schichten, ein. Da der Encoder bereits trainiert ist, müssen diese Schichten nicht erneut lernen. Trainiert werden nur die vollverbundenen Schichten.
for layer in full_model.layers[0:19]:
    layer.trainable = False
Kompilieren wir das Modell!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Schauen wir uns auch die Zusammenfassung an. Es sollten nun nicht-trainierbare Parameter erscheinen, da die ersten neunzehn Schichten eingefroren sind.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
Jetzt trainieren wir das Modell mit fit(). Es läuft 100 Epochen. Das zurückgegebene History-Objekt in fashion_train nutzen wir später für Accuracy- und Loss-Kurven auf Training und Validierung.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
Geschafft! Du hast das Modell auf Fashion-MNIST trainiert. Bereits nach kurzer Zeit erreicht es sehr hohe Trainingsgenauigkeiten bei solider Validierungsleistung.
Speichern wir das Klassifikationsmodell!
full_model.save_weights('autoencoder_classification.h5')
Jetzt trainierst du erneut – diesmal setzt du die ersten neunzehn Schichten auf trainierbar = True, statt sie eingefroren zu lassen.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Trainieren wir das gesamte Modell ein letztes Mal!
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Speichern wir das Modell ein letztes Mal.
full_model.save_weights('classification_complete.h5')
Zur Einordnung der Ergebnisse plotten wir Accuracy und Loss für Training und Validierung:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
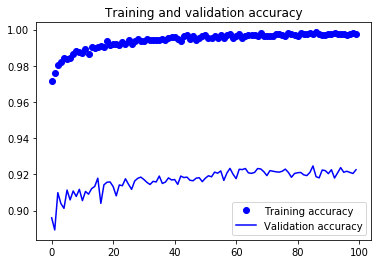
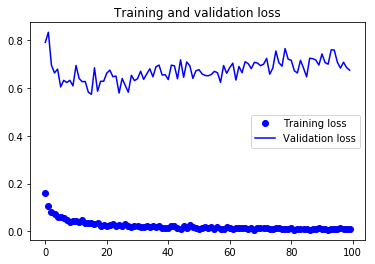
Aus den beiden Plots wird ersichtlich, dass das Modell überfittet: Zwischen Trainings- und Validierungsverlust liegt eine deutliche Lücke. Gegen Overfitting helfen Regularisierungstechniken wie Dropout. Mehr dazu findest du im CNN-Tutorial in Python mit Keras.
Zum Schluss bewerten wir das Modell auch auf den Testdaten:
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Da die Vorhersagen Fließkommazahlen sind, ist ein direkter Vergleich mit den echten Labels unpraktisch. Wir runden daher und nutzen np.argmax(), um pro Zeile den Index mit dem höchsten Wert zu wählen.
Beispiel: Ist die Vorhersage für ein Bild [0 1 0 0 0 0 0 0 0 0], lautet das Klassenlabel 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
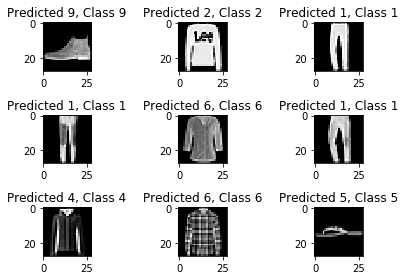
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
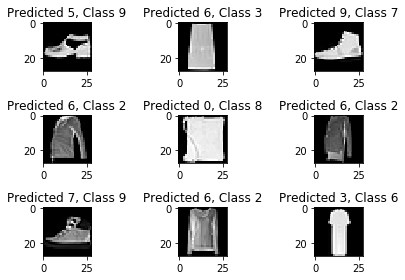
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
Der Classification Report hilft dir, Fehlklassifikationen im Detail zu erkennen. Du siehst, für welche der zehn Klassen das Modell schwächer abgeschnitten hat.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Dieses Tutorial war ein guter Einstieg in Autoencoder und vollverbundene Convolutional Neural Networks mit Python und Keras. Wenn du gut folgen konntest – stark! Probiere jetzt Varianten aus, etwa dieselbe Architektur mit anderen öffentlichen Datensätzen.
Es gibt noch viel zu entdecken – warum nicht gleich DataCamps Kurs Deep Learning in Python belegen? Schau dir außerdem die Keras-Dokumentation an, falls noch nicht geschehen. Dort findest du Beispiele, Erklärungen zu Funktionen, Argumenten und weiteren Schichten – ein unverzichtbares Nachschlagewerk, wenn du mit neuronalen Netzen in Python arbeitest!
Wenn du lieber ein Buch lesen möchtest, das die Grundlagen des Deep Learning (mit Keras) sowie Praxiseinsatz erklärt, empfehlen wir dir François Cholletts Deep Learning in Python.
Python-Kurse
Kurs
Kurs
Kurs