Curso
Introducción al Deep Learning en Python
4 h
264.6K
En general, los autoencoders se consideran una técnica de aprendizaje no supervisado, ya que no necesitas etiquetas explícitas para entrenar el modelo. Todo lo que necesitas es datos de entrada en bruto.
En este tutorial, aprenderás qué son los autoencoders en deep learning e implementarás un autoencoder convolucional y uno de eliminación de ruido en Python con Keras. Trabajarás con el dataset de alfabetos NotMNIST como ejemplo.
En pocas palabras, hoy verás:
Como leíste en la introducción, un autoencoder es un algoritmo de aprendizaje automático no supervisado que toma una imagen como entrada e intenta reconstruirla usando un menor número de bits en el cuello de botella, también llamado espacio latente. La imagen se comprime en gran medida en ese cuello de botella. La compresión en los autoencoders se logra entrenando la red durante un tiempo; a medida que aprende, intenta representar lo mejor posible la imagen de entrada en el cuello de botella. Los algoritmos generales de compresión de imágenes como JPEG o JPEG lossless comprimen sin necesidad de entrenamiento y suelen funcionar bastante bien.
Los autoencoders son similares a técnicas de reducción de dimensionalidad como el Análisis de Componentes Principales (PCA). Proyectan los datos de una dimensión mayor a otra menor mediante transformaciones lineales e intentan preservar las características importantes eliminando las partes no esenciales.
Sin embargo, la gran diferencia entre los autoencoders y PCA está en la transformación: como ya viste, PCA usa transformaciones lineales, mientras que los autoencoders emplean transformaciones no lineales.
Ahora que ya tienes una idea de qué son los autoencoders, ¡vamos a desglosar el término para ganar más intuición!
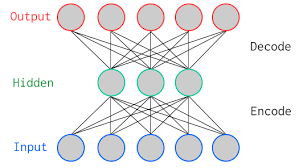
La figura anterior muestra un autoencoder sencillo de dos capas con una capa oculta. En la jerga del deep learning, verás a menudo que la capa de entrada no se tiene en cuenta al contar el número total de capas de una arquitectura. El total de capas incluye únicamente las capas ocultas y la capa de salida.
Como se muestra en la imagen, las capas de entrada y salida tienen el mismo número de neuronas.
Veamos un ejemplo. Introduces una imagen con cinco píxeles en el autoencoder; el codificador la comprime en tres valores de píxel en el cuello de botella (capa intermedia) o espacio latente. Con esos tres valores, el decodificador intenta reconstruir los cinco píxeles, es decir, la imagen original que diste como entrada a la red.
En la práctica, suele haber más capas ocultas entre la entrada y la salida.
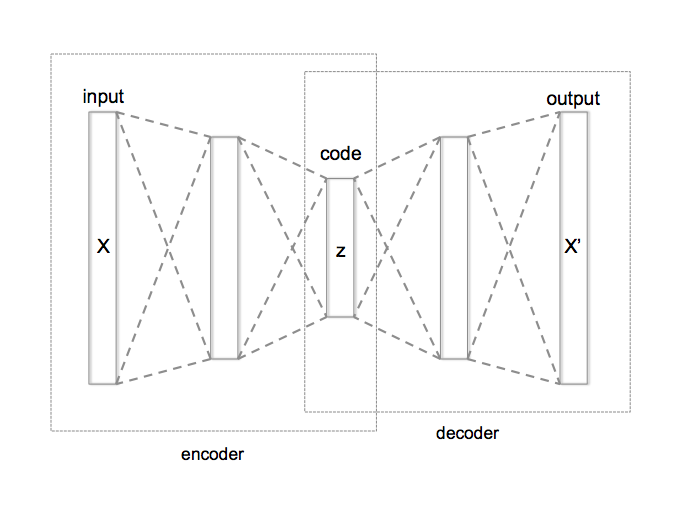
Un autoencoder se divide en tres partes
Existen distintos tipos de autoencoders, como el convolucional, el de eliminación de ruido, el variacional o el disperso (sparse). Sin embargo, como viste en la introducción, en este tutorial te centrarás únicamente en los convolucionales y los de eliminación de ruido.Convolutional Autoencoders in Python with Keras
Dado que tus datos de entrada son imágenes, es buena idea usar un autoencoder convolucional. No es una variante distinta, sino un autoencoder tradicional apilado con capas de convolución: básicamente sustituyes las capas totalmente conectadas por capas convolucionales. Las capas de convolución junto con las de max-pooling convierten la entrada de ancha (una imagen 28 x 28) y fina (un solo canal o escala de grises) a pequeña (imagen 7 x 7 en el espacio latente) y gruesa (128 canales).
¡No te preocupes si la idea anterior no te ha quedado clara del todo! La segunda parte del tutorial, donde te centrarás en la implementación, debería despejar tus dudas.
Consejo: si quieres saber más sobre redes neuronales convolucionales, echa un vistazo a este tutorial.
Esto ayuda a la red a extraer rasgos visuales de las imágenes y, por tanto, a obtener una representación del espacio latente más precisa. El proceso de reconstrucción utiliza upsampling y convoluciones, que conforman el decodificador. La reducción (downsampling) es el proceso por el cual la imagen se comprime a baja dimensión, y corresponde al codificador.
Es importante notar que el codificador principalmente comprime la imagen de entrada; por ejemplo: si tu imagen de entrada tiene dimensión 176 x 176 x 1 (~30976), el punto de compresión máxima puede tener dimensión 22 x 22 x 512 (~247808). En este caso, partiste de una imagen en escala de grises 176 x 176 y, tras pasarla por varias capas convolucionales y exactamente tres capas de max-pooling, la imagen se reduce a 22 x 22, pero el número de canales aumenta de 1 a 512. Como decíamos: pasas de una entrada ancha (176 x 176) y fina (1) a una pequeña (22 x 22) y gruesa (512).
El dataset notMNIST es un conjunto de reconocimiento de imágenes de glifos de letras de la A a la J. Es muy similar al clásico MNIST, que contiene imágenes de dígitos manuscritos del 0 al 9: en este caso, encontrarás que NotMNIST incluye imágenes en escala de grises de 28x28 con 70.000 letras de la A a la J, en total 10 categorías y 6.000 imágenes por categoría.
Consejo: si quieres aprender a implementar un perceptrón multicapa (MLP) para tareas de clasificación con el dataset MNIST, echa un vistazo a este tutorial.
El dataset NotMNIST no está predefinido en Keras ni en TensorFlow, así que tendrás que descargar los datos desde esta fuente. Los datos se descargarán en formato ubyte.gzip, ¡pero no te preocupes! Pronto verás cómo leer flujos de bytes y convertirlos en un array de NumPy. ¡Vamos allá!
La red se entrenará en una Nvidia Tesla K40, así que si entrenas en GPU y usas Jupyter Notebook, tendrás que añadir tres líneas más para especificar el orden de dispositivos CUDA y los dispositivos visibles CUDA usando el módulo os.
En el código siguiente, estableces variables de entorno en el notebook con os.environ. Es buena práctica hacerlo antes de inicializar Keras para limitar el backend TensorFlow a usar la primera GPU. Si la máquina en la que entrenas tiene la GPU en 0, asegúrate de usar 0 en lugar de 1. Puedes comprobarlo ejecutando un comando sencillo en tu terminal, por ejemplo, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
A continuación, importa los módulos necesarios como numpy, matplotlib y, lo más importante, keras, ya que será el framework que usarás hoy.
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
Aquí defines una función que abre el archivo gzip y lo lee con bytestream.read(). Le pasas la dimensión de la imagen y el número total de imágenes. Luego, con np.frombuffer(), conviertes la cadena almacenada en la variable buf en un array de NumPy de tipo float32.
Después, reconfiguras el array a uno tridimensional (tensor) donde la primera dimensión es el número de imágenes y la segunda y tercera son la dimensión de la imagen. Por último, devuelves el array de NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Ahora llamarás a la función extract_data() pasando los archivos de entrenamiento y prueba junto con su número de imágenes correspondiente:
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
De forma similar, defines una función para extraer etiquetas que abre el archivo gzip, lo lee con bytestream.read(), a la que pasas la dimensión de la etiqueta (1) y el número total de imágenes. Luego, con np.frombuffer(), conviertes la cadena almacenada en la variable buf en un array de NumPy de tipo int64.
Esta vez no necesitas reconfigurar el array, ya que la variable labels devolverá un vector columna de dimensión 60.000 x 1. Por último, devuelves el array de NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Ahora llamarás a la función de extracción de etiquetas pasando los archivos de etiquetas de entrenamiento y prueba junto con su número de imágenes correspondiente:
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Una vez cargados los datos de entrenamiento y prueba, ya puedes analizarlos para hacerte una idea del dataset con el que vas a trabajar hoy.
Analicemos cómo son las imágenes del dataset y veamos también su dimensión con el atributo de NumPy .shape:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Por la salida anterior, puedes ver que los datos de entrenamiento tienen forma 60000 x 28 x 28, ya que hay 60.000 muestras de entrenamiento, cada una con una matriz 28 x 28. De forma similar, los datos de prueba tienen forma 10000 x 28 x 28.
Nota: en esta tarea no usarás las etiquetas de entrenamiento y prueba. Solo trabajarás con las imágenes. Sin embargo, para explorar los datos y ganar intuición, usaremos las etiquetas.
Creemos ahora un diccionario con los nombres de clase y sus etiquetas categóricas correspondientes:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Ahora, echemos un vistazo a un par de imágenes del dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
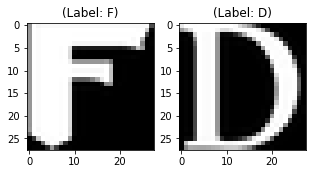
La salida de las dos gráficas anteriores muestra una de las imágenes de ejemplo de entrenamiento y prueba, a las que se les asignan las etiquetas 5 o F, por un lado, y 3 o D, por otro. De forma análoga, el resto de letras tienen distintas etiquetas, y las iguales comparten la misma. Es decir, las 6.000 imágenes de la clase F tendrán etiqueta 5.
Las imágenes del dataset son en efecto en escala de grises, con valores de píxel entre 0 y 255 y dimensión 28 x 28, así que antes de alimentar el modelo es importante preprocesarlas. Primero convertirás cada imagen 28 x 28 de train y test en una matriz de 28 x 28 x 1, que podrás pasar a la red:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Después, asegúrate de comprobar el tipo de datos de los arrays de entrenamiento y prueba: debe ser float32; si no, conviértelo (ya lo hiciste al leer los datos). Además, debes reescalar los valores de píxel al rango 0 - 1. ¡Hagámoslo!
No olvides verificar los tipos de datos de entrenamiento y prueba:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Ahora, reescala los datos de entrenamiento y prueba con el valor máximo de píxel de cada conjunto:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Verifiquemos que el valor máximo de train y test sea 1.0 tras el reescalado:
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Hecho esto, toca particionar los datos. Para que tu modelo generalice bien, divide el conjunto de entrenamiento en dos: entrenamiento y validación. Entrenarás con el 80% y validarás con el 20% restante.
Esto también ayuda a reducir el sobreajuste, ya que validarás con datos que el modelo no ve durante el entrenamiento.
Puedes usar el módulo train_test_split de scikit-learn para dividir correctamente:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Nota: para esta tarea no necesitas etiquetas de entrenamiento ni de prueba. Por eso pasarás las imágenes de entrenamiento dos veces. Tus imágenes de entrenamiento actuarán tanto como entrada como verdad terreno, igual que las etiquetas en una tarea de clasificación.
Ahora ya puedes definir la red y alimentar los datos. ¡Vamos al siguiente paso!
Las imágenes son de tamaño 28 x 28 x 1, o un vector de 784 dimensiones. Convertirás la matriz de imagen a un array, la reescalarás entre 0 y 1, le darás forma 28 x 28 x 1 y la pasarás como entrada a la red.
Usarás un tamaño de lote de 128; tamaños mayores como 256 o 512 también son válidos: depende del sistema con el que entrenes. Influyen mucho en el aprendizaje y en la precisión de las predicciones. Entrenarás durante 50 épocas.
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
Como comentamos, el autoencoder se divide en dos partes: codificador y decodificador.
Encoder
Decoder
La capa de max-pooling reducirá a la mitad la entrada cada vez que la uses, mientras que la de upsampling la duplicará cada vez.
Nota: el número de filtros, su tamaño, el número de capas o de épocas, son hiperparámetros y deberías decidirlos con tu propia intuición. Eres libre de probar variaciones y medir el rendimiento de tu modelo. ¡Así es como irás dominando el arte del deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Una vez creado el modelo, compílalo usando el optimizador RMSProp.
Consejo: mira este tutorial de Andrew Ng si quieres saber más sobre RMSProp.
Ten en cuenta que también debes especificar el tipo de pérdida con el argumento loss. En este caso, es el error cuadrático medio, ya que la pérdida tras cada lote se calcula entre la salida predicha y la verdad terreno, píxel a píxel, con el error cuadrático medio:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualicemos ahora las capas creadas con la función summary; verás el número de parámetros (pesos y sesgos) de cada capa y el total del modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
¡Por fin toca entrenar el modelo con la función fit() de Keras! El modelo se entrena durante 50 épocas. La función fit() devuelve un objeto history; si guardas el resultado en fashion_train, luego podrás trazar la curva de pérdida de entrenamiento y validación para analizar visualmente el rendimiento.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
¡Listo! Has entrenado el modelo en Not-MNIST durante 50 épocas. Ahora, representemos la pérdida de entrenamiento frente a la de validación para visualizar el rendimiento.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
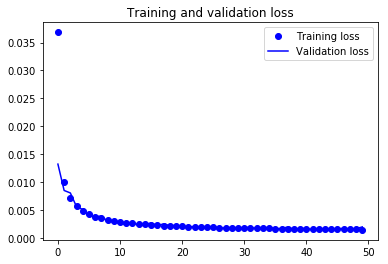
Como ves, las pérdidas de validación y entrenamiento van a la par. Indica que tu modelo no está sobreajustando: la pérdida de validación disminuye y no aumenta, y apenas hay brecha entre ambas curvas.
Por lo tanto, puedes decir que la capacidad de generalización de tu modelo es buena.
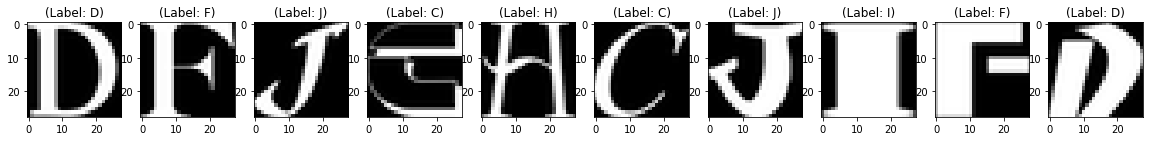
Por último, es el momento de reconstruir las imágenes de prueba usando la función predict() de Keras y comprobar qué tal reconstruye tu modelo en los datos de test.
Harás predicciones con el modelo entrenado sobre las 10.000 imágenes de test y representarás algunas reconstrucciones para visualizar la calidad.
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
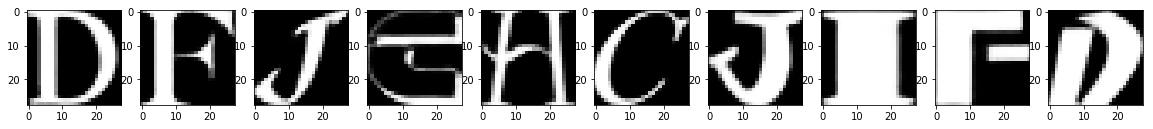
En las figuras anteriores puedes observar que tu modelo ha hecho un gran trabajo reconstruyendo las imágenes de prueba. Al menos visualmente, las originales y las reconstruidas son casi idénticas.
Un autoencoder de eliminación de ruido intenta aprender una representación (espacio latente o cuello de botella) robusta al ruido. Añades ruido a una imagen y pasas esa imagen ruidosa como entrada a la parte de codificación de tu red. El codificador transforma la imagen a un espacio que intenta preservar las letras pero eliminar el ruido.
Pero, ¿cómo elimina exactamente el ruido?
Durante el entrenamiento, defines una función de pérdida, similar al error cuadrático medio que usaste antes en el autoencoder convolucional. En cada iteración, la red calculará la pérdida entre la imagen con ruido que sale del decodificador y la verdad terreno (imagen sin ruido) e intentará minimizar esa diferencia entre la reconstrucción y la imagen original libre de ruido. En otras palabras, la red aprenderá un espacio 7 x 7 x 128 que contendrá codificaciones sin ruido de los datos con los que entrenes.
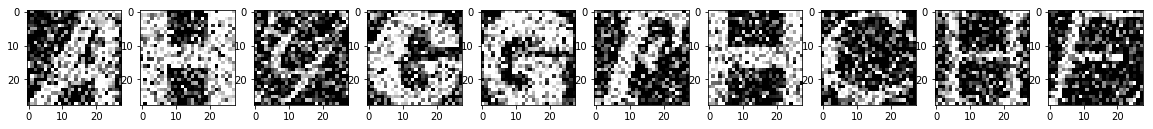
Para ver cómo funciona en Python, usarás el mismo dataset NotMNIST que en la primera parte. Eso significa que no necesitas repetir el preprocesamiento. Sin embargo, un paso clave aquí será añadir ruido a las imágenes de entrenamiento, validación y prueba. ¡Hagámoslo!
Primero definamos un factor de ruido, que es un hiperparámetro. Ese factor se multiplica por una matriz aleatoria con media 0,0 y desviación típica 1,0. Esta matriz toma muestras de una distribución normal (gaussiana). La forma del array normal aleatorio será la misma que la de los datos a los que añadirás el ruido.
Por simplicidad, veámoslo con un ejemplo: la variable train_X tiene forma 48000 x 28 x 28 x 1. Por lo tanto, el array normal aleatorio tendrá la misma forma que train_X; solo así podrás sumar ambos arrays.
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip() saturará todos los valores negativos a cero y todos los mayores que uno a uno, ya que quieres que los píxeles estén entre cero y uno. Como al introducir ruido el rango puede variar, es buena práctica recortar los valores para mantenerlos en el rango deseado.
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
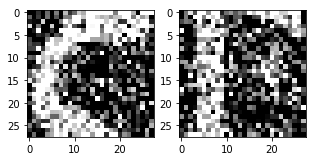
Ahora que ya tienes los datos con ruido, puedes pasarlos por la red y ver cómo el ruido se elimina "mágicamente" de las imágenes.
Como ya dijimos, el autoencoder se divide en dos partes: codificador y decodificador. La arquitectura que vas a construir tendrá este aspecto:
Encoder
Decoder
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Si recuerdas, al entrenar el autoencoder convolucional pasabas las imágenes de entrenamiento dos veces, ya que la entrada y la verdad terreno eran iguales. En el autoencoder de eliminación de ruido, en cambio, pasas las imágenes con ruido como entrada, mientras que la verdad terreno son las imágenes originales (sin ruido) a las que habías aplicado ese ruido. Solo así la red puede calcular la pérdida entre la imagen ruidosa y la imagen verdadera sin ruido.
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
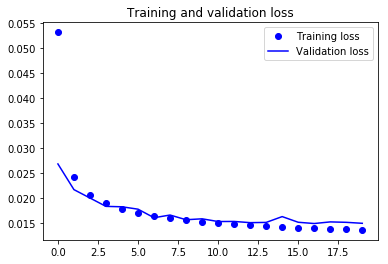
De la gráfica anterior puedes intuir que el modelo sobreajusta en algunas épocas, aunque en la mayor parte se mantiene estable. Puedes intentar mejorar el rendimiento introduciendo algo más de complejidad para reducir la pérdida o entrenando más épocas, y decidir después.
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
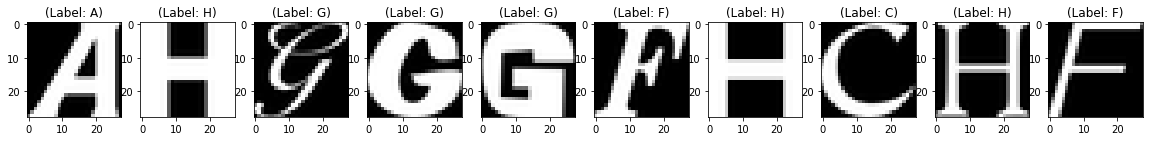
Test Images with Noise
Reconstruction of Noisy Test Images
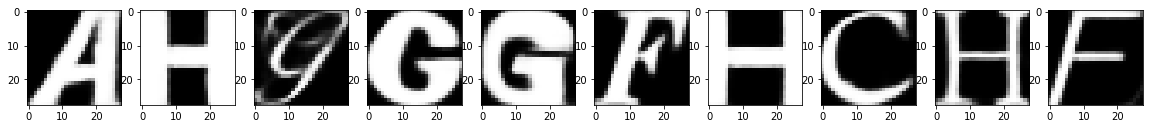
Parece que, en solo 20 épocas, una arquitectura bastante sencilla ha hecho un buen trabajo eliminando el ruido de las imágenes de prueba, ¿verdad?
Este tutorial es un buen punto de partida para entender los autoencoders tanto en teoría como en la práctica. Si has podido seguirlo sin problemas, o incluso con un poco de esfuerzo extra, ¡bien hecho! Echa un vistazo al tutorial Keras Tutorial: Deep Learning in Python de DataCamp y al curso Introduction to Deep Learning in Python.
En el próximo tutorial aprenderás a leer imágenes desde cero, analizarlas, preprocesarlas y alimentarlas al modelo usando un dataset de huellas dactilares. ¡También verás cómo leer imágenes médicas de modalidad T-1 y reconstruirlas con un autoencoder!
Todavía queda mucho por cubrir, así que ¿por qué no haces el curso Deep Learning in Python de DataCamp si aún no lo has hecho? Aprenderás desde lo básico y poco a poco llegarás a dominar el deep learning; sin duda será un recurso imprescindible para aprender a trabajar con redes convolucionales en Python, detectar caras, objetos, etc.
Aprende más sobre Python y Keras
Curso
Curso
Curso
Tutorial
Abid Ali Awan
15 min
Tutorial
Moez Ali
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Zoumana Keita
14 min
Tutorial
Kurtis Pykes
14 min