Curso
Introdução a Deep Learning em Python
4 h
264.6K
Observação: este tutorial foca principalmente na implementação prática de classificação usando rede neural convolucional e autoencoder convolucional. Se você ainda não está familiarizado com convolutional neural network (CNN) e autoencoder, vale dar uma olhada nos tutoriais de CNN e Autoencoder.
Mais especificamente, você vai abordar os seguintes tópicos neste tutorial:
Antes de carregar e processar o dataset, é bom ter uma noção do tipo de dados, suas dimensões e quantas classes diferentes existem.
O Fashion-MNIST é um conjunto de 70.000 imagens em tons de cinza 28x28 de produtos de moda em 10 categorias, com 7.000 imagens por categoria. O conjunto de treino tem 60.000 imagens, e o de teste tem 10.000. O Fashion-MNIST foi proposto como substituto do MNIST original para produzir resultados mais desafiadores; as dimensões das imagens e as divisões de treino e teste são semelhantes às do MNIST. O dataset está disponível gratuitamente neste link e pode ser carregado tanto com TensorFlow quanto com Keras sem precisar baixá-lo manualmente para sua máquina.
Assim como o MNIST, o Fashion-MNIST também tem 10 classes, mas em vez de dígitos manuscritos, temos 10 tipos de itens de moda, como sandálias, camisa, calças etc.
A tarefa aqui é treinar um autoencoder convolucional e usar a parte do encoder, combinada com camadas totalmente conectadas, para reconhecer corretamente novas amostras do conjunto de teste.
Dica: se você quer aprender a implementar um Multi-Layer Perceptron (MLP) para tarefas de classificação com o MNIST, confira este tutorial.
No código abaixo, definimos variáveis de ambiente no notebook usando os.environ. É uma boa prática fazer isso antes de inicializar o Keras para limitar o backend TensorFlow a usar a primeira GPU. Se a máquina em que você treina tiver a GPU em 0, certifique-se de usar 0 em vez de 1. Você pode verificar rodando um comando simples no terminal, por exemplo: nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
Agora, importe todos os módulos necessários como numpy, matplotlib e, principalmente, Keras, já que neste tutorial usaremos Keras como framework!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Aqui, definimos uma função que abre o arquivo gzip e lê o conteúdo com bytestream.read(). Você passa a dimensão da imagem e o número total de imagens para essa função. Em seguida, com np.frombuffer(), converte a string armazenada em buf em um array NumPy do tipo float32.
Depois de convertido em array NumPy, remodelamos o array para três dimensões (tensor), onde a primeira é o número de imagens e a segunda e a terceira são as dimensões da imagem. Por fim, retornamos o array NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Agora chamamos a função extract_data() passando os arquivos de treino e teste com seus respectivos números de imagens.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
De forma semelhante, definimos uma função para extrair rótulos que abre o arquivo gzip, lê o conteúdo com bytestream.read(), passando a dimensão do rótulo (1) e o número total de imagens. Com np.frombuffer(), convertemos a string em buf para um array NumPy do tipo int64.
Dessa vez, não precisamos remodelar o array, pois labels retornará um vetor coluna de dimensão 60.000 x 1. Por fim, retornamos o array NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Agora chamamos a função para extrair rótulos passando os arquivos de rótulos de treino e teste com seus respectivos números de imagens.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Com os dados de treino e teste carregados, já dá para analisar os dados e ganhar intuição sobre o dataset com que vamos trabalhar neste tutorial!
Vamos ver como são algumas imagens do dataset e checar as dimensões com o atributo .shape de NumPy:
# Shapes do conjunto de treino
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes do conjunto de teste
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Pelo output acima, o treino tem shape 60000 x 28 x 28, pois há 60.000 amostras de treino, cada uma uma matriz 28 x 28. O teste tem shape 10000 x 28 x 28 porque há 10.000 amostras de teste.
Observação: na tarefa de reconstrução com autoencoder convolucional você não precisa de rótulos de treino e teste. Suas imagens de treino serão tanto a entrada quanto o ground truth, de forma análoga aos rótulos em tarefas de classificação.
Mas, para a tarefa de classificação, você também vai precisar dos rótulos junto com as imagens — isso será feito mais adiante. Mesmo que aqui lidemos apenas com imagens de treino e teste, para fins de exploração, que ajudam a entender melhor os dados, usaremos os rótulos.
Vamos criar um dicionário com os nomes das classes e seus rótulos categóricos correspondentes:
# Dicionário de classes-alvo
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Agora, vamos dar uma olhada em algumas imagens do dataset:
plt.figure(figsize=[5,5])

# Mostra a primeira imagem no treino
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Mostra a primeira imagem no teste
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
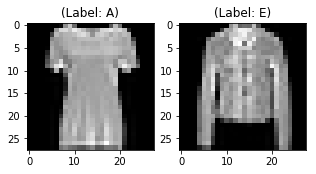
O resultado dos dois gráficos acima mostra uma amostra do treino e uma do teste. Essas imagens recebem rótulos de classe como 0 ou A e 4 ou E. Outras letras terão rótulos diferentes, mas a mesma letra compartilha o mesmo rótulo. Isso significa que todas as 6.000 imagens da classe E terão rótulo 4.
As imagens são em tons de cinza, com valores de pixel entre 0 e 255 e dimensão 28 x 28. Antes de alimentar o modelo, é fundamental preprocessar. Primeiro, vamos converter cada imagem 28 x 28 do treino e do teste em uma matriz 28 x 28 x 1, que pode ser enviada à rede:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Depois, verifique o tipo dos arrays de treino e teste. Eles devem estar em float32; se não estiverem, converta. Como já convertemos na leitura, não é preciso repetir. Também é preciso reescalar os pixels para a faixa 0–1. Vamos lá!
Não esqueça de verificar os tipos:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Agora, reescale os dados de treino e teste pelo valor máximo de pixel:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Vamos confirmar que o valor máximo agora é 1.0:
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Depois disso, é importante particionar os dados. Para o modelo generalizar bem, dividimos o treino em duas partes: treino e validação. Vamos treinar em 80% e validar em 20% dos dados de treino.
Isso também ajuda a reduzir overfitting, pois o modelo é validado em dados que ele não viu durante o treino.
Use o train_test_split do scikit-learn para dividir corretamente:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Observação: você usará essa divisão duas vezes: na reconstrução com autoencoder convolucional, em que não precisa de rótulos — por isso passamos as imagens de treino duas vezes, atuando como entrada e como ground truth — e, depois, na classificação, em que você também passará os rótulos.
Pronto para definir a rede e alimentar os dados. Vamos ao próximo passo!
As imagens têm tamanho 28 x 28 x 1. Convertendo a matriz em array, reescalando para 0 a 1, remodelando para 28 x 28 x 1, alimentamos isso como entrada da rede.
Usaremos batch size 128 (valores maiores como 256 ou 512 também podem funcionar melhor, depende do seu sistema). Esse parâmetro impacta fortemente o aprendizado e a acurácia.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Como você já deve saber, o autoencoder tem duas partes: encoder e decoder.
Encoder: 4 blocos convolucionais; cada bloco tem uma camada convolucional seguida de batch normalization. Camadas de max-pooling são usadas após o primeiro e o segundo blocos.
Decoder: 3 blocos convolucionais; cada bloco tem uma camada convolucional seguida de batch normalization. Camadas de upsampling são usadas após o segundo e o terceiro blocos.
O max-pooling reduz a entrada pela metade a cada uso; o upsampling aumenta pela metade a cada uso.
Observação: número de filtros, tamanho do filtro, número de camadas, épocas de treino etc. são hiperparâmetros e devem ser escolhidos com base na sua intuição. Sinta-se à vontade para experimentar e medir a performance. É assim que você desenvolve o “tato” em deep learning!
Vamos criar funções separadas de encoder e decoder, já que os pesos do encoder serão usados depois na classificação!
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Após criar o modelo, compile-o usando o otimizador RMSProp.
Também é preciso especificar a função de loss. Aqui usamos mean squared error, pois o loss após cada batch será calculado entre a saída prevista e o ground truth, pixel a pixel:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Vamos visualizar as camadas com summary(). Isso mostra o número de parâmetros (pesos e vieses) por camada e o total do modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
Hora de treinar com fit() do Keras! O modelo treina por 200 épocas. A função fit() retorna um objeto de histórico; guardando o resultado em autoencoder_train, você poderá depois plotar as curvas de loss de treino e validação para analisar a performance visualmente.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
Pronto! Você treinou o modelo no Fashion-MNIST por 100 épocas. Agora, vamos plotar as curvas de loss de treino e validação para visualizar a performance.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
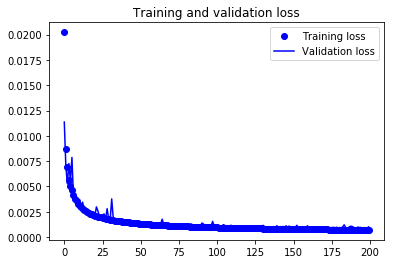
Repare que as curvas de loss de treino e validação estão alinhadas. Isso indica que seu modelo não está sofrendo overfitting: o loss de validação cai e não aumenta, e há pouca diferença entre as curvas ao longo do treino.
Podemos dizer que a capacidade de generalização está boa.
Mas a tarefa aqui é usar o encoder do modelo treinado para classificar as imagens do Fashion-MNIST. Vamos para a próxima parte!
Como você vai precisar dos pesos do encoder na classificação, vamos salvar primeiro os pesos completos do autoencoder. Em seguida, veremos como extrair os pesos do encoder.
autoencoder.save_weights('autoencoder.h5')
Agora vamos usar o “topo” do autoencoder treinado, isto é, o encoder, e carregar os pesos do autoencoder apenas na parte do encoder do novo modelo.
Depois, adicionaremos algumas camadas densas totalmente conectadas ao encoder para classificar as imagens do Fashion-MNIST.
No one-hot encoding, você converte dados categóricos em um vetor numérico. Fazemos isso porque algoritmos de machine learning não trabalham diretamente com categorias. Criamos uma coluna booleana para cada categoria/classe; apenas uma delas terá valor 1 por amostra — daí o nome one-hot.
No nosso problema, o one-hot será um vetor linha 1 x 10 para cada imagem. O detalhe importante: o vetor tem zeros em todas as posições, exceto na posição da classe correspondente, que vale 1.
Vamos converter os rótulos para one-hot:
# Converte os rótulos categóricos para one-hot
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Exibe a mudança após o one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Bem claro, né?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Mais uma checada nos shapes de treino e validação:
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Agora vamos definir o modelo de classificação. Lembre-se: usaremos exatamente o mesmo encoder da arquitetura do autoencoder.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Agora, as camadas totalmente conectadas que serão empilhadas após o encoder.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Observação: o próximo passo é muito importante. Para garantir que os pesos do encoder do autoencoder são iguais aos carregados no encoder do modelo de classificação, sempre imprima os pesos de alguma camada correspondente em ambos os modelos. Se não forem iguais, não vale a pena usar a estratégia de classificação com autoencoder.
Vamos imprimir os pesos da primeira camada de ambos os modelos.
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
Perfeito! Os arrays são idênticos. Então vamos compilar e começar o treino.
Agora, vamos tornar a parte do encoder — as primeiras dezenove camadas — não treinável. Como o encoder já foi treinado, não precisamos ajustá-lo; vamos treinar apenas a parte totalmente conectada.
for layer in full_model.layers[0:19]:
    layer.trainable = False
Vamos compilar o modelo!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Vamos imprimir o summary. Devem existir parâmetros não treináveis, já que tornamos as primeiras camadas não treináveis.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
Hora de treinar com fit() do Keras! O modelo treina por 10 épocas. A função fit() retorna um histórico; guardando em fashion_train (aqui classify_train), você poderá depois plotar as curvas de acurácia e loss de treino e validação para avaliar a performance visualmente.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
Pronto! Você treinou o modelo no Fashion-MNIST por apenas 10 épocas e, observando a acurácia e o loss de treino, dá para dizer que o modelo foi muito bem: após 10 épocas a acurácia de treino está em 99% e a validação em 98%.
Vamos salvar o modelo de classificação!
full_model.save_weights('autoencoder_classification.h5')
Em seguida, vamos re-treinar o modelo tornando as primeiras dezenove camadas treináveis (True) em vez de mantê-las congeladas. Vamos lá.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Agora vamos treinar o modelo completo pela última vez!
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Vamos salvar o modelo pela última vez.
full_model.save_weights('classification_complete.h5')
Agora, vamos colocar a avaliação em perspectiva e plotar as curvas de acurácia e loss de treino e validação:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
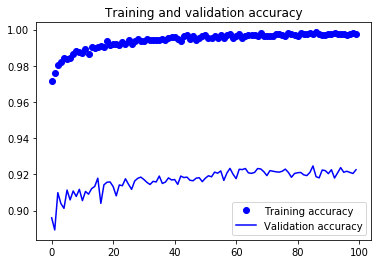
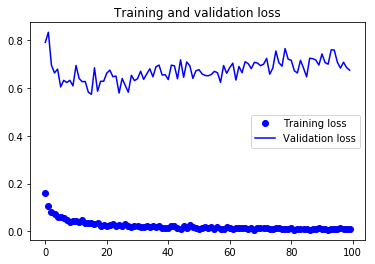
Nos dois gráficos acima, dá para ver overfitting, pois há um grande gap entre os losses de treino e validação. Para reduzir overfitting, experimente técnicas de regularização como Dropout. Você pode seguir este tutorial de CNN em Python com Keras.
Por fim, vamos avaliar o modelo nos dados de teste e ver como ele se sai!
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Como as previsões são valores de ponto flutuante, não é prático comparar diretamente com os rótulos verdadeiros. Vamos arredondar a saída para inteiros e usar np.argmax() para selecionar o índice com maior valor em cada linha.
Por exemplo, se a previsão para uma imagem for [0 1 0 0 0 0 0 0 0 0], o rótulo previsto deve ser 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
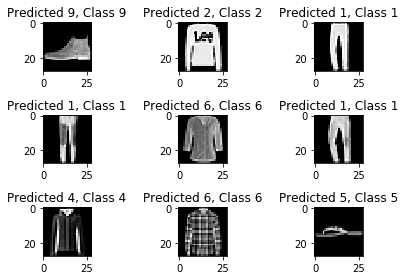
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
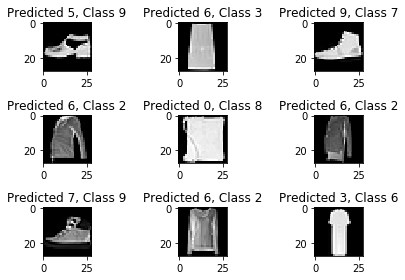
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
O relatório de classificação ajuda a identificar com mais detalhe as classes com erros. Você poderá observar em quais classes o modelo teve pior desempenho entre as dez disponíveis.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Este tutorial foi um ótimo começo para usar autoencoder e uma rede neural convolucional totalmente conectada com Python e Keras. Se você acompanhou tranquilo (ou com um pouco de esforço), mandou bem! Tente fazer alguns experimentos, talvez com a mesma arquitetura, mas usando outros datasets públicos.
Ainda há muito o que explorar. Que tal fazer o curso Deep Learning in Python da DataCamp? Enquanto isso, não deixe de consultar a documentação do Keras, se ainda não fez isso. Lá você encontra mais exemplos e informações sobre funções, argumentos, camadas etc. É um recurso indispensável para quem está aprendendo a trabalhar com redes neurais em Python!
Se você prefere um livro que explica os fundamentos de deep learning (com Keras) e como aplicar na prática, vale muito ler Deep Learning in Python, do François Chollet.
Cursos de Python
Curso
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
Kurtis Pykes
14 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Avinash Navlani
10 min
Tutorial
Moez Ali
14 min





