Curso
Introducción a Python
4 h
7M
Usarás el conjunto de datos de huellas dactilares FVC2002 para entrenar tu red. Para comprobar la eficacia del modelo, lo pondrás a prueba con dos conjuntos de datos procedentes de sensores distintos: Secugen y Lumidigm.
Nota: Este tutorial se centra principalmente en la implementación práctica de autoencoders convolucionales. Si aún no estás familiarizado con las redes neuronales convolucionales (CNN) y los autoencoders, te recomendamos revisar antes los tutoriales de CNN y Autoencoder.
En resumen, hoy abordaremos:
Antes de cargar los datos, conviene echar un vistazo a qué vas a manejar exactamente. El conjunto de datos FVC2002 procede de la Fingerprint Verification Competition, organizada en los años 2000 y 2002. Incluye huellas capturadas con cuatro tipos de sensores (sensor óptico de bajo coste, sensor capacitivo de bajo coste, sensor óptico y generador sintético), cada uno con tamaños de imagen diferentes. El set A contiene 3.200 imágenes, 800 por sensor. ¡Podrás comprobarlo tú mismo cuando cargues los datos! ;)
Este conjunto de datos no está predefinido en Keras ni en TensorFlow, por lo que tendrás que descargarlo desde esta fuente. En la siguiente sección verás cómo hacerlo.
Nota : Ten en cuenta que el modelo se entrenó en un sistema con GPU Nvidia 1080 Ti, procesador Xeon e5 GeForce y 32 GB de RAM. Si usas Jupyter Notebook, añade tres líneas para especificar el orden del dispositivo CUDA y los dispositivos visibles CUDA usando el módulo os.
En el siguiente código estableces variables de entorno en el notebook con os.environ. Es recomendable hacerlo antes de inicializar Keras para limitar el backend TensorFlow a la primera GPU. Si la máquina con la que entrenas tiene la GPU en 0, usa 0 en lugar de 1. Puedes comprobarlo ejecutando en la terminal, por ejemplo, nvidia-smi.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Empieza importando los módulos necesarios como cv2, numpy, matplotlib y, sobre todo, keras, ya que es el framework que usarás en este tutorial.
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Con los datos ya cargados, estás listo para analizarlos y hacerte una idea del conjunto con el que vas a trabajar.
Veamos ahora cómo son las imágenes del dataset y revisemos sus dimensiones usando el atributo .shape de los arrays de NumPy:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Como ves, los datos tienen forma 3200 x 224 x 224: hay 3.200 muestras y cada una es una matriz de 224 x 224.
Ahora, vamos a mostrar un par de imágenes del conjunto:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
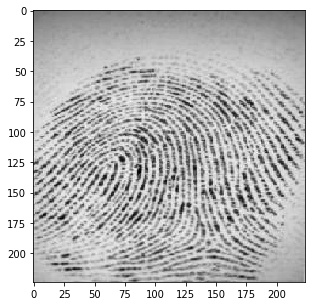
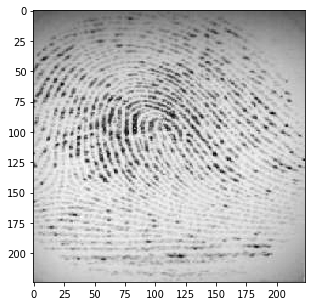
En estas dos figuras (del propio dataset) se aprecia que las huellas no son muy nítidas. Será interesante comprobar si el autoencoder convolucional aprende bien las características y es capaz de reconstruirlas correctamente.
Las imágenes son en escala de grises, con valores de píxel entre 0 y 255 y dimensión 224 x 224. Antes de alimentar el modelo, es clave preprocesarlas. Primero, convertiremos cada imagen 224 x 224 en una matriz 224 x 224 x 1 para poder introducirla en la red:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
A continuación, asegúrate de que el tipo de datos del array de NumPy sea float32; si no lo es, conviértelo. También debes reescalar los píxeles al rango 0–1. ¡Vamos a ello!
Primero, verifica el tipo de datos:
images_arr.dtype
dtype('float32')
Luego, reescala usando el valor máximo de los píxeles:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Comprueba ahora el valor máximo y mínimo: deberían ser 1.0 y 0.0 tras el reescalado.
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Después, es importante particionar los datos. Para que el modelo generalice bien, divide en entrenamiento y validación: entrenaremos con el 80% y validaremos con el 20% restante.
Esto también ayuda a reducir el sobreajuste, ya que validarás con datos no vistos durante el entrenamiento.
Puedes usar train_test_split de scikit-learn para hacerlo correctamente:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Nota: para esta tarea no necesitas etiquetas de entrenamiento ni de prueba. Por eso pasamos las imágenes dos veces: actúan como entrada y como «verdad terreno» (ground truth), igual que las etiquetas en una tarea de clasificación.
Ya puedes definir la red y alimentar los datos. ¡Vamos al siguiente paso!
Las imágenes son de tamaño 224 x 224 x 1, es decir, un vector de 50.176 dimensiones. Conviertes la matriz de imagen en array, la reescalas a 0–1, la reconfiguras a 224 x 224 x 1 y la usas como entrada de la red.
Usaremos un batch size de 128 (también es viable 256 o 512; depende del sistema con el que entrenes). Este parámetro influye mucho en el aprendizaje y en la precisión. Entrenaremos durante 50 épocas.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Como ya sabrás, un autoencoder tiene dos partes: codificador (encoder) y decodificador (decoder).
Encoder
Decoder
Max-pooling reduce la resolución a la mitad cada vez que se aplica; upsampling, por su parte, la duplica.
Nota: el número y tamaño de filtros, el número de capas y de épocas son hiperparámetros. Decide en función de tu criterio, prueba variaciones y mide el rendimiento. Así irás dominando el arte del deep learning.
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Una vez creado el modelo, compílalo usando el optimizador RMSProp.
También debes indicar la función de pérdida mediante el argumento loss. En este caso, usamos error cuadrático medio, ya que la pérdida tras cada batch se calcula píxel a píxel entre la predicción y el ground truth.
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualicemos ahora las capas con summary; verás el número de parámetros (pesos y sesgos) por capa y el total del modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
¡Hora de entrenar el modelo con fit() de Keras! Entrenaremos durante 200 épocas. fit() devuelve un objeto history; si lo guardas (por ejemplo, en autoencoder_train), podrás graficar después la pérdida de entrenamiento y validación para analizar el rendimiento visualmente.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
¡Listo! Has entrenado el modelo con el dataset de huellas durante 200 épocas. Ahora, grafiquemos la pérdida de entrenamiento y validación para visualizar el rendimiento.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
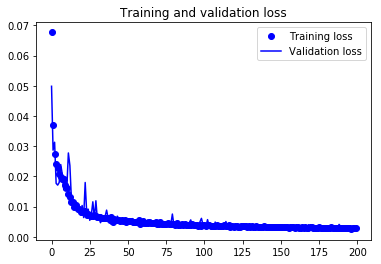
Se observa que las pérdidas de validación y de entrenamiento siguen una trayectoria similar. No hay sobreajuste: la pérdida de validación disminuye y apenas hay diferencia con la de entrenamiento, especialmente a partir de la época 40.
Por tanto, la capacidad de generalización del modelo es buena.
Ahora toca reconstruir imágenes de prueba con predict() de Keras y ver qué tal se comporta con los datos de test.
Guardemos el modelo entrenado. Es un paso clave en deep learning: los pesos son el corazón de tu solución.
Podrás cargar los pesos guardados en el mismo modelo y continuar el entrenamiento donde lo dejaste. Por ejemplo, si vuelves a entrenar el modelo anterior, parámetros como pesos, sesgos y la función de pérdida no empezarán desde cero.
Con una sola línea puedes guardar y volver a cargar los pesos.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
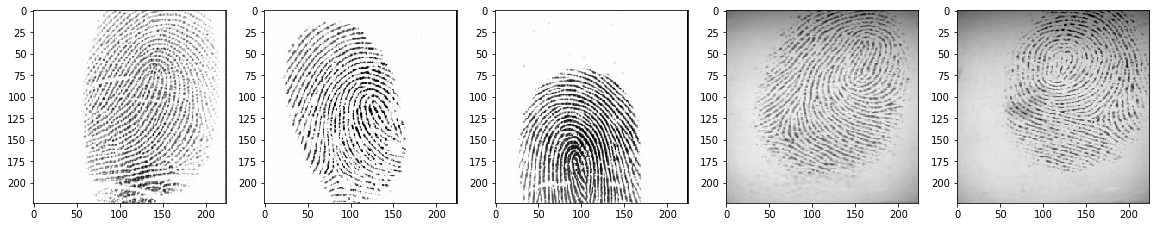
Como no tenemos un conjunto de test separado, usaremos los datos de validación para predecir con el modelo entrenado.
Generarás predicciones sobre las 640 imágenes de validación y mostrarás algunas reconstrucciones para evaluar visualmente la calidad.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
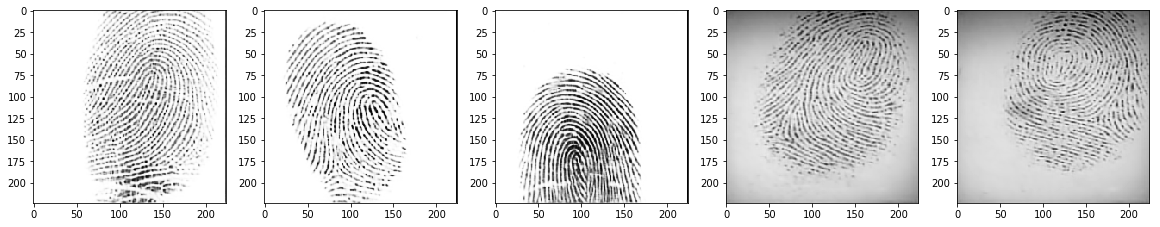
Como puedes ver, el modelo reconstruye las imágenes de prueba de forma excelente. Al menos visualmente, las originales y las reconstruidas son casi idénticas.
Como viste en la gráfica de entrenamiento vs validación, el modelo generaliza bien en datos no vistos. Ahora vamos a poner a prueba su robustez con datos de sensores diferentes.
Probremos con dos tipos de sensores:
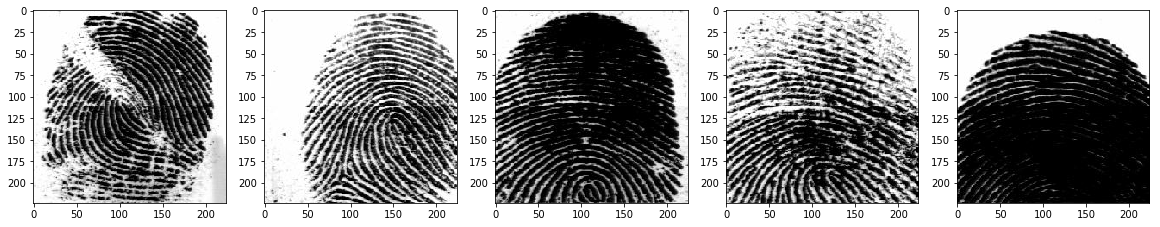
Primero, probaremos con un sensor de huellas de baja calidad, Secugen, y veremos cómo responde el modelo.
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Secugen Images
Reconstruction of Test Secugen Images
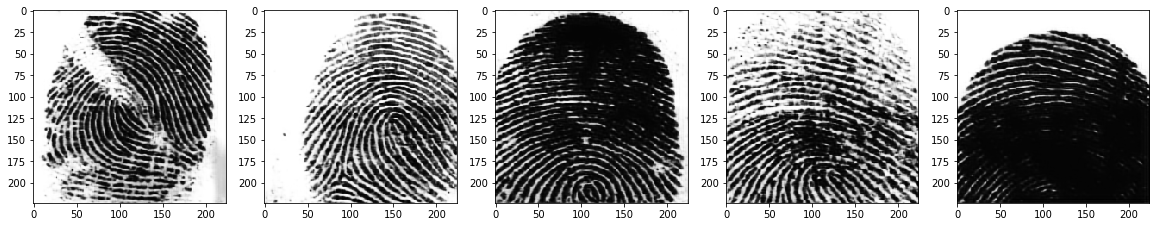
Como muestran las figuras, el modelo también reconstruye muy bien las imágenes de Secugen. ¿No está nada mal, verdad?
Ahora probemos con imágenes de un sensor de mejor calidad, Lumidigm.
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
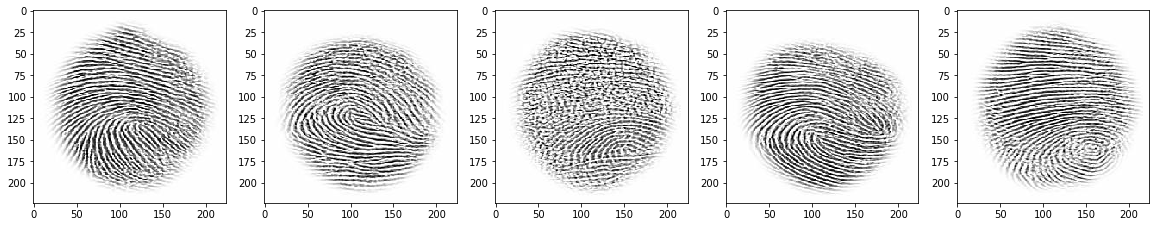
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
Reconstruction of Test Lumidigm Images
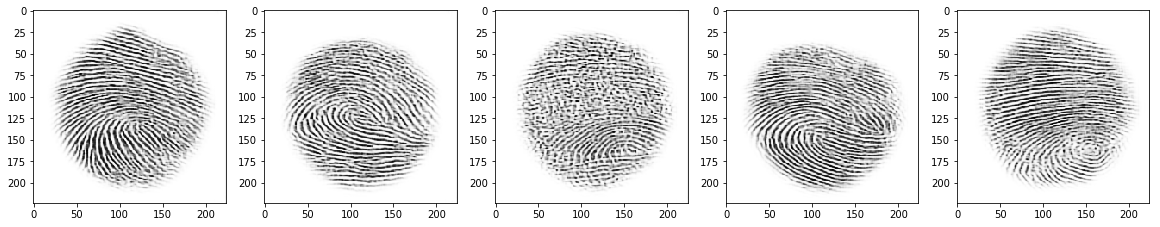
De nuevo, el modelo hace un gran trabajo reconstruyendo también las imágenes de Lumidigm.
Este tutorial es un buen punto de partida para entender cómo leer imágenes desde cero, analizarlas, preprocesarlas y alimentarlas a un modelo con un dataset de huellas dactilares. Has visto una aplicación práctica muy útil de los autoencoders. Si has podido seguirlo sin problemas (o incluso con un poco de esfuerzo), ¡enhorabuena!
En el próximo tutorial aprenderás a leer imágenes médicas de la modalidad T-1 y a reconstruirlas con un autoencoder.
Aún queda mucho por explorar, así que ¿por qué no haces el curso de DataCamp Deep Learning in Python? Si aún no lo has hecho, empezarás desde lo básico y avanzarás hasta dominar el deep learning: será un recurso imprescindible para trabajar con redes convolucionales en Python, detección de caras, objetos, etc.
Cursos de Python
Curso
Curso
Curso
Tutorial
Natassha Selvaraj
8 min
Tutorial
Zoumana Keita
14 min
Tutorial
Moez Ali
14 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Aditya Sharma
15 min