Kurs
Einführung in Deep Learning mit Python
4 Std.
264.6K
Grundsätzlich kannst du Autoencoder als eine Methode des unüberwachten Lernens betrachten, da du zum Trainieren des Modells keine expliziten Labels brauchst. Für das Training eines Autoencoders genügen Rohdaten als Eingabe.
In diesem Tutorial lernst du Autoencoder im Deep Learning kennen und implementierst einen Convolutional- und einen Denoising-Autoencoder in Python mit Keras. Als Beispiel arbeitest du mit dem NotMNIST-Alphabet-Datensatz.
Kurz gesagt, behandelst du heute folgende Themen:
Wie in der Einleitung erwähnt, ist ein Autoencoder ein unüberwachter Machine-Learning-Algorithmus, der ein Bild als Eingabe erhält und versucht, es mithilfe einer geringeren Anzahl von Bits im sogenannten Bottleneck bzw. Latent Space zu rekonstruieren. Am Bottleneck ist das Bild stark komprimiert. Diese Kompression entsteht, indem das Netzwerk über eine gewisse Zeit trainiert wird und lernt, die Eingabe im Bottleneck möglichst gut zu repräsentieren. Allgemeine Bildkompressionsverfahren wie JPEG oder JPEG-Lossless komprimieren Bilder ohne Training und liefern dabei bereits beachtliche Ergebnisse.
Autoencoder ähneln Dimensionalitätsreduktionstechniken wie der Hauptkomponentenanalyse (PCA). Sie projizieren Daten mittels Transformation von einem höherdimensionalen in einen niedrigerdimensionalen Raum und versuchen, wichtige Merkmale zu bewahren, während Unwesentliches entfernt wird.
Der entscheidende Unterschied zwischen Autoencodern und PCA liegt jedoch in der Art der Transformation: PCA nutzt lineare Transformationen, Autoencoder hingegen nichtlineare.
Da du nun ein Grundverständnis hast, zerlegen wir den Begriff weiter und bauen etwas Intuition auf!
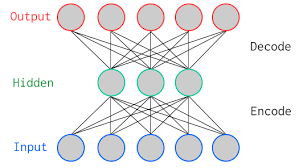
Die obige Abbildung zeigt einen einfachen Autoencoder mit zwei Schichten und einer verborgenen Schicht. In der Deep-Learning-Terminologie wird die Eingabeschicht beim Zählen der Schichten einer Architektur meist nicht mitgezählt. Die Gesamtzahl der Schichten umfasst die Anzahl der verborgenen Schichten sowie die Ausgabeschicht.
Wie in der Grafik erkennbar, haben Eingabe- und Ausgabeschicht gleich viele Neuronen.
Ein Beispiel: Du gibst ein Bild mit fünf Pixelwerten in den Autoencoder. Der Encoder komprimiert es am Bottleneck (mittlere Schicht) bzw. im Latent Space auf drei Pixelwerte. Aus diesen drei Werten versucht der Decoder, die fünf Pixelwerte bzw. das ursprüngliche Eingabebild zu rekonstruieren.
In der Praxis gibt es zwischen Eingabe und Ausgabe meist mehr verborgene Schichten.
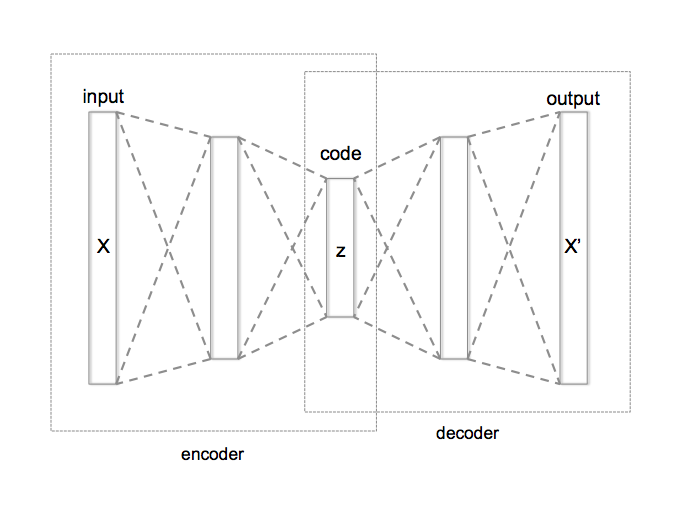
Ein Autoencoder lässt sich in drei Teile gliedern
Es gibt verschiedene Autoencoder-Varianten, etwa Convolutional, Denoising, Variational und Sparse Autoencoder. In diesem Tutorial konzentrierst du dich – wie eingangs erwähnt – auf Convolutional und Denoising.Convolutional Autoencoders in Python with Keras
Da deine Eingabedaten aus Bildern bestehen, ist es eine gute Idee, einen Convolutional Autoencoder zu verwenden. Dabei handelt es sich nicht um eine neue Autoencoder-Variante, sondern um einen klassischen Autoencoder mit Convolution-Schichten: Du ersetzt vollverbundene Schichten im Kern durch Convolutional Layers. Convolution-Schichten zusammen mit Max-Pooling wandeln die Eingabe von breit (28 x 28 Bild) und dünn (ein Kanal bzw. Graustufe) zu klein (7 x 7 Bild im Latent Space) und dick (128 Kanäle).
Keine Sorge, wenn das noch abstrakt klingt! Im zweiten Teil des Tutorials, in dem du das Ganze implementierst, klärt sich das hoffentlich.
Tipp: Wenn du mehr über Convolutional Neural Networks erfahren willst, wirf einen Blick in dieses Tutorial.
So kann das Netzwerk visuelle Merkmale aus den Bildern extrahieren und eine präzisere Repräsentation im Latent Space lernen. Die Rekonstruktion nutzt Upsampling und Convolutions – das ist der Decoder. Das Downsampling, also die Kompression in einen niedrigeren Raum, übernimmt der Encoder.
Wichtig: Der Encoder komprimiert vor allem die Eingabe, z. B.: Hat dein Eingabebild die Dimension 176 x 176 x 1 (~30976), kann der Punkt maximaler Kompression die Dimension 22 x 22 x 512 (~247808) haben. Du startest also mit einem Graustufenbild 176 x 176 und reduzierst es über mehrere Convolution-Schichten und genau drei Max-Pooling-Schichten schließlich auf 22 x 22 – bei gleichzeitigem Anstieg der Kanäle von 1 auf 512. Wie oben beschrieben: von breit (176 x 176) und dünn (1) zu klein (22 x 22) und dick (512).
Der notMNIST-Datensatz ist ein Bilderkennungs-Datensatz mit Schriftzeichen (Glyphen) der Buchstaben A bis J. Er ähnelt dem klassischen MNIST-Datensatz mit handgeschriebenen Ziffern 0 bis 9: NotMNIST umfasst 28x28-Graustufenbilder von insgesamt 70.000 Buchstaben A–J in 10 Kategorien mit je 6.000 Bildern.
Tipp: Wenn du wissen willst, wie du ein Multi-Layer Perceptron (MLP) für Klassifikationsaufgaben mit dem MNIST-Datensatz implementierst, schau dir dieses Tutorial an.
NotMNIST ist weder in Keras noch in TensorFlow vordefiniert, daher musst du die Daten von dieser Quelle herunterladen. Die Daten kommen im Format ubyte.gzip. Kein Problem – gleich lernst du, Bytestream-Formate zu lesen und in ein NumPy-Array zu konvertieren. Los geht’s!
Trainiert wird auf einer Nvidia Tesla K40. Wenn du auf einer GPU und in Jupyter Notebook trainierst, solltest du drei Zeilen Code ergänzen, um CUDA-Gerätereihenfolge und sichtbare Geräte über das Modul os festzulegen.
Im folgenden Code setzt du Umgebungsvariablen im Notebook mit os.environ. Es ist sinnvoll, dies vor der Initialisierung von Keras zu tun, um das Keras-Backend TensorFlow auf die erste GPU zu beschränken. Hat die Trainingsmaschine eine GPU unter 0, nutze 0 statt 1. Das kannst du z. B. mit nvidia-smi im Terminal prüfen.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Als Nächstes importierst du alle benötigten Module wie numpy, matplotlib und vor allem keras, da du es in diesem Tutorial verwendest.
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
Hier definierst du eine Funktion, die die gzip-Datei öffnet und mit bytestream.read() liest. Du übergibst die Bilddimension und die Anzahl der Bilder. Mit np.frombuffer() wandelst du die Zeichenkette in buf in ein NumPy-Array vom Typ float32 um.
Anschließend formst du das Array in ein dreidimensionales Array (Tensor) um: erste Dimension Anzahl Bilder, zweite und dritte Dimension die Bildgröße. Am Ende gibst du das NumPy-Array data zurück.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Jetzt rufst du extract_data() mit den Trainings- und Testdateien sowie der jeweiligen Bildanzahl auf:
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Ähnlich definierst du eine Funktion zum Extrahieren der Labels, die die gzip-Datei öffnet, mit bytestream.read() liest, die Labeldimension (1) und die Anzahl der Bilder erhält. Dann wandelst du den String in buf mit np.frombuffer() in ein NumPy-Array vom Typ int64 um.
Diesmal musst du das Array nicht umformen, da labels einen Vektor der Dimension 60.000 x 1 zurückgibt. Abschließend gibst du das NumPy-Array labels zurück.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Nun rufst du die Funktion zur Label-Extraktion mit den Trainings- und Test-Labeldateien sowie der jeweiligen Bildanzahl auf:
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Sobald Trainings- und Testdaten geladen sind, kannst du die Daten analysieren, um ein Gefühl für den Datensatz zu bekommen, mit dem du heute arbeiten wirst.
Schauen wir uns an, wie die Bilder im Datensatz aussehen, und prüfen wir mit dem NumPy-Array-Attribut .shape die Dimensionen:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Wie du siehst, hat das Training-Array die Form 60000 x 28 x 28, da es 60.000 Trainingsbeispiele mit je 28 x 28 Pixeln gibt. Entsprechend hat das Test-Array die Form 10000 x 28 x 28.
Hinweis: In dieser Aufgabe verwendest du die Trainings- und Testlabels nicht weiter. Wir arbeiten ausschließlich mit den Bildern. Zur Exploration, um ein besseres Gefühl für die Daten zu bekommen, nutzen wir die Labels dennoch kurz.
Erstellen wir ein Dictionary, das die Klassennamen den numerischen Labels zuordnet:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Werfen wir nun einen Blick auf ein paar Beispielbilder aus deinem Datensatz:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
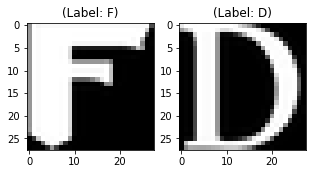
Die Ausgabe der beiden Plots zeigt Beispielbilder aus Trainings- und Testdaten. Diese Bilder sind etwa mit den Klassenlabels 5 bzw. F einerseits und 3 bzw. D andererseits versehen. Entsprechend haben andere Buchstaben andere Labels, gleiche Buchstaben dasselbe Label. Das heißt: Alle 6.000 Bilder der Klasse F tragen das Label 5.
Die Bilder sind Graustufenbilder mit Pixelwerten von 0 bis 255 und der Dimension 28 x 28. Bevor du die Daten ins Modell gibst, ist Vorverarbeitung wichtig. Zuerst wandelst du jedes 28 x 28 Bild aus Train- und Testset in eine Matrix der Größe 28 x 28 x 1 um, damit sie ins Netzwerk passen:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Prüfe als Nächstes den Datentyp der Arrays; er sollte float32 sein. Falls nicht, müsstest du konvertieren – das haben wir bereits beim Einlesen erledigt. Außerdem skalierst du die Pixelwerte auf den Bereich 0–1. Los geht’s!
Vergiss nicht, die Datentypen zu verifizieren:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Skaliere nun Trainings- und Testdaten mit dem maximalen Pixelwert der jeweiligen Daten:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Prüfen wir, ob der Maximalwert danach 1.0 ist:
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Im Anschluss teilst du die Daten auf. Damit dein Modell gut generalisiert, splittest du die Trainingsdaten in Training und Validierung: 80% Training, 20% Validierung.
So reduzierst du auch die Gefahr von Overfitting, da du auf bisher ungesehenen Daten validierst.
Zum sauberen Split nutzt du train_test_split aus scikit-learn:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Hinweis: Für diese Aufgabe brauchst du keine Labels. Deshalb übergibst du die Trainingsbilder zweimal. Sie dienen gleichzeitig als Eingabe und als Ground Truth – analog zu Labels in einer Klassifikationsaufgabe.
Jetzt definierst du das Netzwerk und speist die Daten ein. Also weiter zum nächsten Schritt!
Die Bilder haben die Größe 28 x 28 x 1 bzw. sind 784-dimensionale Vektoren. Du wandelst die Bildmatrix in ein Array, skalierst es auf 0 bis 1, formst es zu 28 x 28 x 1 und gibst es ins Netzwerk.
Du nutzt eine Batch-Größe von 128. Auch größere Batches wie 256 oder 512 sind möglich – das hängt vom System ab und beeinflusst Lernverhalten und Genauigkeit stark. Du trainierst 50 Epochen.
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
Wie besprochen, besteht der Autoencoder aus zwei Teilen: Encoder und Decoder.
Encoder
Decoder
Max-Pooling halbiert bei jeder Anwendung die räumliche Größe, Upsampling verdoppelt sie.
Hinweis: Anzahl und Größe der Filter, Schichten, Trainings-Epochen etc. sind Hyperparameter. Probiere ruhig Varianten aus und miss die Performance – so lernst du nach und nach die Kunst des Deep Learning.
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Nach dem Erstellen des Modells kompilierst du es mit dem Optimierer RMSProp.
Tipp: Schau dir dieses Tutorial von Andrew Ng zu RMSProp an, wenn du mehr darüber erfahren möchtest.
Außerdem gibst du den Loss-Typ über das Argument loss an. Hier ist es der Mean Squared Error, da der Verlust nach jeder Batch pixelweise zwischen vorhergesagter Ausgabe und Ground Truth als mittlerer quadratischer Fehler berechnet wird:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualisieren wir die Schichten mit der Summary-Funktion. Sie zeigt die Parameter (Gewichte und Biases) je Schicht und die Gesamtparameter deines Modells.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Jetzt trainieren wir das Modell mit der Keras-Funktion fit() für 50 Epochen. Die Funktion gibt ein History-Objekt zurück; speichere es als autoencoder_train, um später den Verlauf von Trainings- und Validierungsverlust zu plotten und die Performance visuell zu beurteilen.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
Geschafft! Du hast das Modell 50 Epochen lang auf NotMNIST trainiert. Jetzt plotten wir den Verlustverlauf von Training und Validierung, um die Performance zu visualisieren.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
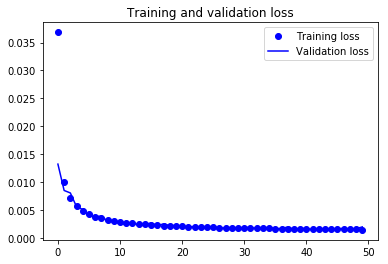
Du siehst, dass Validierungs- und Trainingsverlust gut zusammenlaufen. Dein Modell überfitten nicht: Der Validierungsverlust sinkt und steigt nicht an, und die Lücke zwischen beiden Kurven ist gering.
Das spricht für eine gute Generalisierungsfähigkeit deines Modells.
Zum Schluss ist es Zeit, die Testbilder mit der Keras-Funktion predict() zu rekonstruieren und zu prüfen, wie gut dein Modell auf den Testdaten rekonstruiert.
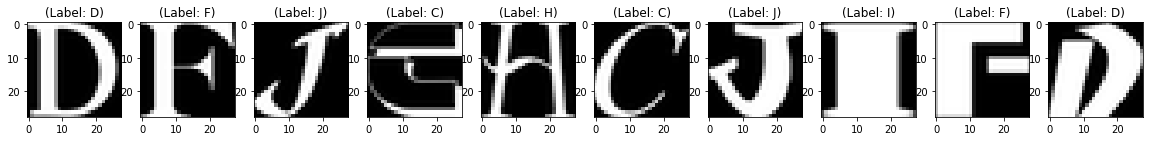
Du sagst für alle 10.000 Testbilder vorher und plottest einige rekonstruierte Bilder, um die Qualität der Rekonstruktion zu beurteilen.
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
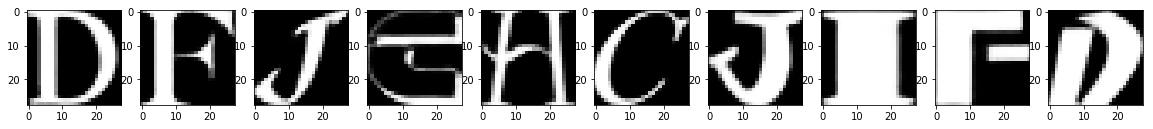
Wie du siehst, rekonstruiert dein Modell die Testbilder sehr gut. Visuell wirken Original und Rekonstruktion nahezu identisch.
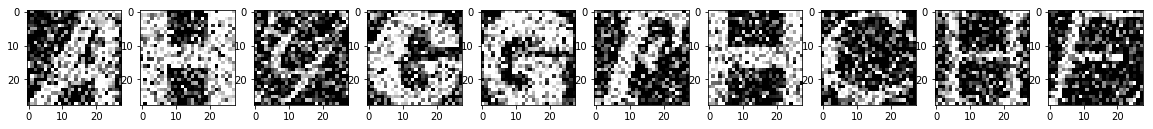
Ein Denoising Autoencoder lernt eine Repräsentation (Latent Space/Bottleneck), die robust gegenüber Rauschen ist. Du fügst einem Bild Rauschen hinzu und gibst das verrauschte Bild als Eingabe an den Encoder deines Netzwerks. Der Encoder transformiert das Bild in einen Raum, der die Buchstaben erhält, aber das Rauschen entfernt.
Aber wie entfernt er das Rauschen genau?
Beim Training definierst du eine Verlustfunktion – ähnlich dem Root Mean Squared Error aus dem Convolutional Autoencoder. In jeder Iteration berechnet das Netzwerk den Verlust zwischen dem vom Decoder ausgegebenen verrauschten Bild und der Ground Truth (dem rauschfreien Bild) und minimiert diese Differenz. Anders gesagt: Das Netzwerk lernt einen 7 x 7 x 128 großen Raum, der rauschfreie Kodierungen der Trainingsdaten enthält.
Für die Python-Implementierung verwendest du wie zuvor den NotMNIST-Datensatz. Das heißt, die Vorverarbeitung entfällt hier weitgehend. Ein wichtiger Schritt ist nun jedoch, Trainings-, Validierungs- und Testbildern Rauschen hinzuzufügen. Legen wir los!
Definieren wir zuerst einen noise factor als Hyperparameter. Er wird mit einer Zufallsmatrix multipliziert, die Mittelwert 0,0 und Standardabweichung 1,0 hat und aus einer Normalverteilung gezogen wird. Die Form der Zufallsmatrix entspricht der Form der Daten, denen du Rauschen hinzufügst.
Ein Beispiel: train_X hat die Form 48000 x 28 x 28 x 1. Also hat das Zufallsarray die gleiche Form – nur so lassen sich die Arrays addieren.
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip() setzt alle negativen Werte auf 0 und alle Werte größer als 1 auf 1, damit die Pixelwerte im Bereich 0–1 bleiben. Da die Werte durch das Hinzufügen von Rauschen geringfügig außerhalb dieses Bereichs liegen können, ist das Clipping eine sinnvolle Vorsichtsmaßnahme.
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
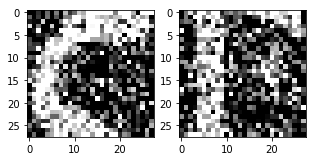
Jetzt, wo du verrauschte Daten hast, kannst du sie ins Netzwerk einspeisen und beobachten, wie das Rauschen „magisch“ verschwindet!
Wie zuvor teilt sich der Autoencoder in Encoder und Decoder. Die Architektur sieht wie folgt aus:
Encoder
Decoder
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Erinnerst du dich? Beim Convolutional Autoencoder hast du die Trainingsbilder doppelt übergeben, da Eingabe und Ground Truth identisch waren. Beim Denoising Autoencoder gibst du hingegen die verrauschten Bilder als Eingabe und die ursprünglichen, rauschfreien Bilder als Ground Truth. Nur so kann das Netzwerk den Verlust zwischen verrauschten und wahren rauschfreien Bildern berechnen.
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
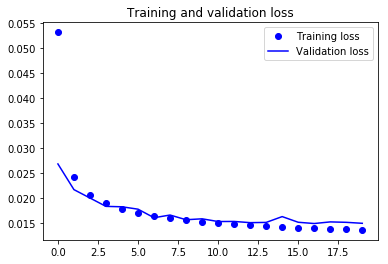
Der Plot zeigt: Das Modell überfittet phasenweise, ist aber meist im Gleichklang. Du kannst die Performance verbessern, indem du die Architektur leicht komplexer machst, länger trainierst und dann erneut bewertest.
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
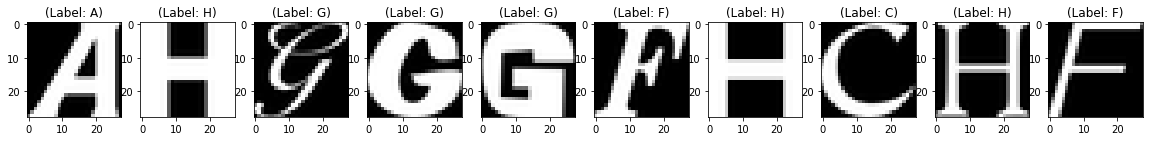
Test Images with Noise
Reconstruction of Noisy Test Images
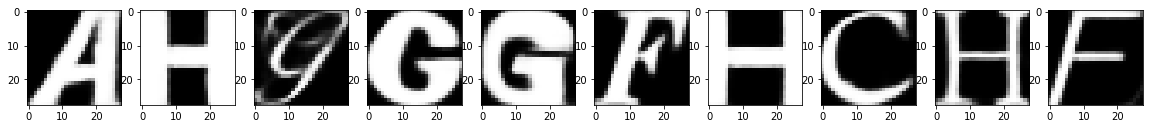
Sieht so aus, als hätte schon eine recht einfache Architektur in nur 20 Epochen das Rauschen aus den Testbildern überzeugend entfernt, oder?
Dieses Tutorial war ein guter Einstieg in Autoencoder – theoretisch wie praktisch. Wenn du gut folgen konntest (auch mit etwas Mühe): stark! Schau dir das Keras-Tutorial: Deep Learning in Python und den Kurs Introduction to Deep Learning in Python von DataCamp an.
Im nächsten Tutorial lernst du, Bilder von Grund auf einzulesen, zu analysieren, vorzubereiten und mit einem Fingerabdruck-Datensatz ins Modell zu geben. Außerdem erfährst du, wie man medizinische Bilder der T1-Modality liest und mit einem Autoencoder rekonstruiert.
Es gibt noch viel zu entdecken – warum nimmst du nicht DataCamps Kurs Deep Learning in Python, falls noch nicht geschehen? Du startest bei den Grundlagen und arbeitest dich Schritt für Schritt zu praxisnaher Expertise vor – eine unverzichtbare Ressource, wenn du mit Convolutional Neural Networks in Python arbeiten, Gesichter oder Objekte erkennen usw. möchtest.
Mehr über Python und Keras lernen
Kurs
Kurs
Kurs
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
DataCamp Team
4 Min.
Tutorial
Satyabrata Pal
15 Min.


