Curso
Introdução a Deep Learning em Python
4 h
264.6K
De modo geral, você pode considerar autoencoders como uma técnica de aprendizado não supervisionado, já que não precisa de rótulos explícitos para treinar o modelo. Tudo o que você precisa é de dados brutos de entrada.
Neste tutorial, você vai aprender sobre autoencoders em deep learning e vai implementar um autoencoder convolucional e um autoencoder de remoção de ruído em Python com Keras. Você vai usar o dataset de alfabetos NotMNIST como exemplo.
Resumindo, você vai abordar os seguintes tópicos no tutorial de hoje:
Como você leu na introdução, um autoencoder é um algoritmo de aprendizado de máquina não supervisionado que recebe uma imagem como entrada e tenta reconstruí-la usando um número menor de bits no gargalo, também conhecido como espaço latente. É nesse gargalo que a imagem é fortemente comprimida. A compressão em autoencoders é alcançada treinando a rede por um período e, à medida que aprende, ela tenta representar da melhor forma a imagem de entrada no gargalo. Algoritmos tradicionais de compressão de imagens como JPEG e JPEG sem perdas comprimem imagens sem necessidade de treinamento e se saem razoavelmente bem nessa tarefa.
Autoencoders são semelhantes a técnicas de redução de dimensionalidade como a Análise de Componentes Principais (PCA). Elas projetam os dados de uma dimensão maior para uma menor por meio de transformações lineares e tentam preservar as características importantes dos dados, removendo partes não essenciais.
Contudo, a principal diferença entre autoencoders e PCA está na transformação: como você já viu, a PCA usa transformações lineares, enquanto autoencoders usam transformações não lineares.
Agora que você já tem uma noção do que são autoencoders, vamos destrinchar o termo e construir uma intuição sobre ele!
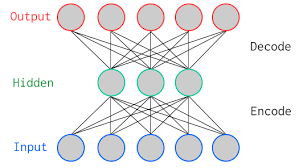
A figura acima mostra um autoencoder vanilla de duas camadas com uma camada oculta. Em terminologia de deep learning, é comum não considerar a camada de entrada ao contar o total de camadas de uma arquitetura. O total de camadas considera apenas o número de camadas ocultas e a camada de saída.
Como mostrado na imagem, as camadas de entrada e saída têm o mesmo número de neurônios.
Vamos a um exemplo. Você alimenta uma imagem com apenas cinco valores de pixel em um autoencoder, que o codificador comprime para três valores de pixel no gargalo (camada do meio) ou espaço latente. Usando esses três valores, o decodificador tenta reconstruir os cinco valores de pixel — ou seja, a imagem de entrada que você forneceu à rede.
Na prática, há mais camadas ocultas entre a entrada e a saída.
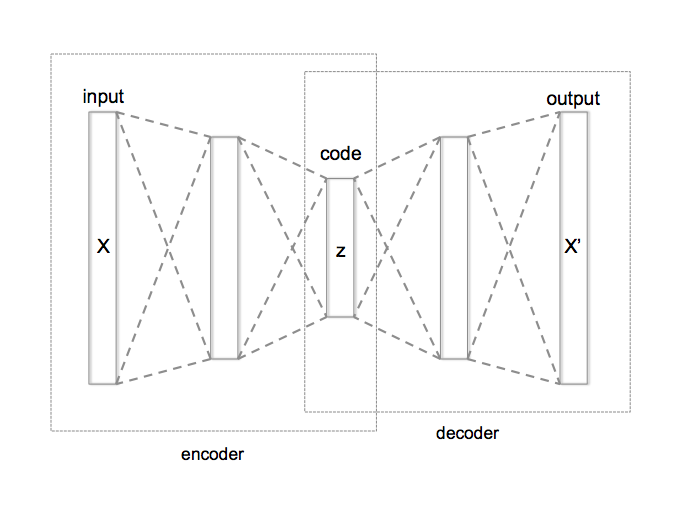
Um autoencoder pode ser dividido em três partes
Existem vários tipos de autoencoders, como o convolucional, o de remoção de ruído, o variacional e o esparso. No entanto, como você leu na introdução, neste tutorial vamos focar apenas nos modelos convolucionais e de remoção de ruído.Convolutional Autoencoders in Python with Keras
Como seus dados de entrada são imagens, é uma boa ideia usar um autoencoder convolucional. Ele não é uma variante completamente nova, mas sim um autoencoder tradicional empilhado com camadas de convolução: basicamente, você substitui camadas totalmente conectadas por camadas convolucionais. Camadas convolucionais, juntamente com camadas de max-pooling, convertem a entrada de larga (uma imagem 28 x 28) e fina (um único canal, escala de cinza) para pequena (imagem 7 x 7 no espaço latente) e espessa (128 canais).
Não se preocupe se a ideia acima não ficou totalmente clara! A segunda parte do tutorial, em que você vai focar na implementação, deve esclarecer todas as dúvidas.
Dica: se você quiser saber mais sobre redes neurais convolucionais, confira este tutorial.
Isso ajuda a rede a extrair características visuais das imagens e, consequentemente, obter uma representação mais fiel no espaço latente. O processo de reconstrução usa upsampling e convoluções, conhecido como decodificador. O downsampling é o processo em que a imagem é comprimida para uma dimensão menor, conhecido como codificador.
É importante notar que o codificador principalmente comprime a imagem de entrada. Por exemplo: se sua imagem de entrada tem dimensão 176 x 176 x 1 (~30976), então o ponto máximo de compressão pode ter dimensão 22 x 22 x 512 (~247808). Nesse caso, você começou com uma imagem em escala de cinza de 176 x 176 e, ao passá-la por algumas camadas convolucionais e exatamente três camadas de max-pooling, sua imagem é reduzida para 22 x 22, mas o número de canais aumenta de 1 para 512. Como dito acima, sua entrada que era larga (176 x 176) e fina (1) ficou pequena (22 x 22) e espessa (512).
O dataset notMNIST é um conjunto de imagens de glifos de fontes para as letras de A a J. Ele é bem semelhante ao clássico MNIST, que contém imagens de dígitos manuscritos de 0 a 9. No caso do NotMNIST, você encontrará imagens em escala de cinza 28 x 28 com 70.000 letras de A a J, totalizando 10 categorias, e 6.000 imagens por categoria.
Dica: se você quer aprender a implementar um Perceptron Multicamadas (MLP) para tarefas de classificação com o dataset MNIST, confira este tutorial.
O dataset NotMNIST não vem pré-definido no Keras ou TensorFlow, então você precisará baixá-lo desta fonte. Os dados serão baixados no formato ubyte.gzip, mas não se preocupe com isso agora! Você vai aprender a ler formatos bytestream e convertê-los em um array NumPy. Vamos começar!
A rede será treinada em uma Nvidia Tesla K40. Se você for treinar em GPU e usar Jupyter Notebook, será preciso adicionar três linhas de código para especificar a ordem dos dispositivos CUDA e quais dispositivos CUDA ficarão visíveis usando o módulo os.
No código abaixo, você basicamente define variáveis de ambiente no notebook usando os.environ. É bom fazer isso antes de inicializar o Keras para limitar o backend TensorFlow a usar a primeira GPU. Se a máquina em que você está treinando tiver a GPU em 0, use 0 em vez de 1. Você pode verificar executando um comando simples no terminal: por exemplo, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Em seguida, importe todos os módulos necessários, como numpy, matplotlib e, o mais importante, keras, já que é o framework que você vai usar hoje!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
Aqui, você define uma função que abre o arquivo gzip e o lê com bytestream.read(). Você passa a dimensão da imagem e o número total de imagens para essa função. Depois, com np.frombuffer(), converte a string armazenada na variável buf em um array NumPy do tipo float32.
Em seguida, você remodela o array em um tensor tridimensional, onde a primeira dimensão é o número de imagens e a segunda e a terceira são as dimensões da imagem. Por fim, retorna o array NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Agora você vai chamar a função extract_data() passando os arquivos de treino e teste junto com seus respectivos números de imagens:
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Da mesma forma, você define uma função para extrair rótulos que abre o arquivo gzip, lê com bytestream.read(), para a qual você passa a dimensão do rótulo (1) e o número total de imagens. Depois, com np.frombuffer(), converte a string armazenada em buf em um array NumPy do tipo int64.
Desta vez, não é necessário remodelar o array, pois a variável labels retornará um vetor coluna de dimensão 60.000 x 1. Por fim, você retorna o array NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Agora você vai chamar a função de extração de rótulos passando os arquivos de rótulos de treino e teste com seus respectivos números de imagens:
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Com os dados de treino e teste carregados, você já pode analisar o dataset para ganhar intuição sobre o que vai trabalhar no tutorial de hoje!
Vamos analisar como são as imagens do dataset e também ver a dimensão das imagens com a ajuda do atributo .shape do NumPy:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Pela saída acima, você vê que os dados de treino têm shape 60000 x 28 x 28, pois há 60.000 amostras de treino, cada uma com matriz 28 x 28. Do mesmo modo, os dados de teste têm shape 10000 x 28 x 28, já que são 10.000 amostras.
Observação: nesta tarefa, você não vai usar os rótulos de treino e teste. O foco será apenas nas imagens de treino e teste. Porém, para fins de exploração — que podem te dar melhor intuição —, você vai usar os rótulos.
Vamos criar um dicionário com os nomes das classes e seus respectivos rótulos categóricos:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Agora, vamos dar uma olhada em algumas imagens do seu dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
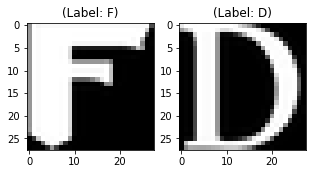
A saída dos dois gráficos acima mostra uma das amostras tanto dos dados de treino quanto dos de teste, e essas imagens estão associadas aos rótulos 5 ou F, por um lado, e 3 ou D, por outro. De forma análoga, outras letras terão rótulos diferentes, mas letras iguais terão o mesmo rótulo. Isso significa que todas as 6.000 imagens da classe F terão rótulo 5.
As imagens do dataset são em escala de cinza, com valores de pixel entre 0 e 255 e dimensão 28 x 28. Antes de alimentar os dados no modelo, é muito importante pré-processá-los. Primeiro, você vai converter cada imagem 28 x 28 dos conjuntos de treino e teste em uma matriz 28 x 28 x 1, que pode ser usada pela rede:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Depois, verifique o tipo de dados dos arrays NumPy de treino e teste; eles devem estar em formato float32 — se não estiverem, converta. Como você já fez essa conversão ao ler os dados, não precisa repetir. Também é preciso reescalar os valores de pixel para o intervalo 0–1. Vamos lá!
Não esqueça de verificar os tipos dos dados de treino e teste:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Agora, reescale os dados de treino e teste usando o valor máximo de pixel de cada um:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Vamos verificar o valor máximo dos dados de treino e teste, que deve ser 1.0 após o reescalonamento:
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Depois disso, é importante particionar os dados. Para o seu modelo generalizar bem, divida os dados de treino em duas partes: treino e validação. Você vai treinar com 80% e validar com 20% dos dados de treino.
Isso também ajuda a reduzir as chances de overfitting, já que você validará o modelo em dados que ele não viu durante o treinamento.
Você pode usar o módulo train_test_split do scikit-learn para dividir corretamente os dados:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Observação: para esta tarefa, você não precisa dos rótulos de treino e teste. Por isso, passamos as imagens de treino duas vezes. Suas imagens de treino atuam tanto como entrada quanto como ground truth, similar aos rótulos em tarefas de classificação.
Agora você está pronto para definir a rede e alimentar os dados. Sem mais demora, vamos para a próxima etapa!
As imagens são de tamanho 28 x 28 x 1, ou um vetor de 784 dimensões. Você converte a matriz da imagem em array, reescala entre 0 e 1, remodela para 28 x 28 x 1 e usa isso como entrada da rede.
Você vai usar um batch size de 128 — tamanhos maiores, como 256 ou 512, também são válidos; tudo depende da máquina em que você treina o modelo. O batch size influencia bastante os parâmetros de aprendizado e afeta a acurácia. O treinamento será de 50 épocas.
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
Como discutido, o autoencoder é dividido em duas partes: encoder e decoder.
Encoder
Decoder
A camada de max-pooling reduz a entrada pela metade a cada uso, enquanto a camada de upsampling dobra a dimensão a cada uso.
Observação: o número de filtros, o tamanho do filtro, o número de camadas e de épocas de treino são hiperparâmetros e devem ser definidos com base na sua intuição. Fique à vontade para experimentar, ajustando esses hiperparâmetros e medindo o desempenho do seu modelo. É assim que você vai, aos poucos, dominar a arte do deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Após criar o modelo, você precisa compilá-lo usando o otimizador RMSProp.
Dica: assista este tutorial do Andrew Ng sobre RMSProp para saber mais.
Note também que é preciso especificar o tipo de perda via o argumento loss. Neste caso, usamos o erro quadrático médio (MSE), já que a perda após cada batch é calculada entre a saída prevista e o ground truth, pixel a pixel:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Vamos visualizar as camadas criadas usando a função summary, que mostra o número de parâmetros (pesos e vieses) em cada camada e o total do modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Finalmente, é hora de treinar o modelo com a função fit() do Keras! O modelo treina por 50 épocas. A função fit() retorna um objeto de histórico; ao armazenar o resultado em autoencoder_train, você poderá usá-lo depois para plotar a curva de perda entre treino e validação, o que ajuda a analisar visualmente o desempenho.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
Pronto! Você treinou o modelo no NotMNIST por 50 épocas. Agora, vamos plotar a perda de treino versus validação para visualizar o desempenho.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
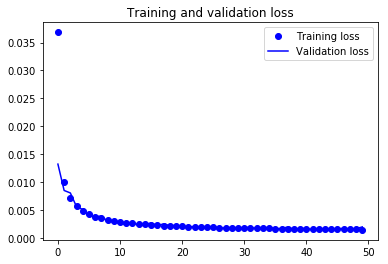
Você pode ver que a perda de validação e a de treino estão alinhadas. Isso indica que seu modelo não está com overfitting: a perda de validação está diminuindo (não aumentando) e raramente há um grande gap entre as curvas.
Portanto, podemos dizer que a capacidade de generalização do seu modelo é boa.
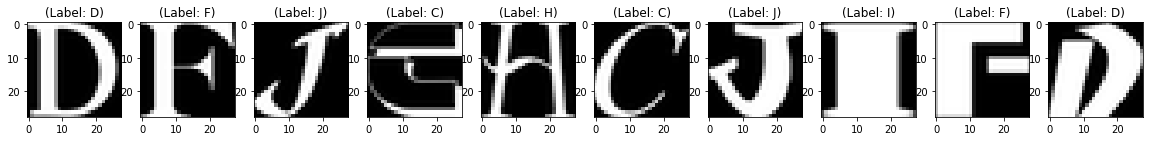
Por fim, é hora de reconstruir as imagens de teste usando a função predict() do Keras e ver o quão bem o modelo consegue reconstruir os dados de teste.
Você vai usar o modelo treinado para prever nas 10.000 imagens de teste e plotar algumas reconstruções para visualizar a qualidade do resultado.
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
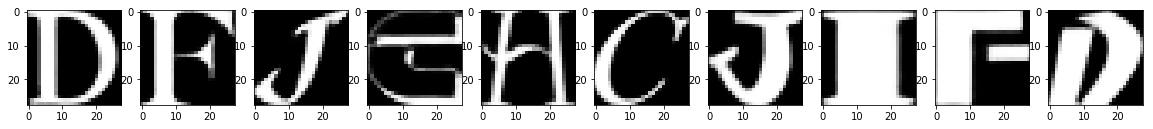
Pelas figuras acima, dá para notar que seu modelo fez um excelente trabalho ao reconstruir as imagens de teste. Pelo menos visualmente, as imagens originais e as reconstruídas parecem quase idênticas.
Um autoencoder de remoção de ruído tenta aprender uma representação (espaço latente ou gargalo) robusta a ruídos. Você adiciona ruído a uma imagem e então alimenta a imagem ruidosa como entrada para a parte do encoder da rede. O encoder transforma a imagem em um espaço que tenta preservar as letras e remover o ruído.
Mas como exatamente o ruído é removido?
Durante o treinamento, você define uma função de perda, semelhante ao erro quadrático médio que usamos no autoencoder convolucional. A cada iteração, a rede calcula a perda entre a imagem ruidosa produzida pelo decodificador e o ground truth (a imagem sem ruído) e tenta minimizar essa diferença entre a imagem reconstruída e a imagem original sem ruído. Em outras palavras, a rede aprende um espaço 7 x 7 x 128 que contenha codificações livres de ruído dos dados nos quais você a treinou!
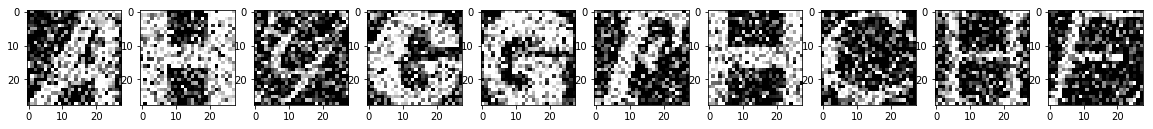
Para ver isso em Python, usaremos o mesmo dataset NotMNIST da primeira parte do tutorial. Isso significa que você não precisa refazer o pré-processamento, pois já foi feito! No entanto, uma etapa importante agora será adicionar ruído às imagens de treino, validação e teste. Vamos fazer isso primeiro!
Primeiro, vamos definir um fator de ruído, que é um hiperparâmetro. O fator de ruído é multiplicado por uma matriz aleatória com média 0,0 e desvio padrão 1,0. Essa matriz é amostrada de uma distribuição normal (Gaussiana). O shape do array normal aleatório será igual ao shape dos dados aos quais você adicionará ruído.
Para simplificar, pense assim: a variável train_X tem shape 48000 x 28 x 28 x 1. Logo, o array normal aleatório também terá o mesmo shape de train_X; só assim será possível somar os arrays, já que precisam ter dimensões iguais.
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip() vai limitar todos os valores negativos a zero e todos os valores maiores que um a um, pois queremos valores de pixel entre zero e um. Como há chances de o intervalo mudar após introduzir ruído, é uma boa prática fazer o clip dos valores.
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
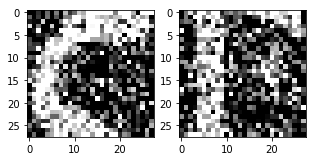
Agora que você tem os dados com ruído, pode alimentá-los na rede e ver como o ruído é "magicamente" removido das imagens!
Como discutido, o autoencoder é dividido em duas partes: encoder e decoder. A arquitetura que você vai construir será a seguinte:
Encoder
Decoder
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Se você lembrar, ao treinar o autoencoder convolucional, alimentamos as imagens de treino duas vezes, já que a entrada e o ground truth eram iguais. No autoencoder de remoção de ruído, porém, você fornece as imagens com ruído como entrada, enquanto o ground truth permanece sendo as imagens sem ruído — as mesmas às quais você adicionou o ruído. Só assim a rede conseguirá calcular a perda entre as imagens ruidosas e as verdadeiras sem ruído.
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
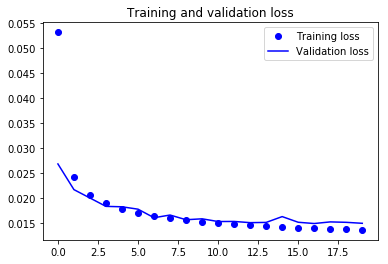
Pelo gráfico, dá para intuir que o modelo sofre um pouco de overfitting em algumas épocas, embora, na maior parte do tempo, as curvas fiquem alinhadas. Você pode tentar melhorar o desempenho adicionando alguma complexidade ao modelo para reduzir ainda mais a perda, ou treinando por mais épocas — vale testar.
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
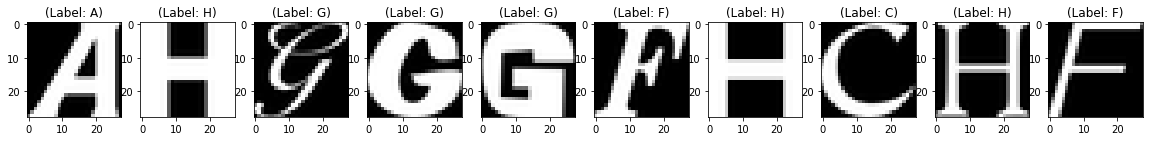
Test Images with Noise
Reconstruction of Noisy Test Images
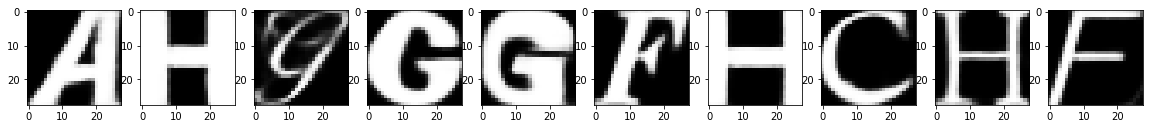
Pelo visto, em apenas 20 épocas, uma arquitetura relativamente simples já conseguiu remover bem o ruído das imagens de teste, não é?
Este tutorial foi um ótimo começo para entender autoencoders na teoria e na prática. Se você conseguiu acompanhar, mesmo que com um pouco de esforço, parabéns! Confira o tutorial Keras Tutorial: Deep Learning in Python e o curso Introduction to Deep Learning in Python da DataCamp.
No próximo tutorial, você vai aprender a ler imagens do zero, analisar, pré-processar e alimentá-las no modelo usando um dataset de digitais. Você também vai aprender a ler imagens médicas da modalidade T-1 e reconstruí-las usando um autoencoder!
Ainda há muito o que explorar, então que tal fazer o curso Deep Learning in Python da DataCamp? Se você ainda não fez, comece agora. Você vai aprender do básico até avançar no domínio de deep learning — será um recurso indispensável quando estiver aprendendo a trabalhar com redes neurais convolucionais em Python, detectar faces, objetos etc.
Saiba mais sobre Python e Keras
Curso
Curso
Curso
Tutorial
Kurtis Pykes
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Moez Ali
14 min