Cours
Introduction au Deep Learning en Python
4 h
264.8K
De manière générale, les autoencodeurs relèvent de l’apprentissage non supervisé, puisqu’il n’est pas nécessaire de disposer d’étiquettes explicites pour entraîner le modèle. Il suffit de données brutes en entrée.
Dans ce tutoriel, vous allez découvrir les autoencodeurs en deep learning et implémenter un autoencodeur convolutionnel ainsi qu’un autoencodeur de débruitage en Python avec Keras. Vous utiliserez l’ensemble de données alphabétiques NotMNIST comme exemple.
En bref, voici les sujets que vous allez aborder aujourd’hui :
Comme indiqué en introduction, un autoencodeur est un algorithme d’apprentissage automatique non supervisé qui prend une image en entrée et tente de la reconstruire en utilisant un plus petit nombre de bits au niveau du goulot d’étranglement, aussi appelé espace latent. C’est à ce niveau que l’image est fortement compressée. La compression dans les autoencodeurs est obtenue en entraînant le réseau pendant un certain temps ; au fil de l’apprentissage, il cherche à représenter au mieux l’entrée dans l’espace latent. Les algorithmes de compression d’images classiques comme JPEG et JPEG lossless compressent les images sans phase d’apprentissage et se débrouillent déjà très bien.
Les autoencodeurs sont proches des techniques de réduction de dimensionnalité comme l’analyse en composantes principales (ACP). Elles projettent les données d’un espace de grande dimension vers un espace de plus faible dimension au moyen de transformations linéaires, en essayant de préserver les caractéristiques importantes tout en éliminant le superflu.
La principale différence entre autoencodeurs et ACP tient à la nature de la transformation : comme vous l’avez lu, l’ACP est linéaire alors que les autoencodeurs apprennent des transformations non linéaires.
Maintenant que vous avez une première intuition sur les autoencodeurs, détaillons un peu plus le concept.
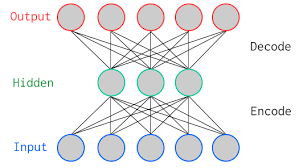
La figure ci-dessus représente un autoencodeur « vanilla » à deux couches avec une couche cachée. En deep learning, on ne compte généralement pas la couche d’entrée dans le total des couches d’une architecture. Le nombre total de couches comprend les couches cachées et la couche de sortie.
Comme illustré, les couches d’entrée et de sortie ont le même nombre de neurones.
Prenons un exemple. Vous donnez en entrée au réseau une image composée de cinq pixels. L’encodeur la compresse en trois valeurs au niveau du goulot d’étranglement (couche du milieu) ou espace latent. À partir de ces trois valeurs, le décodeur tente de reconstruire les cinq pixels, autrement dit l’image d’origine que vous aviez fournie au réseau.
En pratique, il y a souvent davantage de couches cachées entre l’entrée et la sortie.
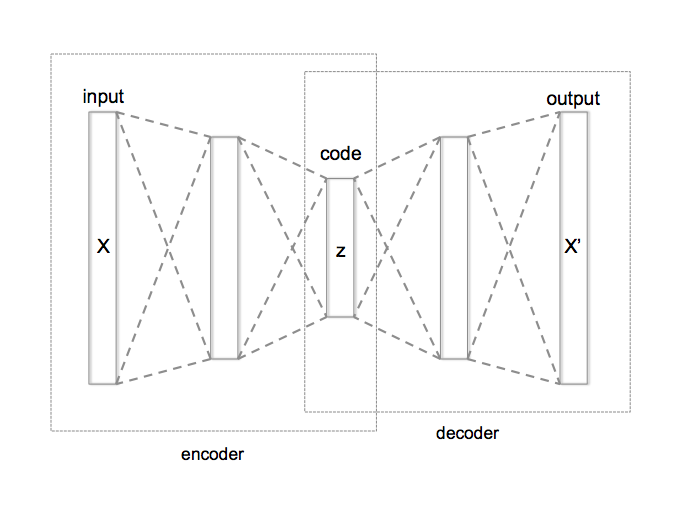
On peut décomposer un autoencodeur en trois parties
Il existe plusieurs types d’autoencodeurs, comme l’autoencodeur convolutionnel, l’autoencodeur de débruitage, l’autoencodeur variationnel ou encore l’autoencodeur parcimonieux. Cependant, comme annoncé en introduction, vous vous concentrerez ici sur les versions convolutionnelle et de débruitage.Convolutional Autoencoders in Python with Keras
Puisque vos données d’entrée sont des images, il est judicieux d’utiliser un autoencodeur convolutionnel. Ce n’est pas une variante fondamentalement différente, mais un autoencodeur classique où l’on remplace les couches entièrement connectées par des couches de convolution. Les couches de convolution, associées au max-pooling, transforment l’entrée de large (image 28 x 28) et fine (un seul canal ou niveau de gris) en petite (image 7 x 7 dans l’espace latent) et épaisse (128 canaux).
Pas d’inquiétude si l’idée ci-dessus n’est pas encore claire ! La deuxième partie de ce tutoriel, dédiée à l’implémentation, lèvera vos doutes.
Astuce : pour en savoir plus sur les réseaux de neurones convolutionnels, consultez ce tutoriel.
Cela aide le réseau à extraire des caractéristiques visuelles et donc à obtenir une représentation latente plus pertinente. La reconstruction utilise de l’upsampling et des convolutions : c’est la partie décodeur. Le downsampling (sous-échantillonnage) correspond à la compression de l’image en basse dimension : c’est la partie encodeur.
Notez qu’un encodeur compresse principalement l’image d’entrée. Par exemple : si votre image d’entrée est de dimension 176 x 176 x 1 (~30976), le point de compression « maximal » peut avoir une dimension de 22 x 22 x 512 (~247808). Ici, vous partez d’une image en niveaux de gris 176 x 176 et, après quelques couches de convolution et précisément trois couches de max-pooling, l’image est finalement sous-échantillonnée en 22 x 22 tandis que le nombre de canaux passe de 1 à 512. Comme indiqué plus haut, votre entrée de large (176 x 176) et fine (1) devient petite (22 x 22) et épaisse (512).
Le jeu de données notMNIST est un ensemble de reconnaissance d’images de glyphes de polices pour les lettres A à J. Il est assez proche du classique MNIST, qui contient des images de chiffres manuscrits de 0 à 9 : ici, vous trouverez des images en niveaux de gris 28 x 28 de 70 000 lettres de A à J, réparties en 10 catégories, à raison de 6 000 images par catégorie.
Astuce : si vous souhaitez implémenter un perceptron multicouche (MLP) pour des tâches de classification avec MNIST, consultez ce tutoriel.
Le jeu de données NotMNIST n’est pas prédéfini dans Keras ou TensorFlow, vous devrez donc le télécharger depuis cette source. Les données seront téléchargées au format ubyte.gzip, mais pas d’inquiétude ! Vous allez apprendre à lire des flux d’octets et à les convertir en tableaux NumPy. C’est parti !
Le réseau sera entraîné sur une Nvidia Tesla K40. Si vous entraînez sur GPU et utilisez Jupyter Notebook, vous devrez ajouter trois lignes de code pour définir l’ordre des périphériques CUDA et les GPU visibles via le module os.
Dans le code ci-dessous, vous définissez des variables d’environnement dans le notebook avec os.environ. Il est utile de le faire avant d’initialiser Keras, afin de limiter l’utilisation au premier GPU voulu côté backend TensorFlow. Si la machine sur laquelle vous entraînez dispose d’un GPU sur 0, utilisez 0 au lieu de 1. Vous pouvez le vérifier avec une simple commande dans votre terminal, par exemple nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Ensuite, importez les modules nécessaires comme numpy, matplotlib et surtout keras, puisque c’est le framework utilisé dans ce tutoriel.
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
Ici, vous définissez une fonction qui ouvre le fichier gzip, lit le fichier via bytestream.read(). Vous passez la dimension de l’image et le nombre total d’images à cette fonction. Puis, avec np.frombuffer(), vous convertissez la chaîne stockée dans la variable buf en tableau NumPy de type float32.
Ensuite, vous reformatez le tableau en tenseur 3D : première dimension : le nombre d’images, deuxième et troisième : la taille de l’image. Enfin, vous renvoyez le tableau NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Appelez maintenant la fonction extract_data() en lui passant les fichiers d’entraînement et de test, ainsi que leur nombre d’images :
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
De même, définissez une fonction d’extraction des étiquettes qui ouvre le fichier gzip, lit le fichier via bytestream.read(), à laquelle vous passez la dimension de l’étiquette (1) et le nombre total d’images. Puis, via np.frombuffer(), vous convertissez la chaîne stockée dans buf en tableau NumPy de type int64.
Cette fois, pas besoin de reformater le tableau, puisque labels renverra un vecteur colonne de dimension 60 000 x 1. Enfin, la fonction retourne le tableau NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Appelez maintenant la fonction d’extraction des étiquettes en passant les fichiers d’étiquettes d’entraînement et de test ainsi que leur nombre d’images :
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Une fois les jeux d’entraînement et de test chargés, vous pouvez analyser les données pour vous faire une idée de l’ensemble avec lequel vous allez travailler.
Analysons maintenant l’apparence des images du jeu de données et examinons leurs dimensions à l’aide de l’attribut NumPy .shape :
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Comme on le voit ci-dessus, les données d’entraînement ont une forme 60000 x 28 x 28 : 60 000 échantillons, chacun une matrice 28 x 28. De même, les données de test ont une forme 10000 x 28 x 28 pour 10 000 échantillons.
Remarque : dans cette tâche, vous n’utiliserez pas les étiquettes d’entraînement et de test. Vous ne traiterez que les images. Toutefois, à des fins d’exploration, utiles pour mieux comprendre les données, vous utiliserez les étiquettes.
Créons un dictionnaire associant les noms de classes à leurs étiquettes catégorielles :
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Regardons maintenant quelques images du jeu de données :
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
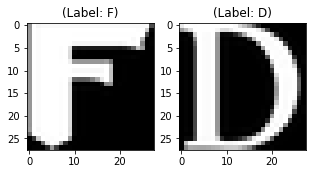
Les deux tracés ci-dessus montrent des exemples issus des ensembles d’entraînement et de test, étiquetés respectivement 5 ou F, d’une part, et 3 ou D, d’autre part. De la même manière, les autres lettres auront des étiquettes différentes, mais les lettres identiques partageront la même étiquette. Par exemple, les 6 000 images de la classe F auront toutes l’étiquette 5.
Les images du jeu de données sont bien en niveaux de gris, avec des valeurs de pixels de 0 à 255 et des dimensions 28 x 28. Avant d’alimenter le modèle, il est essentiel de les prétraiter. Vous allez d’abord convertir chaque image 28 x 28 des ensembles d’entraînement et de test en matrice 28 x 28 x 1, exploitable par le réseau :
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Vérifiez ensuite le type des tableaux NumPy d’entraînement et de test : il doit être en float32. Si ce n’était pas le cas, il faudrait convertir, mais vous l’avez déjà fait lors de la lecture des données. Il faut aussi remettre à l’échelle les pixels dans l’intervalle [0,1]. Allons-y !
N’oubliez pas de vérifier les types des données d’entraînement et de test :
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Redimensionnez maintenant les données d’entraînement et de test avec la valeur maximale des pixels :
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Vérifions que la valeur maximale est bien 1,0 après la remise à l’échelle.
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Après cela, il est important de partitionner les données. Pour bien généraliser, vous allez scinder les données d’entraînement en deux parties : entraînement et validation. Vous entraînerez votre modèle sur 80 % des données et le validerez sur les 20 % restants.
Cela aide aussi à limiter le surapprentissage, puisque vous validez sur des données non vues pendant l’entraînement.
Vous pouvez utiliser le module train_test_split de scikit-learn pour diviser correctement les données :
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Remarque : pour cette tâche, vous n’avez pas besoin des étiquettes. C’est pourquoi vous passez deux fois les images d’entraînement. Elles servent à la fois d’entrée et de vérité terrain, comme les étiquettes en classification.
Vous êtes prêt à définir le réseau et à y injecter les données. Passons à la suite !
Les images ont une taille de 28 x 28 x 1, soit un vecteur de 784 dimensions. Vous convertissez la matrice en tableau, la remettez à l’échelle entre 0 et 1, la reformez en 28 x 28 x 1, puis l’utilisez comme entrée du réseau.
Vous utiliserez une taille de lot de 128. Des tailles plus élevées, 256 ou 512, peuvent aussi convenir : cela dépend de la machine utilisée. La taille de lot influence fortement l’apprentissage et la précision. Vous entraînerez le réseau pendant 50 époques.
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
Comme évoqué, l’autoencodeur se divise en deux parties : un encodeur et un décodeur.
Encodeur
Décodeur
Chaque couche de max-pooling sous-échantillonne l’entrée par un facteur 2, tandis que chaque couche d’upsampling la suréchantillonne par un facteur 2.
Remarque : le nombre de filtres, leur taille, le nombre de couches, le nombre d’époques, etc., sont des hyperparamètres. Fiez-vous à votre intuition, faites des essais en les ajustant et mesurez les performances. C’est ainsi que l’on progresse en deep learning.
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Après avoir créé le modèle, compilez-le avec l’optimiseur RMSProp.
Astuce : regardez ce cours d’Andrew Ng sur RMSProp pour en savoir plus.
Notez que vous devez aussi spécifier la fonction de perte via l’argument loss. Ici, il s’agit de l’erreur quadratique moyenne, calculée pixel par pixel entre la sortie prédite et la vérité terrain :
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualisons les couches créées ci-dessus avec la fonction de résumé, qui indique le nombre de paramètres (poids et biais) par couche et le total du modèle.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Il est temps d’entraîner le modèle avec la fonction fit() de Keras ! L’entraînement dure 50 époques. La fonction fit() renvoie un objet « history » ; en stockant ce résultat dans autoencoder_train, vous pourrez ensuite tracer la courbe de perte d’entraînement et de validation, ce qui aide à analyser visuellement les performances.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
Parfait ! Vous avez entraîné le modèle sur NotMNIST pendant 50 époques. Traçons maintenant les pertes d’entraînement et de validation pour visualiser les performances.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
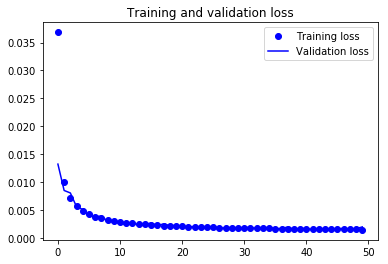
On observe que les pertes de validation et d’entraînement évoluent de concert. Votre modèle ne surapprend pas : la perte de validation diminue et l’écart avec la perte d’entraînement est faible.
On peut donc dire que la capacité de généralisation du modèle est bonne.
Enfin, il est temps de reconstruire les images de test avec la fonction predict() de Keras et de voir à quel point le modèle s’en sort sur les données de test.
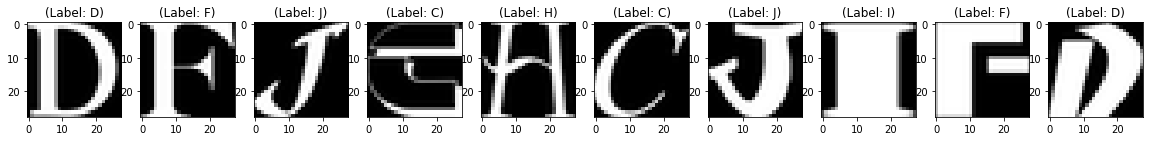
Vous allez prédire sur l’ensemble des 10 000 images de test et tracer quelques reconstructions pour visualiser la qualité des résultats.
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
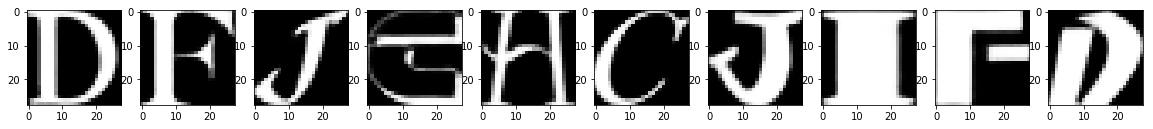
À la lecture de ces figures, on constate que le modèle reconstruit très bien les images de test. Visuellement, les originaux et leurs reconstructions sont presque identiques.
Un autoencodeur de débruitage apprend une représentation (espace latent ou goulot) robuste au bruit. Vous ajoutez du bruit à une image, puis vous alimentez l’encodeur du réseau avec cette image bruitée. L’encodeur transforme l’image dans un espace qui tente de préserver la lettre tout en retirant le bruit.
Mais comment supprime-t-il exactement le bruit ?
Pendant l’entraînement, vous définissez une fonction de perte, similaire à l’erreur quadratique moyenne utilisée plus haut pour l’autoencodeur convolutionnel. À chaque itération, le réseau calcule la perte entre l’image bruitée produite par le décodeur et la vérité terrain (image non bruitée), puis tente de la minimiser. En d’autres termes, le réseau apprend un espace 7 x 7 x 128 où les encodages sont débarrassés du bruit pour les données sur lesquelles vous l’entraînez.
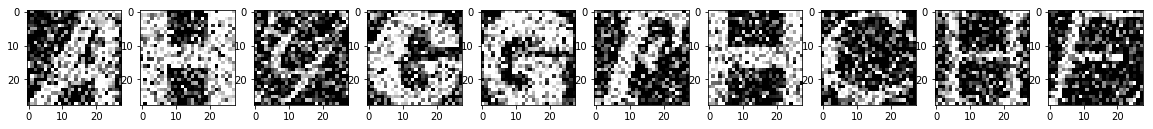
Pour voir cela en Python, vous réutiliserez le même jeu de données NotMNIST que dans la première partie. Vous n’avez donc pas de prétraitements supplémentaires à refaire ! Toutefois, une étape importante ici consiste à ajouter du bruit aux images d’entraînement, de validation et de test. Commençons par là.
Définissons d’abord un facteur de bruit, hyperparamètre qui multiplie une matrice aléatoire de moyenne 0,0 et d’écart type 1,0. Cette matrice est échantillonnée selon une loi normale (gaussienne). Sa forme doit correspondre à celle des données auxquelles vous ajoutez le bruit.
Par exemple : la variable train_X a une forme 48000 x 28 x 28 x 1. Le tableau aléatoire normal doit donc avoir la même forme pour pouvoir être additionné élément par élément.
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip() tronque toutes les valeurs négatives à zéro et toutes celles supérieures à un à un, afin de conserver des pixels entre 0 et 1. Comme l’ajout de bruit peut élargir la plage de valeurs, il est prudent de clipper les pixels.
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
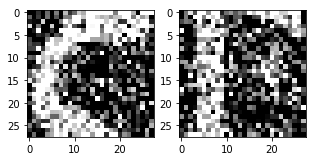
Maintenant que vous disposez des données bruitées, vous pouvez les passer dans le réseau et observer comment le bruit est « magiquement » retiré des images.
Comme évoqué, l’autoencodeur se compose d’un encodeur et d’un décodeur. L’architecture que vous allez construire ressemble à ceci :
Encodeur
Décodeur
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Souvenez-vous : pour l’autoencodeur convolutionnel, vous passiez deux fois les images d’entraînement, car l’entrée et la vérité terrain étaient identiques. Dans l’autoencodeur de débruitage, vous fournissez les images bruitées en entrée, tandis que la vérité terrain reste les images non bruitées. Le réseau peut ainsi calculer la perte entre l’image bruitée et l’image de référence.
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
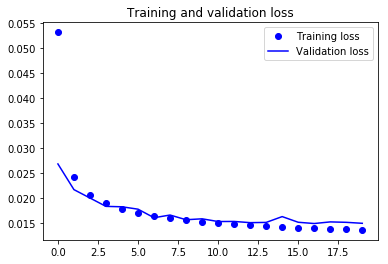
À la lecture de cette courbe, on peut penser que le modèle surapprend à certaines époques tout en restant globalement aligné le reste du temps. Vous pouvez tenter d’améliorer ses performances en ajoutant un peu de complexité, afin de réduire davantage la perte, et/ou en l’entraînant plus longtemps.
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
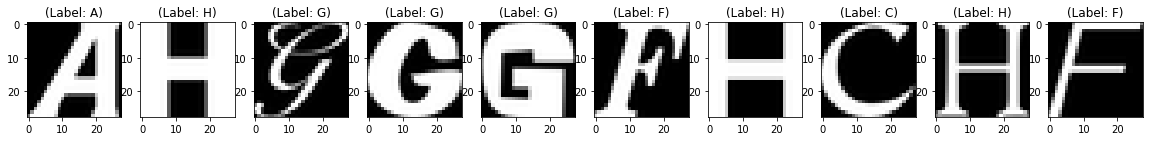
Test Images with Noise
Reconstruction of Noisy Test Images
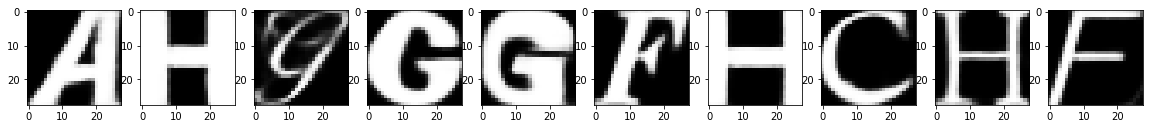
On dirait que, en seulement 20 époques, une architecture relativement simple s’en sort déjà très bien pour supprimer le bruit des images de test, n’est-ce pas ?
Ce tutoriel constitue une excellente introduction, à la fois théorique et pratique, aux autoencodeurs. Si vous avez pu suivre sans difficulté — ou même avec un peu d’effort — bravo ! Découvrez le tutoriel Keras Tutorial: Deep Learning in Python de DataCamp et le cours Introduction to Deep Learning in Python.
Dans le prochain tutoriel, vous apprendrez à lire des images « from scratch », à les analyser, les prétraiter et les injecter dans un modèle à l’aide d’un jeu d’empreintes digitales. Vous verrez aussi comment lire des images médicales en modalité T-1 et les reconstruire avec un autoencodeur.
Il reste encore beaucoup à explorer : pourquoi ne pas suivre le cours Deep Learning in Python de DataCamp si ce n’est pas déjà fait ? Vous partirez des bases et progresserez jusqu’à maîtriser le deep learning : une ressource incontournable pour travailler avec des réseaux de neurones convolutionnels en Python, détecter des visages, des objets, etc.
En savoir plus sur Python et Keras
Cours
Cours
Cours
Tutoriel
Satyabrata Pal
15 min
Tutoriel
Sejal Jaiswal
9 min
Tutoriel
Aditya Sharma
5 min
Tutoriel
DataCamp Team
5 min
Tutoriel
Sejal Jaiswal
24 min
Tutoriel
DataCamp Team
4 min


