Curso
Comprender el machine learning
2 h
308K
En machine learning, seguramente te hayas topado con el término sobreajuste. El sobreajuste es un fenómeno en el que un modelo de machine learning se ajusta demasiado bien a los datos de entrenamiento, pero no rinde igual de bien en los datos de prueba. Lograr un buen rendimiento en los datos de prueba es casi una condición indispensable en machine learning.
Existen varias técnicas que ayudan a evitar el sobreajuste. La regularización es una de ellas, y este artículo se centra por completo en explicarla. Intentaré explicar la regularización con poca matemática y mucha intuición. A diferencia de otros tutoriales, aquí no veremos un caso práctico. Antes de ponernos con uno, quiero que entiendas la importancia y los matices de la regularización. Porque la regularización es delicada, pero es una técnica muy importante que debes dominar como data scientist.
La estructura de este artículo es la siguiente:
Antes de explicar el sobreajuste, hablemos un momento de la generalización en machine learning.
La generalización es la capacidad de un modelo de aplicar a ejemplos nuevos (no vistos durante el entrenamiento; es decir, el conjunto de prueba) los conceptos que aprendió.
El objetivo de un buen modelo de machine learning es generalizar bien desde los datos de entrenamiento a cualquier dato del dominio del problema. Así podrás hacer predicciones en el futuro sobre datos que el modelo nunca ha visto.
Cito de la introducción: «El sobreajuste es un fenómeno en el que un modelo de machine learning se ajusta demasiado bien a los datos de entrenamiento, pero no rinde bien en los datos de prueba.»
El sobreajuste ocurre cuando un modelo aprende los detalles y el ruido del conjunto de entrenamiento hasta el punto de perjudicar su rendimiento en datos no vistos. Es decir, el modelo recoge y aprende como si fueran conceptos válidos las fluctuaciones aleatorias del entrenamiento. El problema es que esos «conceptos» no aplican a datos nuevos y perjudican la capacidad de generalización del modelo.
El sobreajuste es más probable en modelos no paramétricos y no lineales, que tienen más flexibilidad al aprender la función objetivo. Por ello, muchos algoritmos no paramétricos incluyen parámetros o técnicas para limitar y acotar cuánto detalle aprende el modelo.
Por ejemplo, los árboles de decisión son algoritmos no paramétricos muy flexibles y propensos al sobreajuste. Este problema puede abordarse podando el árbol tras el entrenamiento para eliminar parte del detalle que ha capturado. En cambio, el subajuste describe un modelo que no es capaz ni de ajustar los datos de entrenamiento ni de generalizar a datos nuevos.
Si oyes «regularización» fuera del contexto de machine learning, pensarás en el proceso de «regularizar» algo. ¿Qué es ese «algo» aquí? En machine learning hablamos de algoritmos o modelos; y lo que hay dentro de ellos es el conjunto de parámetros. En resumen, la regularización en machine learning es el proceso de regularizar los parámetros: imponerles restricciones o encoger las estimaciones de los coeficientes hacia cero. En otras palabras, esta técnica desincentiva aprender modelos demasiado complejos o flexibles y así evita el riesgo de sobreajuste.
Ahora ya estás más cerca de entender cómo ayuda la regularización a prevenir el sobreajuste. Vamos a ello.
Si la regularización consiste en regularizar los parámetros, quizá te preguntes: ¿por qué ayuda eso a evitar el sobreajuste? Observa el siguiente gráfico:
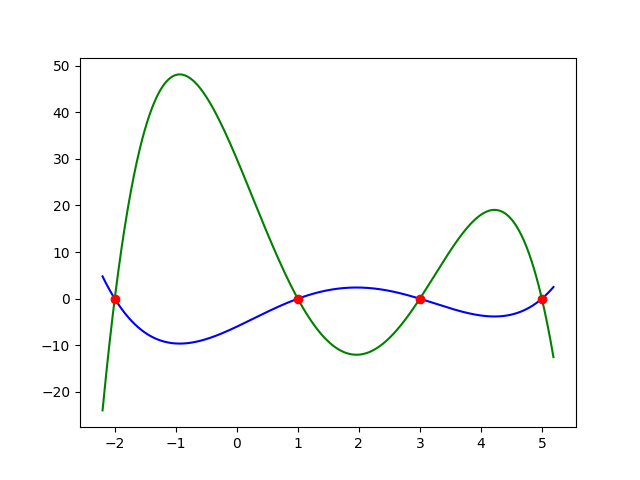
Como ves, hay dos funciones representadas por una curva verde y una azul. Ambas ajustan tan bien a los puntos rojos que podemos considerar que el error es prácticamente cero. Siguiendo la intuición sobre el sobreajuste, quizá hayas adivinado que la curva verde es la que sobreajusta. ¡Correcto! Pero ¿te has preguntado por qué la curva verde (o cualquier curva similar) sobreajusta los datos?
Para entenderlo con un poco más de matemática, supongamos que las funciones usadas para trazar el gráfico son:
La curva verde:

La curva roja:
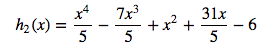
Si miras las ecuaciones, verás que la curva verde tiene coeficientes más grandes; y esa es la causa principal del sobreajuste. Como decíamos, el sobreajuste implica que el modelo encaja tan bien el conjunto de datos que parece memorizar lo que le hemos mostrado en lugar de aprender patrones generales. Intuitivamente, tener coeficientes grandes puede interpretarse como una señal de «memorización» de los datos. Por ejemplo, si tu conjunto de entrenamiento contiene ruido, con valores muy alejados del resto, ese ruido puede empujar al modelo a dar más peso a coeficientes de mayor grado, y el resultado es un modelo que sobreajusta los datos de entrenamiento.
A menudo, en problemas de data science, al aumentar el número de variables un modelo puede ajustar mejor los datos. Pero todo tiene su contrapartida: si añades demasiadas variables, pagarás el precio del sobreajuste. Puede que pienses: si añadir muchas variables causa sobreajuste, ¿por qué no dejamos de añadirlas cuando el modelo ya es aceptable? Pero imagina que tu cliente o tu responsable te pide un 95% de acierto y no lo alcanzas sin añadir más variables, lo que te lleva a sobreajustar. ¿Qué harías entonces?
O al revés: te enfrentas a un problema con un conjunto de datos grande, con muchas variables, y no sabes cuáles descartar; peor aún, puede que todas aporten información, de modo que eliminar algunas empeore el rendimiento del algoritmo. ¿Qué plan sigues?
La respuesta es la regularización.
No siempre es buena idea eliminar variables para evitar el sobreajuste. Y como has visto arriba, hace falta analizar bien si realmente puedes quitar las menos informativas. Por eso, una buena práctica es usar todas las variables para construir tu primer modelo. Ahí entra en juego la regularización. Para verlo claro, empecemos por la función de coste MSE (MSE: error cuadrático medio):
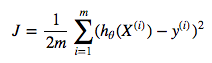
donde:
En modelos como la regresión logística, el objetivo del aprendizaje es minimizar esta función MSE. Es decir, los parámetros pueden actualizarse como sea con tal de reducir el MSE. Y, como ya comentábamos, cuanto más grandes se vuelven los parámetros, mayor es el riesgo de sobreajuste. Entonces, ¿podemos no solo minimizar la función de coste, sino también restringir que los parámetros crezcan demasiado? La respuesta es: SÍ, añadiendo un término de regularización como este:
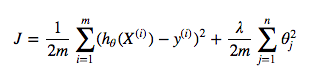
donde:
Fíjate en la nueva función de coste tras añadir el término de regularización. Este término penaliza los parámetros grandes. Minimizar la función de coste implica reducir ambos términos de la derecha: el MSE y el de regularización. Así, cada vez que un parámetro crece demasiado, el término de regularización aumenta el valor de la función de coste; como consecuencia, ese parámetro será penalizado y se actualizará hacia un valor menor.
Lo dejamos aquí. Puede que el artículo no sea largo, pero contiene lo suficiente para que revises y consolides conceptos. Cuando te sientas cómodo con la intuición que has construido, los siguientes pasos serían:
Si quieres seguir aprendiendo sobre machine learning, echa un vistazo a estos cursos de DataCamp:
Cursos de machine learning
Curso
Curso
Curso
blog
Moez Ali
8 min
blog
Zoumana Keita
14 min
blog
Matt Crabtree
14 min
blog
Abid Ali Awan
7 min
Tutorial
Kurtis Pykes
8 min
Tutorial
Avinash Navlani
10 min