Kurs
Machine Learning verstehen
2 Std.
308K
Im Machine Learning bist du sicher schon auf den Begriff Overfitting gestoßen. Overfitting beschreibt den Fall, dass ein Modell die Trainingsdaten zu gut abbildet, auf Testdaten jedoch schwach abschneidet. Eine gute Performance auf Testdaten ist im Machine Learning so etwas wie die Grundbedingung.
Es gibt etliche Techniken, die Overfitting entgegenwirken. Regularisierung ist eine davon – und um sie geht es hier. Ich erkläre Regularisierung mit wenig Mathe, dafür mit viel Intuition. Anders als in meinen anderen Tutorials gibt es diesmal keine Fallstudie. Bevor wir in Anwendungsfälle einsteigen, sollst du die Bedeutung und Feinheiten der Regularisierung verstehen. Denn Regularisierung ist knifflig, aber für Data Scientists extrem wichtig.
Dieser Beitrag ist wie folgt aufgebaut:
Bevor wir Overfitting erklären, kurz zur Generalisierung im Machine Learning.
Generalisierung beschreibt, wie gut die vom Modell gelernten Konzepte auf neue, beim Lernen nicht gesehene Beispiele (das Testset) übertragen.
Das Ziel eines guten Modells ist, vom Training auf beliebige Daten aus demselben Problemfeld gut zu generalisieren. So kannst du künftig Vorhersagen für Daten treffen, die das Modell noch nie gesehen hat.
Zur Erinnerung aus der Einleitung: „Overfitting ist ein Phänomen, bei dem ein Modell die Trainingsdaten zu gut abbildet, aber auf Testdaten schlecht performt.“
Overfitting tritt auf, wenn ein Modell Details und Rauschen der Trainingsdaten so stark lernt, dass die Leistung auf neuen Daten leidet. Das Modell interpretiert Zufallsschwankungen als Muster – diese gelten jedoch nicht für neue Daten und schaden der Generalisierung.
Overfitting ist häufiger bei nichtparametrischen, nichtlinearen Modellen, die sehr flexibel sind. Deshalb enthalten viele dieser Algorithmen Mechanismen oder Parameter, die den Detailgrad begrenzen.
Beispiel: Entscheidungsbäume sind sehr flexibel und neigen dazu, Trainingsdaten zu überanpassen. Abhilfe schafft das Beschneiden (Pruning) nach dem Training, um überflüssige Details zu entfernen. Das Gegenstück ist Underfitting: Ein Modell bildet weder die Trainingsdaten gut ab noch generalisiert es.
Hörst du den Begriff Regularisierung unabhängig von Machine Learning, denkst du an „etwas regulären“. Im ML-Kontext geht es um Lernalgorithmen bzw. Modelle – also um ihre Parameter. Kurz gesagt: Regularisierung bedeutet, die Parameter eines Modells zu begrenzen bzw. ihre Koeffizienten in Richtung Null zu schrumpfen. So wird das Lernen sehr komplexer, zu flexibler Modelle unattraktiv gemacht – und das Risiko von Overfitting sinkt.
Wie genau hilft Regularisierung, Overfitting zu vermeiden? Schauen wir uns das an.
Wenn Regularisierung die Parameter begrenzt, stellt sich die Frage: Warum verhindert das Overfitting? Betrachte die folgende Grafik:
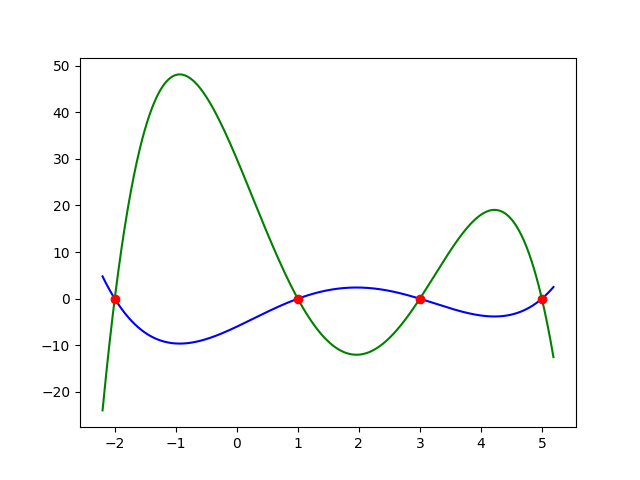
Die Grafik zeigt zwei Funktionen: eine grüne und eine blaue Kurve. Beide passen die roten Punkte so gut an, dass die Fehlerrate praktisch null ist. Aus dem Overfitting-Verständnis heraus ahnst du: Die grüne Kurve überpasst. Genau! Aber warum überpasst die grüne (oder ähnliche) Kurve?
Betrachten wir zwei Beispiel-Funktionen, mit denen die obige Grafik gezeichnet wurde:
Die grüne Kurve:

Die rote Kurve:
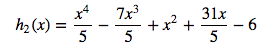
In den Gleichungen siehst du: Die grüne Kurve hat größere Koeffizienten – das ist der Hauptgrund für Overfitting. Overfitting bedeutet letztlich, dass dein Modell die gezeigten Daten auswendig lernt statt generalisierbare Muster zu erfassen. Große Koeffizienten sind ein Indiz fürs Memorieren. Enthält dein Trainingsset z. B. Ausreißer, ziehen sie höhergradige Terme stark nach oben – das Modell überpasst.
In Data-Science-Problemen gilt oft: Mit mehr Features kann ein Modell die Daten besser anpassen. Der Haken: Zu viele Features führen häufig zu Overfitting. Du könntest nun sagen: Dann hören wir einfach früher auf. Aber was, wenn Kundinnen oder Chefs 95% Genauigkeit verlangen, die ohne weitere Features nicht erreichbar ist – und die Erweiterung zum Overfitting führt?
Oder du bekommst einen großen Datensatz mit sehr vielen Features. Du weißt nicht, was du weglassen kannst – und möglicherweise ist jedes Feature informativ, sodass Weglassen die Performance verschlechtert. Was tust du dann?
Die Antwort lautet: Regularisierung.
Es ist also nicht immer sinnvoll, Features zu streichen. Wie im Beispiel gesehen, braucht es Analyse, um wenig informative Merkmale sicher zu entfernen. Oft ist es besser, zunächst alle Features zu nutzen – und Regularisierung als Lösung einzusetzen. Dazu schauen wir uns zuerst die MSE-Kostenfunktion an (MSE: Mean Squared Error):
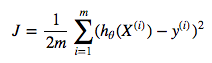
wobei
In Modellen wie der Logistischen Regression besteht das Lernziel darin, die MSE zu minimieren. Die Parameter können sich also so verändern, dass der MSE-Wert sinkt. Wie oben erwähnt, steigt mit der Größe der Parameter jedoch die Gefahr des Overfittings. Kannst du also nicht nur die Kosten minimieren, sondern zugleich große Parameterwerte verhindern? Ja – indem du einen Regularisierungsterm hinzufügst:
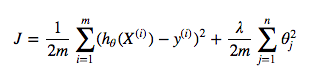
wobei
Betrachte die neue Kostenfunktion: Der Regularisierungsterm bestraft große Parameter. Die Minimierung umfasst nun zwei Ziele: den MSE-Teil und den Regularisierungsteil zu verringern. Wird ein Parameter sehr groß, steigt die Kostenfunktion über den Regularisierungsterm – der Parameter wird also „bestraft“ und wieder nach unten angepasst.
Hier machen wir einen Punkt. Der Beitrag ist kurz, aber ausreichend, um die Kernidee zu verinnerlichen. Wenn du dich mit der hier vermittelten Intuition sicher fühlst, sind die nächsten Schritte:
Wenn du mehr über Machine Learning lernen möchtest, schau dir diese DataCamp-Kurse an:
Machine-Learning-Kurse
Kurs
Kurs
Kurs