Cours
Comprendre le Machine Learning
2 h
308.2K
En machine learning, vous avez forcément croisé le terme surapprentissage (overfitting). Le surapprentissage décrit un modèle qui s’adapte trop bien aux données d’entraînement mais échoue à bien performer sur les données de test. Obtenir de bonnes performances sur les données de test est un impératif en machine learning.
Il existe de nombreuses techniques pour prévenir le surapprentissage. La régularisation en fait partie. Et cet article lui est consacré. Je vais expliquer la régularisation avec peu de formules et davantage d’intuition. Contrairement à d’autres tutoriels, il n’inclut pas d’étude de cas. Avant d’y plonger, je souhaite que vous compreniez l’importance et les subtilités de la régularisation. Car la régularisation est délicate, mais c’est une technique essentielle à maîtriser pour tout Data Scientist.
Plan de l’article :
Avant d’expliquer le surapprentissage, parlons un instant de la généralisation en machine learning.
La généralisation désigne la capacité d’un modèle à appliquer ce qu’il a appris à des exemples qu’il n’a pas vus pendant l’entraînement (le jeu de test).
L’objectif d’un bon modèle de machine learning est de bien généraliser des données d’entraînement vers toute donnée du même domaine. Cela vous permet de faire des prédictions sur des données que le modèle n’a jamais vues.
Pour reprendre l’introduction : « Le surapprentissage décrit un modèle qui s’adapte trop bien aux données d’entraînement mais échoue sur les données de test. »
Le surapprentissage survient lorsqu’un modèle apprend les détails et le bruit des données d’entraînement au point de nuire à ses performances sur des données inédites. Autrement dit, le modèle assimile le bruit ou les fluctuations aléatoires comme s’il s’agissait de concepts utiles. Problème : ces « concepts » ne s’appliquent pas aux nouvelles données et dégradent la capacité de généralisation.
Le surapprentissage est plus probable avec des modèles non paramétriques et non linéaires, plus flexibles pour apprendre la fonction cible. Ainsi, nombre d’algorithmes non paramétriques intègrent des paramètres ou des techniques pour limiter la quantité de détails apprise.
Par exemple, les arbres de décision, algorithme non paramétrique très flexible, sont sujets au surapprentissage. On peut y remédier en élaguant l’arbre après l’apprentissage pour retirer une partie des détails captés. À l’inverse, le sous-apprentissage (underfitting) désigne un modèle qui n’explique ni les données d’entraînement ni les nouvelles données.
Hors contexte machine learning, la régularisation est l’action de « rendre régulier ». Mais que régularise-t-on ? En machine learning, on parle d’algorithmes ou de modèles — et au cœur des modèles se trouvent les paramètres. En bref, la régularisation consiste à contraindre ces paramètres : elle pénalise, encadre ou « rétrécit » les coefficients vers zéro. Autrement dit, elle décourage l’apprentissage de modèles trop complexes ou trop flexibles, réduisant ainsi le risque de surapprentissage.
Voyons maintenant en quoi la régularisation aide concrètement à prévenir le surapprentissage.
Si la régularisation consiste à contrôler les paramètres, pourquoi cela prévient-il le surapprentissage ? Considérons le graphique ci-dessous :
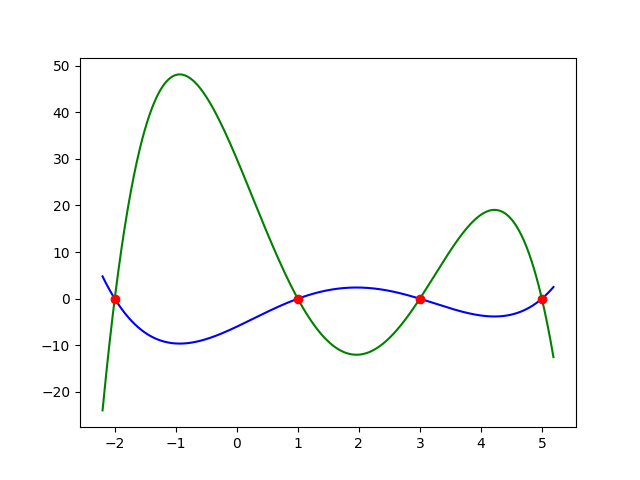
Comme vous le voyez, deux fonctions sont représentées par une courbe verte et une courbe bleue. Toutes deux épousent si bien les points rouges qu’on peut considérer une perte quasi nulle. Intuitivement, la courbe verte est celle qui surapprend. Exact ! Mais pourquoi la courbe verte (ou toute courbe similaire) surapprend-elle ?
Pour l’entrevoir de façon un peu plus mathématique, supposons les deux fonctions qui ont servi à tracer le graphe :
La courbe verte :

La courbe rouge :
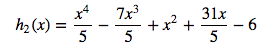
En regardant les équations, on constate que la courbe verte présente des coefficients plus grands — c’est l’une des causes majeures du surapprentissage. Comme évoqué, un modèle qui « colle » trop aux données d’entraînement finit par les mémoriser plutôt que d’en extraire des régularités. Intuitivement, de grands coefficients peuvent révéler cette mémorisation. Par exemple, si votre jeu d’entraînement contient du bruit avec des valeurs atypiques, ce bruit peut pousser le modèle à augmenter le poids des termes de degré élevé, et vous obtenez un modèle qui surapprend !
Souvent en Data Science, plus on ajoute de variables, mieux un modèle semble s’ajuster. Mais il y a un revers : trop de variables conduisent au surapprentissage. Certains diront : si l’ajout de variables cause le surapprentissage, arrêtons d’en ajouter dès que le modèle est acceptable. Mais imaginez que votre client ou votre direction exige 95 % de précision, objectif inatteignable sans ajouter des variables supplémentaires — au risque de surapprendre. Que faire ?
Autre scénario : vous traitez un grand jeu de données riche en variables. Vous ne savez pas lesquelles écarter — et si, pire encore, toutes s’avèrent informatives, en supprimer dégraderait les performances. Quelle stratégie adopter ?
La réponse : la régularisation.
Il n’est donc pas toujours judicieux de supprimer des variables pour prévenir le surapprentissage. Comme l’exemple ci-dessus le suggère, cela exige une analyse poussée pour savoir lesquelles retirer. Une bonne pratique consiste à commencer par utiliser toutes les variables pour bâtir un premier modèle. La régularisation apporte alors une solution. Pour rendre cela concret, examinons la fonction de coût MSE (Mean Squared Error) :
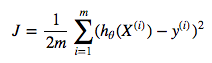
où :
Dans des modèles comme la régression logistique, l’objectif est de minimiser cette fonction MSE. Vos paramètres peuvent donc évoluer librement pour baisser le MSE. Or, plus les paramètres deviennent grands, plus le risque de surapprentissage augmente. La question est donc : peut-on à la fois minimiser la fonction de coût et empêcher les paramètres de devenir trop grands ? Oui, en ajoutant un terme de régularisation :
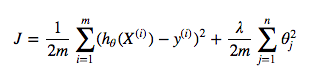
où :
Regardez la nouvelle fonction de coût après ajout du terme de régularisation. Celui-ci pénalise les grands paramètres. Minimiser la fonction de coût revient donc à réduire les deux termes : le MSE et le terme de régularisation. Ainsi, chaque fois qu’un paramètre devient trop grand, le coût augmente via la régularisation ; il est donc pénalisé et réajusté à une valeur plus faible.
Concluons ici. Ce billet est volontairement concis, mais il devrait vous donner de quoi consolider vos intuitions. Une fois à l’aise avec ces notions, les prochaines étapes sont :
Pour aller plus loin en machine learning, explorez ces cours DataCamp :
Cours de machine learning
Cours
Cours
Cours