Curso
Introducción a R
4 h
3.1M
Ejecuta y edita el código de este tutorial en línea
Ejecutar códigoVamos a cubrir tanto las propiedades matemáticas de los métodos como ejemplos prácticos en R, además de algunos trucos y ajustes extra. Sin más, ¡vamos al lío!
Empecemos por lo básico: el modelo de regresión lineal simple, en el que intentas predecir n observaciones de la variable respuesta, Y, con una combinación lineal de m variables predictoras, X, y un término de error con distribución normal y varianza σ2:
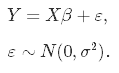
Como no conocemos los parámetros reales, β, tenemos que estimarlos a partir de la muestra. En el enfoque de Mínimos Cuadrados Ordinarios (OLS), se estiman como $\hat\beta$ de forma que la suma de cuadrados de los residuos sea lo más pequeña posible. Es decir, minimizamos la siguiente función de pérdida:
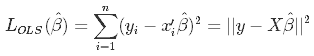
para obtener las conocidas estimaciones OLS, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
En estadística, hay dos características clave de los estimadores: el sesgo y la varianza. El sesgo es la diferencia entre el parámetro poblacional real y el valor esperado del estimador:
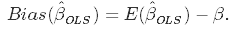
El sesgo mide la precisión de las estimaciones. La varianza, por su parte, mide la dispersión o incertidumbre de esas estimaciones. Viene dada por
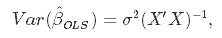
donde la varianza del error desconocida, σ2, puede estimarse a partir de los residuos como
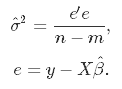
Este gráfico ilustra qué son el sesgo y la varianza. Imagina que la diana es el parámetro poblacional real que estamos estimando, β, y los disparos son los valores de nuestras estimaciones usando cuatro estimadores distintos: con bajo sesgo y varianza, alto sesgo y varianza, y sus combinaciones.
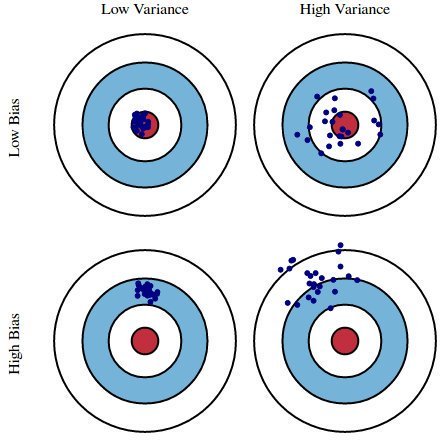
Fuente: kdnuggets.com
Tanto el sesgo como la varianza conviene que sean bajos, porque valores altos empeoran las predicciones del modelo. De hecho, el error del modelo puede descomponerse en tres partes: error por varianza alta, error por sesgo elevado y el resto, la parte no explicable.
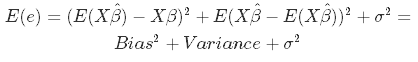
El estimador OLS tiene la virtud de ser insesgado. Sin embargo, puede presentar una varianza enorme. Esto ocurre especialmente cuando:
La solución general es: reducir la varianza a costa de introducir algo de sesgo. Este enfoque se llama regularización y casi siempre mejora el rendimiento predictivo del modelo. Para interiorizarlo, fíjate en el siguiente gráfico.
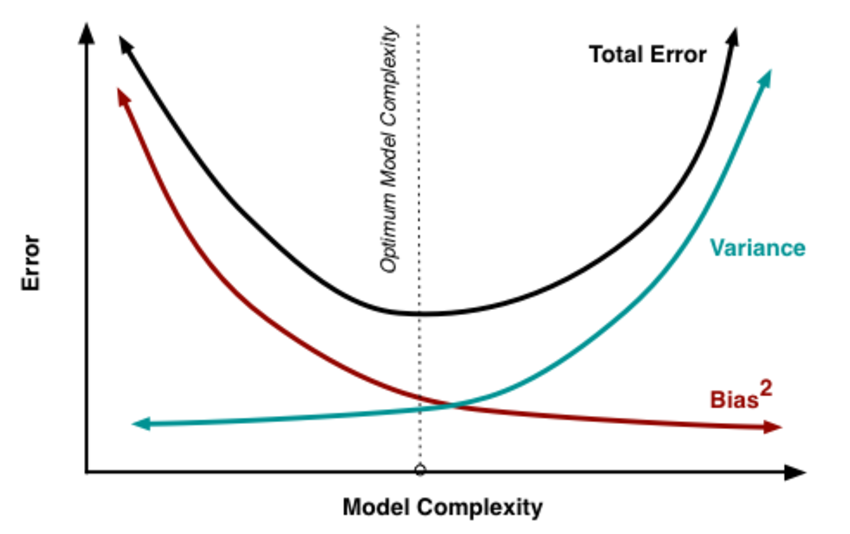
Fuente: researchgate.net
A medida que aumenta la complejidad del modelo, que en regresión lineal puedes entender como el número de predictores, también crece la varianza de las estimaciones, pero el sesgo disminuye. El OLS, al ser insesgado, nos situaría en la parte derecha del gráfico, lejos del óptimo. Por eso regularizamos: para reducir la varianza a cambio de algo de sesgo, moviéndonos hacia la izquierda, hacia el punto óptimo.
Hasta ahora hemos concluido que queremos reducir la complejidad del modelo, es decir, el número de predictores. Podríamos usar selección hacia delante o hacia atrás, pero así perderíamos información sobre el efecto de las variables eliminadas en la respuesta. Quitar predictores equivale a fijar sus coeficientes en cero. En lugar de forzar que sean exactamente cero, penalicemos que se alejen de cero, obligándolos a ser pequeños de forma continua. Así reducimos la complejidad manteniendo todas las variables en el modelo. Básicamente, esto es lo que hace la regresión Ridge.
En la regresión Ridge, ampliamos la función de pérdida OLS para no solo minimizar la suma de cuadrados de los residuos, sino también penalizar el tamaño de los coeficientes, con el fin de encogerlos hacia cero:
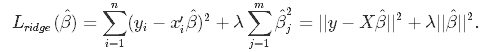
Resolver esto para $\hat\beta$ da las estimaciones de ridge $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, donde I es la matriz identidad.
El parámetro λ es la penalización de regularización. Más adelante veremos cómo elegirlo, pero fíjate en que:
Así que poner λ a 0 equivale a usar OLS, mientras que cuanto mayor sea su valor, más se penaliza el tamaño de los coeficientes.
Incorporar el coeficiente de regularización en las fórmulas de sesgo y varianza nos da
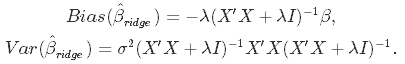
De aquí se ve que a medida que λ crece, la varianza disminuye y el sesgo aumenta. Esto plantea la pregunta: ¿cuánto sesgo estamos dispuestos a aceptar para reducir la varianza? O dicho de otra forma: ¿cuál es el valor óptimo de λ?
Tenemos dos vías para abordar esto. Un enfoque más tradicional es elegir λ minimizando algún criterio de información, como AIC o BIC. Un enfoque más cercano al aprendizaje automático es hacer validación cruzada y seleccionar el valor de λ que minimice la suma de residuos al cuadrado validada (u otra métrica). El primer enfoque prioriza el ajuste del modelo a los datos; el segundo, su rendimiento predictivo. Veamos ambos.
Minimizar criterios de información
Este método consiste en estimar el modelo con muchos valores distintos de λ y elegir el que minimiza el criterio de información de Akaike o Bayesiano:
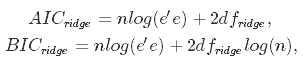
donde dfridge es el número de grados de libertad. ¡Atención aquí! El número de grados de libertad en ridge no es el mismo que en el OLS clásico. Esto se pasa por alto a menudo y conduce a inferencias incorrectas. En OLS y en ridge, los grados de libertad son la traza de la llamada matriz sombrero, que mapea el vector de respuestas al de valores ajustados así: $\hat y = H y$.
En OLS, HOLS = X(X′X)−1X, lo que da dfOLS = trHOLS = m, donde m es el número de predictores. En ridge, en cambio, la matriz sombrero incluye la penalización: Hridge = X(X′X + λI)−1X, lo que da dfridge = trHridge, que ya no es igual a m. Algunos paquetes de ridge calculan los criterios de información con la fórmula de OLS. Para ir sobre seguro, mejor calcúlalos a mano, que es lo que haremos más adelante.
Minimizar los residuos validados
Para elegir λ mediante validación cruzada, escoge un conjunto de P valores de λ a probar, divide el conjunto de datos en K folds y sigue este algoritmo:
Tranquilo, no hace falta programarlo tú: R ya tiene funciones dedicadas.
En R, el paquete glmnet tiene todo lo necesario para implementar ridge. Usaremos el conocido dataset mtcars como ejemplo: la tarea es predecir millas por galón a partir de otras características del coche. Un apunte más: ridge asume que los predictores están estandarizados y la respuesta centrada. Enseguida verás por qué. De momento, estandarizaremos antes de modelar.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)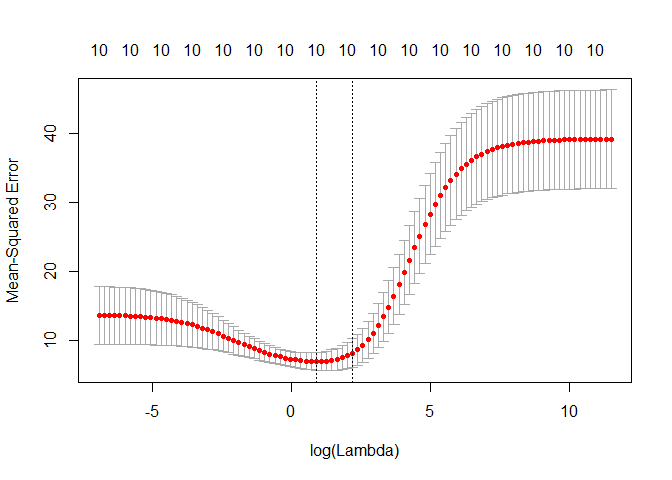
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))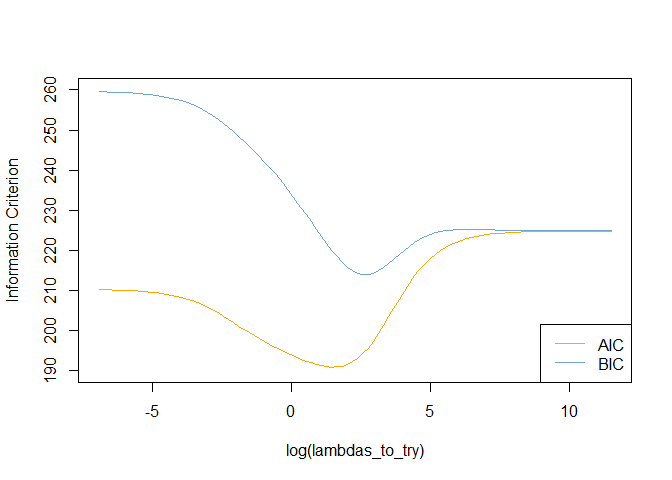
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)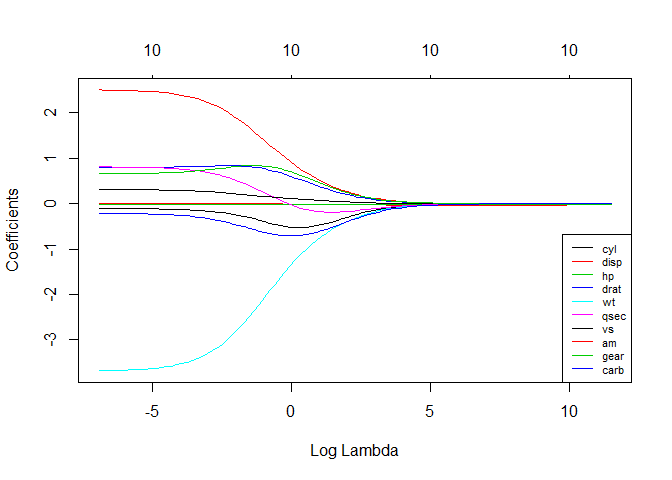
Comenté antes que ridge asume que los predictores están escalados a puntuaciones z. ¿Por qué es necesario? Este escalado asegura que el término de penalización castigue por igual a cada coeficiente, tomando la forma $\lambda \sum_{j=1}^m\hat\beta_j^2$. Si los predictores no están estandarizados, sus desviaciones estándar no son 1, y puede demostrarse que el término de penalización pasa a ser $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$. Así, los coeficientes no estandarizados quedan ponderados por el inverso de la desviación estándar de su predictor. Escalamos la matriz X para evitar esto, pero... En lugar de igualar las varianzas mediante el escalado, ¡podemos usarlas como pesos en la estimación! Esta es la idea detrás de la regresión Ridge ponderada diferencialmente o heterocedástica.
La idea es penalizar distintos coeficientes con distinta intensidad introduciendo pesos en la función de pérdida:
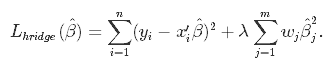
¿Cómo elegir los pesos wj? Ejecuta regresiones univariantes (respuesta vs. un predictor) para todos los predictores, extrae la estimación de la varianza del coeficiente, $\hat\sigma_{j}$, y ¡úsala como peso! De este modo:
Así lo harías en R. Como este método no está implementado en glmnet, necesitaremos un poco de programación.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso, de Least Absolute Shrinkage and Selection Operator, es conceptualmente similar a ridge. También añade una penalización por coeficientes distintos de cero, pero, a diferencia de ridge que penaliza la suma de cuadrados de los coeficientes (penalización L2), lasso penaliza la suma de sus valores absolutos (penalización L1). Como resultado, para valores altos de λ, muchos coeficientes quedan exactamente en cero con lasso, algo que no ocurre con ridge.
La única diferencia entre las funciones de pérdida de ridge y lasso está en el término de penalización. Con lasso, la pérdida se define como:
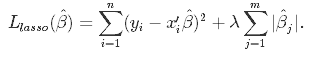
Para ejecutar una regresión Lasso puedes reutilizar la función glmnet(), pero con el parámetro alpha igual a 1.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)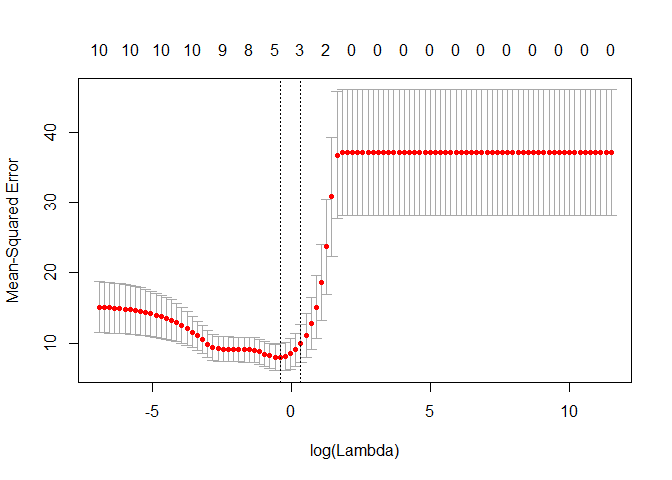
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)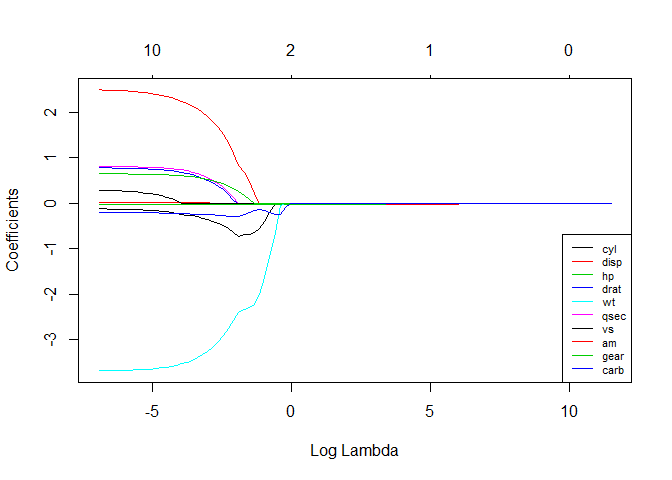
¡Comparemos el R-cuadrado múltiple de los distintos modelos que hemos estimado!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Parecen rendir de forma similar en estos datos. Recuerda que el modelo heterocedástico no está ajustado y la lambda no es óptima. Algunas consideraciones generales sobre ridge y lasso:
Elastic Net surgió como respuesta a la crítica a lasso, cuya selección de variables puede depender demasiado de los datos y ser inestable. La solución es combinar las penalizaciones de ridge y lasso para aprovechar lo mejor de ambos. Elastic Net busca minimizar la siguiente función de pérdida:
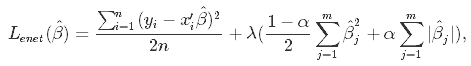
donde α es el parámetro de mezcla entre ridge (α = 0) y lasso (α = 1).
Ahora hay dos parámetros que ajustar: λ y α. El paquete glmnet permite ajustar λ mediante validación cruzada para un &alpha fijo, pero no ajusta α, así que recurriremos a caret para esta tarea.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2¡Enhorabuena! Si has llegado hasta aquí, ya sabes que:
Si quieres aprender más sobre regresión en R, haz el curso Supervised Learning in R: Regression de DataCamp. También puedes ver nuestros tutoriales de Linear Regression in R y Logistic Regression in R.
Cursos de R
Curso
Curso
Curso
Tutorial
DataCamp Team
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Kurtis Pykes
8 min
Tutorial
Vidhi Chugh
14 min
Tutorial
DataCamp Team
2 min


