Curso
Entendendo Machine Learning
2 h
308K
Em machine learning, você provavelmente já se deparou com o termo overfitting. Overfitting é o fenômeno em que um modelo aprende muito bem os dados de treino, mas não consegue manter um bom desempenho nos dados de teste. Ter um desempenho suficientemente bom nos dados de teste é visto como essencial em machine learning.
Existem várias técnicas que ajudam a evitar overfitting. Regularização é uma delas — e este post é todo sobre isso. Aqui, vou explicar regularização com menos matemática e mais intuição. Diferente de outros tutoriais, não há estudo de caso. Antes de partir para exemplos práticos, quero que você entenda a importância e as sutilezas da regularização. Ela é traiçoeira, mas é uma técnica muito importante para quem trabalha com dados.
Veja como o post está organizado:
Antes de falar de overfitting, vamos falar um pouco sobre generalização em machine learning.
Generalização é o quão bem os conceitos aprendidos por um modelo se aplicam a exemplos que ele não viu durante o treinamento (ou seja, o conjunto de teste).
O objetivo de um bom modelo é generalizar bem dos dados de treino para qualquer dado do mesmo domínio. Isso permite fazer previsões no futuro com dados que o modelo nunca viu.
Reforçando a definição da introdução: “overfitting é quando um modelo aprende demais os dados de treino, mas não vai bem nos dados de teste.”
Overfitting acontece quando o modelo aprende detalhes e ruídos do conjunto de treino a ponto de prejudicar seu desempenho em dados não vistos. Ou seja, o ruído ou as flutuações aleatórias do treino são capturados como se fossem conceitos válidos. O problema é que esses “conceitos” não se aplicam a novos dados e atrapalham a capacidade de generalização do modelo.
Overfitting é mais comum em modelos não paramétricos e não lineares, que têm mais flexibilidade para aprender a função alvo. Por isso, muitos algoritmos não paramétricos trazem parâmetros ou técnicas para limitar e restringir o nível de detalhe aprendido.
Por exemplo, árvores de decisão são algoritmos não paramétricos muito flexíveis e suscetíveis a overfitting nos dados de treino. Esse problema pode ser tratado com poda da árvore após o aprendizado, removendo parte do excesso de detalhe. Por outro lado, o underfitting acontece quando o modelo não consegue representar nem os dados de treino nem generalizar para novos dados.
Quando você ouve “regularização” fora do contexto, entende que é o processo de tornar algo mais regular. Em machine learning, esse “algo” são os parâmetros dos modelos. Em resumo, regularização é o processo de regularizar os parâmetros, restringindo-os ou encolhendo os coeficientes em direção a zero. Em outras palavras, a técnica desestimula modelos muito complexos ou flexíveis, reduzindo o risco de overfitting.
Agora vamos direto ao ponto: como a regularização ajuda a evitar overfitting?
Se regularização serve para regularizar os parâmetros, por que isso ajuda? Considere o gráfico abaixo:
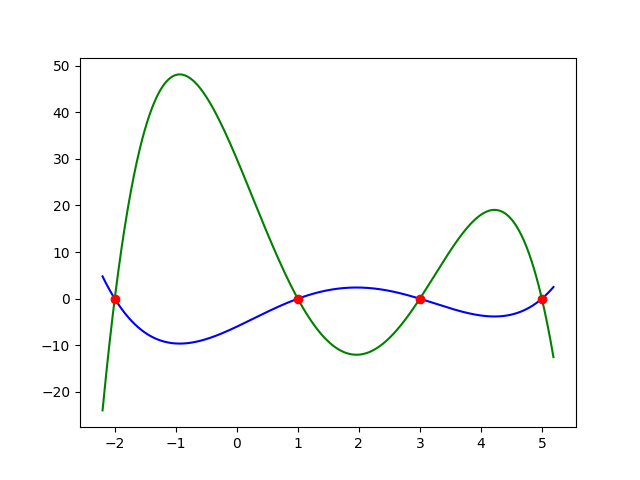
No gráfico, há duas funções representadas pelas curvas verde e azul. Ambas ajustam muito bem os pontos vermelhos, a ponto de praticamente terem perda zero. Pela intuição de overfitting, você deve ter suposto que a curva verde é a que sofre overfitting. Exato! Mas por que a curva verde (ou curvas semelhantes) está fazendo overfitting?
Para entender de forma um pouco mais matemática, vamos supor as duas funções usadas para desenhar o gráfico acima:
A curva verde:

A curva vermelha:
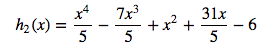
Observando as equações, a curva verde tem coeficientes maiores, e isso é a principal causa do overfitting. Como dito, overfitting pode ser interpretado como um ajuste tão bom ao conjunto de treino que o modelo parece memorizar os dados em vez de aprender padrões gerais. Intuitivamente, coeficientes grandes são um indício dessa memorizacão. Por exemplo, se houver ruídos no seu conjunto de treino, com valores de magnitude bem diferentes do restante, esses ruídos podem levar o modelo a dar mais peso a coeficientes de ordem mais alta — resultado: um modelo que faz overfitting aos dados de treino.
Muitas vezes, em problemas de Data Science, ao aumentar o número de features, um modelo consegue ajustar bem seus dados. Mas tudo tem um limite: se você incluir features demais, paga o preço em overfitting. Talvez você pense: se adicionar muitas features causa overfitting, por que não parar quando o modelo já está aceitável? Agora imagine que seu cliente ou gestor exige 95% de acurácia, e você só chega lá adicionando mais features — o que provoca overfitting. O que fazer?
Outra situação: você recebe um dataset grande, com muitas features. Você não sabe quais descartar e, pior, descobre que todas têm informação relevante. Remover algumas pode prejudicar o desempenho. Qual é o plano?
A resposta é regularização.
Portanto, nem sempre é uma boa ideia descartar features para evitar overfitting. Como vimos, isso exige uma análise cuidadosa. Na prática, é comum usar todas as features para construir o primeiro modelo. E é aqui que a regularização entra como solução. Para clarear, veja a função de custo MSE (Mean Squared Error):
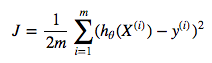
onde:
Em modelos como logistic regression, o objetivo é minimizar essa função MSE. Isso significa que os parâmetros podem ser atualizados de qualquer forma que reduza o MSE. E, como vimos, parâmetros muito grandes aumentam a chance de overfitting. Então, dá para minimizar o custo e ao mesmo tempo evitar que os parâmetros cresçam demais? A resposta é: SIM. Basta adicionar um termo de regularização, assim:
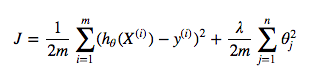
onde:
Observe a nova função de custo com o termo de regularização. Esse termo penaliza parâmetros grandes. Minimizar o custo agora envolve reduzir tanto o MSE quanto o termo de regularização. Assim, sempre que algum parâmetro crescer demais, o valor do custo sobe por causa da penalização, levando o algoritmo a ajustá-lo para baixo.
Vou encerrar por aqui. O post não é longo, mas traz base suficiente para você revisar e praticar. Quando estiver confiante com a intuição, os próximos passos são:
Se quiser aprender mais sobre machine learning, confira estes cursos da DataCamp:
Cursos de machine learning
Curso
Curso
Curso
blog
Abid Ali Awan
5 min
Tutorial
Avinash Navlani
10 min
Tutorial
DataCamp Team
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
11 min