

Comment accéder à DeepSeek R1 et V3 via API
Pour accéder aux modèles DeepSeek via API :
- Obtenez une clé API : créez un compte sur la plateforme API DeepSeek et générez votre clé.
- Utilisez le SDK OpenAI (Software Development Kit) : configurez votre code pour vous connecter à l'API DeepSeek via le SDK d'OpenAI avec les bons réglages. Un SDK est un ensemble d'outils, de bibliothèques, de documentation et d'exemples de code qui facilitent le développement d'applications pour une plateforme, un framework ou une API donnés. Un SDK d'API (comme le SDK OpenAI) fournit des fonctions prêtes à l'emploi pour simplifier les appels d'API, évitant aux développeurs de tout coder à partir de zéro.
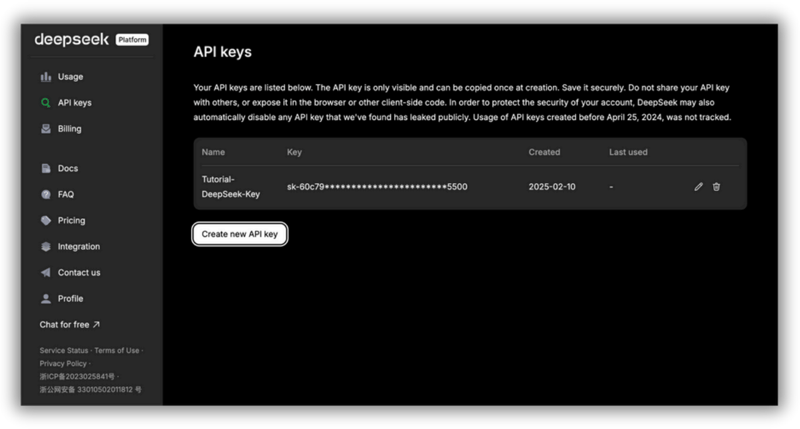
Page de gestion des clés API sur la plateforme DeepSeek. Vous pouvez y générer et gérer vos clés d'accès aux services d'IA de DeepSeek. La clé API n'est visible qu'à la création et doit être stockée en sécurité ; la partager publiquement entraîne des risques de sécurité.
Pour utiliser DeepSeek-V3, définissez model='deepseek-chat' et pour utiliser DeepSeek-R1, définissez model='deepseek-reasoner'.
Voici comment utiliser le SDK OpenAI pour accéder à l'API DeepSeek :
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
model="deepseek-chat",
messages=[
{"role": "system", "content": "You are a helpful assistant"},
{"role": "user", "content": "Hello"},
],
stream=False
)
print(response.choices[0].message.content)Voyons de plus près ce que fait ce code.
L'objectif est d'envoyer un message de chat au modèle DeepSeek et d'afficher sa réponse.
D'abord, from openai import OpenAI importe la classe OpenAI de la bibliothèque openai.
Ensuite, client = OpenAI(...) crée un client OpenAI. Ce client est votre connexion à l'API DeepSeek. Il est configuré avec votre clé API (authentification) et l'URL de base de l'API DeepSeek.
Important : remplacez <DeepSeek API Key> par votre clé API DeepSeek réelle !
La variable response est celle qui envoie votre message au modèle DeepSeek et récupère la réponse. client.chat.completions.create(...) appelle l'API DeepSeek pour obtenir la réponse du modèle.
Regardons messages=[...], la partie qui définit l'historique de conversation :
- Message système : {"role": "system", "content": "You are a helpful assistant"} : cela fixe le comportement du modèle, en lui demandant d'agir en assistant serviable.
- Message utilisateur : {"role": "user", "content": "Hello"} : c'est la requête (votre prompt) à laquelle l'IA doit répondre ("Hello").
Notez que dans cet exemple, nous utilisons DeepSeek-V3 car nous avons défini model='deepseek-chat', mais vous pouvez utiliser DeepSeek-R1 en passant model='deepseek-reasoner'.
Le paramètre stream=False signifie : "Renvoyez toute la réponse d'un coup". Autrement dit, avec stream=False, le modèle attend d'avoir généré toute la réponse avant de l'envoyer. Utilisez-le si vous souhaitez afficher ou analyser la sortie complète d'un coup.
En revanche, pour des réponses longues, vous devrez parfois patienter avant de recevoir l'affichage. Avec stream=True, le modèle affiche les mots (en fait, des tokens) au fil de leur génération, ce qui vous permet de voir la réponse en temps réel au lieu d'attendre la fin.
Enfin, print(response.choices.message.content) extrait le message du modèle depuis l'objet de réponse et l'affiche dans votre console. L'objet de réponse contient de nombreuses informations, mais l'élément principal est le contenu du message du modèle. L'API peut parfois renvoyer plusieurs réponses possibles (choices) : cette instruction sélectionne la première.
Au moment de la publication, DeepSeek a suspendu l'ajout de nouveaux fonds sur les comptes API car ses serveurs manquent de ressources. Vous ne pouvez donc pas recharger votre solde pour l'instant. Si vous avez déjà des fonds, vous pouvez continuer à utiliser l'API normalement. DeepSeek devrait rétablir les recharges dès que la capacité serveur le permettra ; restez à l'affût des mises à jour !
Gérer les paramètres pour contrôler la sortie et la tarification
L'équipe DeepSeek affirme que ses modèles sont moins chers que la concurrence. Mais vous devez tout de même les utiliser intelligemment pour garder des coûts bas et de bonnes performances. Voici les points clés à connaître et à prendre en compte pour contrôler la sortie et les tarifs.
Choisir le bon modèle
Chaque modèle DeepSeek est conçu pour des usages différents. Le bon choix vous aide à arbitrer entre coût et performance selon vos besoins. Aperçu rapide :
- deepseek-chat (V3) : moins cher, idéal pour le chat général et les conversations.
- deepseek-reasoner (R1) → plus cher, mais excellent pour le raisonnement complexe et les tâches avancées.
Coûts des tokens
Les tokens sont la plus petite unité de texte traitée par le modèle : mot, nombre ou même signe de ponctuation. Le volume de tokens varie selon la langue et la façon dont le modèle segmente le texte.
Conversion approximative caractères → tokens :
- 1 caractère anglais ≈ 0,3 token (une phrase de 100 caractères représente environ 30 tokens).
- 1 caractère chinois ≈ 0,6 token (les caractères chinois portent plus de sens chacun).
Pour une estimation précise, consultez les détails d'usage après votre requête. Comprendre le comptage des tokens aide à gérer les coûts et à optimiser les performances avec les modèles DeepSeek.
Voici les prix pour 1 million de tokens pour chaque modèle DeepSeek (note : tarifs en vigueur à la publication — vérifiez les coûts les plus récents ici) :
|
Modèle |
Longueur de contexte |
Max tokens CoT |
Max tokens de sortie |
Prix 1M tokens entrée (cache hit) |
Prix 1M tokens entrée (cache miss) |
Prix 1M tokens sortie |
|
deepseek-chat |
64k |
- |
8k |
$0.07 |
$0.27 |
$1.10 |
|
deepseek-reasoner |
64k |
32k |
8k |
$0.14 |
$0.55 |
$2.19 |
Comme indiqué, DeepSeek propose deux modèles, deepseek-chat et deepseek-reasoner, avec des forces et des coûts différents. Comprendre leur traitement et leur tarification par token vous permet de les utiliser plus efficacement et de maîtriser les dépenses.
Les deux modèles gèrent jusqu'à 64 000 tokens par conversation, ce qui améliore la mémoire du contexte et la pertinence des réponses. Toutefois, leur fonctionnement diffère.
deepseek-chat est conçu pour des échanges généraux et n'utilise pas de raisonnement avancé. deepseek-reasoner, lui, permet jusqu'à 32 000 tokens pour une pensée pas à pas (chain-of-thought — nous y revenons) avant la réponse finale. Idéal pour les problèmes complexes, mais plus gourmand en tokens — donc plus coûteux.
Côté longueur de réponse, chaque modèle peut générer jusqu'à 8 000 tokens. Ce plafond évite des sorties trop longues et onéreuses.
En termes de prix, deepseek-chat est l'option la plus économique. Si l'entrée est en cache (déjà utilisée), le coût est de 0,07 $ par million de tokens. Pour une nouvelle entrée, il passe à 0,27 $, et la sortie coûte 1,10 $ par million de tokens.
deepseek-reasoner est plus cher car il fournit un raisonnement plus poussé. L'entrée mise en cache coûte 0,14 $ par million de tokens, une nouvelle entrée 0,55 $, et la sortie 2,19 $ par million de tokens, reflétant la complexité des réponses.
Quel modèle choisir ?
Pour des réponses simples ou rapides, deepseek-chat est préférable car plus abordable. Pour un raisonnement détaillé ou des problèmes complexes, deepseek-reasoner est plus puissant — mais plus onéreux.
Pour économiser, utilisez aussi la mise en cache : quand le modèle reconnaît une entrée déjà vue, le tarif baisse. Très utile pour les requêtes répétitives ou les conversations multi-tours.
Les modèles DeepSeek sont compétitifs, mais l'usage des tokens grimpe vite. Pour maîtriser les coûts : prompts courts, cache quand c'est possible, et bon choix de modèle. Pour aller plus loin, lisez cet article sur l'optimisation des prompts.
Le paramètre temperature
Le paramètre temperature contrôle le degré de variabilité des réponses. Par défaut dans DeepSeek, il vaut 1,0 : un équilibre entre créativité et déterminisme. Vous pouvez l'ajuster selon vos besoins.
Recommandations DeepSeek selon l'usage :
|
Cas d'usage |
Temperature recommandée |
|
Code / Mathématiques |
0,0 (déterministe, précis) |
|
Nettoyage / analyse de données |
1,0 (réponses équilibrées) |
|
Conversation générale |
1,3 (plus de variété dans les réponses) |
|
Traduction |
1,3 (souplesse de formulation) |
|
Écriture créative / Poésie |
1,5 (favorise une sortie riche et créative) |
Une temperature basse (proche de 0,0) rend le modèle plus prévisible et précis : idéal pour le code, les maths et les analyses structurées.
Au-dessus de 1,0, le modèle devient plus créatif et varié : utile pour les récits, la poésie et des traductions plus libres.
Pour la conversation générale, autour de 1,3 produit des dialogues naturels et engageants, sans être trop répétitifs ni aléatoires.
La temperature n'impacte pas directement le coût, mais peut influer sur le volume de tokens de sortie :
- Plus élevée → réponses plus longues et variées, donc plus de tokens — coûts en hausse.
- Plus basse → réponses plus courtes et directes, moins de tokens — coûts en baisse.
Format de réponse
Avec l'API de DeepSeek, vous pouvez contrôler le format des réponses via le paramètre response_format. C'est particulièrement utile avec des données structurées, pour garantir la cohérence et la lisibilité de la sortie.
Pour recevoir une réponse en JSON, définissez :
response_format={'type': 'json_object'}Vous demandez ainsi une sortie structurée, plus simple à traiter par programme. Le JSON est très courant pour les applications qui exigent des réponses lisibles par machine : extraction de données, automatisation, intégrations d'API.
Le JSON n'impacte pas directement la tarification, mais peut parfois réduire les coûts.
- Réponses plus concises : le format structuré est souvent plus compact, donc potentiellement moins de tokens qu'un texte libre.
- Précision accrue : en demandant explicitement une sortie structurée, vous évitez les digressions inutiles et limitez les tokens.
Comprendre le chain-of-thought (CoT) et ses coûts
Le CoT est le processus de raisonnement que suit DeepSeek-R1 avant de donner sa réponse finale. Le modèle explicite son raisonnement étape par étape avant de conclure.
Chaque token utilisé dans le CoT et la réponse finale est facturé 2,19 $ par million de tokens, car il s'agit de tokens de sortie. C'est un compromis : plus de tokens CoT = coût plus élevé, mais meilleure précision pour les tâches complexes.
Comment contrôler les coûts avec le CoT ?
- Des prompts clairs : demandez un raisonnement court mais efficace, évitez les explications fleuves.
- Suivez l'usage des tokens : surveillez le volume CoT vs la réponse finale.
- Choisissez le bon modèle : pour des questions simples, préférez deepseek-chat, moins cher. Pas de CoT dans ce cas.
- Utilisez le cache : pour des questions récurrentes, la mise en cache réduit les coûts d'entrée.
Exemple : prompt non optimisé
Pour illustrer la sortie Chain-of-Thought (CoT) de DeepSeek-R1 et son impact sur le prix, prenons un exemple :
from openai import OpenAI
client = OpenAI(
api_key="<Your_DeepSeek_API_Key>",
base_url="https://api.deepseek.com"
)
def generate_response(prompt):
response = client.chat.completions.create(
model="deepseek-reasoner",
messages=[
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": prompt}
],
stream=False
)
return response.choices[0].message.content
# Example usage
prompt = "Calculate the area of a triangle with a base of 6 cm and a height of 4 cm."
result = generate_response(prompt)
print(result)CoT :
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember how to do this. I think the formula for the area of a triangle is something like base multiplied by height divided by two. Wait, is that right? Let me think.
When I was in math class, the teacher mentioned that a triangle is basically half of a parallelogram. So if you have a parallelogram, its area is base times height. If you cut it along the diagonal, you get two triangles. That means each triangle would have half the area of the parallelogram. So yes, the formula should be (base × height) / 2. That makes sense. Let me write that down to visualize it better.
Area = (base × height) / 2
Given the base is 6 cm and the height is 4 cm, I can substitute those values into the formula. Let me plug them in step by step.
First, multiply the base and the height: 6 cm × 4 cm. Let me calculate that. 6 times 4 is 24. So that gives me 24 cm². Now, divide that result by 2. So 24 divided by 2 is 12. Therefore, the area should be 12 cm².
Wait, let me verify that. If the base was 6 and the height 4, multiplying them gives the area of the corresponding parallelogram, which would be 24 cm². Then, since the triangle is half of that, dividing by 2 gives 12 cm². Yes, that seems correct.
Is there another way to check this? Maybe using a different method? Let's see. For a triangle, the area can also be calculated using Heron's formula, but that requires knowing all three sides. Since I only have the base and height, that might not apply here. Alternatively, if it's a right-angled triangle, the area would be (1/2)*base*height, which is the same formula. But even if it's not a right-angled triangle, the formula still applies because the height is given. The height is the perpendicular distance from the base to the opposite vertex, so regardless of the triangle's type, as long as we know the base and the corresponding height, the formula works.
Let me draw a mental picture. Imagine a triangle where the base is 6 cm. The height is 4 cm, which means if I were to drop a perpendicular line from the top vertex to the base, that line would measure 4 cm. So, even if the triangle is slanted, that vertical height is still 4 cm. Multiplying base and height gives the area of the parallelogram, so dividing by two gives the triangle's area.
Another way to think about it: If I have two identical triangles, I can put them together to form a parallelogram. The area of that parallelogram is base times height, so each triangle is half of that. Therefore, the area of one triangle is 1/2 * base * height.
So, plugging the numbers in again: 1/2 * 6 cm * 4 cm. 1/2 of 6 is 3, and 3 times 4 is 12. Yep, 12 cm².
I think that's solid. Let me check with an example. Suppose the base was 2 cm and the height 3 cm. Then the area would be (2*3)/2 = 3 cm². If I draw such a triangle, it should have an area of 3 cm², which seems right. So scaling up, with a base of 6 and height of 4, the area is proportionally larger.
Alternatively, if I consider a rectangle with the same base and height, area would be 6*4=24 cm². The triangle is half of that, so 12 cm². That also checks out.
Wait, but hold on. If the triangle isn't a right triangle, does the formula still hold? Let's think. If I have an obtuse triangle where the height is outside the triangle, does that affect the area? For example, suppose the base is 6 cm, but the height is measured from the base to a vertex that's outside the triangle, making an obtuse triangle. Even in that case, the area is still (base*height)/2. Because the height is the perpendicular distance regardless of where it's located. So even if the triangle is obtuse, the formula remains the same. Therefore, regardless of the triangle type, as long as the height is given, the formula applies.
Therefore, using 6 cm and 4 cm, multiplying them, dividing by two, gives 12 cm². That seems to be the correct answer. I can't see any mistakes in the reasoning.
Let me just recap. The formula for the area of a triangle is 1/2 multiplied by base multiplied by height. Given base = 6 cm, height = 4 cm. Plugging into the formula: 1/2 * 6 * 4 = 12. The units are in centimeters, and since area is in square units, the answer is 12 cm².
Yes, that all lines up. I think I've got it right. The area is 12 square centimeters.Réponse finale :
The area of the triangle is 12 cm².
To calculate the area of a triangle with a base of 6 cm and a height of 4 cm, we use the standard formula:
Area=1/2×base×height
Step-by-Step Calculation
Multiply the base and height: 6 cm×4 cm=24 cm²Divide the result by 2: 24 cm²/ 2=12 cm²Final Answer: 12 cm²
Thus, the area of the triangle is 12 cm².Calcul du coût
- Tokens utilisés ≈ 1165
- Coût par million de tokens = 2,19 $
- Conversion en millions : 1165 tokens ÷ 1 000 000 = 0,001165 million
- Multiplication par le tarif : 0,001165 × 2,19 = 0,002551350.
- Coût final ≈ 0,00255 $ (arrondi à 5 décimales)
Exemple : prompt optimisé
Optimisons maintenant le prompt et observons l'impact sur la sortie :
Prompt : "Area of triangle: base 6cm, height 4cm. Show formula and result only"
CoT :
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember the formula for the area of a triangle. I think it's something like base multiplied by height divided by two. Wait, yeah, right, because a triangle is basically half of a parallelogram, right? So if you have a parallelogram, the area is base times height, and then a triangle would be half of that. So the formula should be (base * height) / 2.
Let me double-check that. Maybe I can visualize a triangle with base 6 and height 4. If I had another identical triangle, I could put them together to form a parallelogram. The base would still be 6, the height would still be 4, so the area of the parallelogram would be 6*4=24. Then the area of one triangle would be half of that, which is 12. So that makes sense.
Alternatively, I remember in school they taught us the formula as A = 1/2 * b * h. So plugging in the values, it should be 1/2 * 6 cm * 4 cm. Let me calculate that. 1/2 of 6 is 3, then 3 times 4 is 12. So the area should be 12 cm².
Wait, but just to be thorough, let me make sure there aren't any other formulas that could apply here. For example, Heron's formula requires the lengths of all three sides, but I only have the base and height here. So Heron's formula isn't necessary. Since we have the base and height given directly, using the standard area formula is the way to go.
Also, units: the base is in centimeters, the height is in centimeters, so when multiplying, the area will be in square centimeters. That checks out.
Another thing to consider: is the height corresponding to the given base? The problem states "base 6 cm, height 4 cm," so yes, they correspond. If the height was relative to a different side, it might complicate things, but here it's specified for the base. So no issues there.
I think that's all. The formula is correct, the calculation seems right. 6 times 4 is 24, divided by 2 is 12. So the area is 12 square centimeters.Réponse finale :
The area of the triangle is calculated using the formula: Area=1/2×base×height
Substituting the given values: Area=1/2×6 cm ×4 cm = 12 cm²
Result: 12 cm²Calcul du coût
- Tokens utilisés ≈ 496
- Coût par million de tokens = 2,19 $
- Conversion en millions : 496 tokens ÷ 1 000 000 = 0,000496 million
- Multiplication par le tarif : 0,000496 × 2,19 = 0,001086240.
- Coût final ≈ 0,00109 $ (arrondi à 5 décimales)
Tableau comparatif des coûts finaux
Le tableau ci-dessous illustre l'impact du nombre de tokens sur le coût total d'un appel API :
|
Exemple |
Tokens utilisés |
Coût (USD) |
|
Prompt non optimisé |
1165 |
$0.00255 |
|
Prompt optimisé |
496 |
$0.00109 |
Nous avons réduit les coûts d'environ 57 % par rapport à l'original grâce au prompt optimisé, tout en obtenant la bonne réponse.
Utiliser la mise en cache du contexte de DeepSeek pour réduire les coûts
D'après le tableau de prix vu dans la section Coûts des tokens, la mise en cache permet d'économiser environ 74,07 % des coûts d'API pour deepseek-chat et 74,55 % pour deepseek-reasoner par rapport au traitement d'entrées nouvelles (non mises en cache). Autrement dit, la mise en cache peut réduire presque des trois quarts le coût des tokens d'entrée.
C'est particulièrement utile avec des prompts longs, car cela réduit l'attente. De plus, le système gère la mise en cache automatiquement : pas besoin de modifier votre code.
Comment fonctionne la mise en cache du contexte ?
Quand vous envoyez une requête, DeepSeek stocke l'entrée sur ses serveurs. Si vous envoyez ensuite une requête similaire, le système réutilise le résultat stocké au lieu de tout recalculer. C'est plus rapide et moins cher.
Quand la mise en cache est-elle la plus utile ?
La mise en cache est utile et réduit les coûts dans les situations suivantes :
- Conversations multi-tours : les chatbots peuvent réutiliser des réponses antérieures et réduire les coûts.
- Analyse de données : les requêtes répétées sur les mêmes fichiers profitent du cache.
- Assistants Q&R : les consignes longues en début de conversation peuvent être mises en cache.
- Jeux de rôle et applis interactives : les réglages des personnages et longs dialogues ne nécessitent pas de recalcul.
- Analyse de code : référencer plusieurs fois les mêmes fichiers économise des tokens.
- Few-shot learning : si vous fournissez des exemples au modèle, la mise en cache peut réduire la facture.
Comment maximiser les économies
Pour optimiser les économies, je recommande :
- Placez le texte réutilisé au début : l'API ne met en cache que le début des entrées.
- Restez proche des entrées précédentes : évitez de trop changer les prompts si vous visez le cache.
- Concevez pour la répétition : structurez vos requêtes pour réutiliser un maximum de contenu mis en cache.
Comment suivre l'usage du cache
Pour suivre votre usage du cache avec l'API de DeepSeek, vous n'avez rien à changer dans votre code. Les informations de cache sont incluses automatiquement dans la réponse API. Le système de cache est activé par défaut pour tous. Lors d'un appel, l'objet de réponse inclut deux champs supplémentaires dans la section usage :
prompt_cache_hit_tokens: nombre de tokens d'entrée servis depuis le cacheprompt_cache_miss_tokens: nombre de tokens d'entrée non trouvés dans le cache
Pour y accéder, consultez le champ usage de la réponse API. Exemple d'accès :
response = client.chat.completions.create(
model="deepseek-chat",
messages=[
{"role": "user", "content": "You are a helpful assistant."}
]
)
cache_hits = response.usage.prompt_cache_hit_tokens
cache_misses = response.usage.prompt_cache_miss_tokens
print(f"Cache hits: {cache_hits}")
print(f"Cache misses: {cache_misses}")Cette fonctionnalité vous permet de suivre l'efficacité du cache pour votre cas d'usage.
Il existe toutefois des limites :
- Taille minimale du cache : seuls les segments d'au moins 64 tokens sont mis en cache. Les entrées plus courtes ne le sont pas.
- Pas garanti à 100 % : le système ne garantit pas qu'une requête utilisera systématiquement le cache.
- Expiration du cache : en l'absence d'usage, le cache est purgé automatiquement en quelques heures à quelques jours.
Pour en savoir plus, lisez cet article sur la mise en cache des prompts.
Conclusion
Dans ce tutoriel, nous avons vu comment utiliser l'API DeepSeek et ses deux modèles, DeepSeek-R1 et V3. En comprenant leur fonctionnement, vous pouvez créer des applications d'IA pertinentes et maîtrisées en coûts.
Suivez la documentation DeepSeek et les bonnes pratiques pour tirer le meilleur de ces modèles puissants. Une fois votre clé API DeepSeek obtenue, vous pouvez la pointer vers l'agent de code de DeepSeek ; consultez notre tutoriel DeepSeek Harness.
Bon code !

Ana Rojo Echeburúa est une spécialiste de l'IA et des données, titulaire d'un doctorat en mathématiques appliquées. Elle aime transformer les données en informations exploitables et possède une grande expérience de la direction d'équipes techniques. Ana aime travailler en étroite collaboration avec ses clients pour résoudre leurs problèmes commerciaux et créer des solutions d'IA innovantes. Connue pour ses compétences en matière de résolution de problèmes et de communication claire, elle est passionnée par l'IA, en particulier l'IA générative. Ana se consacre à l'apprentissage continu et au développement éthique de l'IA, ainsi qu'à la simplification des problèmes complexes et à l'explication de la technologie de manière accessible.







Dans ce tutoriel, je vous montre comment configurer et utiliser l'API DeepSeek afin de l'intégrer à vos projets. Vous allez découvrir :
Au final, vous saurez utiliser DeepSeek tout en gardant un coût minimal. Commençons !
Modèles DeepSeek
DeepSeek propose deux modèles principaux accessibles via API :
Pour en savoir plus sur les différences entre les deux modèles, consultez cet article sur DeepSeek R1 vs V3.