यदि आप 2026 की दूसरी छमाही में एजेंटिक कार्य के लिए कोई मॉडल चुन रहे हैं, तो शॉर्टलिस्ट बहुत छोटी है—और उस पर मौजूद दोनों नाम दो हफ्ते के अंतर से लॉन्च हुए। Anthropic ने 24 जुलाई को Claude Opus 5 जारी किया, और OpenAI ने 9 जुलाई को GPT-5.6 Sol को जनरल उपलब्धता में लाया। दोनों फ्लैगशिप टियर हैं, दोनों लंबी चलने वाली पेशेवर जिम्मेदारियों के लिए बने हैं, और दोनों की कीमतें लगभग समान दिखती हैं।
इस लेख में, मैं आपके वर्कफ़्लो के लिए उपयुक्त विकल्प तय करने में मदद के लिए कोडिंग, तर्क, कंप्यूटर उपयोग, टूल उपयोग, प्राइसिंग और एक्सेस पर Claude Opus 5 और GPT-5.6 Sol की तुलना करूँगा। प्रत्येक मॉडल की गहराई से कवरेज के लिए हमारा Claude Opus 5 गाइड और हमारा GPT-5.6 फैमिली गाइड देखें।
संक्षेप में
- Opus 5 नया-नवेला तर्क और एजेंटिक कार्य का विशेषज्ञ है; GPT-5.6 Sol टर्मिनल और ब्राउज़िंग में अधिक सक्षम जनरलिस्ट है।
- दोनों पर 1M इनपुट टोकन की कीमत $5 है। आउटपुट पर, Opus 5 17% सस्ता है।
- वास्तव में नए समस्याओं, कोडिंग और कंप्यूटर उपयोग के लिए Opus 5 चुनें। टर्मिनल वर्कफ़्लो, ब्राउज़िंग एजेंट और साइबरसिक्योरिटी डिफेंस कार्य के लिए Sol चुनें।
Claude Opus 5 क्या है?
Claude Opus 5, Anthropic का Opus-टियर मॉडल है, जो 24 जुलाई, 2026 को जारी हुआ और उच्च-स्तरीय Fable 5 जैसी क्षमता आधी कीमत पर देता है। यह Claude Max पर नया डिफ़ॉल्ट मॉडल है और Claude Pro पर उपलब्ध सबसे शक्तिशाली मॉडल है।
मॉडल का सबसे अलग व्यवहार है दृढ़ता। Anthropic के अनुसार, Opus 5 अपना काम स्वयं सत्यापित करता है और सफल होने तक दोहराव करता है, बजाय इसके कि किसी संभावित उत्तर पर रुक जाए; और यह 2.3 का मिसअलाइंड-व्यवहार ऑडिट स्कोर रिपोर्ट करता है, जो हालिया Anthropic मॉडलों में सबसे कम है। संदर्भ 1M टोकन तक जाता है, 128K आउटपुट सीमा के साथ, और सोच (reasoning) डिफ़ॉल्ट रूप से ऑन है।
यदि आप इसे पढ़ने के बजाय इससे बनाना चाहते हैं, तो हमारा Claude Opus 5 API ट्यूटोरियल एक बग-फिक्सिंग एजेंट बनाने और उसे पाँचों प्रयास-स्तरों पर बेंचमार्क करने की प्रक्रिया बताता है।
GPT-5.6 Sol क्या है?
GPT-5.6 Sol, OpenAI की GPT-5.6 फैमिली का फ्लैगशिप है, जो सीमित प्रीव्यू के बाद 9 जुलाई, 2026 को जनरल उपलब्धता तक पहुँचा। इस फैमिली में तीन टियर हैं:
- Sol: सर्वोच्च प्रदर्शन वाला फ्लैगशिप मॉडल
- Terra: संतुलित, दैनिक उपयोग का मॉडल
- Luna: लागत-कुशल विकल्प
OpenAI के अनुसार, Sol कोडिंग, नॉलेज वर्क, साइबरसिक्योरिटी और विज्ञान में अत्याधुनिक परिणाम देता है, और जिन मॉडलों को यह मात देता है, उनसे कम टोकन खर्च करता है।
Sol की ख़ास विशेषता है ultra, एक रीजनिंग सेटिंग जो डिफ़ॉल्ट रूप से चार एजेंटों को समानांतर कार्यप्रवाहों में समन्वित करती है। OpenAI ने Responses API में Programmatic Tool Calling भी जोड़ा है, जो मॉडल को छोटे प्रोग्राम लिखने और चलाने देता है, ताकि वे टूल्स का ऑर्केस्ट्रेशन करें और मध्यवर्ती डेटा को फ़िल्टर करें—हर टूल प्रतिक्रिया को दोबारा मॉडल के माध्यम से रूट करने के बजाय।
परिवार की संरचना और प्रीव्यू-युग के अपवादों पर अधिक जानकारी के लिए हमारा GPT-5.6 विश्लेषण देखें। हमने GPT-5.6 Pro के Dinitz-Garg-Goemans अनुमान के दावे किए गए प्रतिउदाहरण को भी कवर किया है—अब तक इस फैमिली के साथ किया गया सबसे दिलचस्प कार्य।
Claude Opus 5 बनाम GPT-5.6 Sol: आमने-सामने तुलना
अलग-अलग आयामों में जाने से पहले यहाँ त्वरित सारांश है।
| फ़ीचर | Claude Opus 5 | GPT-5.6 Sol |
|---|
| रिलीज़ | 24 जुलाई, 2026 | 9 जुलाई, 2026 |
| इनपुट, प्रति 1M टोकन | $5.00 | $5.00 |
| आउटपुट, प्रति 1M टोकन | $25.00 | $30.00 |
| कॉन्टेक्स्ट विंडो | 1M टोकन | 1M टोकन |
| अधिकतम आउटपुट | 128K टोकन | 128K टोकन |
| नवीन तर्क (ARC-AGI-3) | 30.2% | 7.78% |
| रिपॉज़िटरी कोडिंग (SWE-Bench Pro) | 79.2% | 64.6% |
| टर्मिनल कोडिंग (Terminal-Bench 2.1) | 89.1% | 88.8% (ultra के साथ 91.9%) |
| लॉन्ग-होराइजन कोडिंग (DeepSWE V1.1) | 68.8% | 72.7% |
| कंप्यूटर उपयोग (OSWorld 2.0) | 70.6% | 62.6% |
| ब्राउज़िंग एजेंट (BrowseComp) | 90.8% | 90.4% (ultra के साथ 92.2%) |
| सिग्नेचर फ़ीचर | स्व-प्रमाणीकरण और पुनरावृत्ति | ultra समानांतर-एजेंट मोड |
| मॉडल ID | claude-opus-5 | gpt-5.6-sol |
नवीन तर्क और अमूर्त समस्याएँ
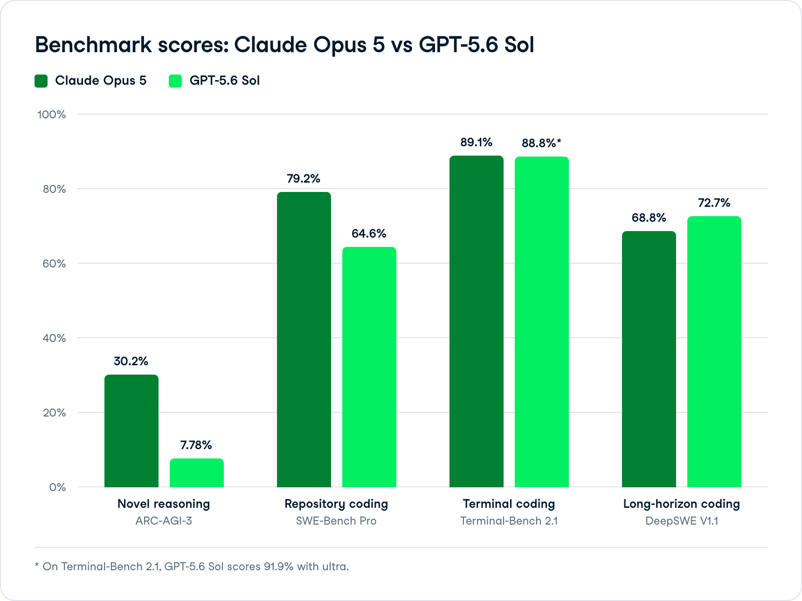
यहीं दोनों मॉडल सबसे तीखे रूप में अलग होते हैं, इसलिए मैं यहीं से शुरू कर रहा हूँ। ARC-AGI-3 मॉडल से वे समस्याएँ हल कराने को कहता है, जिनसे वह प्रशिक्षण में नहीं गुज़रा—यह तर्क का, न कि याद रखने का, सबसे नज़दीकी परीक्षण है।
Opus 5 का स्कोर 30.2% है। GPT-5.6 Sol 7.78% स्कोर करता है, हालाँकि वह लीडरबोर्ड पर दूसरे स्थान का मॉडल है। तुलना के लिए, Gemini 3.1 Pro Preview 0.42% तक ही पहुँचता है। संदर्भ के लिए, Opus 4.8 ने दो महीने पहले 1.5% स्कोर किया था—यानी एक ही Anthropic जनरेशन के भीतर बीस गुना छलांग।
मैं यह स्पष्ट रखना चाहता हूँ कि एक बेंचमार्क पर 4x अंतर का क्या मतलब है। ARC-AGI-3 जानबूझकर मेमोराइजेशन के प्रतिकूल बनाया गया है, और 30.2% स्कोर का मतलब अब भी अधिकांश असफलताएँ हैं। लेकिन यदि आपका काम ऐसे प्रश्नों पर है जो किसी ट्रेनिंग कॉर्पस में मौजूद किसी भी चीज़ जैसे नहीं लगते, तो यह पूरी तुलना का सबसे प्रासंगिक एकल नंबर है—और यह मुकाबला नहीं है।
 कोडिंग और एजेंटिक इंजीनियरिंग
कोडिंग में नतीजे बँटे हुए हैं—कोई एक मॉडल सब कुछ नहीं जीतता। प्रत्येक विक्रेता उन्हीं बेंचमार्क्स पर आगे है, जिन पर उसने ज़ोर दिया, जो बिल्कुल अपेक्षित है और यही कारण है कि आपको हेडलाइन दावों से आगे पढ़ना चाहिए।
| बेंचमार्क | Claude Opus 5 | GPT-5.6 Sol | टिप्पणी |
|---|
| SWE-Bench Verified | 96.0% | 96.2% | लगभग बराबरी; Fable 5 95.0% पर |
| SWE-Bench Pro | 79.2% | 64.6% | Claude Mythos 5 80.3% पर अग्रणी |
| DeepSWE v1.1 | 68.8% | 72.7% | Sol 3.9 अंक से आगे |
| Terminal-Bench 2.1 | 89.1% | 88.8% (ultra के साथ 91.9%) | बराबरी, फर्क ultra लाता है |
| Frontier-Bench v0.1 | 43.3% | 37.5% | Opus 4.8 ने दो महीने पहले 18.7% स्कोर किया था |
| AA Coding Agent Index v1.1 | प्रकाशित नहीं | 80 | Fable 5 77.2 पर, Opus 4.8 72.5 पर |
पैटर्न स्पष्ट है जब आप रिपॉज़िटरी कार्य को टर्मिनल कार्य से अलग कर देते हैं। Opus 5 SWE-Bench Pro पर लगभग 15 अंकों से आगे है और Frontier-Bench पर Opus 4.8 के स्कोर से दोगुने से भी अधिक पर पहुँचता है—यह एजेंटिक सॉफ़्टवेयर इंजीनियरिंग को मापता है, जैसे तकनीकी ड्रॉइंग से FreeCAD में मशीन पार्ट फिर से बनाना। Anthropic का अपना उदाहरण उद्धृत करने लायक है: ड्रॉइंग देखने का कोई तरीका न होने पर, Opus 5 ने कच्चे पिक्सल से ज्योमेट्री निकालने के लिए अपना कंप्यूटर विज़न पाइपलाइन लिखी, और पाँच प्रयासों में कोई प्रतिस्पर्धी मॉडल इसे हल नहीं कर पाया।
Sol टर्मिनल में आगे है, हालाँकि पहले की तुलना में मार्जिन कम है। यह Terminal-Bench 2.1 पर Opus 5 के साथ बराबरी पर है, लेकिन ultra सक्षम करने पर 91.9% तक जाता है। Sol DeepSWE v1.1 भी जीतता है, जो वास्तविक कोडबेस पर लंबी-अवधि इंजीनियरिंग का परीक्षण है, 3.9 अंकों से—और Fable 5 के आधे से भी कम आउटपुट टोकन और लगभग एक-तिहाई कम लागत पर।
हमारे हाथ-कलम अनुभव से एक बात: जब हमने Opus 5 के साथ एक बग-फिक्सिंग एजेंट बनाया और उसे पाँचों प्रयास-स्तरों पर चलाया, तो low प्रयास ने तीनों रन में बग ठीक कर दिया, जबकि max प्रयास तीन में से एक बार विफल रहा। उस विफल रन ने स्कीमा-अनुरूप लेकिन पूरी तरह खोखली रिपोर्ट लौटाई—शून्य टूल कॉल और रूट कॉज़ फ़ील्ड "b0" पर सेट। सबक यह है कि संरचित आउटपुट संरचना की गारंटी देता है, सार की नहीं—और अधिक प्रयास अपने-आप बेहतर नहीं होता। पूरी जानकारी हमारे Opus 5 API ट्यूटोरियल में है।
मेरा आकलन: यदि आपके एजेंट शेल में रहते हैं और आप ultra वहन कर सकते हैं, तो Sol को हल्की बढ़त है। यदि वे रिपॉज़िटरी में रहते हैं और कई फ़ाइलों में आर्किटेक्चर पर तर्क करना होता है, तो Opus 5 बेहतर है। "कोडिंग" एक श्रेणी के रूप में किसी का साफ़-सुथरा जीतना नहीं है—और कोई भी विक्रेता दावा जो इससे अलग कहे, वह बेंचमार्क चुन रहा है।
कंप्यूटर उपयोग और ब्राउज़िंग
यदि आप ऐसा कुछ बना रहे हैं जो GUI चलाता है, तो कंप्यूटर उपयोग मायने रखता है—और यह भी कोडिंग की तरह ही बँटा हुआ है।
Opus 5 OSWorld 2.0 पर 70.6% स्कोर करता है, जबकि Sol 62.6%—यानी 8 अंकों का अंतर। Anthropic यह भी दावा करता है कि Opus 5, Fable 5 के सर्वश्रेष्ठ OSWorld परिणाम को लगभग एक-तिहाई लागत पर पार कर जाता है—यह अधिक दिलचस्प है क्योंकि Fable 5 पर 1M इनपुट टोकन $10 पड़ते हैं, जबकि Opus 5 पर $5।
ब्राउज़िंग लगभग बराबरी पर है। Opus 5 BrowseComp पर 90.8% रिपोर्ट करता है; Sol 90.4% रिपोर्ट करता है, जो ultra के साथ सोलह समानांतर एजेंटों पर 92.2% तक पहुँचता है। फिर वही बात—यहीं ultra फर्क लाता है।
Sol का OSWorld परिणाम एक टोकन-क्षमता दावे के साथ आता है: OpenAI कहता है कि यह Opus 4.8 से बेहतर प्रदर्शन करते हुए 85% कम आउटपुट टोकन उपयोग करता है। यह तुलना Anthropic की पिछली पीढ़ी के विरुद्ध है, Opus 5 के विरुद्ध नहीं—इसलिए इसे इस मुकाबले पर लागू नहीं किया जा सकता, पर यह संकेत देता है कि Sol का कंप्यूटर-उपयोग मार्ग कार्य-प्रति-लागत के हिसाब से असामान्य रूप से सस्ता है।
टूल उपयोग और ऑटोमेशन
यही वह आयाम है जहाँ अमूर्त क्षमता का अंतर पूर्ण व्यावसायिक कार्यों में बदलता है—और यहाँ Opus 5 स्पष्ट रूप से आगे है।
Zapier के AutomationBench पर, जो मापता है कि कोई मॉडल किसी बिज़नेस टास्क को शुरुआत से अंत तक ले जा सकता है या नहीं, Opus 5 26.0% स्कोर करता है जबकि Sol 18.1%। Anthropic बताता है कि इसका पास रेट समान प्रति-कार्य लागत पर अगले सर्वश्रेष्ठ मॉडल का लगभग 1.5x है—और सबसे कम प्रयास सेटिंग पर भी, Opus 5 अन्य किसी भी मॉडल से अधिक कार्य पास करता है।
Zapier के CEO Wade Foster एक विशेष रन का वर्णन करते हैं: Opus 5 ने एक कच्चे अकाउंट-हेल्थ वर्कबुक को लिया और उसे एंड-टू-एंड चर्न-रोकथाम अनुक्रम में बदला—जोखिमग्रस्त खातों को फ़्लैग किया, सही ओनर को अलर्ट किया, और रिटेंशन ऑप्स के लिए सारांश बनाया। पिछले मॉडल पास नहीं हुए; Opus 5 ने 100% हिट किया।
Sol का प्रतिवाद स्कोर-आधारित नहीं, बल्कि स्थापत्य है। Responses API में Programmatic Tool Calling, Sol को छोटे प्रोग्राम लिखने देता है जो टूल्स का समन्वय करते हैं, मध्यवर्ती परिणाम फ़िल्टर करते हैं, और काम के चलते अगला कदम चुनते हैं—जिससे टूल-भारी कार्यों में मॉडल के राउंड-ट्रिप कम लगते हैं। यह वास्तविक दक्षता तंत्र है, पर यह अधिक कार्य सही ढंग से पूरा करने के दावे से भिन्न है—और AutomationBench बाद वाले को मापता है।
साइबरसिक्योरिटी और विज्ञान
यह वह आयाम है जहाँ दोनों विक्रेताओं ने जानबूझकर विपरीत विकल्प चुने हैं—और कुछ पाठकों के लिए यहीं से फैसला हो जाएगा।
Anthropic ने Opus 5 को साइबर कार्यों पर प्रशिक्षित नहीं किया है। वह स्पष्ट कहता है कि Opus 5 द्वि-उपयोग क्षमताओं के फ्रंटियर को आगे नहीं बढ़ाता और बायोलॉजी रिसर्च और ऑफेंसिव साइबरसिक्योरिटी दोनों में Mythos 5 से पीछे रहता है। OSS-Fuzz पर, Opus 5 कमजोरियाँ पहचानने की दर में Mythos 5 के करीब है, पर उनके लिए एक्सप्लॉइट विकसित करने में काफ़ी पीछे है। Opus 5 के साइबर क्लासिफ़ायर बायनरी-आधारित वल्नरेबिलिटी स्कैनिंग, पेन-टेस्टिंग और एक्सप्लॉइट जनरेशन को ब्लॉक करते हैं, हालाँकि Anthropic का अनुमान है कि वे Fable 5 की तुलना में लगभग 85% कम बार हस्तक्षेप करेंगे।
OpenAI ने उल्टा रास्ता लिया। Sol को OpenAI का सबसे सक्षम साइबरसिक्योरिटी मॉडल बताया गया है, और संख्याएँ बड़ी हैं:
- ExploitBench: 73.5% बनाम GPT-5.5 का 47.9%, तुलनीय आउटपुट-टोकन बजट पर
- ExploitGym: दो घंटे की सीमा में 24.9%, छह घंटे में 33.7% तक—GPT-5.5 की 15.1% पीक के मुकाबले
- SEC-Bench Pro: 71.2% बनाम GPT-5.5 का 45.8%, बेहतर लेटेंसी पर
- कैप्चर-द-फ़्लैग: 96.7%
दोनों विक्रेता इस पर एक्सेस गेट रखते हैं। OpenAI उन्नत डिफेंसिव क्षमता को Daybreak के Trusted Access for Cyber के माध्यम से रूट करता है, 1 सितंबर तक अपने सबसे साइबर-समर्थ मॉडलों की निरंतर पहुँच के लिए हार्डवेयर-बैक्ड पासकीज़ अनिवार्य करता है, और कहता है कि Sol के साइबर सेफ़गार्ड्स संभावित हानिकारक गतिविधि को पिछले मॉडलों की तुलना में लगभग दस गुना अधिक ब्लॉक करते हैं। Anthropic एक Cyber Verification Program चलाता है, जो नामांकित एंटरप्राइज़ और शोधकर्ताओं को Opus 5 का कम-प्रतिबंधित बिल्ड देता है।
विज्ञान पर, Opus 5, Anthropic के जीवन-विज्ञान मूल्याँकनों में Opus 4.8 को हर जगह पछाड़ता है—सबसे बड़े लाभ ऑर्गेनिक केमिस्ट्री (स्पेक्ट्रोस्कोपी डेटा से आणविक संरचनाएँ निकालने में 10.2 प्रतिशत अंक) और प्रोटीन सीक्वेंस-फंक्शन भविष्यवाणी (7.7 अंक) में हैं। Sol GeneBench Pro पर 28.7% और LifeSciBench पर 59.9% रिपोर्ट करता है, GPT-5.5 के क्रमशः 12% और 59.9% के मुकाबले। साझा बेंचमार्क नहीं हैं—तो यह तुलना नहीं, बल्कि दो विक्रेताओं द्वारा अलग-अलग परीक्षाओं पर अपना-अपना आकलन है।
प्राइसिंग
मानक संदर्भ पर इनपुट और कैश्ड-रीड दरें बिल्कुल मिलती हैं, जिससे एक चर हट जाता है। जो बचता है वह है Sol पर 20% आउटपुट प्रीमियम, और एक लॉन्ग-कॉन्टेक्स्ट सरचार्ज जो सिर्फ Sol वसूलता है।
टोकन दरें साथ-साथ
| दर | Claude Opus 5 | GPT-5.6 Sol |
|---|
| इनपुट, प्रति 1M टोकन | $5.00 | $5.00 |
| आउटपुट, प्रति 1M टोकन | $25.00 | $30.00 |
| कैश्ड इनपुट रीड, प्रति 1M टोकन | $0.50 | $0.50 |
| कैश राइट, प्रति 1M टोकन | $6.25 | $6.25 |
| लॉन्ग-कॉन्टेक्स्ट सरचार्ज | कोई नहीं (1M तक फ्लैट) | 272K इनपुट से ऊपर 2× इनपुट / 1.5× आउटपुट |
| फास्ट मोड | 2× कीमत, ~2.5× स्पीड | 2× कीमत, ~2.5× स्पीड |
पूरे शॉर्ट-कॉन्टेक्स्ट लागत अंतर का असर जेनरेशन पर पड़ता है, इसलिए Sol का प्रीमियम सबसे अधिक तब चुभता है जब लंबा तर्क और लाँग-फ़ॉर्म आउटपुट चाहिए। वह रिट्रीवल कार्यों में घट जाता है जहाँ आप इनपुट ज़्यादा और आउटपुट कम भेजते हैं—जब तक कि Sol का लॉन्ग-कॉन्टेक्स्ट सरचार्ज हावी न हो जाए।
दोनों मॉडल अब फास्ट मोड देते हैं—लगभग दोगुनी कीमत पर लगभग 2.5× स्पीड। OpenAI ने 30 जुलाई, 2026 को Sol का पुराना Priority Processing फास्ट मोड में मिला दिया, इसलिए यह लीवर दोनों ओर सममित है—अंतरकारक नहीं।
वास्तविक वर्कलोड की लागत
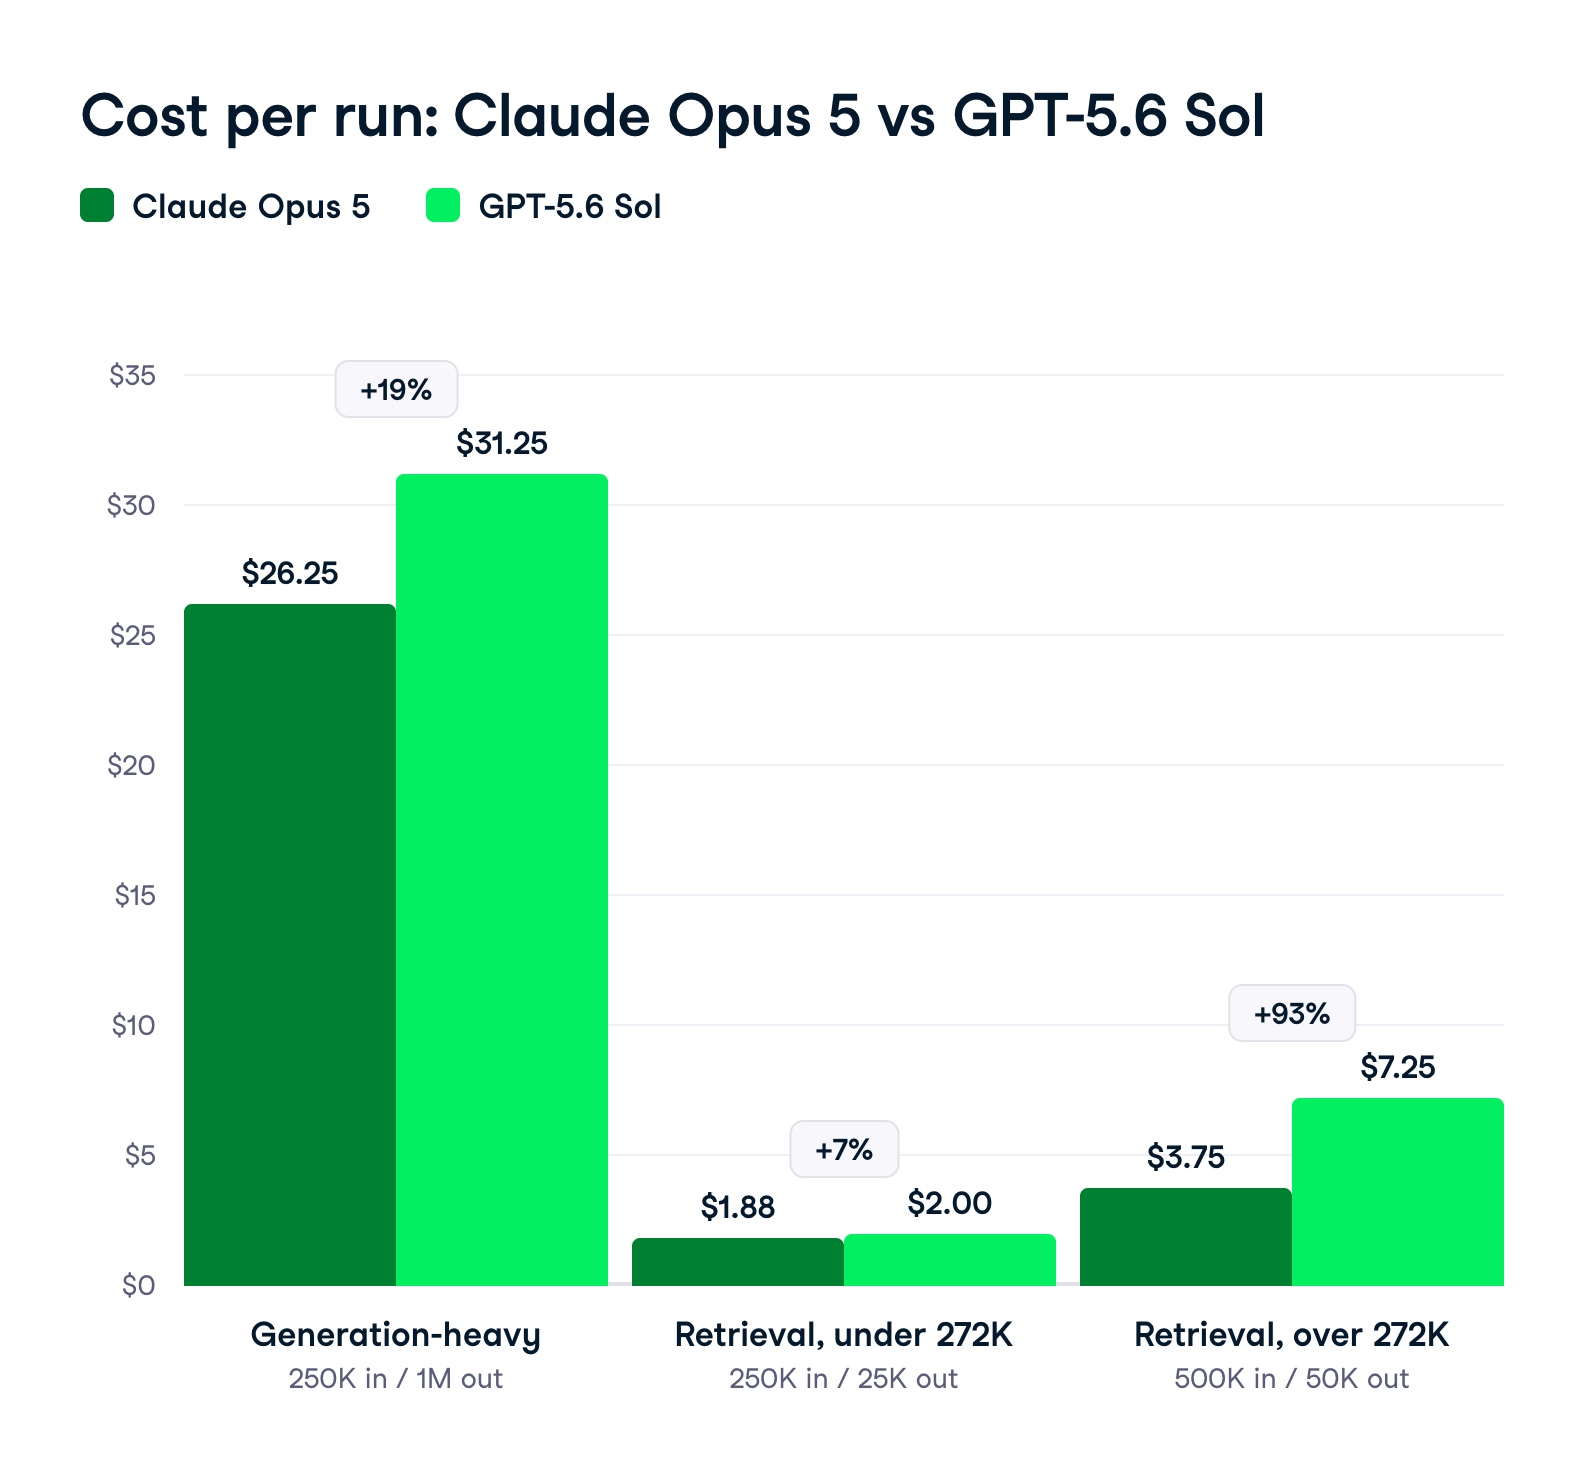
प्रति मिलियन टोकन की दरों से बजट बनाना मुश्किल है, और एक तय अनुपात इस तुलना का सबसे महत्वपूर्ण हिस्सा छिपा देता है: इन दोनों मॉडलों के बीच का अंतर पूरी तरह वर्कलोड के आकार पर निर्भर करता है। यहाँ मानक दरों पर तीन प्रतिनिधि आकार हैं—बिना कैशिंग या बैच छूट के।
| वर्कलोड | मान्य वॉल्यूम | Claude Opus 5 | GPT-5.6 Sol | Sol बनाम Opus |
|---|
| जेनरेशन-हेवी | 250K इन / 1M आउट | $26.25 | $31.25 | +19% |
| रिट्रीवल, 272K से कम | 250K इन / 25K आउट | $1.88 | $2.00 | +7% |
| रिट्रीवल, 272K से अधिक | 500K इन / 50K आउट | $3.75 | $7.25 | +93% |
जेनरेशन-हेवी कार्यों में 20% आउटपुट प्रीमियम सीधे-सीधे गुजरता है—और Sol लगभग 19% महँगा पड़ता है। छोटे रिट्रीवल कार्यों में यह लगभग 7% तक सिमट जाता है, क्योंकि आउटपुट, समान इनपुट दर के आगे, राउंडिंग एरर जैसा है।
तीसरी पंक्ति ध्यान देने लायक है। जैसे ही कोई अनुरोध 272K इनपुट टोकन पार करता है, Sol का सरचार्ज पूरे अनुरोध पर 2× इनपुट और 1.5× आउटपुट लागू करता है, जबकि Opus 5 1M तक फ्लैट रहता है—तो प्रीमियम स्केल पर सिमटता नहीं; बिल लगभग दोगुना कर देता है। रिट्रीवल-हेवी या बड़े कॉन्टेक्स्ट वाले कामों में यह पलटाव हेडलाइन आउटपुट प्रीमियम से अधिक मायने रखता है।
एक ही टास्क की लागत अलग क्यों पड़ती है
हेडलाइन दरों के अलावा दो बातें हैं जो समान काम के बिल अलग कर देती हैं:
- Sol का लॉन्ग-कॉन्टेक्स्ट सरचार्ज। 272K इनपुट टोकन से ऊपर कोई भी अनुरोध पूरे अनुरोध पर 2× इनपुट और 1.5× आउटपुट पर बिल होता है—तो एक ही ओवरसाइज़्ड प्रॉम्प्ट Sol को ऐसे उच्च-रेट बैंड में ले जाता है जो Opus 5 पर होता ही नहीं। यह टोकन का फर्क नहीं, रेट-स्विच है—और ऊपर तीसरी वर्कलोड पंक्ति में शामिल है।
- Sol
ultra. Ultra पर कोई रेट प्रीमियम नहीं—यह बेस Sol की तरह $5/$30 पर ही बिल होता है—लेकिन इसका मल्टी-एजेंट, उच्च-प्रयास मोड प्रति कार्य काफ़ी अधिक टोकन खर्च करता है, जो किसी एजेंटिक जॉब की लागत को बेस Sol की तुलना में लगभग तीन गुना तक पहुँचा सकता है। यह गुणक रिपोर्टेड अनुमान है, मापा हुआ नहीं।
यह caveat सामान्य तौर पर आउटपुट साइड पर भी लागू होता है। प्रचलित दक्षता दावे लगभग सभी अन्य मॉडलों से तुलना करते हैं: बताया जाता है कि Sol, Coding Agent Index पर Fable 5 के आउटपुट टोकन के आधे से भी कम उपयोग करता है; और Anthropic बताता है कि Opus 5 अधिकतम reasoning पर Opus 4.8 से 26% कम टोकन जनरेट करता है। दोनों पूर्ववर्ती तुलना हैं—और ऊपर दिए गए आँकड़े नहीं बदलते।
Claude Opus 5 बनाम GPT-5.6 Sol: कब किसे चुनें
आयाम-स्तरीय नतीजे वर्कलोड पर साफ़-साफ़ मैप होते हैं, इसलिए विस्तार से बताने से पहले निर्णय-निर्देश यहाँ है।
| उपयोग-प्रकरण | सिफारिश | क्यों |
|---|
| वास्तव में नए, प्रशिक्षण-पूर्वदृष्टांतहीन प्रश्न | Claude Opus 5 | ARC-AGI-3 पर 30.2% बनाम Sol का 7.78% |
| जटिल टर्मिनल और कमांड-लाइन एजेंट | GPT-5.6 Sol | Terminal-Bench 2.1 पर 88.8%, ultra के साथ 91.9% |
| रिपॉज़िटरी-स्तरीय रिफैक्टरिंग और आर्किटेक्चर कार्य | Claude Opus 5 | SWE-Bench Pro पर 79.2% बनाम 64.6% |
| डिफेंसिव साइबरसिक्योरिटी और एक्सप्लॉइट पुनरुत्पादन | GPT-5.6 Sol | ExploitBench पर 73.5%; Opus 5 डिज़ाइन से एक्सप्लॉइट जनरेशन ब्लॉक करता है |
| GUI-ड्राइविंग और कंप्यूटर-उपयोग एजेंट | Claude Opus 5 | OSWorld 2.0 पर 70.6% बनाम 62.6% |
| बड़े दस्तावेज़-समुच्चयों पर लॉन्ग-कॉन्टेक्स्ट रिट्रीवल | Claude Opus 5 | 1M कॉन्टेक्स्ट डिफ़ॉल्ट रूप से—कोई सरचार्ज टियर नहीं |
| मल्टी-क्लाउड एंटरप्राइज़ डिप्लॉयमेंट | Claude Opus 5 | Bedrock, Vertex AI, और Azure AI Foundry पर उपलब्ध |
Claude Opus 5 चुनें यदि...
- आपकी समस्याएँ सच में नई हैं। ARC-AGI-3 का अंतर इस तुलना का सबसे बड़ा परिणाम है—और यह सीधे शोध कार्य और वहाँ मैप होता है जहाँ उत्तर किसी ट्रेनिंग कॉर्पस में नहीं है।
- आपको ऐसे एजेंट चाहिए जो कार्य पूरा करें, सिर्फ़ प्रयास न करें। AutomationBench में बढ़त, क्षमता नहीं बल्कि पूर्णता पर इस लेख का सबसे मज़बूत संकेत है।
- आप लंबे कॉन्टेक्स्ट में काम करते हैं। 1M टोकन डिफ़ॉल्ट और अधिकतम दोनों के रूप में—बिना किसी सरचार्ज टियर—Sol की प्रकाशित कॉन्टेक्स्ट हैंडलिंग से अधिक साफ़ कहानी है।
- एलाइनमेंट औपचारिक आवश्यकता है। 2.3 का मिसअलाइंड-व्यवहार ऑडिट स्कोर Anthropic का अब तक का सर्वश्रेष्ठ है—सबसे कम धोखे की दर और दुरुपयोग में फँसने की न्यूनतम संभावना के साथ।
GPT-5.6 Sol चुनें यदि...
- आप जटिल एजेंट चला रहे हैं जो शेल में रहते हैं। Sol का ultra मोड इसे शीर्ष पर पहुँचा देता है
- आप डिफेंसिव सिक्योरिटी कार्य कर रहे हैं। ExploitBench, ExploitGym और SEC-Bench Pro की संख्याएँ बड़ी हैं—और Opus 5 के क्लासिफ़ायर एक्सप्लॉइट जनरेशन को सक्रिय रूप से ब्लॉक करते हैं—इसलिए यह करीबी मामला नहीं है।
- आपको बिल्ट-इन पैरेलल-एजेंट ऑर्केस्ट्रेशन चाहिए।
ultra डिफ़ॉल्ट रूप से चार एजेंट समन्वित करता है और BrowseComp को सोलह एजेंटों पर 92.2% तक ले गया; और Responses API में मल्टी-एजेंट बीटा आपको ऐसे पैटर्न स्वयं बनाने देता है।
अंतिम विचार
दो हफ्तों के अंतर से, दोनों विक्रेताओं ने उल्टे दाँव लगाए: Opus 5 नया तर्क और टास्क-पूर्णता का पीछा करता है, जबकि Sol टर्मिनल कार्य, ब्राउज़िंग और डिफेंसिव सिक्योरिटी पर झुकता है—और 20% आउटपुट प्रीमियम वसूलता है।
यदि आपकी समस्याएँ वास्तव में नई हैं, आपके एजेंटों को प्रयास नहीं बल्कि पूर्णता चाहिए, या आप लंबे कॉन्टेक्स्ट पर काम करते हैं जहाँ इसकी फ्लैट 1M प्राइसिंग Sol के सरचार्ज को मात देती है—तो Opus 5 चुनें; यदि आपके एजेंट शेल में रहते हैं, आप ऐसा एक्सप्लॉइट-पुनरुत्पादन कार्य करते हैं जिसे Opus 5 डिज़ाइन के अनुसार ब्लॉक करता है, या आप टर्मिनल और ब्राउज़िंग लीडरबोर्ड में शीर्ष पर पहुँचने के लिए ultra वहन कर सकते हैं—तो Sol चुनें।
ज्यादातर अन्य आयामों पर अंतर, किसी भी विक्रेता की मार्केटिंग के संकेत से छोटा है—इसलिए हेडलाइन बेंचमार्क के बजाय अपने प्रमुख वर्कलोड से मॉडल का मिलान करें।
यदि आप 2026 की दूसरी छमाही में एजेंटिक कार्य के लिए कोई मॉडल चुन रहे हैं, तो शॉर्टलिस्ट बहुत छोटी है—और उस पर मौजूद दोनों नाम दो हफ्ते के अंतर से लॉन्च हुए। Anthropic ने 24 जुलाई को Claude Opus 5 जारी किया, और OpenAI ने 9 जुलाई को GPT-5.6 Sol को जनरल उपलब्धता में लाया। दोनों फ्लैगशिप टियर हैं, दोनों लंबी चलने वाली पेशेवर जिम्मेदारियों के लिए बने हैं, और दोनों की कीमतें लगभग समान दिखती हैं।
इस लेख में, मैं आपके वर्कफ़्लो के लिए उपयुक्त विकल्प तय करने में मदद के लिए कोडिंग, तर्क, कंप्यूटर उपयोग, टूल उपयोग, प्राइसिंग और एक्सेस पर Claude Opus 5 और GPT-5.6 Sol की तुलना करूँगा। प्रत्येक मॉडल की गहराई से कवरेज के लिए हमारा Claude Opus 5 गाइड और हमारा GPT-5.6 फैमिली गाइड देखें।
संक्षेप में
Claude Opus 5 क्या है?
Claude Opus 5, Anthropic का Opus-टियर मॉडल है, जो 24 जुलाई, 2026 को जारी हुआ और उच्च-स्तरीय Fable 5 जैसी क्षमता आधी कीमत पर देता है। यह Claude Max पर नया डिफ़ॉल्ट मॉडल है और Claude Pro पर उपलब्ध सबसे शक्तिशाली मॉडल है।
मॉडल का सबसे अलग व्यवहार है दृढ़ता। Anthropic के अनुसार, Opus 5 अपना काम स्वयं सत्यापित करता है और सफल होने तक दोहराव करता है, बजाय इसके कि किसी संभावित उत्तर पर रुक जाए; और यह 2.3 का मिसअलाइंड-व्यवहार ऑडिट स्कोर रिपोर्ट करता है, जो हालिया Anthropic मॉडलों में सबसे कम है। संदर्भ 1M टोकन तक जाता है, 128K आउटपुट सीमा के साथ, और सोच (reasoning) डिफ़ॉल्ट रूप से ऑन है।
यदि आप इसे पढ़ने के बजाय इससे बनाना चाहते हैं, तो हमारा Claude Opus 5 API ट्यूटोरियल एक बग-फिक्सिंग एजेंट बनाने और उसे पाँचों प्रयास-स्तरों पर बेंचमार्क करने की प्रक्रिया बताता है।
GPT-5.6 Sol क्या है?
GPT-5.6 Sol, OpenAI की GPT-5.6 फैमिली का फ्लैगशिप है, जो सीमित प्रीव्यू के बाद 9 जुलाई, 2026 को जनरल उपलब्धता तक पहुँचा। इस फैमिली में तीन टियर हैं:
OpenAI के अनुसार, Sol कोडिंग, नॉलेज वर्क, साइबरसिक्योरिटी और विज्ञान में अत्याधुनिक परिणाम देता है, और जिन मॉडलों को यह मात देता है, उनसे कम टोकन खर्च करता है।
Sol की ख़ास विशेषता है
ultra, एक रीजनिंग सेटिंग जो डिफ़ॉल्ट रूप से चार एजेंटों को समानांतर कार्यप्रवाहों में समन्वित करती है। OpenAI ने Responses API में Programmatic Tool Calling भी जोड़ा है, जो मॉडल को छोटे प्रोग्राम लिखने और चलाने देता है, ताकि वे टूल्स का ऑर्केस्ट्रेशन करें और मध्यवर्ती डेटा को फ़िल्टर करें—हर टूल प्रतिक्रिया को दोबारा मॉडल के माध्यम से रूट करने के बजाय।परिवार की संरचना और प्रीव्यू-युग के अपवादों पर अधिक जानकारी के लिए हमारा GPT-5.6 विश्लेषण देखें। हमने GPT-5.6 Pro के Dinitz-Garg-Goemans अनुमान के दावे किए गए प्रतिउदाहरण को भी कवर किया है—अब तक इस फैमिली के साथ किया गया सबसे दिलचस्प कार्य।
Claude Opus 5 बनाम GPT-5.6 Sol: आमने-सामने तुलना
अलग-अलग आयामों में जाने से पहले यहाँ त्वरित सारांश है।
ultraके साथ 91.9%)ultraके साथ 92.2%)ultraसमानांतर-एजेंट मोडclaude-opus-5gpt-5.6-solनवीन तर्क और अमूर्त समस्याएँ
यहीं दोनों मॉडल सबसे तीखे रूप में अलग होते हैं, इसलिए मैं यहीं से शुरू कर रहा हूँ। ARC-AGI-3 मॉडल से वे समस्याएँ हल कराने को कहता है, जिनसे वह प्रशिक्षण में नहीं गुज़रा—यह तर्क का, न कि याद रखने का, सबसे नज़दीकी परीक्षण है।
Opus 5 का स्कोर 30.2% है। GPT-5.6 Sol 7.78% स्कोर करता है, हालाँकि वह लीडरबोर्ड पर दूसरे स्थान का मॉडल है। तुलना के लिए, Gemini 3.1 Pro Preview 0.42% तक ही पहुँचता है। संदर्भ के लिए, Opus 4.8 ने दो महीने पहले 1.5% स्कोर किया था—यानी एक ही Anthropic जनरेशन के भीतर बीस गुना छलांग।
मैं यह स्पष्ट रखना चाहता हूँ कि एक बेंचमार्क पर 4x अंतर का क्या मतलब है। ARC-AGI-3 जानबूझकर मेमोराइजेशन के प्रतिकूल बनाया गया है, और 30.2% स्कोर का मतलब अब भी अधिकांश असफलताएँ हैं। लेकिन यदि आपका काम ऐसे प्रश्नों पर है जो किसी ट्रेनिंग कॉर्पस में मौजूद किसी भी चीज़ जैसे नहीं लगते, तो यह पूरी तुलना का सबसे प्रासंगिक एकल नंबर है—और यह मुकाबला नहीं है।
कोडिंग में नतीजे बँटे हुए हैं—कोई एक मॉडल सब कुछ नहीं जीतता। प्रत्येक विक्रेता उन्हीं बेंचमार्क्स पर आगे है, जिन पर उसने ज़ोर दिया, जो बिल्कुल अपेक्षित है और यही कारण है कि आपको हेडलाइन दावों से आगे पढ़ना चाहिए।
ultraके साथ 91.9%)ultraलाता हैपैटर्न स्पष्ट है जब आप रिपॉज़िटरी कार्य को टर्मिनल कार्य से अलग कर देते हैं। Opus 5 SWE-Bench Pro पर लगभग 15 अंकों से आगे है और Frontier-Bench पर Opus 4.8 के स्कोर से दोगुने से भी अधिक पर पहुँचता है—यह एजेंटिक सॉफ़्टवेयर इंजीनियरिंग को मापता है, जैसे तकनीकी ड्रॉइंग से FreeCAD में मशीन पार्ट फिर से बनाना। Anthropic का अपना उदाहरण उद्धृत करने लायक है: ड्रॉइंग देखने का कोई तरीका न होने पर, Opus 5 ने कच्चे पिक्सल से ज्योमेट्री निकालने के लिए अपना कंप्यूटर विज़न पाइपलाइन लिखी, और पाँच प्रयासों में कोई प्रतिस्पर्धी मॉडल इसे हल नहीं कर पाया।
Sol टर्मिनल में आगे है, हालाँकि पहले की तुलना में मार्जिन कम है। यह Terminal-Bench 2.1 पर Opus 5 के साथ बराबरी पर है, लेकिन
ultraसक्षम करने पर 91.9% तक जाता है। Sol DeepSWE v1.1 भी जीतता है, जो वास्तविक कोडबेस पर लंबी-अवधि इंजीनियरिंग का परीक्षण है, 3.9 अंकों से—और Fable 5 के आधे से भी कम आउटपुट टोकन और लगभग एक-तिहाई कम लागत पर।हमारे हाथ-कलम अनुभव से एक बात: जब हमने Opus 5 के साथ एक बग-फिक्सिंग एजेंट बनाया और उसे पाँचों प्रयास-स्तरों पर चलाया, तो
lowप्रयास ने तीनों रन में बग ठीक कर दिया, जबकिmaxप्रयास तीन में से एक बार विफल रहा। उस विफल रन ने स्कीमा-अनुरूप लेकिन पूरी तरह खोखली रिपोर्ट लौटाई—शून्य टूल कॉल और रूट कॉज़ फ़ील्ड "b0" पर सेट। सबक यह है कि संरचित आउटपुट संरचना की गारंटी देता है, सार की नहीं—और अधिक प्रयास अपने-आप बेहतर नहीं होता। पूरी जानकारी हमारे Opus 5 API ट्यूटोरियल में है।मेरा आकलन: यदि आपके एजेंट शेल में रहते हैं और आप
ultraवहन कर सकते हैं, तो Sol को हल्की बढ़त है। यदि वे रिपॉज़िटरी में रहते हैं और कई फ़ाइलों में आर्किटेक्चर पर तर्क करना होता है, तो Opus 5 बेहतर है। "कोडिंग" एक श्रेणी के रूप में किसी का साफ़-सुथरा जीतना नहीं है—और कोई भी विक्रेता दावा जो इससे अलग कहे, वह बेंचमार्क चुन रहा है।कंप्यूटर उपयोग और ब्राउज़िंग
यदि आप ऐसा कुछ बना रहे हैं जो GUI चलाता है, तो कंप्यूटर उपयोग मायने रखता है—और यह भी कोडिंग की तरह ही बँटा हुआ है।
Opus 5 OSWorld 2.0 पर 70.6% स्कोर करता है, जबकि Sol 62.6%—यानी 8 अंकों का अंतर। Anthropic यह भी दावा करता है कि Opus 5, Fable 5 के सर्वश्रेष्ठ OSWorld परिणाम को लगभग एक-तिहाई लागत पर पार कर जाता है—यह अधिक दिलचस्प है क्योंकि Fable 5 पर 1M इनपुट टोकन $10 पड़ते हैं, जबकि Opus 5 पर $5।
ब्राउज़िंग लगभग बराबरी पर है। Opus 5 BrowseComp पर 90.8% रिपोर्ट करता है; Sol 90.4% रिपोर्ट करता है, जो
ultraके साथ सोलह समानांतर एजेंटों पर 92.2% तक पहुँचता है। फिर वही बात—यहींultraफर्क लाता है।Sol का OSWorld परिणाम एक टोकन-क्षमता दावे के साथ आता है: OpenAI कहता है कि यह Opus 4.8 से बेहतर प्रदर्शन करते हुए 85% कम आउटपुट टोकन उपयोग करता है। यह तुलना Anthropic की पिछली पीढ़ी के विरुद्ध है, Opus 5 के विरुद्ध नहीं—इसलिए इसे इस मुकाबले पर लागू नहीं किया जा सकता, पर यह संकेत देता है कि Sol का कंप्यूटर-उपयोग मार्ग कार्य-प्रति-लागत के हिसाब से असामान्य रूप से सस्ता है।
टूल उपयोग और ऑटोमेशन
यही वह आयाम है जहाँ अमूर्त क्षमता का अंतर पूर्ण व्यावसायिक कार्यों में बदलता है—और यहाँ Opus 5 स्पष्ट रूप से आगे है।
Zapier के AutomationBench पर, जो मापता है कि कोई मॉडल किसी बिज़नेस टास्क को शुरुआत से अंत तक ले जा सकता है या नहीं, Opus 5 26.0% स्कोर करता है जबकि Sol 18.1%। Anthropic बताता है कि इसका पास रेट समान प्रति-कार्य लागत पर अगले सर्वश्रेष्ठ मॉडल का लगभग 1.5x है—और सबसे कम प्रयास सेटिंग पर भी, Opus 5 अन्य किसी भी मॉडल से अधिक कार्य पास करता है।
Zapier के CEO Wade Foster एक विशेष रन का वर्णन करते हैं: Opus 5 ने एक कच्चे अकाउंट-हेल्थ वर्कबुक को लिया और उसे एंड-टू-एंड चर्न-रोकथाम अनुक्रम में बदला—जोखिमग्रस्त खातों को फ़्लैग किया, सही ओनर को अलर्ट किया, और रिटेंशन ऑप्स के लिए सारांश बनाया। पिछले मॉडल पास नहीं हुए; Opus 5 ने 100% हिट किया।
Sol का प्रतिवाद स्कोर-आधारित नहीं, बल्कि स्थापत्य है। Responses API में Programmatic Tool Calling, Sol को छोटे प्रोग्राम लिखने देता है जो टूल्स का समन्वय करते हैं, मध्यवर्ती परिणाम फ़िल्टर करते हैं, और काम के चलते अगला कदम चुनते हैं—जिससे टूल-भारी कार्यों में मॉडल के राउंड-ट्रिप कम लगते हैं। यह वास्तविक दक्षता तंत्र है, पर यह अधिक कार्य सही ढंग से पूरा करने के दावे से भिन्न है—और AutomationBench बाद वाले को मापता है।
साइबरसिक्योरिटी और विज्ञान
यह वह आयाम है जहाँ दोनों विक्रेताओं ने जानबूझकर विपरीत विकल्प चुने हैं—और कुछ पाठकों के लिए यहीं से फैसला हो जाएगा।
Anthropic ने Opus 5 को साइबर कार्यों पर प्रशिक्षित नहीं किया है। वह स्पष्ट कहता है कि Opus 5 द्वि-उपयोग क्षमताओं के फ्रंटियर को आगे नहीं बढ़ाता और बायोलॉजी रिसर्च और ऑफेंसिव साइबरसिक्योरिटी दोनों में Mythos 5 से पीछे रहता है। OSS-Fuzz पर, Opus 5 कमजोरियाँ पहचानने की दर में Mythos 5 के करीब है, पर उनके लिए एक्सप्लॉइट विकसित करने में काफ़ी पीछे है। Opus 5 के साइबर क्लासिफ़ायर बायनरी-आधारित वल्नरेबिलिटी स्कैनिंग, पेन-टेस्टिंग और एक्सप्लॉइट जनरेशन को ब्लॉक करते हैं, हालाँकि Anthropic का अनुमान है कि वे Fable 5 की तुलना में लगभग 85% कम बार हस्तक्षेप करेंगे।
OpenAI ने उल्टा रास्ता लिया। Sol को OpenAI का सबसे सक्षम साइबरसिक्योरिटी मॉडल बताया गया है, और संख्याएँ बड़ी हैं:
दोनों विक्रेता इस पर एक्सेस गेट रखते हैं। OpenAI उन्नत डिफेंसिव क्षमता को Daybreak के Trusted Access for Cyber के माध्यम से रूट करता है, 1 सितंबर तक अपने सबसे साइबर-समर्थ मॉडलों की निरंतर पहुँच के लिए हार्डवेयर-बैक्ड पासकीज़ अनिवार्य करता है, और कहता है कि Sol के साइबर सेफ़गार्ड्स संभावित हानिकारक गतिविधि को पिछले मॉडलों की तुलना में लगभग दस गुना अधिक ब्लॉक करते हैं। Anthropic एक Cyber Verification Program चलाता है, जो नामांकित एंटरप्राइज़ और शोधकर्ताओं को Opus 5 का कम-प्रतिबंधित बिल्ड देता है।
विज्ञान पर, Opus 5, Anthropic के जीवन-विज्ञान मूल्याँकनों में Opus 4.8 को हर जगह पछाड़ता है—सबसे बड़े लाभ ऑर्गेनिक केमिस्ट्री (स्पेक्ट्रोस्कोपी डेटा से आणविक संरचनाएँ निकालने में 10.2 प्रतिशत अंक) और प्रोटीन सीक्वेंस-फंक्शन भविष्यवाणी (7.7 अंक) में हैं। Sol GeneBench Pro पर 28.7% और LifeSciBench पर 59.9% रिपोर्ट करता है, GPT-5.5 के क्रमशः 12% और 59.9% के मुकाबले। साझा बेंचमार्क नहीं हैं—तो यह तुलना नहीं, बल्कि दो विक्रेताओं द्वारा अलग-अलग परीक्षाओं पर अपना-अपना आकलन है।
प्राइसिंग
मानक संदर्भ पर इनपुट और कैश्ड-रीड दरें बिल्कुल मिलती हैं, जिससे एक चर हट जाता है। जो बचता है वह है Sol पर 20% आउटपुट प्रीमियम, और एक लॉन्ग-कॉन्टेक्स्ट सरचार्ज जो सिर्फ Sol वसूलता है।
टोकन दरें साथ-साथ
पूरे शॉर्ट-कॉन्टेक्स्ट लागत अंतर का असर जेनरेशन पर पड़ता है, इसलिए Sol का प्रीमियम सबसे अधिक तब चुभता है जब लंबा तर्क और लाँग-फ़ॉर्म आउटपुट चाहिए। वह रिट्रीवल कार्यों में घट जाता है जहाँ आप इनपुट ज़्यादा और आउटपुट कम भेजते हैं—जब तक कि Sol का लॉन्ग-कॉन्टेक्स्ट सरचार्ज हावी न हो जाए।
दोनों मॉडल अब फास्ट मोड देते हैं—लगभग दोगुनी कीमत पर लगभग 2.5× स्पीड। OpenAI ने 30 जुलाई, 2026 को Sol का पुराना Priority Processing फास्ट मोड में मिला दिया, इसलिए यह लीवर दोनों ओर सममित है—अंतरकारक नहीं।
वास्तविक वर्कलोड की लागत
प्रति मिलियन टोकन की दरों से बजट बनाना मुश्किल है, और एक तय अनुपात इस तुलना का सबसे महत्वपूर्ण हिस्सा छिपा देता है: इन दोनों मॉडलों के बीच का अंतर पूरी तरह वर्कलोड के आकार पर निर्भर करता है। यहाँ मानक दरों पर तीन प्रतिनिधि आकार हैं—बिना कैशिंग या बैच छूट के।
जेनरेशन-हेवी कार्यों में 20% आउटपुट प्रीमियम सीधे-सीधे गुजरता है—और Sol लगभग 19% महँगा पड़ता है। छोटे रिट्रीवल कार्यों में यह लगभग 7% तक सिमट जाता है, क्योंकि आउटपुट, समान इनपुट दर के आगे, राउंडिंग एरर जैसा है।
तीसरी पंक्ति ध्यान देने लायक है। जैसे ही कोई अनुरोध 272K इनपुट टोकन पार करता है, Sol का सरचार्ज पूरे अनुरोध पर 2× इनपुट और 1.5× आउटपुट लागू करता है, जबकि Opus 5 1M तक फ्लैट रहता है—तो प्रीमियम स्केल पर सिमटता नहीं; बिल लगभग दोगुना कर देता है। रिट्रीवल-हेवी या बड़े कॉन्टेक्स्ट वाले कामों में यह पलटाव हेडलाइन आउटपुट प्रीमियम से अधिक मायने रखता है।
एक ही टास्क की लागत अलग क्यों पड़ती है
हेडलाइन दरों के अलावा दो बातें हैं जो समान काम के बिल अलग कर देती हैं:
ultra. Ultra पर कोई रेट प्रीमियम नहीं—यह बेस Sol की तरह $5/$30 पर ही बिल होता है—लेकिन इसका मल्टी-एजेंट, उच्च-प्रयास मोड प्रति कार्य काफ़ी अधिक टोकन खर्च करता है, जो किसी एजेंटिक जॉब की लागत को बेस Sol की तुलना में लगभग तीन गुना तक पहुँचा सकता है। यह गुणक रिपोर्टेड अनुमान है, मापा हुआ नहीं।यह caveat सामान्य तौर पर आउटपुट साइड पर भी लागू होता है। प्रचलित दक्षता दावे लगभग सभी अन्य मॉडलों से तुलना करते हैं: बताया जाता है कि Sol, Coding Agent Index पर Fable 5 के आउटपुट टोकन के आधे से भी कम उपयोग करता है; और Anthropic बताता है कि Opus 5 अधिकतम reasoning पर Opus 4.8 से 26% कम टोकन जनरेट करता है। दोनों पूर्ववर्ती तुलना हैं—और ऊपर दिए गए आँकड़े नहीं बदलते।
Claude Opus 5 बनाम GPT-5.6 Sol: कब किसे चुनें
आयाम-स्तरीय नतीजे वर्कलोड पर साफ़-साफ़ मैप होते हैं, इसलिए विस्तार से बताने से पहले निर्णय-निर्देश यहाँ है।
ultraके साथ 91.9%Claude Opus 5 चुनें यदि...
GPT-5.6 Sol चुनें यदि...
ultraडिफ़ॉल्ट रूप से चार एजेंट समन्वित करता है और BrowseComp को सोलह एजेंटों पर 92.2% तक ले गया; और Responses API में मल्टी-एजेंट बीटा आपको ऐसे पैटर्न स्वयं बनाने देता है।अंतिम विचार
दो हफ्तों के अंतर से, दोनों विक्रेताओं ने उल्टे दाँव लगाए: Opus 5 नया तर्क और टास्क-पूर्णता का पीछा करता है, जबकि Sol टर्मिनल कार्य, ब्राउज़िंग और डिफेंसिव सिक्योरिटी पर झुकता है—और 20% आउटपुट प्रीमियम वसूलता है।
यदि आपकी समस्याएँ वास्तव में नई हैं, आपके एजेंटों को प्रयास नहीं बल्कि पूर्णता चाहिए, या आप लंबे कॉन्टेक्स्ट पर काम करते हैं जहाँ इसकी फ्लैट 1M प्राइसिंग Sol के सरचार्ज को मात देती है—तो Opus 5 चुनें; यदि आपके एजेंट शेल में रहते हैं, आप ऐसा एक्सप्लॉइट-पुनरुत्पादन कार्य करते हैं जिसे Opus 5 डिज़ाइन के अनुसार ब्लॉक करता है, या आप टर्मिनल और ब्राउज़िंग लीडरबोर्ड में शीर्ष पर पहुँचने के लिए
ultraवहन कर सकते हैं—तो Sol चुनें।ज्यादातर अन्य आयामों पर अंतर, किसी भी विक्रेता की मार्केटिंग के संकेत से छोटा है—इसलिए हेडलाइन बेंचमार्क के बजाय अपने प्रमुख वर्कलोड से मॉडल का मिलान करें।