
लर्निंग पाथ
एआई मूलभूत बातें
10 घंटा
किसी मॉडल को कोड भेजना आसान हिस्सा है। असल काम उसके इर्द-गिर्द होता है: यह तय करना कि वह किन फ़ाइलों को पढ़ सकता है, वह जिन टूल कॉल्स की माँग करता है उन्हें चलाना, यह जानना कि उसे कब रुकना चाहिए, और यह चुनना कि तर्क-वितर्क (reasoning) पर कितना खर्च करना है।
Claude Opus 5 उस आख़िरी फैसले को स्पष्ट करता है। effort पैरामीटर में पाँच सेटिंग्स हैं, और Anthropic का कहना है कि अधिक खर्च ठीक उसी काम पर फल देता है जो एक कोडिंग एजेंट करता है। यह दावा दोहराना आसान है और जाँचना कठिन, इसलिए मैं एक संकीर्ण उत्तर चाहता था। एक वास्तविक बग पर, जहाँ टेस्ट या तो पास होते हैं या फेल, क्या effort बढ़ाने से बेहतर मरम्मत मिलती है?
पता लगाने के लिए, हम एक छोटा सा बग-फिक्सिंग एजेंट बनाएँगे और वही कार्य हर effort स्तर पर चलाएँगे। इस दौरान हम कवर करेंगे:
claude-opus-5 को कॉल करना और ऐसी प्रतिक्रिया को पार्स करना जो thinking ब्लॉक से शुरू होती है
effort से reasoning की गहराई को नियंत्रित करना और उसके अनुसार max_tokens का आकार चुनना
ऐसा मल्टी-टर्न टूल लूप चलाना जो thinking ब्लॉक्स और टूल एरर्स के बावजूद टिकाऊ रहे
गद्य के बजाय एक सत्यापित Pydantic रिपोर्ट लौटाना
सभी पाँच effort स्तरों पर सफलता, टोकन, लेटेंसी, और लागत को मापना
एक ही रन के भीतर prompt caching से दोहराए गए इनपुट खर्च को घटाना
अंत बता देता हूँ: इस कार्य पर, सबसे सस्ती सेटिंग ने हर रन में बग ठीक कर दिया, और उससे ऊपर कुछ भी बेहतर नहीं था। यह परिणाम इसी रेपो तक सीमित है; ज़्यादा उपयोगी हिस्सा वह रिग है जिसने इसे पैदा किया।
एजेंट एक बग रिपोर्ट और एक छोटे Python रेपो तक नियंत्रित पहुँच लेता है, फिर समस्या पर काम करता है: फ़ाइलों की सूची बनाना, संबंधित फ़ाइलें पढ़ना, सूट चलाना, पैच करना, फिर से चलाना, और रिपोर्ट करना।
Claude फ़ाइल सिस्टम को कभी नहीं छूता। यह नाम और JSON आर्ग्युमेंट्स के साथ एक टूल रिक्वेस्ट इमिट करता है, और हमारा Python कोड तय करता है कि उसे चलाना है या नहीं और क्या वापस भेजना है। यही सीमा पूरी सुरक्षा मॉडल है—जब भी एजेंट अपने आप काम करता दिखे, इसे याद रखना चाहिए।
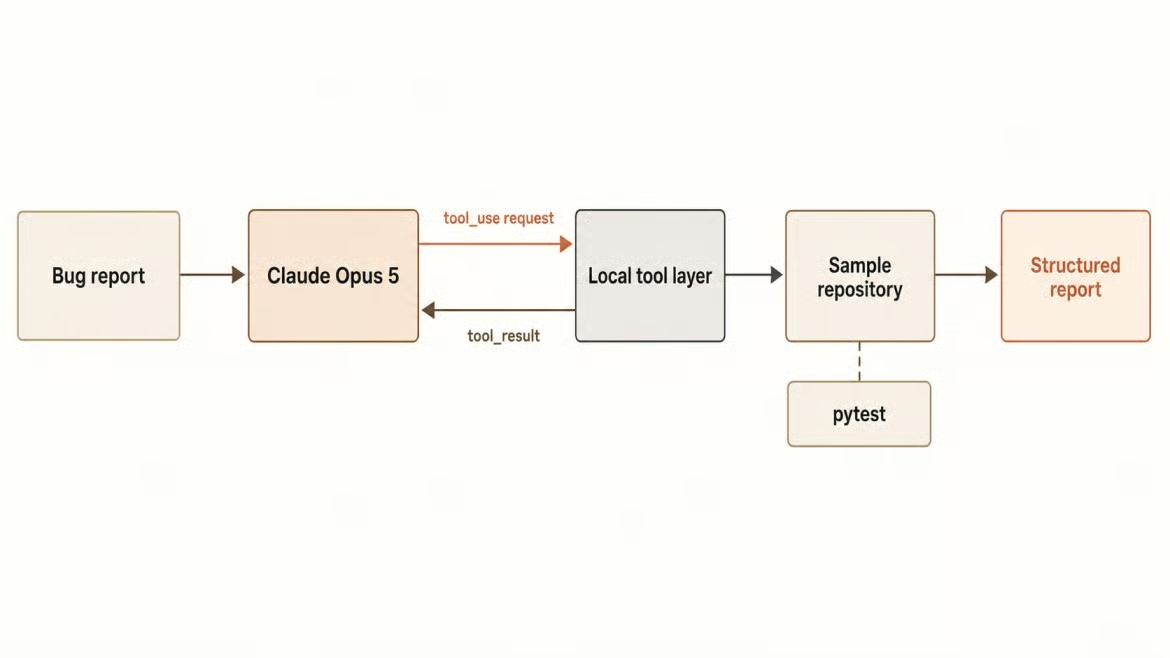
बग रिपोर्ट नियंत्रित टूल्स से होकर बहती है। चित्र: लेखक।
आपको Python 3.10 या नया, claude-opus-5 की एक्सेस वाला API की, सैंपल रेपो को रीसेट करने के लिए Git, और इतना pytest ज्ञान चाहिए कि आप फेल्योर पढ़ सकें। तैयार प्रोजेक्ट GitHub पर है, यदि आप इसे समूचा पढ़ना चाहें; नीचे के सेक्शंस इसे टुकड़ों में बनाते हैं।
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
.env.example को .env में कॉपी करें और अपनी की डालें। यह की इससे बनी किसी भी चीज़ के सर्वर साइड पर ही रहनी चाहिए—कभी भी रिक्वेस्ट बॉडी में नहीं और कभी भी लॉग लाइन में नहीं।
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
ये चार कीमतें आगे ज़रूरी होंगी। हर चीज़ को बेस इनपुट रेट पर चार्ज करना, cache writes को एक चौथाई कम आँकता है और cache reads को दस गुना ज़्यादा—ऐसी गलती जो किसी बेंचमार्क को उससे बेहतर दिखा दे जितना वह था।
न्यायसंगत तुलना के लिए ऐसा बग चाहिए जो हर बार एक ही तरह से फेल हो, इसलिए मैंने एजेंट से पहले फ़िक्स्चर लिखी। सैंपल रेपो एक बिलिंग सेवा है जिसमें एक साझा डेट हेल्पर, एक subscriptions मॉड्यूल, और एक invoices मॉड्यूल है। हेल्पर एक व्यवहार को डॉक्यूमेंट करता है और दूसरा लागू करता है।
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days ट्रंकेट करता है, तो ट्रायल के दस घंटे बचे होने पर भी शून्य दिन रिपोर्ट होते हैं। दो मॉड्यूल यह हेल्पर कॉल करते हैं, इसलिए एक डिफेक्ट दो असंबंधित फेल्योर के रूप में सतह पर आता है: test_trial_active_on_final_day ग्राहकों को समय से पहले लॉक कर देता है, और test_prorated_credit_counts_partial_day एक दिन का रिफंड कम कर देता है।
बग रिपोर्ट सिर्फ़ पहले लक्षण का ज़िक्र करती है, जैसा कि सपोर्ट टिकट करता। एक जाल भी है: is_trial_active को ज़ीरो स्वीकारने के लिए पैच करना रिपोर्टेड टेस्ट पास करा देता है और invoice टेस्ट को टूटा छोड़ देता है, इसलिए उथली फिक्स पकड़ में आ जाती है। बेसलाइन दो फेल्योर और चार पास हैं, Git में कमिटेड ताकि git checkout -- . रन के बीच इसे रिस्टोर कर दे।
किसी भी टूल से पहले, पुष्टि करें कि ऑथेंटिकेशन और रिस्पॉन्स पार्सिंग काम करती हैं। Messages API को एक मॉडल स्ट्रिंग, आवश्यक max_tokens, और एक messages ऐरे चाहिए।
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
वह पहला print इसी अभ्यास की बात है। यह ['thinking', 'text'] लौटाता है, क्योंकि thinking डिफ़ॉल्ट रूप से ऑन है और thinking ब्लॉक पहले आता है।
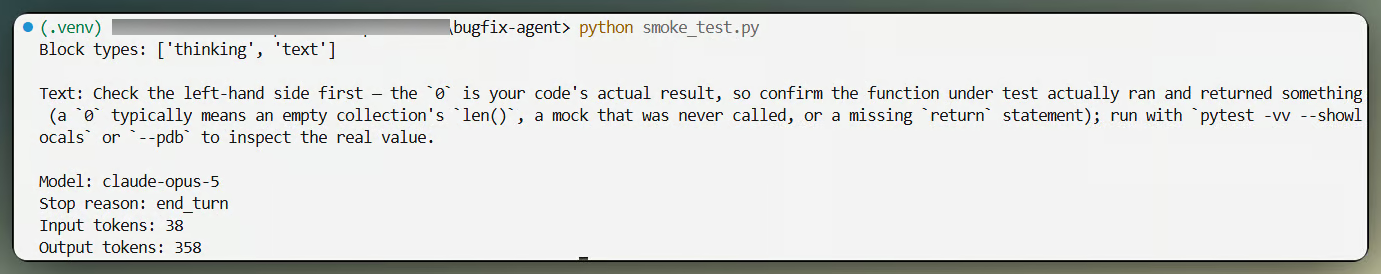
पहली कॉल में पहले thinking फिर text आता है। चित्र: लेखक।
कोई भी कोड जो response.content[0].text तक पहुँचता है, Opus 5 पर AttributeError उठाएगा। ब्लॉक टाइप से फ़िल्टर करें। इसी दौरान, temperature, top_p, और top_k को किसी भी पोर्ट की गई रिक्वेस्ट से हटा दें, क्योंकि इस मॉडल पर non-default मान 400 लौटाते हैं।
Thinking और effort दो कंट्रोल हैं जिन्हें अक्सर मिला दिया जाता है। Thinking यह है कि मॉडल उत्तर देने से पहले तर्क करता है या नहीं, जैसा कि पहली कॉल ने दिखा दिया। Effort यह है कि वह कितना तर्क करता है—हर आउटपुट टोकन पर, टूल कॉल्स सहित। नीचे के उपखंड सीढ़ी, जिस टोकन छत से वह टकराता है, और वह एक संयोजन जिसे API ठुकराता है, कवर करते हैं।
Effort output_config के अंदर सेट होता है, और किसी बीटा हेडर की ज़रूरत नहीं।
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
API डिफ़ॉल्ट high है, और "high" को स्पष्ट रूप से पास करना इसे छोड़ देने के बराबर है। Anthropic सुझाता है कि एजेंटिक कोडिंग के लिए xhigh से शुरू करें और नोट करता है कि low और medium Opus 5 पर पहले के Opus मॉडलों से मज़बूत हैं। उनका मार्गदर्शन यह भी चेतावनी देता है कि max सरल कार्यों पर ओवरथिंक कर सकता है—जो निकला मेरे मापन का सबसे दिलचस्प हिस्सा।
जैसा मैंने पहले कहा, max_tokens reasoning के साथ-साथ उत्तर को भी कवर करता है, इसलिए किसी non-thinking मॉडल के लिए ट्यून किया गया मान Opus 5 को काम के बीच में ट्रंकेट कर देगा। एक बाधा भी है जो लोगों को चौंका देती है।
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
SDKs 21,333 max_tokens से ऊपर non-streaming रिक्वेस्ट को ठुकराते हैं। यह क्लाइंट-साइड वेलिडेशन है, API नियम नहीं, इसलिए उपाय है स्ट्रीम करना: लूप client.messages.stream() कॉल करता है और get_final_message() पढ़ता है, और वही 32,000 पार हो जाते हैं। मैं वहीं रुका क्योंकि यह ऊँचे effort स्तरों के लिए जगह छोड़ता है।
आप thinking बंद कर सकते हैं, पर केवल high effort या उससे नीचे। इसे xhigh या max के साथ जोड़ना सीधे खारिज हो जाता है।
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
high effort से ऊपर thinking डिसेबल स्वीकार नहीं। चित्र: लेखक।
स्वीकृत कॉल के ब्लॉक लिस्ट पर ध्यान दें: सिर्फ़ ['text']—thinking ब्लॉक ग़ायब। लागत नियंत्रण के लिए effort कम करना वैसे भी सुरक्षित है, इसलिए मैंने thinking पूरे समय ऑन रखी।
टूल्स किसी मॉडल को एजेंट में बदलते हैं, और यहीं एजेंट असुरक्षित भी हो सकता है। हर परिभाषा एक नाम, एक विवरण, और एक JSON इनपुट स्कीमा है, और हर एक की कीमत हर रिक्वेस्ट पर इनपुट टोकन्स में लगती है। मैंने सेट को पाँच तक रखा, जिन्हें नीचे उनकी संभावित क्षति के हिसाब से समूहित किया है।
list_files और search_code मॉडल को संबद्ध फ़ाइल ढूँढने देते हैं, बिना रेपो को प्रॉम्प्ट में पेस्ट किए। read_file रेपो-रिलेटिव पाथ से एक फ़ाइल खींचता है, और सुरक्षा जाँचें यहीं रहती हैं।
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
तुलना से पहले resolve करें, वरना ../../.ssh/id_rsa सीधे आपके सैंडबॉक्स से बाहर निकल जाएगा। लौटाई गई फ़ाइलों को 8,000 अक्षरों पर कैप करें, क्योंकि हर टूल परिणाम हर बाद की रिक्वेस्ट पर फिर से भेजा जाता है और आप हर बार उसकी कीमत चुकाते हैं।
run_tests कोई आर्ग्युमेंट नहीं लेता। कमांड कॉन्फ़िगरेशन में फिक्स्ड है, इसलिए मॉडल मनमाने शेल कमांड माँगने का कोई तरीका नहीं रखता।
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
एक का allowlist सबसे मज़बूत allowlist है। यदि बाद में आपको और कमांड चाहिएँ, तो उन्हें अलग-अलग नाम वाले टूल्स के रूप में जोड़ें, न कि एक command आर्ग्युमेंट के रूप में।
लिखने के लिए मैंने unified diff की बजाय exact-string replacement का उपयोग किया, क्योंकि diff वाइटस्पेस पर ऐसे तरीके से फेल होते हैं जो एक टर्न बर्बाद कर देते हैं। टूल non-Python फ़ाइलों को ठुकराता है, पैच साइज कैप करता है, और अस्पष्टता से इनकार करता है।
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
ये एरर्स लूप को क्रैश करने के बजाय Claude को टूल रिज़ल्ट्स के रूप में वापस जाते हैं, और मॉडल उन्हें पढ़कर अधिक संदर्भ के साथ फिर कोशिश करता है।
टुकड़े जगह पर हों तो लूप छोटा है। टूल परिभाषाओं के साथ टास्क भेजें, लौटे ब्लॉक्स देखें, जो माँगा गया है उसे चलाएँ, परिणाम वापस भेजें, और जब तक मॉडल माँगना रोक न दे, दोहराएँ।
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
वहाँ तीन लाइनें load-bearing हैं। response.content को पूरा ऐड करना, बजाय सिर्फ़ काम के ब्लॉक्स के, thinking और redacted_thinking को जस का तस रखता है; उन्हें फ़िल्टर करेंगे तो मॉडल हर टूल परिणाम के बाद अपनी reasoning फिर से शुरू करेगा। tool_result ब्लॉक्स यूज़र मैसेज में सबसे पहले आने चाहिए, क्योंकि उनके पहले टेक्स्ट डालने पर 400 मिलता है। और is_error Claude को बताता है कि कोई टूल फेल हुआ, जो एक ख़ामोश खाली स्ट्रिंग से बेहतर है।
सिस्टम प्रॉम्प्ट हर रन में फिक्स्ड रहता है ताकि तुलना मायने रखे। यह मॉडल से कहता है कि एडिट करने से पहले जाँच करें, रिपोर्ट किए गए लक्षण के बजाय मूल कारण ढूँढें, सबसे छोटा काम करने वाला बदलाव करें, और सूट चलाना टास्क का हिस्सा समझें। जो यह छोड़ता है वह है "अपने काम को दोबारा जाँचें।" Opus 5 खुद वेरिफ़ाई करता है, और Anthropic का मार्गदर्शन है कि माइग्रेट करते समय इन निर्देशों को हटा दें, क्योंकि वे पैच को बेहतर किए बिना लेटेंसी और टोकन बढ़ाते हैं।
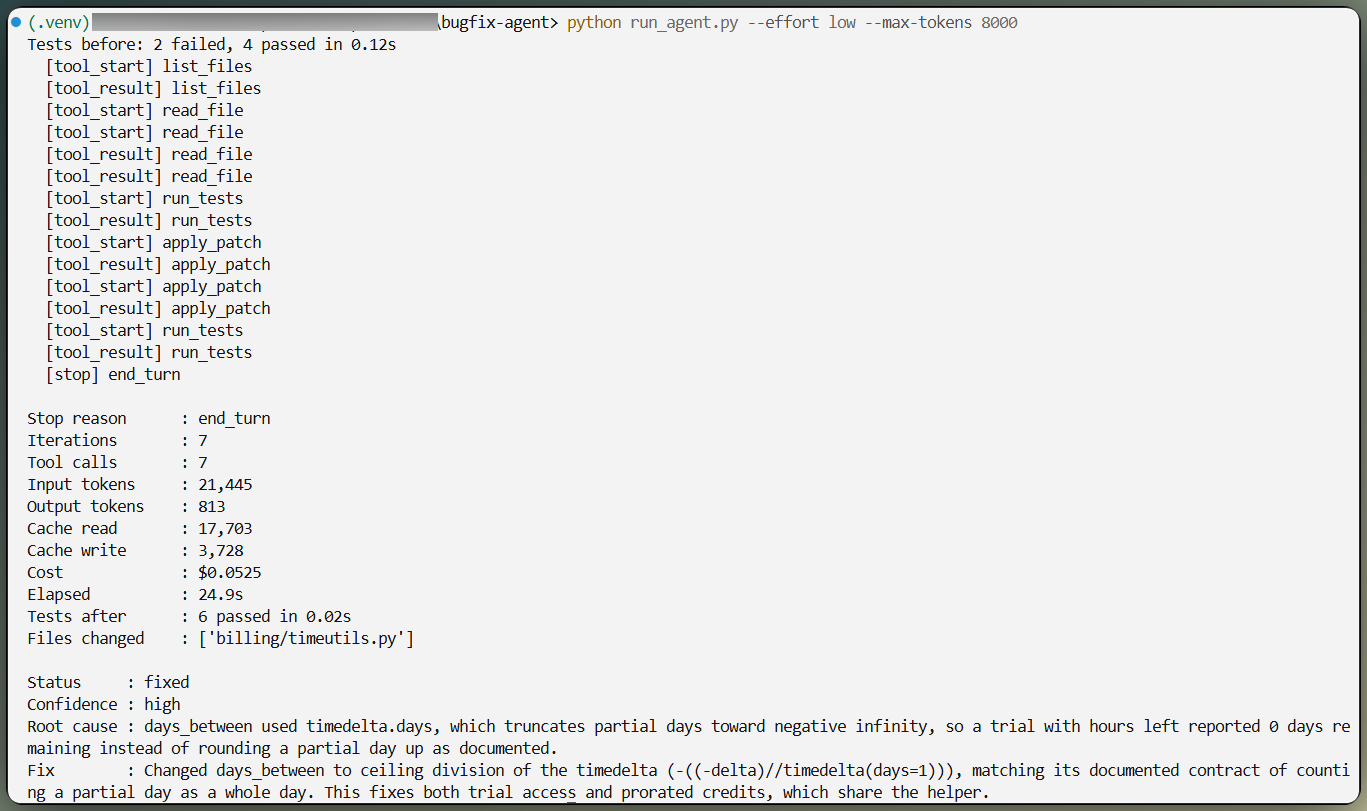
एजेंट जाँचता है, पैच लगाता है, फिर टेस्ट्स दोबारा चलाता है। चित्र: लेखक।
एक रन के लिए गद्य ठीक है। कई की तुलना करनी पड़े तो मुझे एक typed ऑब्जेक्ट चाहिए, इसलिए लूप Pydantic मॉडल को output_format के रूप में पास करता है और SDK उसे constrained decoding वाले JSON स्कीमा में बदल देता है।
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
वैलिडेटर अपनी जगह कमाता है। Structured outputs enum के कैपिटलाइज़ेशन की गारंटी नहीं देते, इसलिए "high" की उम्मीद वाला स्कीमा "High" पा सकता है—बिना एरर और बिना किसी विशेष stop reason के—और सख़्त Literal वैलिडेशन किसी मूलतः सही प्रतिक्रिया को ठुकरा देता।
लेटेंसी और लागत को इस स्कीमा से बाहर रखें। मॉडल बताता है कि उसने क्या निष्कर्ष निकाला; रनर मापता है कि क्या हुआ—pytest दोबारा चलाकर और git diff पढ़कर। बाद में मैं इसी अलगाव का आभारी था, कारण बेंचमार्क स्पष्ट कर देता है।
यही प्रयोग इस ट्यूटोरियल का मक़सद है: वही बग, वही प्रॉम्प्ट, वही टूल्स, low, medium, high, xhigh, और max पर। आउटपुट निर्धारक नहीं है, और सैंपलिंग पैरामीटर्स इस मॉडल पर ठुकराए जाते हैं, इसलिए हर स्तर को दोहराना ही मेरे पास एकमात्र कंट्रोल है।
हर रन उस साफ़ बेसलाइन कमिट से शुरू होता है, फिर पहले और बाद में सूट को मापता है। बग रिपोर्ट, सिस्टम प्रॉम्प्ट, टूल परिभाषाएँ, iteration कैप, और max_tokens हर जगह समान हैं, और सिर्फ़ effort स्ट्रिंग बदलती है। मैंने हर स्तर तीन बार चलाया।
एक बजट गार्ड पूरी चीज़ को लपेटता है, हर रिक्वेस्ट के बाद वास्तविक चार-दरों की लागत जोड़ता है और एक छत पर रोक देता है। एजेंट लूप्स ओवरस्पेंड का आसान तरीका हैं, और आपके नियंत्रण वाली स्टॉप कंडीशन बाद में पता चलने से बेहतर है।
यहाँ 26 जुलाई, 2026 को मापे गए, हर स्तर पर तीन रन के औसत हैं।
|
Effort |
Suite पास |
टूल कॉल्स |
आउटपुट टोकन |
पहले आउटपुट तक समय |
कुल समय |
प्रति रन लागत |
|
|
3/3 |
8.0 |
827 |
2.9s |
24s |
$0.0387 |
|
|
3/3 |
8.0 |
1,008 |
2.7s |
26s |
$0.0466 |
|
|
3/3 |
10.0 |
1,352 |
2.9s |
29s |
$0.0659 |
|
|
3/3 |
11.3 |
1,546 |
2.8s |
35s |
$0.0778 |
|
|
2/3 |
8.3 |
1,787 |
6.6s |
38s |
$0.0762 |
हर स्तर जिसने रेपो से एंगेज किया, साझा डेट हेल्पर में वही root cause पाया और एक फ़ाइल में करीब चार पंक्तियों से उसे ठीक किया। किसी ने भी चारा नहीं लिया और ट्रायल चेक को पैच नहीं किया। पूरे पंद्रह-रन मैट्रिक्स की लागत $0.92 थी।
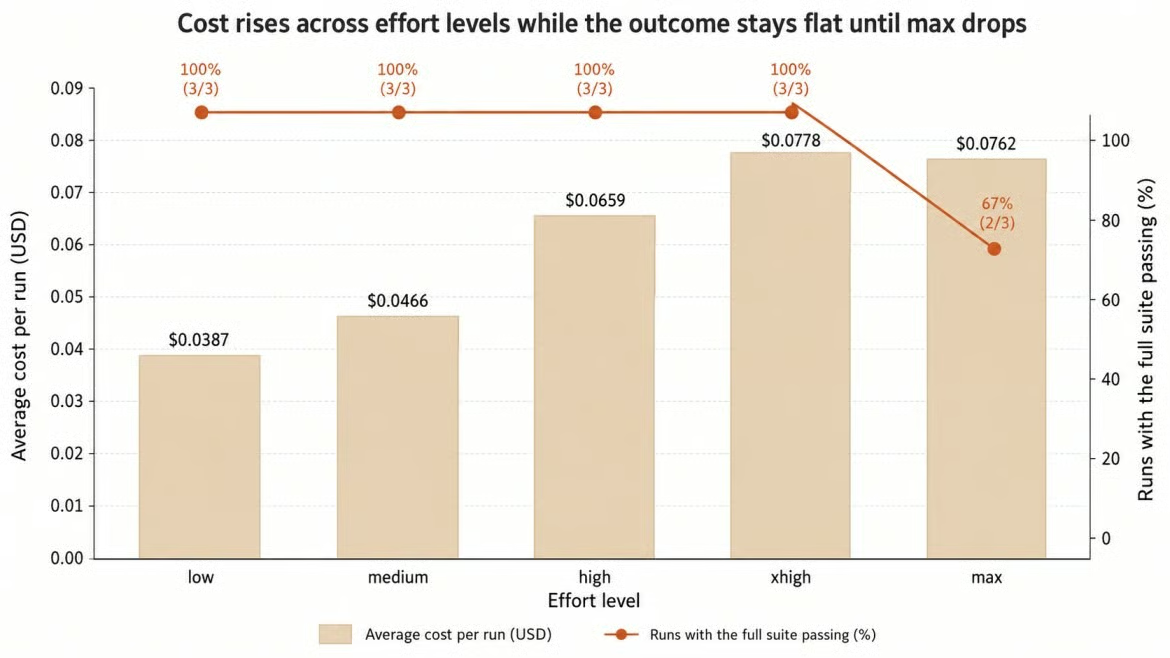
लागत बढ़ती है, नतीजा नहीं। चित्र: लेखक।
ईमानदार पढ़ाई यह है कि यह टास्क सीढ़ी के शीर्ष और तल को अलग करने जितना कठिन नहीं था। low से xhigh पर जाना लागत को दोगुना और ग्यारह सेकंड जोड़ गया—पर नतीजा समान रहा। इसे शिप करते हुए, मैं low चलाऊँगा और बचत टेस्ट कवरेज पर खर्च करूँगा।
वह max पंक्ति स्पष्टीकरण माँगती है। उसके तीन में से एक रन ने बिना एक भी टूल कॉल के पहले टर्न में एक स्कीमा-वैध रिपोर्ट लौटाई, जिसमें root_cause "b0" सेट था और fix_summary खाली था। Pydantic ने उसे स्वीकार किया क्योंकि आकार सही था। टेस्ट्स अनछुए थे। उसे छोड़ दें तो बाकी दो max प्रयासों ने 12.5 टूल कॉल्स और $0.1112 प्रति रन पर बग ठीक किया—लगभग low की लागत से तीन गुना।
मुझे वह विफलता तालिका से ज़्यादा सिखाती है। एक स्कीमा संरचना की गारंटी देता है, पदार्थ की नहीं, और कोई एप्लिकेशन जो report.status पर भरोसा करता वह एक ऐसे रन पर "partial" सफलता लॉग करता जिसने कुछ नहीं किया। रनर ने उसे पकड़ा क्योंकि उसने मॉडल पर यक़ीन करने के बजाय pytest चलाया। इस लेख से आप जो भी लें, इसे ज़रूर लें। और चूँकि आपका टास्क मेरा नहीं है, पूरे को एक विधि की तरह लें, न कि परिणाम की तरह।
कैशिंग वहीं है जहाँ लूप सस्ता होता है, और यह एक रन के भीतर काम करता है न कि effort स्तरों के पार। effort मान बदलने से cached prefixes अमान्य हो जाते हैं, इसलिए हर स्तर अपना cache-creation खर्च खुद देता है और कोई गरम कैश आगे नहीं ले जाया जाता। एक रन के अंदर यह अलग है, क्योंकि सिस्टम प्रॉम्प्ट और टूल परिभाषाएँ नहीं बदलतीं जबकि हिस्ट्री बढ़ती है।
एक टॉप-लेवल cache_control फ़ील्ड ऑटोमैटिक कैशिंग ऑन करता है, जो ब्रेकपॉइंट को आख़िरी cacheable ब्लॉक पर रखता है और बातचीत के बढ़ने के साथ उसे आगे बढ़ाता है।
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
दो लगातार टर्न प्रभाव साफ़ दिखाते हैं:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108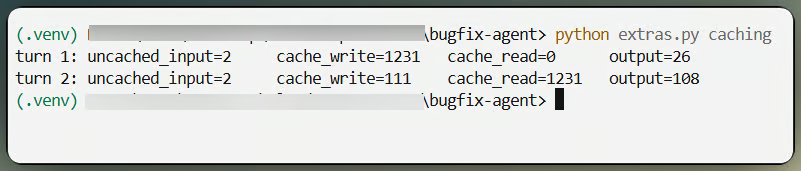
अगले टर्न पर cached प्रीफ़िक्स वापस पढ़ा गया। चित्र: लेखक।
स्थिर प्रीफ़िक्स 1,231 टोकन्स है, जो मैंने पहले बताए कैश मिनिमम से आराम से ऊपर है। दूसरे टर्न पर यह इनपुट रेट के एक-दसवें पर पढ़ा जाता है जबकि सिर्फ़ नया टूल परिणाम लिखा जाता है। एक पूरी xhigh रन में, करीब 36,200 इनपुट टोकन्स में से लगभग 32,600 कैश से आए। कैशिंग आउटपुट टोकन्स के लिए कुछ नहीं करती।
यह पैटर्न मुझे सबसे उपयोगी लगा। एजेंट को read-only टूल्स से शुरू करें, फिर केवल तब write एक्सेस दें जब उसने समस्या का निदान कर लिया हो। साधारण तरीके से, टूल जोड़ने का मतलब tools ऐरे एडिट करना है, जो cached प्रीफ़िक्स के सामने बैठता है और पूरी बातचीत के कैश को अमान्य कर देता है।
Mid-conversation टूल बदलाव इसे सुलझाते हैं। हर टूल पहले से डिक्लेयर करें ताकि ऐरे कभी न बदले, फिर tool_addition और tool_removal ब्लॉक्स से किसी बिंदु से आगे व्यक्तिगत टूल्स ऑफ़र या वापस लें। ब्लॉक्स role: "system" मैसेज के अंदर चलते हैं, और सिस्टम मैसेज messages में पहला एंट्री नहीं हो सकता। कोई भी बाधा वहाँ नहीं है जहाँ आप उसे ढूँढेंगे, और मुझे दोनों का पता उसी तरह चला जैसा आप सोच रहे हैं।
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
tool_removal को बाद में tool_addition से बदलें और टूल वापस आ जाता है। मेरे रन में मॉडल ने पाँच टर्न read-only जाँच-पड़ताल पर बिताए, अपने निदान के साथ रुका, और तभी apply_patch मिला, जिसे उसने छठे और सातवें टर्न पर इस्तेमाल किया, इसके बाद सूट पास हुआ। कैश पूरे समय टिका रहा, 25,557 टोकन्स पढ़े गए। लिखने की पहुँच साक्ष्य आने के बाद आई—यही इस पैटर्न का असली तर्क है। पहले फिक्स्ड-टूल लूप चलाएँ, फिर इसे जोड़ें।
एजेंटिक टास्क कई रिक्वेस्ट्स होते हैं, इसलिए लागत अंतिम प्रतिक्रिया में नहीं बल्कि योग में रहती है। हर प्रतिक्रिया पर चार नंबर वापस आते हैं, और हर एक अलग दर पर बिल होते हैं।
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
कुल इनपुट तीनों इनपुट फ़ील्ड्स का योग है, क्योंकि input_tokens अकेले सिर्फ़ वही गिनता है जो आख़िरी कैश ब्रेकपॉइंट के बाद आता है—जो कम रिपोर्ट करने का आम तरीका है। आउटपुट टोकन्स में thinking और टूल कॉल्स भी शामिल हैं, और इनपुट रेट के पाँच गुने पर वे ऊपर के हर रन पर हावी रहते हैं।
जैसे-जैसे आप स्केल करते हैं, एक बात देखें: पिछले टर्न्स के thinking ब्लॉक्स संदर्भ में बने रहते हैं और हर बाद के टर्न पर फिर से बिल होते हैं, इसलिए लंबे लूप्स टूल परिणामों के सुझाव से ज़्यादा महँगे पड़ते हैं। ऑफ़लाइन इवैल्यूएशन के लिए Batch API दोनों दरें आधी करता है। Fast मोड उल्टा चलता है—$10 और $50 प्रति मिलियन टोकन्स पर—एक एक्सेस-गेटेड रिसर्च प्रीव्यू के रूप में।
पूरे लूप को कैप करने का भी एक तरीका है, न कि एक रिक्वेस्ट को। Task budgets मॉडल को एक सलाहकारी भत्ता और एक काउंटडाउन देते हैं जिसकी रफ़्तार वह देखता है, बीटा में task-budgets-2026-03-13 हेडर के पीछे, 20,000 टोकन्स की फ़्लोर के साथ। मेरे पास इस पर एक सेक्शन तैयार था और मैंने काट दिया, क्योंकि यहाँ कोई फर्क नहीं मापा और एक non-result को तीन पैराग्राफ़ नहीं चाहिए। वही उम्मीद रखें जब काम बजट के आस-पास भी न पहुँचे।
अधिकांश मौजूदा Claude कोड मॉडल स्ट्रिंग बदलते ही चल जाता है। विफलताएँ कुछ जगहों पर क्लस्टर होती हैं, और एजेंट बनाते हुए हम हर एक से गुज़रे, तो इसे चेकलिस्ट समझें, नई व्याख्या नहीं। Anthropic का माइग्रेशन गाइड पूरी वर्ज़न लेकर चलता है।
response.content[0] अब अक्सर टेक्स्ट नहीं, thinking ब्लॉक होता है
ऐसा लूप जो चुने हुए ब्लॉक्स से असिस्टेंट मैसेज को फिर बनाता है, thinking और redacted_thinking गिरा देता है
max_tokens non-thinking मॉडल के लिए ट्यून होने पर ट्रंकेट करेगा, और 21,333 से ऊपर कुछ भी स्ट्रीम होना चाहिए
thinking डिसेबल करना xhigh या max effort पर 400 लौटाता है
Non-default temperature, top_p, और top_k ठुकराए जाते हैं
पुराने प्रॉम्प्ट्स से लाई गई verification निर्देश Opus 5 को over-verify करा देते हैं
Priority Tier और web fetch टूल Opus 5 पर उपलब्ध नहीं हैं
Effort पिछली मॉडल के लिए ट्यून किए मान की बजाय नए सिरे से स्वीप डिज़र्व करता है
आख़िरी बात पर मैं सबसे ज़ोर से दलील दूँगा, और यह लेख वही दलील है। मेरा ट्यून किया हुआ सेटिंग निकला सीढ़ी पर सबसे सस्ता।
शिप करने से पहले दो चीज़ें बदलती हैं। एजेंट-जनरेटेड कोड अविश्वसनीय कोड है, इसलिए टूल लेयर को CPU, मेमोरी, और समय सीमाओं वाले आइसोलेटेड वातावरण में होना चाहिए, और जनरेटेड पैच मर्ज होने से पहले किसी इंसान के सामने होना चाहिए।
दूसरी बात कम स्पष्ट है। Opus 5 सेफ़्टी क्लासिफ़ायर्स चलाता है, और सुरक्षा-एडजेसेंट कोड पढ़ता एजेंट "cyber" सीमा के क़रीब बैठता है, पर एक रिफ़्यूज़ल HTTP 200 के रूप में stop_reason: "refusal" के साथ आता है, इसलिए 5xx रेट्स पर बना मॉनिटरिंग उसे कभी देखता ही नहीं। रिफ़्यूज़ल्स को अलग से इंस्ट्रूमेंट करें, stop_reason पर ब्रांच करें न कि उसके नीचे के stop_details फ़ील्ड्स पर, जो null हो सकते हैं, और बेंचमार्क के दौरान fallbacks ऑफ़ कर दें ताकि आपको पता रहे कि किस मॉडल ने उत्तर दिया।
Opus 5 तब उपयोग करें जब गलत उत्तर की कीमत रिक्वेस्ट से ज़्यादा हो। मल्टी-फ़ाइल डिबगिंग, root-cause विश्लेषण, रेपो-वाइड रिव्यू, लंबे टूल लूप्स, और माइग्रेशन प्लानिंग सब फिट होते हैं, और effort सीढ़ी आपको रूटीन मामलों को सस्ते में चलाने और कठिन पर एस्केलेट करने देती है।
फ़ॉर्मैटिंग, क्लासिफ़िकेशन, और उच्च-वॉल्यूम निम्न-जटिलता के काम के लिए इसे छोड़ें, जहाँ Claude Sonnet 5 बेहतर सौदा है। उसे भी छोड़ें किसी ऐसी चीज़ के लिए जिसे आप वेलिडेट नहीं कर सकते, क्योंकि यहाँ सारा मूल्य एक टेस्ट सूट से आया जिसने ईमानदारी से जवाब दिया। Fable 5 के लिए दोगुना भुगतान वही काम पर अपना खर्च निकालता है जो मैंने ऊपर झंडा किया।
वास्तविक रूटिंग सलाह मैं यह दूँगा कि टास्क की कठिनाई मापें और effort स्तर उसी से चुनने दें, बजाय हर चीज़ को सीढ़ी के शीर्ष पर भेजने के क्योंकि वह ज़्यादा सुरक्षित लगता है। यह ज़्यादा सुरक्षित नहीं है। जैसा बेंचमार्क ने दिखाया, यह वही पैच पाने का महँगा तरीका था, और एक बार यह कुछ न करने पर भी रिपोर्ट दे गया।
रेपो में Streamlit ऐप आपको इसे खुद चलाने देता है: एक effort स्तर चुनें, reasoning और टूल कॉल्स को लाइव आते देखें, और उसी रन से टोकन्स, लागत, और लेटेंसी पढ़ें। यह रेपो को उसी तरह रीसेट करता है जैसे बेंचमार्क ने, इसलिए जो तालिका यह बनाता है वह आपकी माप है, मेरी नहीं। नीचे की स्क्रीन रिकॉर्डिंग वर्कफ़्लो दिखाती है।
DataCamp के साथ सीखें
लर्निंग पाथ
कोर्स
कोर्स