
कोर्स
Software Development with Claude Code
4 घंटा
8.8K
अपडेट (1 जुलाई, 2026): Claude Fable 5 तक पहुंच बहाल कर दी गई है, और अब यह Claude Platform, Claude.ai, Claude Code, और Claude Cowork पर वैश्विक रूप से उपलब्ध है, क्योंकि निर्यात नियंत्रण आदेश हटा लिया गया है। Mythos 5 अब भी केवल चयनित Project Glasswing भागीदारों तक सीमित है।
अपडेट (2 सितंबर, 2026): Anthropic ने इस मॉडल का उत्तराधिकारी प्रकाशित कर दिया है। हमारे Claude Fable 5.1 गाइड और Claude Fable 5.1 API ट्यूटोरियल में इसके बारे में विस्तार से पढ़ें।
हमने पहली बार Claude Mythos के बारे में अप्रैल में सुना था जब हमने Claude Opus 4.7 के रिलीज़ पर लिखा था। उस समय हमारी समझ थी कि Opus 4.7, भले ही अपने आप में बेहद प्रभावशाली है, सार्वजनिक रूप से उपलब्ध सर्वश्रेष्ठ मॉडल सिर्फ इसलिए था क्योंकि मिथोस-क्लास मॉडल व्यापक रिलीज़ से रोके गए थे।
अब, Anthropic ने हमें Claude Fable 5 दिया है, जो कि सामान्य उपयोग के लिए सुरक्षित एक मिथोस-क्लास मॉडल है। निस्संदेह यह महत्वपूर्ण बेंचमार्क परीक्षणों में नया अग्रणी है, जिनमें ज्ञान-कार्य, सॉफ्टवेयर इंजीनियरिंग और वैज्ञानिक अनुसंधान जैसी चीजें शामिल हैं। यह Anthropic के लिए बड़ी जीत है, जिसने सिर्फ आठ दिन पहले ही यू.एस. में IPO के लिए फाइल किया है।
इस लेख में, हम Claude Fable 5 को करीब से देखेंगे, और बाजार में उपलब्ध अन्य मॉडलों जैसे GPT-5.5 और Gemini 3.1 Pro के साथ-साथ Claude के अपने मॉडल, जैसे Opus 4.8, की तुलना करेंगे। हम यह भी बताएंगे कि इस मॉडल का उपयोग कब करें, क्योंकि यह अधिक महंगा है। यदि आप Claude में नए हैं और सीखने के इच्छुक हैं, तो मैं हमारी Claude सीखने की गाइड देखने की सिफारिश करता/करती हूं।
Claude Fable 5 वह नाम है जो Anthropic अपने सबसे नए और सबसे सक्षम मॉडल को दे रहा है। यह एक मिथोस-क्लास मॉडल है, लेकिन इसमें खासकर साइबर सुरक्षा जैसे महत्वपूर्ण क्षेत्रों में अहम सुरक्षा उपाय शामिल हैं।
उपयोगकर्ता के लिए, इसका मतलब है कि कुछ प्रश्नों का उत्तर अगले-इन-लाइन मॉडल, Claude Opus 4.8, द्वारा दिया जाएगा। Anthropic का अनुमान है कि इस तरह का रीरूटिंग सभी क्वेरीज़ में 5% से कम मामलों में होता है, और Anthropic को लगता है कि यह एक रूढ़ अनुमान है। यह अच्छा ही है, क्योंकि इसमें साइबर सुरक्षा चिंताएं शामिल हैं। बेशक, यह प्रतिशत आपके काम के प्रकार के आधार पर काफी बदल भी सकता है।
हम Claude Fable 5 के बारे में खासतौर पर उत्साहित हैं। मॉडल अब इतना सक्षम है कि इसकी उपयोगिता नए क्षेत्रों में पहुंच गई है: साइबर डिफेंडर महत्वपूर्ण सिस्टम को सुरक्षित करने के लिए मॉडल का उपयोग करेंगे, और जीवन विज्ञान के शोधकर्ता नए चिकित्सकीय उपचारों में सुधार के लिए मॉडल का उपयोग कर सकते हैं। खगोलभौतिकीविद् इन मॉडलों का उपयोग आकाशगंगाओं का मानचित्रण करने में कर सकते हैं। और भी बहुत कुछ।
यदि आपने रिलीज़ पढ़ी है, तो आपने Claude Mythos 5 के बारे में भी सुना होगा। यदि आप सोच रहे हैं: Claude Mythos 5 वही अंतर्निहित मॉडल है लेकिन कुछ सुरक्षा उपाय हटाए गए हैं। यह सामान्य उपयोग के लिए नहीं है: इसे यू.एस. सरकार की साझेदारी में Project Glasswing के हिस्से के रूप में तैनात किया गया है, जिसने प्रभावी रूप से Claude Mythos Preview की जगह ले ली है। हमें Claude Mythos 5 के बारे में बहुत कुछ नहीं पता, लेकिन हम जानते हैं कि इसमें दुनिया के किसी भी मॉडल की तुलना में सबसे मजबूत साइबर सुरक्षा क्षमताएं हैं। Anthropic की यू.एस. सरकार के साथ साझेदारी स्वयं इसका प्रमाण है।
Fable 5 सुरक्षा, पारदर्शिता, मेमोरी और डेटा हैंडलिंग में कई उल्लेखनीय उन्नयन लाता है।
Fable 5 में सबसे बड़ा संरचनात्मक जोड़ एक दो-स्तरीय क्लासिफ़ायर सिस्टम है, जिसे मॉडल की सबसे खतरनाक क्षमताओं के दुरुपयोग को रोकने के लिए डिज़ाइन किया गया है। एक प्रोब पूरे ट्रैफ़िक में मॉडल की आंतरिक एक्टिवेशन की निगरानी करता है, और कोई भी फ़्लैग्ड अनुरोध एक अलग प्रशिक्षित LLM क्लासिफ़ायर को एस्केलेट किया जाता है जो अंतिम निर्णय लेता है। जब कोई अनुरोध ब्लॉक किया जाता है, तो उसे सीधे अस्वीकार करने के बजाय Opus 4.8 की ओर रीरूट किया जाता है, ताकि उपयोगकर्ता को फिर भी एक उपयोगी प्रतिक्रिया मिल सके।
यह ऊपर वाले बिंदु के समान है। जब Fable 5 के क्लासिफ़ायर किसी क्वेरी को Opus 4.8 की ओर रीरूट करते हैं, तो उपयोगकर्ताओं को बताया जाता है कि उनकी रिक्वेस्ट किस मॉडल ने संभाली। यह एक नया पारदर्शिता व्यवहार है, ताकि उपयोगकर्ताओं को यह न सोचना पड़े कि प्रतिक्रिया अलग क्यों लगी।
Fable 5 किसी कार्य के बीच में नोट्स फ़ाइल में लिख सकता है और बाद में उनकी ओर लौट सकता है, जो सिर्फ लंबी कॉन्टेक्स्ट विंडो होने से अलग है। यह एक सक्रिय वर्किंग मेमोरी व्यवहार है। Anthropic के अपने परीक्षण में पाया गया कि इससे प्रदर्शन में Opus 4.8 की तुलना में कहीं अधिक सुधार हुआ।
Anthropic एक नई डेटा प्रतिधारण नीति पेश कर रहा है जो सभी Fable 5 ट्रैफ़िक पर लागू होती है। नए जेलब्रेक का पता लगाने और फॉल्स पॉज़िटिव्स को कम करने में मदद के लिए डेटा 30 दिनों तक रखा जाएगा। Anthropic का कहना है कि इस डेटा का उपयोग मॉडल प्रशिक्षण के लिए नहीं किया जाएगा, और मानव पहुंच लॉग की जाती है।
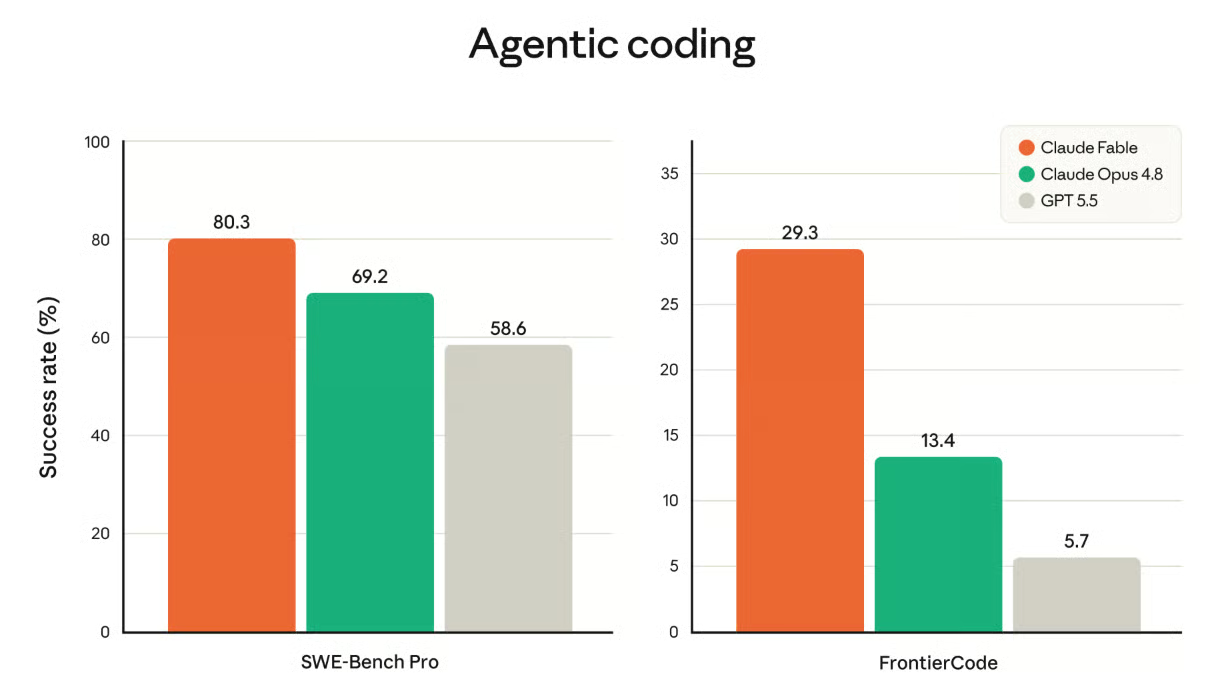
हम जिन बेंचमार्क परीक्षणों पर करीबी नज़र रखते हैं, उन सभी पर Claude Fable 5 स्पष्ट रूप से जीतता है। SWE-Bench Pro पर, यह 80.3% स्कोर करता है, जो Opus 4.8 के 69.2% से आगे है। Humanity's Last Exam पर टूल्स के साथ, यह 64.5% स्कोर करता है, जबकि Opus 4.8 के लिए 57.9% और GPT-5.5 के लिए 52.2% है।
| श्रेणी | बेंचमार्क | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| एजेंटिक कोडिंग | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
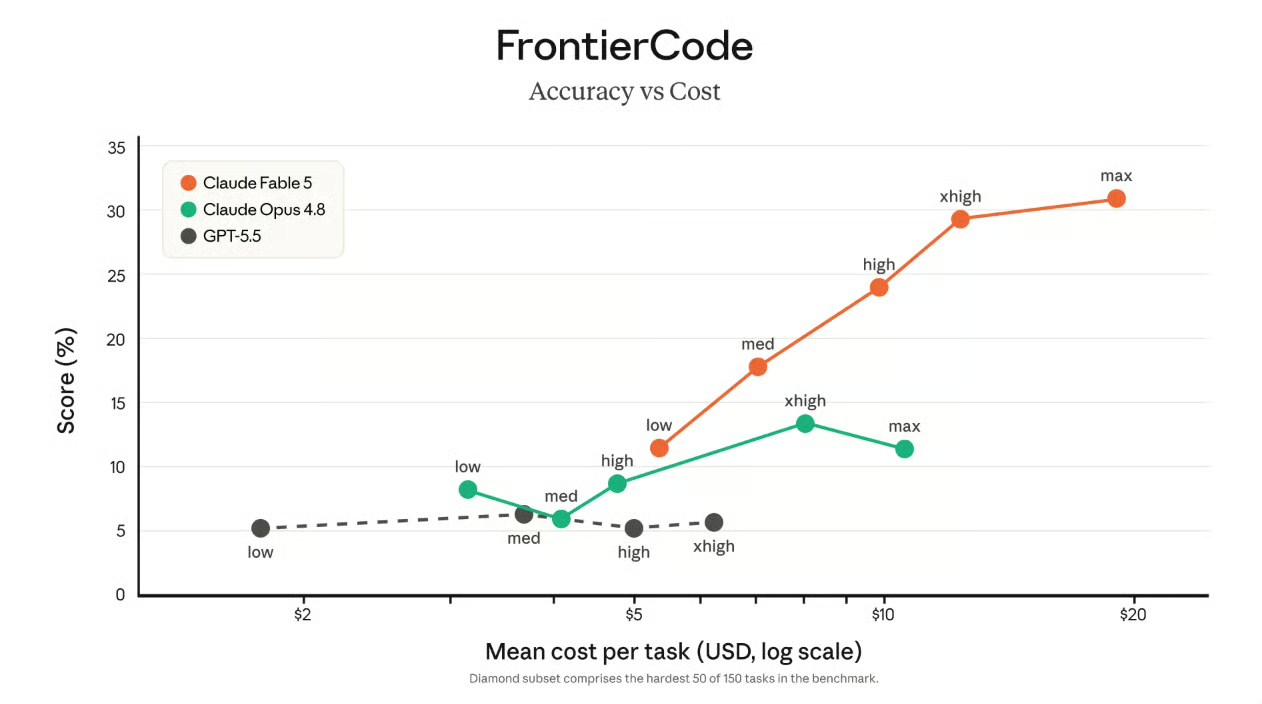
| एजेंटिक कोडिंग | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| ज्ञान-कार्य | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| ज्ञान-कार्य विज़न | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| स्पैशियल रीज़निंग | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| टूल उपयोग | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| कंप्यूटर उपयोग | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| कानूनी | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| बहु-विषयी तर्क | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| बहु-विषयी तर्क | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| जीवविज्ञान | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| जीवविज्ञान | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| एजेंटिक कोडिंग | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| साइबरसुरक्षा | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| स्वास्थ्य | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
मैंने FrontierCode बेंचमार्क परीक्षण का ज़िक्र किया था लेकिन विस्तार में नहीं जा पाया/पाई। FrontierCode यह जांचता है कि क्या कोई मॉडल न केवल कोडिंग टेस्ट पास कर सकता है, जो अपने आप में कठिन है, बल्कि क्या वह उच्च-गुणवत्ता वाले प्रोडक्शन कोडबेस के व्यापक मानकों को भी पूरा कर सकता है, जिसका अर्थ है कि कोड को स्केल पर परफ़ॉर्मेंट होना चाहिए, आइडियोमैटिक होना चाहिए, दीर्घकालिक मेंटेनबिलिटी के लिए संरचित होना चाहिए, आदि।
Claude Fable 5 FrontierCode टेस्ट में किसी भी अन्य मॉडल से अधिक स्कोर करता है, वह भी बिना high या xhigh प्रयास पैरामीटर का उपयोग किए।
विज़न कार्यों के लिए Claude Fable 5 अब नया सर्वश्रेष्ठ मॉडल है। Anthropic के परीक्षण में, Fable 5 केवल स्क्रीनशॉट्स से, बिना किसी स्कैफ़ोल्डिंग के, वेब एप्लिकेशन का सोर्स कोड फिर से बना सका। यही क्षमता CharXiv Reasoning (टूल्स के साथ) में इसके 93.2% स्कोर में भी दिखती है।
Fable 5 मॉडल उस समस्या पर भी बेहद अच्छा करता है जो शायद अधिक लोग झेलते हैं: यह विस्तृत वैज्ञानिक फ़िगर्स से सटीक संख्याएं कम गलतियों के साथ निकाल सकता है।
हम पूरे साल AI मॉडलों की मेमोरी और लॉन्ग-कॉन्टेक्स्ट क्षमताओं के बारे में बहुत बात कर रहे हैं। Fable 5 के साथ, Anthropic हमें कुछ नई बातें देता है जिन पर बात की जा सकती है।
एक तो, Fable 4 लाखों टोकन के पार फ़ोकस बनाए रखता है। यदि आप इस विचार से परिचित नहीं हैं, तो लंबे कार्यों के दौरान AI मॉडल बातचीत लंबी होने पर पहले के कॉन्टेक्स्ट को ‘भूल’ सकते हैं या उसका धागा खो सकते हैं। लेकिन Fable 5 बहुत लंबे कार्यों में भी सुसंगत, संगत व्यवहार बनाए रखने में बेहतर है। कितना लंबा? संदर्भ के लिए, एक मिलियन टोकन लगभग 700-पृष्ठ के उपन्यास के बराबर होता है।
Anthropic यह भी दिलचस्पी से बताता है कि Fable 5 अपनी खुद की नोट्स का उपयोग करके अपने आउटपुट में सुधार करता है। यानी मॉडल कार्य के बीच में चीजें लिख सकता है (उदाहरण के लिए किसी फ़ाइल में) और बाद में उन पर वापस जा सकता है (जो उसने लिखा था)। यह किसी समस्या को हल करते समय व्यक्ति द्वारा नोट्स लिखने जैसा है। यह लंबी मेमोरी होने से अलग है। यह मॉडल बाह्य स्टोरेज को एक सोचने के औज़ार की तरह उपयोग करता है।
ऊपर दी गई तालिका पहले ही दिखाती है कि Fable 5 हर श्रेणी में आगे है। लेकिन एक उपयोगी सवाल यह है कि बढ़त का स्वरूप क्या है: कहां यह भारी अंतर है, कहां टॉस-अप है, और क्यों।
GPT-5.5 सबसे नज़दीकी प्रतिद्वंदी है, और अधिकांश कार्यों पर दोनों लगभग बराबर हैं। Blueprint-Bench 2 स्पैशियल रीज़निंग में GPT-5.5 के लिए 36.2 और Fable 5 के लिए 38.6 है। लंबे एजेंटिक कार्यों पर भी ये क़रीब रहते हैं, बशर्ते मॉडल को काम करते समय फ़ीडबैक मिलता रहे। Terminal-Bench 2.1 पर, जहां टर्मिनल तुरंत त्रुटियां फ़्लैग कर देता है, स्कोर 83.4 बनाम 88.0 है।
एक स्थिति पैटर्न तोड़ती है: लंबा कार्य जिसे केवल अंत में ग्रेड किया जाता है। वहां मॉडल अपनी गलतियां खुद नहीं पकड़ पाता, तो वे जमा होती जाती हैं, और अधिक सक्षम मॉडल आगे निकल जाता है। SWE-Bench Pro सबसे स्पष्ट उदाहरण है, GPT-5.5 के 58.6 के मुकाबले Fable 5 के 80.3।
विस्तृत तुलना के लिए हमारा पोस्ट पढ़ें: Claude Fable 5 बनाम GPT-5.5: बेंचमार्क, प्राइसिंग, और किसे चुनें।
Gemini 3.1 Pro हर मोर्चे पर Fable 5 से पीछे है, और जो काम सबसे ज़्यादा मायने रखता है, उस पर यह अंतर और बढ़ जाता है। GDPval-AA ज्ञान-कार्य पर इसका स्कोर 1314 है जबकि Fable 5 का 1932। Terminal-Bench 2.1 पर यह 70.7 बनाम 88.0 है। छोटे, सीमित कार्यों पर अंतर कम है — स्पैशियल रीज़निंग 26.5 बनाम 38.6 — लेकिन कभी पाटा नहीं जाता। यह पैटर्न ऐसे मॉडल की ओर इशारा करता है जो छोटे प्रॉब्लम्स को ठीक-ठाक संभालता है लेकिन लंबे, टूल-हेवी वर्कफ़्लो में धागा खो देता है, जहां Fable 5 काम करने के लिए बना है।
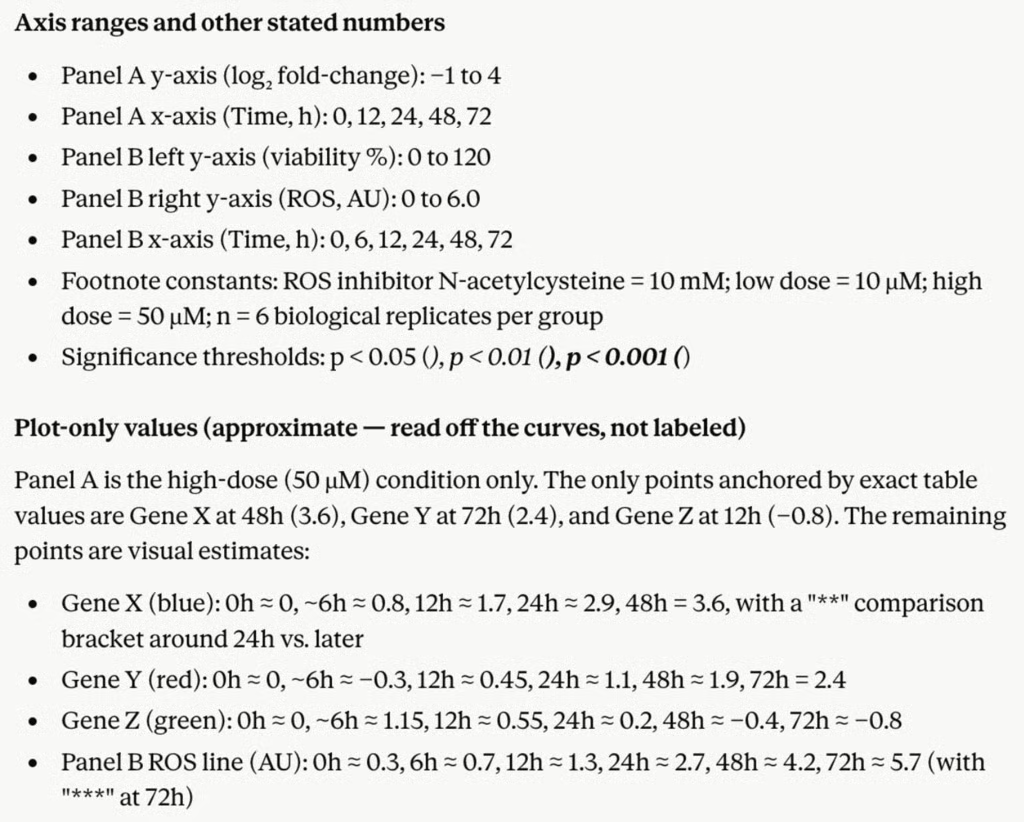
Anthropic की रिलीज़ में एक विशिष्ट दावा यह है कि Fable 5 विस्तृत वैज्ञानिक फ़िगर्स से सटीक संख्याएं कम गलतियों के साथ निकाल सकता है।
इसे परखने के लिए, हमने दो-पैनल का एक वैज्ञानिक फ़िगर बनाया, जैसा आउटपुट आप किसी सेल बायोलॉजी पेपर में पाएंगे: लॉग₂ एक्सिस पर ओवरलैपिंग जीन एक्सप्रेशन टाइम सीरीज़, एक डुअल-एक्सिस पैनल जो प्रतिशत को अन्य मापों (एर्बिट्ररी यूनिट्स) के साथ जोड़ता है, आदि।
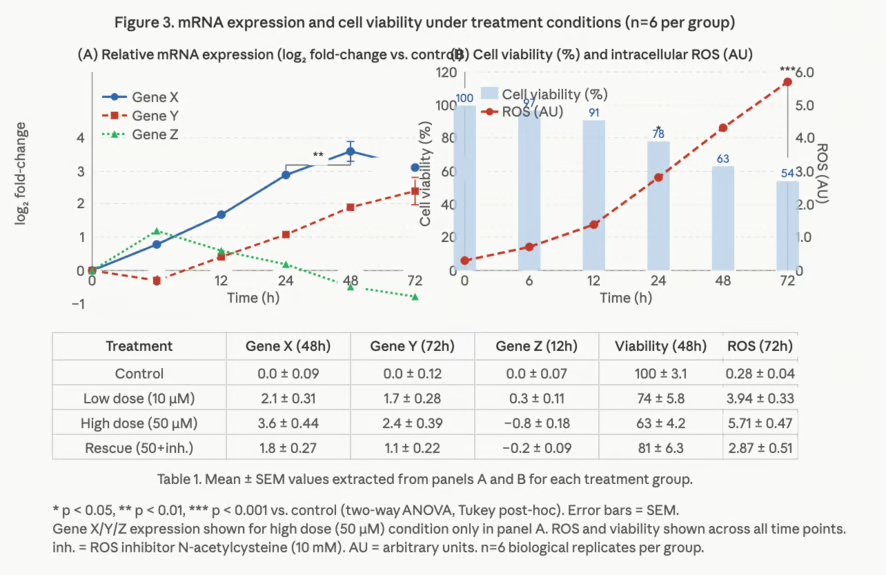
हमें लगा था कि यह पेचीदा होगा। पैनल B में डुअल y-एक्सिस अलग-अलग स्केल और अलग-अलग इकाइयों का उपयोग करते हैं। जीन Z कुछ जगहों पर नकारात्मक लॉग₂ क्षेत्र में चला जाता है।
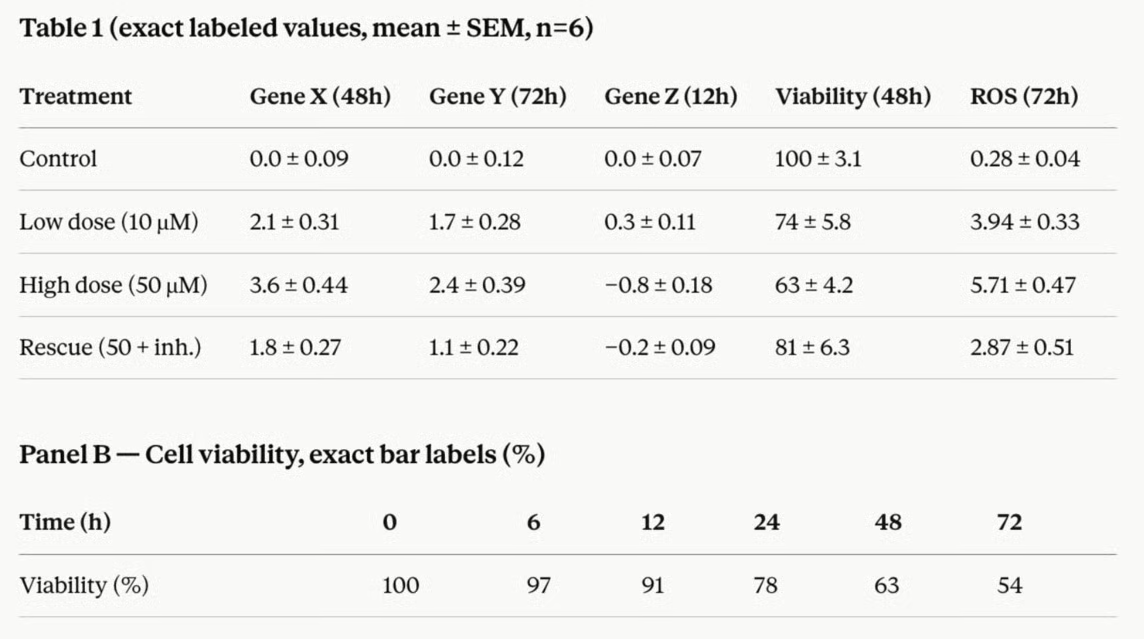
हमने Fable 5 से दोनों पैनलों और तालिका से सभी संख्यात्मक मान निकालने को कहा।
please extract all numeric valuesपरिणाम मूलतः परफेक्ट था। ग्राफ़ बनाने के लिए मेरी अपनी तालिका में 48 घंटे पर जीन Z का मान -0.05 था। Fable 5 ने मुझे बताया कि इस बिंदु पर यह -0.04 है, -0.05 नहीं।
रिलीज़ में, Anthropic हमें ग्राहकों या भागीदारों (जैसे GitHub और Figma) के शुरुआती एक्सेस फ़ीडबैक/प्रोडक्ट टेस्टिमोनियल्स दिखाता है। वे सकारात्मक बातें कहते हैं, जो अपेक्षित है। हर Anthropic मॉडल रिलीज़ में यह सेक्शन होता है।
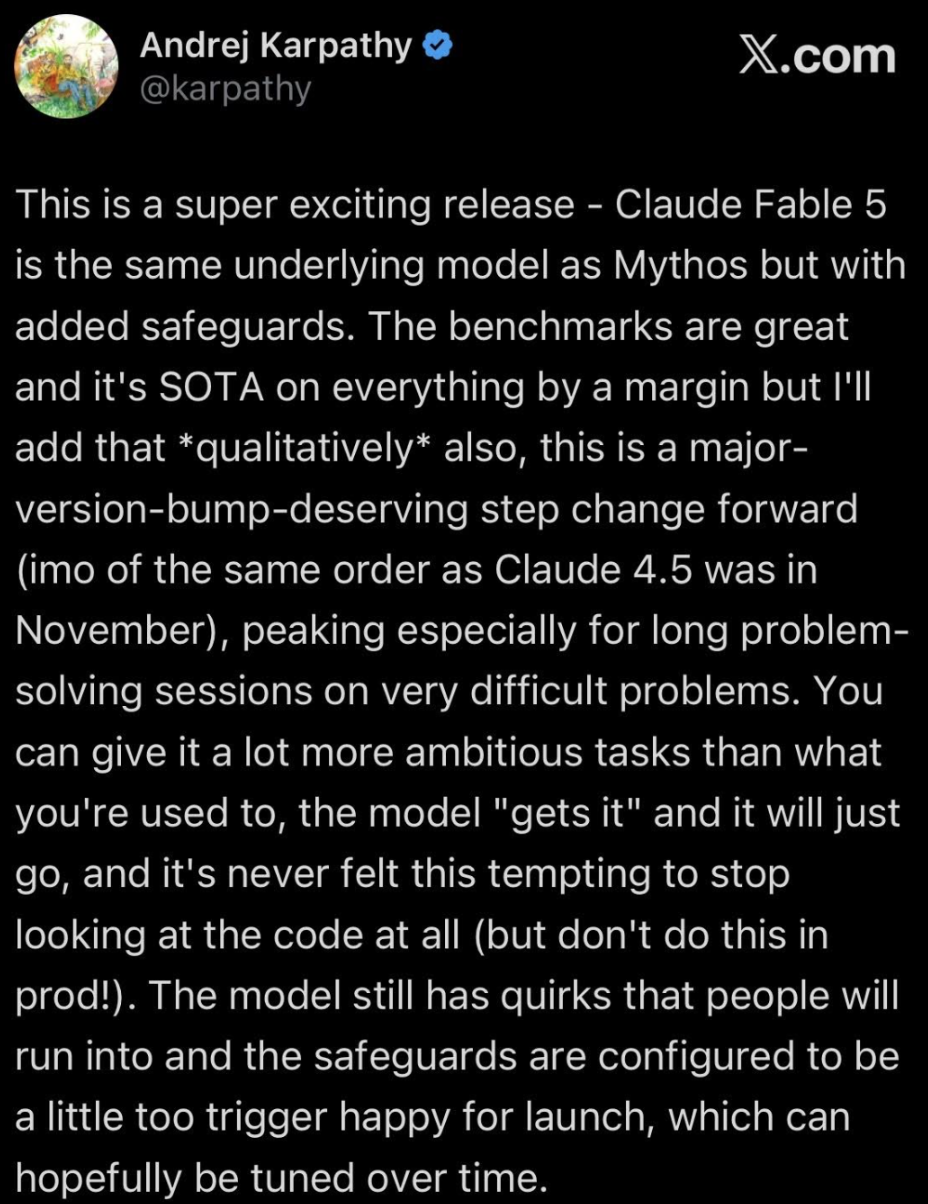
X हमें कम क्यूरेटेड राय देता है। जो तुरंत ध्यान खींचता है, Andrej Karpathy ने मॉडल को मूलतः दमदार समीक्षा दी है, यह स्वीकारते हुए कि Fable 5 सभी प्रासंगिक बेंचमार्क्स पर अंतर से स्टेट-ऑफ-द-आर्ट है, और इसे एक "स्टेप-चैनज" भी कहा है जैसा Opus 4.5 नवंबर में था। पोस्ट के बाकी हिस्से में वह Fable 5 के साथ आप क्या-क्या कर सकते हैं, इस पर ढेरों विचार देते हैं, जैसे:
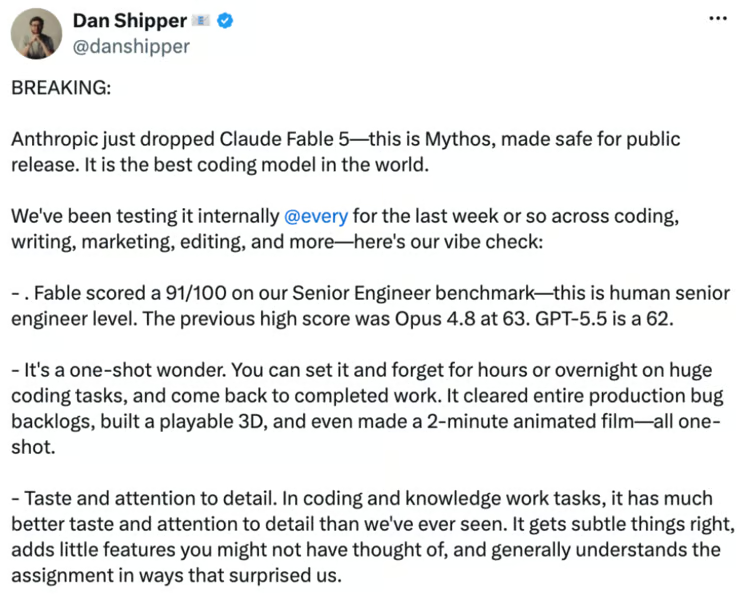
Dan Shipper, Every के सीईओ, ने इसी तरह की बातें कही हैं, कि Fable 5 ने एक तो बेंचमार्क टेस्ट्स में सबको पछाड़ दिया, और यह एक ‘वन-शॉट वंडर’ है — आप इसे किसी बड़े प्रोजेक्ट पर लगा दें और अगली सुबह वापस आएं तो काम पूरा मिलता है। (उन्हें शुरुआती एक्सेस मिला था, इसलिए उन्हें पता है।)
थोड़ी आलोचना संतुलन के लिए: वे कहते हैं कि मॉडल धीमा है और टोकन-भूखा, जो महंगा होने का ही दूसरा तरीका है। वे कहते हैं कि यह Opus से दोगुना महंगा है। इसलिए वे समझदारी से स्वीकारते हैं कि आपको मॉडल का उपयोग केवल उसी काम के लिए करना चाहिए, जिसकी वास्तव में इसे ज़रूरत है।
मैंने बताया था कि Claude Fable 5, Claude Mythos 5 ही है, लेकिन सुरक्षा उपायों के साथ। इसका मतलब यह है कि Fable 5 इतना शक्तिशाली है कि, बिना प्रतिबंधों के, यह साइबर सुरक्षा और जीवविज्ञान जैसी क्षेत्रों में बुरे तत्वों को सार्थक सहायता दे सकता है। यही मान्यता है।
ऊंचे स्तर पर सुरक्षा उपाय इस तरह काम करते हैं। यह एक दो-स्तरीय क्लासिफ़ायर सिस्टम है:
अब, तीन मुख्य क्षेत्र हैं जिन्हें क्लासिफ़ायर कवर करते हैं।
एक विजुअल में सुरक्षा उपायों की पहले/बाद की कहानी देखें। गुलाबी बार Claude Mythos 5 के हैं बिना सुरक्षा उपायों के — कच्चा अंतर्निहित मॉडल। यह सभी चार बेंचमार्क्स पर बेहद सक्षम है: Firefox एक्सप्लॉइट डेवलपमेंट पर 88.4%, CyberGym वल्नरेबिलिटी रिप्रोडक्शन पर 83.8%, आदि।
नारंगी बार Claude Fable 5 के हैं, क्लासिफ़ायर सक्रिय होने के साथ, और वे हर बेंचमार्क पर 0.0% हैं। सुरक्षा उपाय प्रदर्शन को फ्लैटलाइ़न कर देते हैं, जो अच्छा है — शून्य ही लक्ष्य है।
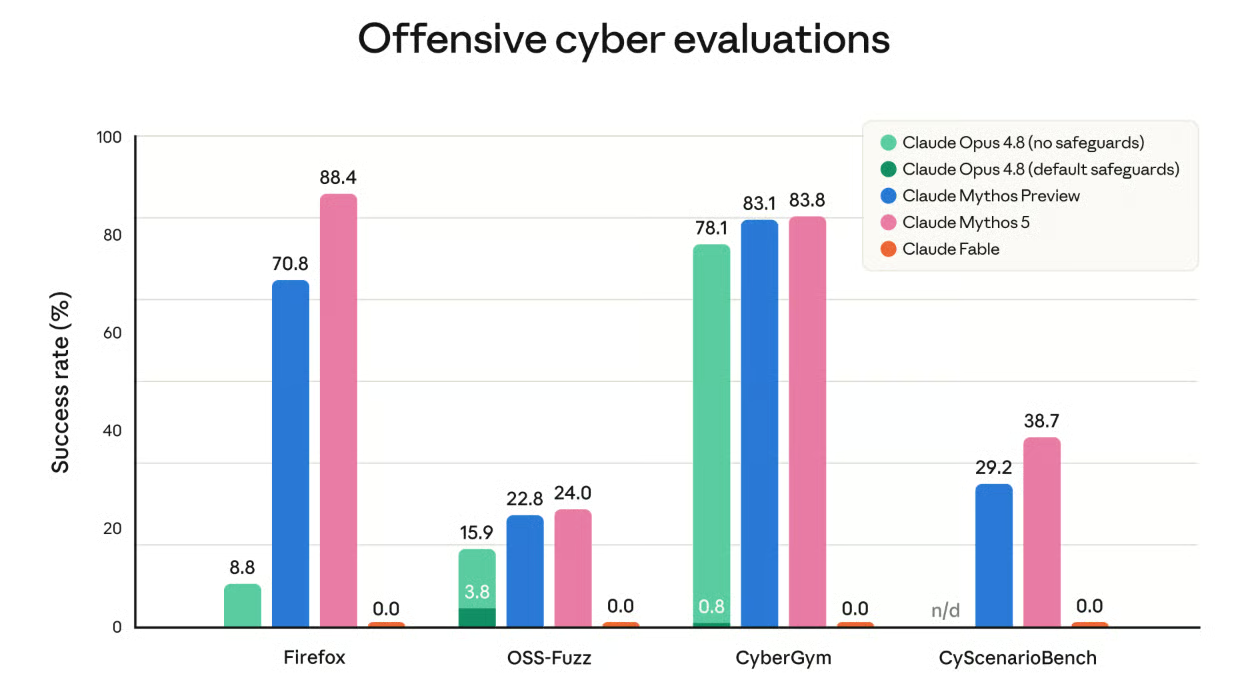
मुझे यह ग्राफ़ पसंद है क्योंकि यह Opus 4.8 को संदर्भ में रखता है। बिना सुरक्षा उपायों के भी, Opus 4.8 Mythos 5 से काफी कम स्कोर करता है। यह हमें बताता है कि क्लासिफ़ायर पहली जगह पर क्यों ज़रूरी थे। Opus और Mythos के बीच क्षमता की छलांग ही व्यापक रिलीज़ को जोखिमभरा और विलंबित बनाती थी।
यदि आप Pro, Max, Team, या Enterprise प्लान पर हैं, तो Fable 5 अभी आपके लिए बिना किसी अतिरिक्त लागत के उपलब्ध है — लेकिन केवल 22 जून तक।
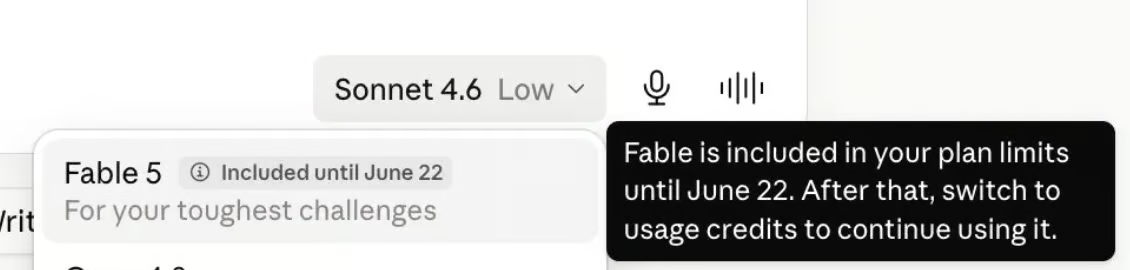
22 जून के बाद, पहुंच के लिए यूसेज क्रेडिट्स की आवश्यकता होगी, जो Anthropic की पे-एज़-यू-गो प्रणाली है जो आपकी मौजूदा सदस्यता के ऊपर बैठती है। शायद यही वजह है कि Dan Shipper ने हमें लागत के बारे में चेताया।
API पर डेवलपर्स के लिए, बात सरल है:
यदि आप Opus 4.8 की मानक कीमतों ($5 इनपुट / $25 आउटपुट) से तुलना करें, तो Dan के कहे अनुसार Fable 5 वाकई दोगुना महंगा है। लेकिन यदि आप पहले से ही Opus 4.8 को फास्ट मोड में उपयोग कर रहे हैं, तो Fable 5 उतनी ही लागत पर अधिक सक्षम मॉडल है।
महत्वपूर्ण नोट, यदि आप मेरी तरह सोच रहे थे: जब कोई क्वेरी Opus 4.8 पर फॉलबैक करती है, जैसा कि इसके सुरक्षा क्लासिफ़ायर सिस्टम में होता है, तो आपका बिल Fable 5 की दरों के बजाय Opus 4.8 की दरों पर होता है।
Claude Mythos 5, यानी बिना सुरक्षा उपायों वाला मिथोस मॉडल संस्करण, आम जनता के लिए उपलब्ध नहीं है। पहुंच Project Glasswing भागीदारों तक सीमित है।
Anthopic ने Project Glasswing और ललचाने वाले नाम वाले Mythos मॉडल के साथ हमें छेड़ा था। लेकिन महीनों तक यह दुनिया का सर्वश्रेष्ठ मॉडल — और यह सचमुच दुनिया में सर्वश्रेष्ठ है — एक सरकारी साझेदारी के पीछे बंद था।
यह बदल गया है, ठीक एक सप्ताह बाद जब Anthropic ने यू.एस. IPO के लिए फाइल किया। अब, मिथोस-क्लास मॉडल Pro प्लान पर उपलब्ध है। (पहुंच यूसेज क्रेडिट्स पर भी निर्भर है। इस सब में जाने के लिए अंतिम सेक्शन देखें।)
जहां हम हैं: Anthropic के पास ऐसे मॉडल हैं जो बिना प्रतिबंधों के गंभीर नुकसान पहुंचाने के लिए पर्याप्त सक्षम हैं। हमें पता है कि यह मार्केटिंग कॉपी नहीं है क्योंकि कंपनी ने सुरक्षा जोड़ने के लिए पूरा पैरेलल क्लासिफ़ायर सिस्टम बनाया।
जहां हम जा रहे हैं: क्षमता की छत लगातार ऊपर खिसक रही है, बेंचमार्क टेस्ट्स को लगातार कठिन संस्करणों से बदला जा रहा है, और मॉडल रिलीज़ टाइमलाइन और छोटी होती जा रही है। साथ ही, सुरक्षा अवसंरचना इसकी भरपाई के लिए और जटिल होती जा रही है। संभावित रूप से इसी साल आने वाले IPO के साथ, इस बात पर काफी चर्चा होगी कि प्रतिस्पर्धी दबाव कैसे सुरक्षा मुद्दों के विरुद्ध चलता है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स