

कोर्स
Claude मॉडलों का परिचय
3 घंटा
15K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंAnthropic के पास फिर से एक बिल्कुल नया सेकंड-बेस्ट मॉडल है।
इस बार, यह Claude Opus 5 है, जिसे सीमारेखा के नजदीक बुद्धिमत्ता के रूप में पेश किया गया है, लेकिन Claude Fable 5 की आधी कीमत पर और, इससे भी बढ़कर, Opus 5 वास्तव में कई कोडिंग और नॉलेज-वर्क मूल्यांकनों पर Fable 5 से बेहतर प्रदर्शन करता है, जिनमें Frontier-Bench और GDPval-AA शामिल हैं। यह बस अभी भी व्यापक रूप से उपलब्ध न हुए Mythos 5 से दूसरे स्थान पर है।
नीचे Opus 5 में क्या नया है, यह और अधिक बेंचमार्क टेस्ट पर कैसा करता है, Anthropic इसके एलाइनमेंट और सेफ्टी प्रोफाइल के बारे में क्या कहता है, और इसकी कीमत क्या है—इन सबका एक वॉकथ्रू दिया गया है।
Opus 5, Anthropic के Opus टियर का नवीनतम रिलीज़ है, जो टॉपलाइन क्षमता के लिहाज़ से Mythos से नीचे, लेकिन Sonnet और Haiku से ऊपर बैठता है।
Anthropic हमें बताता है कि इसका नवीनतम मॉडल "विचारशील और सक्रिय" है (वे हमेशा थोड़ा मानवीकरण करते हैं)। वे यह भी कहते हैं कि मॉडल दैनिक उपयोग के लिए बना है, जिसका मतलब AI इंजीनियर के लिए है कि यह लगातार चलने के लिए पर्याप्त कुशल है।
Frontier-Bench और GDPval-AA जैसे कोडिंग और नॉलेज-वर्क मूल्यांकनों पर, Anthropic का कहना है कि Opus 5 अब उनके मॉडलों में अत्याधुनिक है, हालांकि यह अब भी विशेष रूप से साइबरसुरक्षा कार्यों पर Mythos 5 से पीछे है, जिसे हमने अपने Mythos 5 लेख में विस्तार से कवर किया है।
प्रतिद्वंद्वी और सिब्लिंग मॉडलों के मुकाबले हेड-टू-हेड देखने के लिए, हमारे तुलना गाइड पढ़ें:
Anthropic के अपने शब्दों में दो चीज़ें खास हैं: ऐसे बदलाव जो काम को सच में पूरा करने पर केंद्रित हैं, न कि कोई सम्भाव्य दिखने वाले उत्तर पर रुक जाने पर; और विज़ुअल आउटपुट गुणवत्ता में उछाल।
Opus 5 का सबसे बड़ा गुणात्मक परिवर्तन यह है कि यह तब तक काम जारी रखने को तैयार रहता है जब तक कार्य सचमुच सफल न हो जाए। Anthropic बताता है कि यह कैसा दिखता है:
सम्भाव्य दिखने वाले उत्तर पर समझौता करने के बजाय दोहराते रहने की यह प्रवृत्ति ही लगती है कि Frontier-Bench जैसे एजेंटिक बेंचमार्क पर Opus 5 की छलांग को चला रही है।
Anthropic यह भी बताता है कि Opus 5 पहले के मॉडलों की तुलना में अर्थपूर्ण रूप से अधिक मज़बूत विज़ुअल आउटपुट बनाने में सक्षम है, जैसे कि एयरोडायनामिक वस्तुओं—जैसे कार—के ऊपर एयरफ्लो का विंड-टनल-स्टाइल विज़ुअलाइज़ेशन। यह एक प्रभावशाली उदाहरण था, और अच्छी खबर है यदि आपका काम जनरेटिव डायग्राम बनाने से जुड़ा है।
इस तालिका में केवल Anthropic के अपने मॉडल शामिल हैं। मैंने उनके-अपने रिलीज़ देखे और जो संभव था उसे एकसाथ रखा। अगले सेक्शन में मैं Opus 5 की तुलना प्रतिस्पर्धी मॉडलों से करूँगा।
एक नोट: "प्रकट नहीं" या "प्रकाशित नहीं" का अर्थ है कि जिस रिलीज़ से मॉडल आया, उसमें उसे उस विशेष बेंचमार्क पर शामिल नहीं किया गया था, न कि उसका स्कोर शून्य था।
| बेंचमार्क | Haiku 4.5 | Sonnet 4.6 | Opus 4.7 | Opus 4.8 | Sonnet 5 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|---|---|
| SWE-bench Verified | 73.3% | 79.6% | 87.6% | 88.6% | — | 95.0% | 96.0% |
| SWE-bench Pro | — | 58.1% | 64.3% | 69.2% | 63.2% | 80.3% | 79.2% |
| Terminal-Bench | 41% | 67.0% (2.1) | 69.4% (2.0) | 74.6% (2.1) | 80.4% (2.1) | 88.0% (2.1) | not published |
| Frontier-Bench v0.1 (नया इवैल) | — | — | — | 18.7% | — | 33.7% | 43.3% |
| GDPval-AA / v2 (Elo, /2000) | — | — | 1,753 | 1,890 (v1) / 1,593 (v2) | 1,618 (v2) | 1,747 (v2) | 1,861 (v2) |
| Misaligned-behavior audit (कम = बेहतर) | — | — | — | not disclosed | not disclosed | not disclosed | 2.3 (अब तक का सर्वश्रेष्ठ) |
| कीमत ($/MTok इन/आउट) | $1/$5 | $3/$15 | $5/$25 | $5/$25 | $2–3/$10–15 | $10/$50 | $5/$25 |
ऊपर दी गई तालिका में आप देख सकते हैं कि Opus 5 वास्तव में Frontier-Bench v0.1 (43.3% बनाम 33.7%) और GDPval-AA v2 (1861 बनाम 1747) पर अपने ही अधिक महंगे सिब्लिंग को पछाड़ता है—वह भी Fable 5 की आधी कीमत पर।
यह अगली तुलना सबसे स्पष्ट पीढ़ीगत छलांग है: Opus 5 अपने पूर्ववर्ती पर ARC-AGI-3 में आगे है, जो 1.5% से 30.2% तक उछलता है, और Frontier-Bench v0.1 में भी, जो कि आप ऊपर तालिका में देख सकते हैं, दोगुने से अधिक हो गया है (43.3% बनाम 18.7%)। ध्यान रखें, Opus 4.8 सिर्फ दो महीने पहले जारी हुआ था।
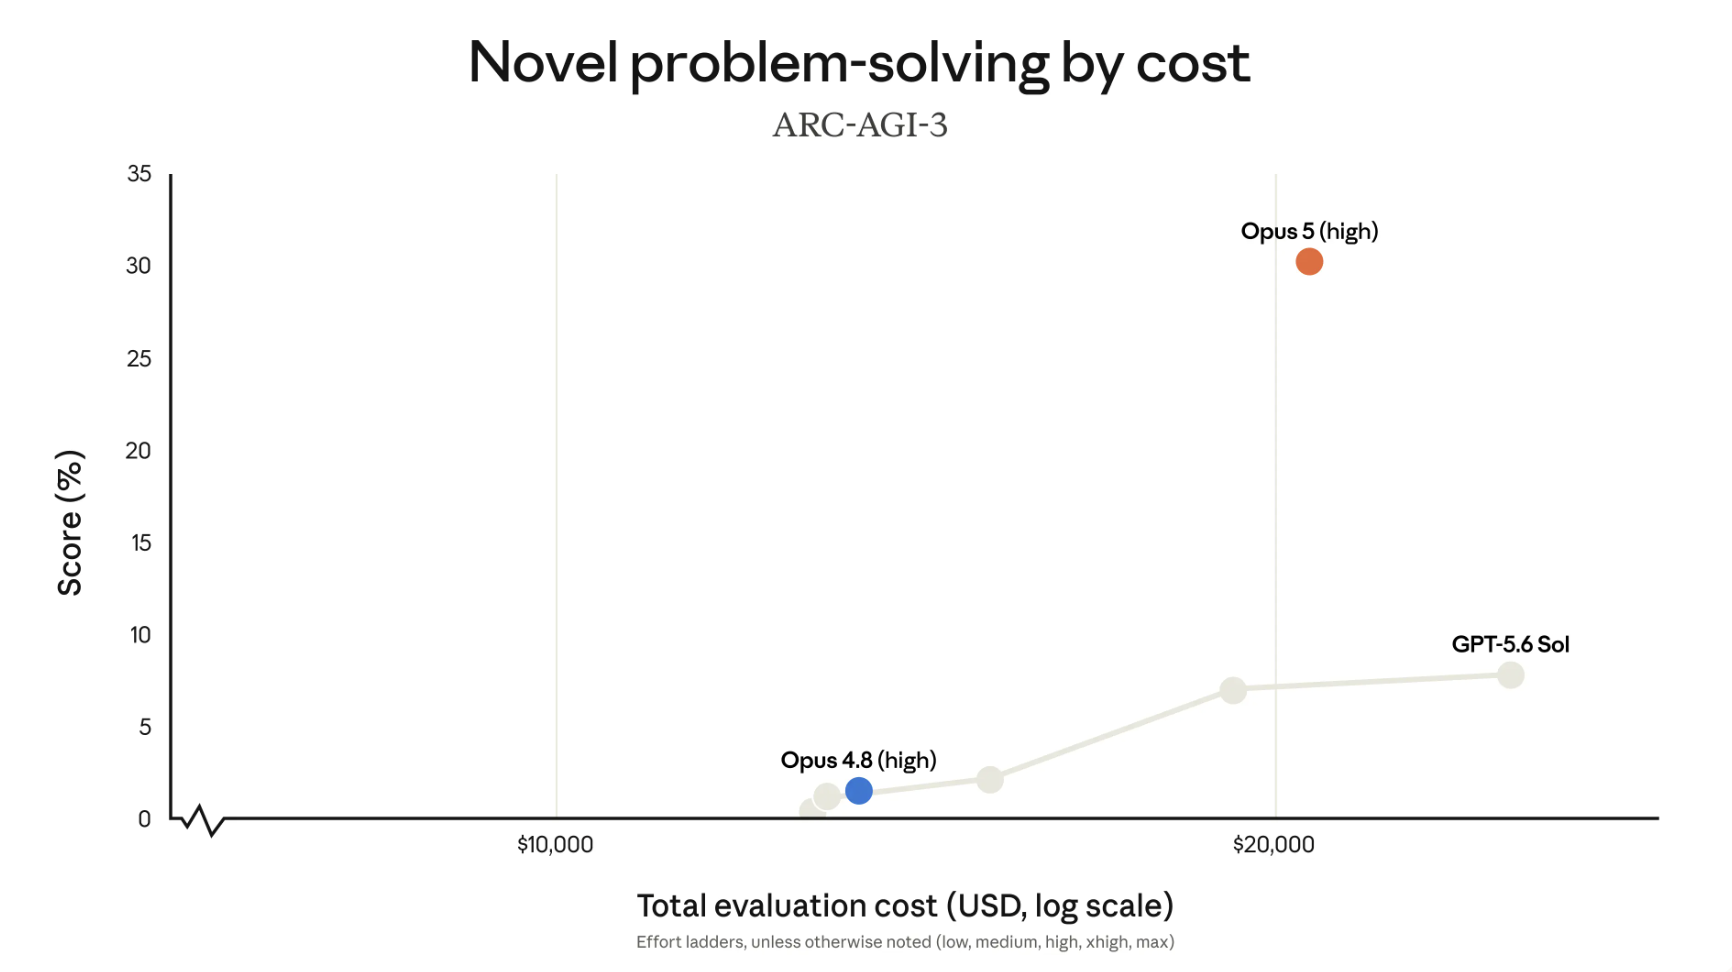
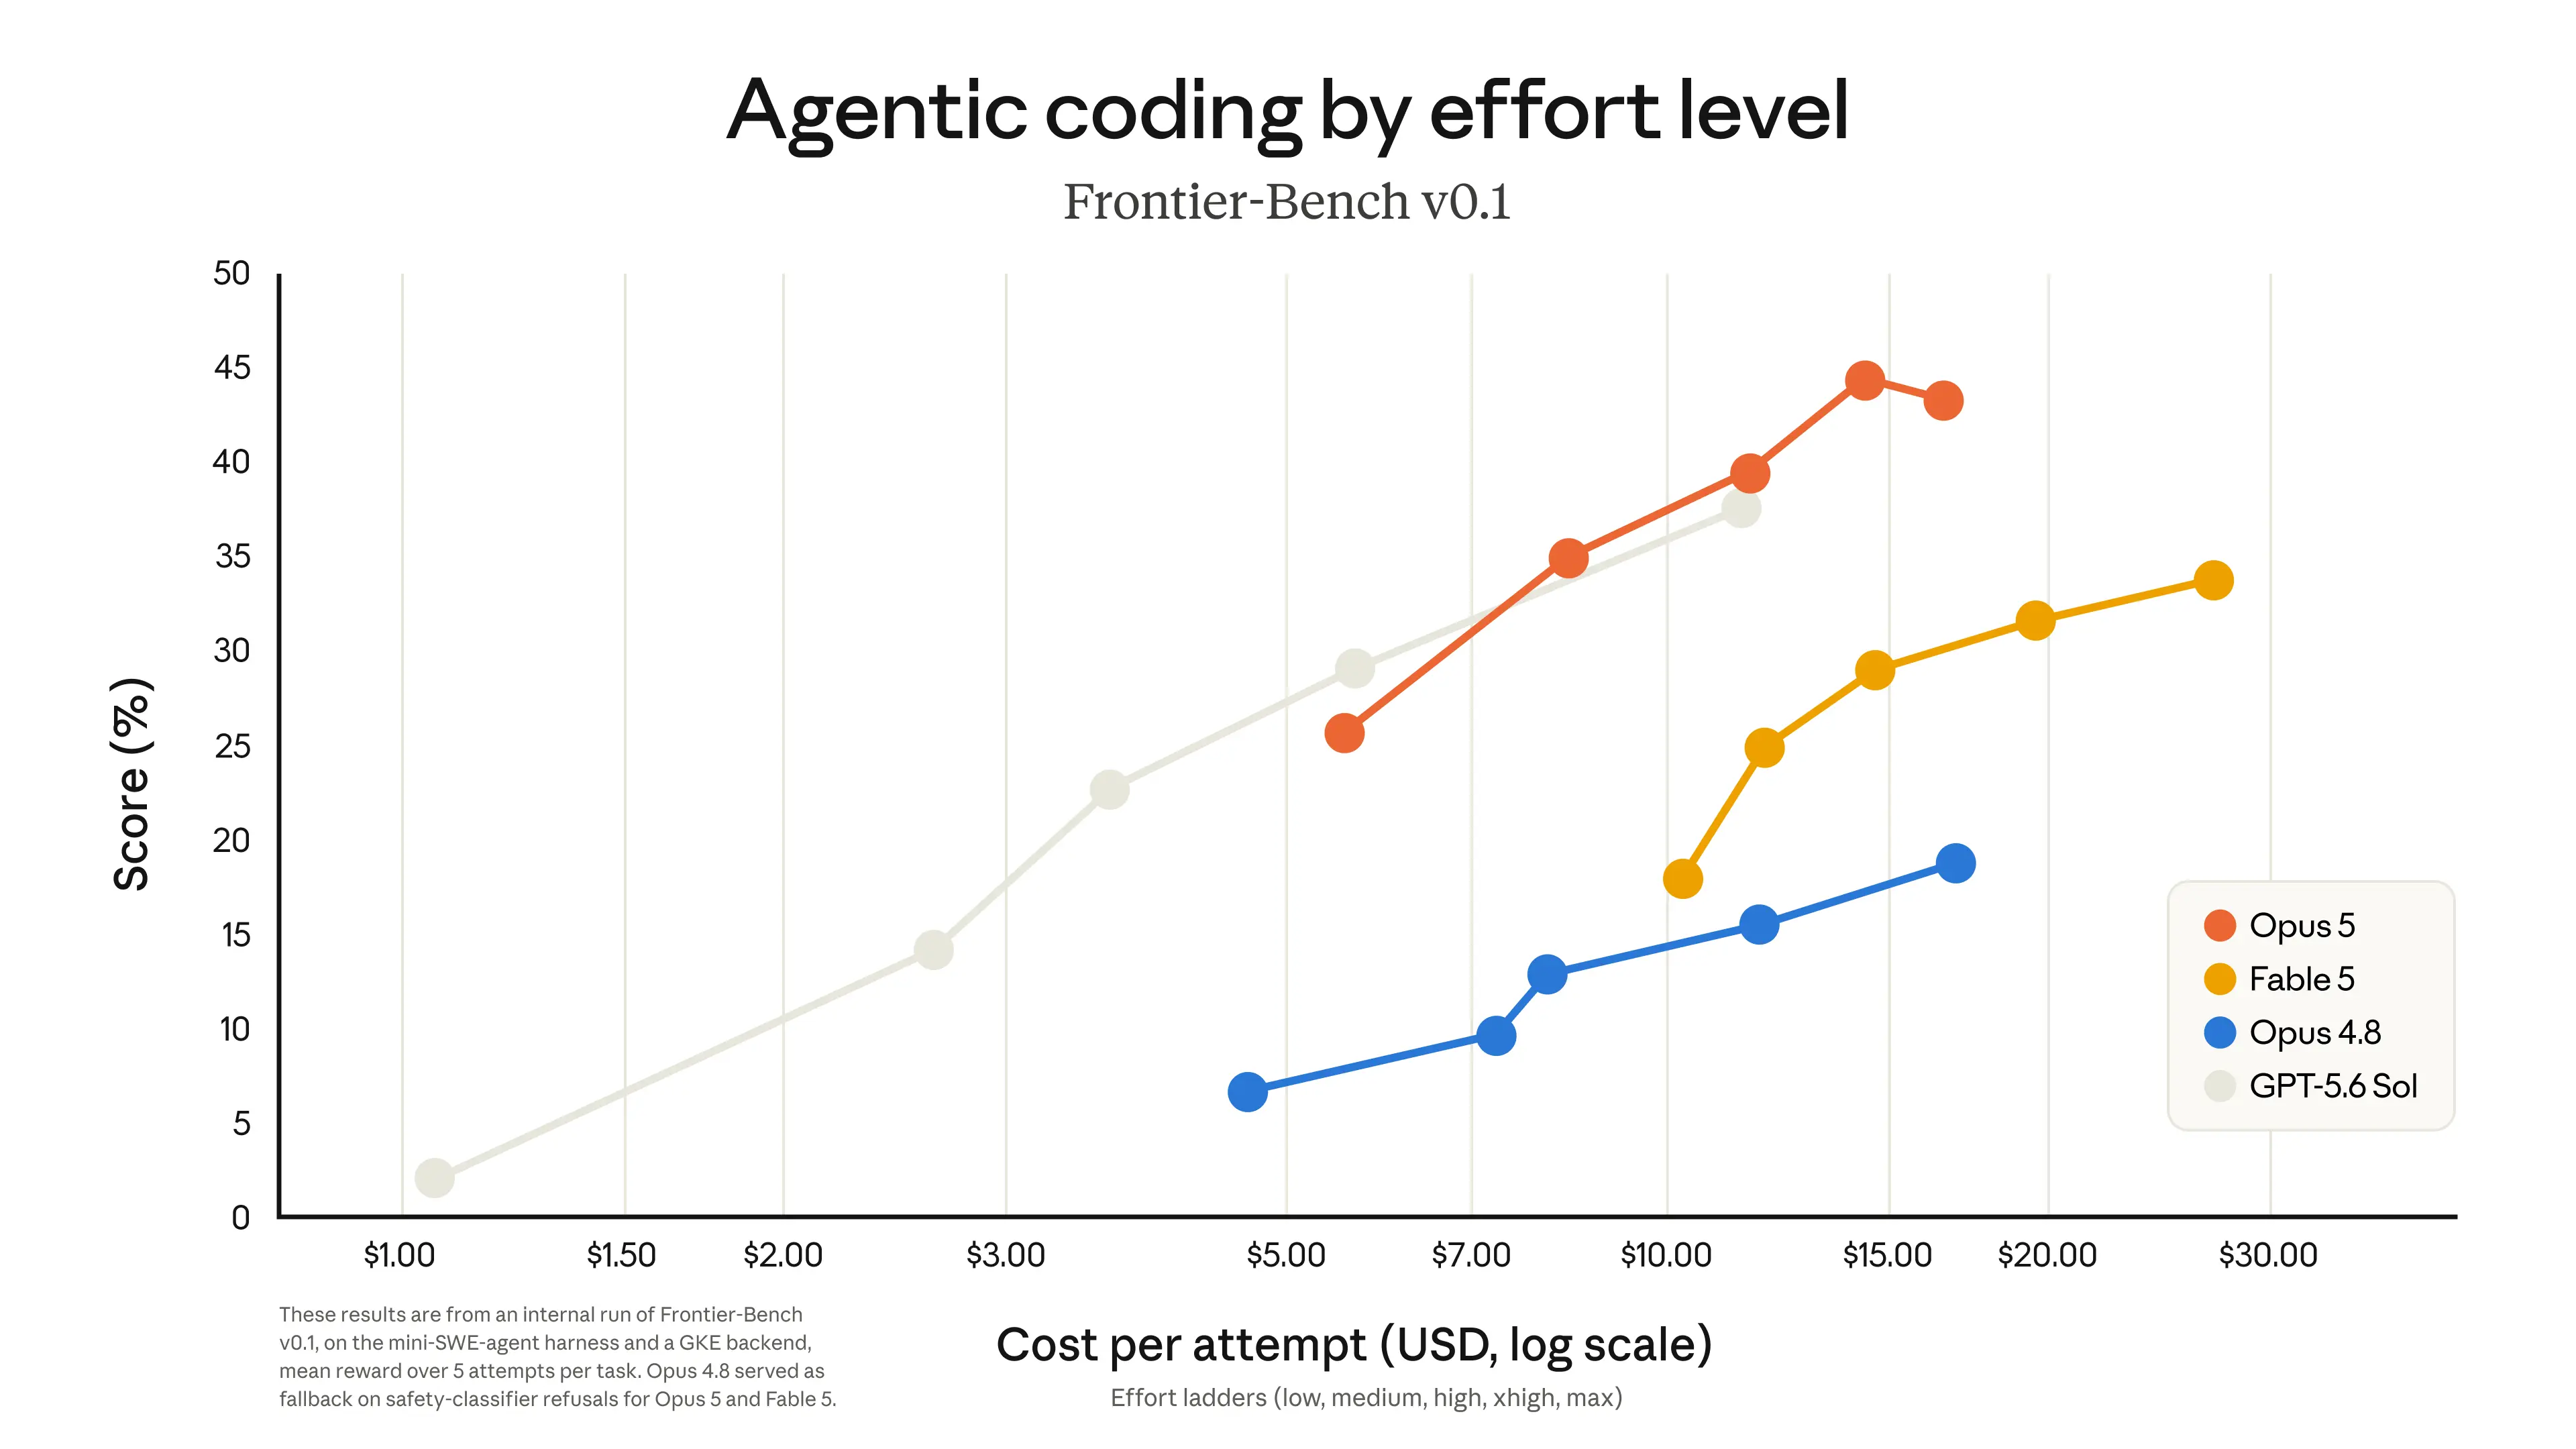
अगली तुलना Anthropic, OpenAI, और Google द्वारा प्रकाशित मॉडल रिलीज़ घोषणाओं से सीधे बेंचमार्क परिणाम खींचकर संकलित की गई है। मैंने ऐसे रो शामिल करने का निर्णय लिया जहाँ पर्याप्त मॉडलों के प्रकाशित, तुलनीय स्कोर थे ताकि रो अर्थपूर्ण हो। साथ ही, जो बेंचमार्क केवल अस्पष्ट सापेक्ष दावों के रूप में रिपोर्ट हुए थे, उन्हें मैंने छोड़ दिया।
| श्रेणी | बेंचमार्क | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 | Gemini 3.6 Flash | Gemini 3.5 Flash-Lite | Gemini 3.5 Flash | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|---|---|
| नॉलेज वर्क | GDPval-AA v2 (Elo) | 1861 | 1736 | — | 1593 | 1591.8 | 1493.7 | 1421 | — | 1348.8 | 962.3 |
| कोडिंग | SWE-Bench Pro | 79.2% | 64.6% | — | 63.4% | 62.7% | 59.4% | — | 54.2% | — | 54.2% |
| कोडिंग | DeepSWE v1.1 | 68.8% | 72.7% | — | 69.6% | 67.2% | 67% | 49% | — | 37% (बेसलाइन) | 11.8% |
| कोडिंग | Terminal-Bench 2.1 | — | 88.8% | 91.9% | 87.4% | 84.7% | 85.6% | — | 54% (3.1 Flash-Lite बेसलाइन 31% के मुकाबले) | — | 70.7% |
| कोडिंग | Frontier-Bench v0.1 (टर्मिनल कोडिंग) | 43.3% | 37.5% | — | — | — | — | — | — | — | — |
| कंप्यूटर उपयोग | BrowseComp | 90.8% | 90.4% | 92.2% | 87.5% | 83.3% | 84.4% | — | — | — | 85.9% |
| कंप्यूटर उपयोग | OSWorld 2.0* | 70.6% | 62.6% | — | 50.2% | 45.6% | 47.5% | — | — | — | — |
| अमूर्त तर्क | ARC-AGI-3 | 30.2% | 7.78% | — | 0.8% | 0.18% | 0.43% | — | — | — | 0.42% |
| टूल उपयोग | AutomationBench | 26.0% | 18.1% | — | 15.2% | 14.9% | 12.9% | — | — | 14.5% |
— |
मुझे कहना चाहिए: यहाँ हर संख्या उसी लैब द्वारा स्वयं-रिपोर्ट की गई है जिसने मॉडल रिलीज़ किया, और उसी लैब के अपने इवैल्यूएशन हार्नेस, प्रॉम्प्टिंग सेटअप, और (कुछ मामलों में) प्रयास या रीज़निंग-लेवल कॉन्फ़िगरेशन पर चलाई गई है।
Opus 5 कठिन, अधिक नए तर्क-संबंधी कार्यों (ARC-AGI-3, Frontier-Bench, AutomationBench) पर आगे है, जबकि GPT-5.6 Sol अधिक स्थापित कोडिंग बेंचमार्क जैसे SWE-Bench Pro और DeepSWE पर थोड़ा बढ़त लेता है। यह संकेत दे सकता है कि Opus 5 खुले-अंत या कम टेम्पलेटेड समस्या-समाधान में बढ़त रखता है, जबकि Sol स्पष्ट-परिभाषित, अधिक-प्रशिक्षित कोडिंग कार्यों पर मज़बूत दिखता है।
Gemini का हालिया रिलीज़ फ्लैश-टियर, किफायती मॉडलों पर केंद्रित है, न कि किसी सीमारेखा फ्लैगशिप पर, इसलिए अधिकांश रो में या तो Gemini डेटा नहीं है या केवल Flash/Flash-Lite के आंकड़े हैं जो Opus 5 और GPT-5.6 दोनों से काफी पीछे हैं। यह तुलना Google की सीमारेखा क्षमता से ज़्यादा मॉडल टियर के बारे में बताती है।
जहाँ दोनों फ्लैगशिप्स का ओवरलैप है, वहाँ Opus 5 नए तर्क और एजेंटिक कार्यों (ARC-AGI-3, BrowseComp, OSWorld 2.0, AutomationBench) पर आगे है, जबकि GPT-5.6 Sol लॉन्ग-होराइज़न कोडिंग (DeepSWE) पर थोड़ा बढ़त लेता है। Sol Ultra, Terra, और Luna मुख्यतः अलग कोडिंग बेंचमार्क्स पर दिखते हैं, जहाँ Opus 5 का कोई प्रकाशित स्कोर नहीं है, इसलिए यह असल में "Anthropic का एक फ्लैगशिप बनाम OpenAI का पूरा परिवार" है, न कि एक साफ़-सुथरी एक-से-एक तुलना।
Opus 5 आज Claude के प्लेटफ़ॉर्म्स पर अपने पूर्ववर्ती की समान कीमत पर उपलब्ध है:
फास्ट मोड लगभग डिफ़ॉल्ट स्पीड से 2.5x पर चलता है, जिसकी कीमत Claude Platform पर Opus 5 के बेस रेट की दुगुनी है (या Claude Code में उपयोग क्रेडिट्स के ज़रिए) — वही संरचना जो Opus 4.8 में थी।
डेवलपर्स API के माध्यम से मॉडल तक claude-opus-5 मॉडल स्ट्रिंग का उपयोग कर पहुँच सकते हैं।
Opus 5 के साथ-साथ दो संबंधित फ़ीचर बीटा में लॉन्च हो रहे हैं:
पहले के Opus रिलीज़ की तरह, Opus 5 पर सामान्य एक्सेस के लिए कोई डेटा रिटेंशन आवश्यकताएँ नहीं हैं।
यदि लगता है कि हम हाल में Claude मॉडलों के बारे में बहुत लिख रहे हैं, तो ऐसा इसलिए है क्योंकि हम सचमुच लिख रहे हैं। Anthropic मॉडल क्षमता और दक्षता को बेहतर बनाने के लिए तेज़ सुधारों पर काफ़ी केंद्रित है।
अब, Anthropic ने अपने पहले के सर्वश्रेष्ठ मॉडल Fable 5 से समग्र रूप से बेहतर कुछ प्रस्तुत किया है। यह अर्थपूर्ण रूप से कम कीमत के साथ आता है, जबकि अब तक के अपने सर्वश्रेष्ठ एलाइनमेंट नंबर भी रिपोर्ट करता है।
आगे क्या? खैर, Haiku मॉडल Anthropic का सबसे पुराना मॉडल है, और हम अभी भी 5 सीरीज़ के अपग्रेड का इंतज़ार कर रहे हैं। यह आगे क्या आ सकता है इस पर एक अंदाज़ा है, लेकिन Anthropic हमें लगातार चौंकाता रहता है।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें