

Menskalakan Klaster Amazon EMR
Seiring berkembangnya kebutuhan pemrosesan data, Anda mungkin perlu menyesuaikan sumber daya klaster EMR untuk mempertahankan performa dan efisiensi biaya.
EMR menawarkan opsi penskalaan manual dan otomatis, memungkinkan Anda memodifikasi jumlah instance berdasarkan permintaan beban kerja.
Selain itu, memanfaatkan Spot Instances dapat membantu mengoptimalkan biaya sekaligus memastikan skalabilitas.
Penskalaan manual
Penskalaan manual memungkinkan Anda menambah atau mengurangi jumlah instance di klaster berdasarkan permintaan beban kerja waktu nyata.
Penyesuaian ini dapat dilakukan melalui konsol EMR, AWS CLI, atau EMR API.
- Menggunakan konsol EMR: Navigasikan ke klaster Anda, pilih "Resize", dan tentukan jumlah instance yang diinginkan.
- Menggunakan AWS CLI: Jalankan perintah berikut untuk memodifikasi ukuran klaster:
aws emr modify-instance-groups --cluster-id <your-cluster-id> --instance-groups InstanceGroupId=<your-instance-group-id>,InstanceCount=<new-instance-count>- Menggunakan EMR API: Anda dapat menggunakan API
ModifyInstanceGroupsuntuk menyesuaikan jumlah instance secara dinamis.
Penskalaan manual paling cocok untuk beban kerja yang dapat diprediksi di mana Anda dapat mengantisipasi kebutuhan sumber daya sebelumnya.
Sebagai contoh, saya menggunakan penskalaan manual ketika saya tahu job pemrosesan data akan memiliki permintaan yang stabil, yang memungkinkan saya menyesuaikan jumlah instance berdasarkan beban kerja yang diharapkan dan memastikan pemanfaatan sumber daya yang optimal.
Auto-scaling di Amazon EMR
Auto-scaling di EMR menyesuaikan jumlah instance secara dinamis sebagai respons terhadap perubahan beban kerja, memastikan pemanfaatan sumber daya yang efisien sambil menjaga biaya tetap terkendali.
Kebijakan auto-scaling menentukan kapan menambah atau menghapus instance berdasarkan metrik tertentu seperti penggunaan CPU, penggunaan memori YARN, atau panjang antrean tugas.
Konfigurasi auto-scaling utama:
- Kebijakan scale-out: Menambah instance saat beban kerja meningkat, memastikan pemrosesan job tepat waktu.
- Kebijakan scale-in: Mengurangi instance saat permintaan menurun, mencegah biaya yang tidak perlu.
- Periode cooldown: Mencegah tindakan penskalaan yang berlebihan dalam interval waktu singkat.
Untuk mengaktifkan auto-scaling, konfigurasikan Auto-Scaling Policy melalui AWS Management Console, CLI, atau API.
Contoh perintah AWS CLI untuk menetapkan kebijakan auto-scaling adalah:
aws emr put-auto-scaling-policy --cluster-id <your-cluster-id> --instance-group-id <your-instance-group-id> --auto-scaling-policy file://policy.jsonAuto-scaling sangat bermanfaat untuk beban kerja variabel, seperti analitik streaming, pemrosesan batch, dan tugas machine learning yang mengalami fluktuasi kebutuhan sumber daya.
Sebagai contoh, saya menggunakan auto-scaling saat menjalankan model machine learning yang mengalami lonjakan trafik yang tidak terduga. Sistem secara otomatis melakukan scale up saat jam sibuk dan scale down saat permintaan turun, yang mengoptimalkan biaya dan performa.
Spot instances untuk optimasi biaya
Amazon EC2 Spot Instances menyediakan cara hemat biaya untuk menjalankan klaster EMR dengan memanfaatkan kapasitas EC2 cadangan pada tarif yang jauh lebih rendah.
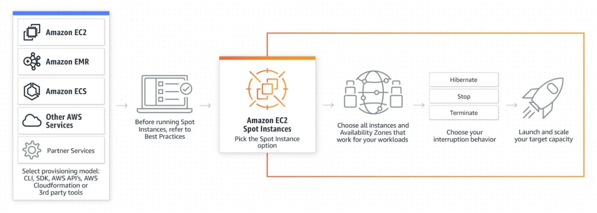
Instance ini ideal jika Anda memiliki beban kerja yang toleran terhadap gangguan, seperti pemrosesan big data dan machine learning.
Manfaat menggunakan Spot Instances di EMR:
- Penghematan biaya: Spot Instances bisa hingga 90% lebih murah daripada On-Demand instances.
- Skalabilitas: Anda dapat menambah daya komputasi secara dinamis dengan biaya lebih rendah.
- Jenis instance hibrida: EMR memungkinkan penggabungan Spot, On-Demand, dan Reserved Instances untuk menyeimbangkan biaya dan keandalan.
Namun, Spot Instances dapat terganggu jika AWS mengambil kembali kapasitas. Untuk menguranginya:
- Gunakan Instance Fleets alih-alih Instance Groups untuk mencampur Spot dan On-Demand secara dinamis.
- Terapkan checkpointing pada beban kerja untuk memulihkan dari potensi gangguan.
- Atur Permintaan Spot yang terdiversifikasi di beberapa Availability Zone dan jenis instance untuk meningkatkan stabilitas.
Untuk mengonfigurasi Spot Instances di EMR, gunakan perintah AWS CLI berikut:
aws emr create-cluster --instance-fleets file://instance-fleet-config.jsonMenggabungkan penskalaan manual, auto-scaling, dan Spot Instances dapat membantu Anda mengoptimalkan klaster EMR untuk performa, efisiensi biaya, dan keandalan.
Keamanan dan Kontrol Akses di Amazon EMR
Peran IAM yang salah dikonfigurasi di EMR dapat mengekspos data sensitif kepada pengguna yang tidak diinginkan. Oleh karena itu, Anda harus selalu menggunakan prinsip least privilege dan membatasi akses SSH hanya untuk IP tepercaya.
AWS menyediakan fitur keamanan yang tangguh, termasuk peran IAM untuk kontrol akses, enkripsi untuk perlindungan data, dan praktik terbaik untuk mengamankan lingkungan Anda.
Peran dan kebijakan IAM
AWS Identity and Access Management (IAM) mengontrol akses ke klaster EMR dan sumber daya terkait.
Saat membuat klaster, Anda harus menetapkan peran IAM yang memberikan izin untuk berinteraksi dengan S3, DynamoDB, dan layanan AWS lainnya.
Menetapkan kebijakan least-privilege memastikan keamanan dengan membatasi akses hanya ke sumber daya yang diperlukan.
Gambar di bawah menunjukkan managed policies dan bagaimana penggunaannya dengan EMR.
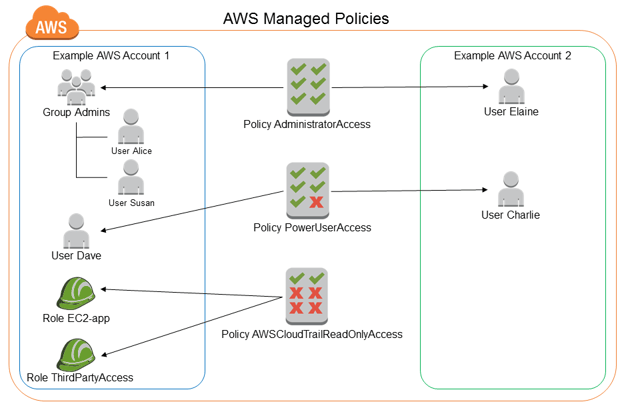
Tangkapan layar pengaturan kebijakan AWS IAM yang menunjukkan bagaimana izin ditetapkan. Sumber: AWS Docs
Enkripsi data dan praktik terbaik keamanan
Amazon EMR mendukung enkripsi untuk data saat disimpan menggunakan enkripsi sisi server Amazon S3 (SSE) atau AWS Key Management Service (KMS). Data saat transit dapat diamankan menggunakan protokol SSL/TLS.
Praktik keamanan terbaik meliputi penggunaan multi-factor authentication (MFA) untuk mengakses konsol AWS, membatasi akses SSH, dan mengelola kunci API dengan aman.
Jika Anda ingin mempelajari lebih lanjut tentang keamanan AWS, lihat kursus AWS Security and Cost Management.
Pemecahan Masalah Amazon EMR
Meskipun Amazon EMR dirancang untuk skalabilitas dan keandalan, masalah tetap dapat muncul selama operasi klaster dan eksekusi job.
Tantangan umum meliputi bottleneck performa, kegagalan job, dan keterbatasan sumber daya. Memahami cara mendiagnosis dan menyelesaikan masalah ini dapat membantu Anda mempertahankan alur kerja yang efisien.
Masalah umum pada klaster EMR
Pengguna sering mengalami masalah seperti eksekusi job yang lambat, alokasi memori yang tidak memadai, kegagalan instance, dan pengacakan data yang tidak efisien.
Masalah performa dapat berasal dari jenis instance yang tidak tepat, klaster yang kurang diprovisikan, atau I/O disk yang berlebihan. Untuk mengatasinya:
- Optimalkan parameter job: Sesuaikan pengaturan seperti memori executor, paralelisme, dan shuffle partitions untuk menyeimbangkan penggunaan sumber daya.
- Skalakan instance secara tepat: Manfaatkan kebijakan auto-scaling untuk menyesuaikan ukuran klaster secara dinamis berdasarkan permintaan beban kerja.
- Pantau dan tinjau log: Gunakan Amazon CloudWatch, konsol EMR, atau analisis log langsung di Amazon S3 untuk mengidentifikasi bottleneck dan titik kegagalan.
Mendiagnosis job Spark dan Hadoop
Ketika job Spark atau Hadoop gagal, memahami akar penyebabnya sangat penting untuk perbaikan.
Log yang disimpan di Amazon S3 atau dapat diakses melalui konsol EMR memberikan wawasan berharga tentang kegagalan eksekusi, masalah memori, dan perlambatan tugas.
- Gunakan Spark history server: Alat ini membantu menganalisis linimasa eksekusi job, operasi shuffle, dan distribusi tugas untuk mengidentifikasi bottleneck performa.
- Manfaatkan Hadoop job tracker: Untuk beban kerja MapReduce, Job Tracker menyediakan statistik eksekusi terperinci, membantu mengidentifikasi masalah seperti tugas yang berjalan lama atau skew data.
- Setel performa dengan Dr. Elephant dan Sparklens: Alat-alat ini memberikan rekomendasi untuk mengoptimalkan beban kerja Spark dan Hadoop dengan menganalisis metrik eksekusi sebelumnya.
Gambar di bawah menunjukkan bagaimana Dr. Elephant dan Sparklens dapat digunakan untuk menyetel performa Hadoop dan Spark di Amazon EMR.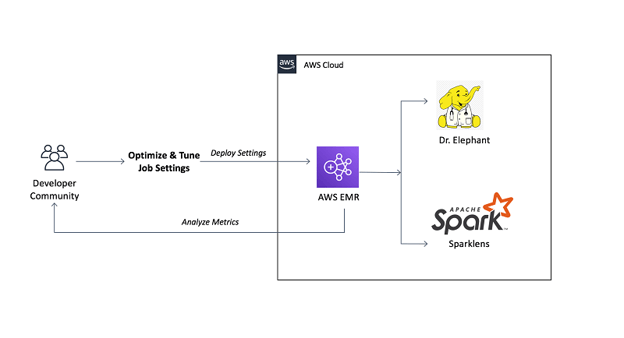
Antarmuka Dr. Elephant dan Sparklens yang menampilkan wawasan penyetelan performa untuk job Hadoop dan Spark di Amazon EMR. Sumber: AWS Blogs
Kesehatan klaster dan pemulihan
Jika klaster mengalami kegagalan, mendiagnosis masalah dengan cepat dapat meminimalkan downtime dan mencegah kehilangan data.
Amazon CloudWatch dan AWS CloudTrail menawarkan kemampuan pemantauan dan peringatan yang dapat membantu mengidentifikasi masalah mendasar.
- Periksa metrik CloudWatch: Lihat penggunaan CPU, konsumsi memori, dan I/O disk untuk menentukan apakah sumber daya kurang atau berlebihan dimanfaatkan.
- Mulai ulang instance yang gagal: Jika instance gagal karena masalah perangkat keras atau perangkat lunak, memulai ulang atau menggantinya dengan instance baru dapat memulihkan stabilitas klaster.
- Luncurkan klaster baru dari konfigurasi tersimpan: Untuk pulih dari kegagalan kritis, Anda dapat menggunakan fitur cloning Amazon EMR untuk meluncurkan klaster baru dengan pengaturan dan bootstrap actions yang sama.
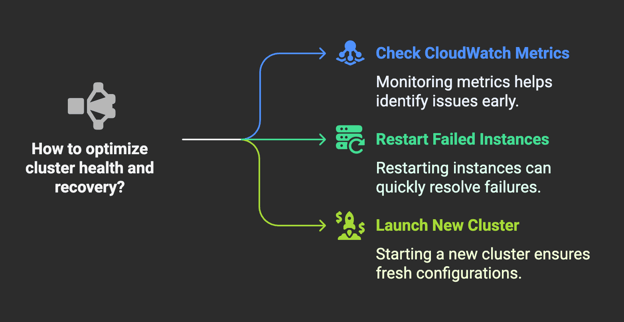 Diagram yang mengilustrasikan cara mengoptimalkan kesehatan dan pemulihan klaster di Amazon EMR. Gambar dibuat menggunakan Napkin AI
Manajemen Biaya dengan Amazon EMR
Mengelola biaya secara efektif sangat penting saat menjalankan beban kerja di Amazon EMR. Harga bergantung pada faktor seperti jenis instance, penyimpanan, dan transfer data, tetapi ada strategi untuk mengoptimalkan pengeluaran.
Memahami penetapan harga
Penetapan harga Amazon EMR terutama didasarkan pada beberapa faktor utama: instance komputasi, penyimpanan, dan transfer data.
- On-demand instances memungkinkan Anda menyesuaikan skala klaster sesuai kebutuhan, memberikan fleksibilitas tanpa komitmen jangka panjang. Namun, model ini bisa mahal untuk beban kerja yang berkelanjutan.
- Spot Instances menawarkan alternatif hemat biaya dengan memungkinkan Anda menawar kapasitas EC2 yang tidak terpakai pada tarif yang jauh lebih rendah. Meskipun Spot Instances dapat memberikan penghematan signifikan, ketersediaannya tidak selalu terjamin dan berpotensi terganggu.
Untuk memperkirakan biaya secara akurat, Anda dapat menggunakan AWS Pricing Calculator, yang memperhitungkan konfigurasi klaster, jenis instance, dan kebutuhan beban kerja.
Anda perlu memahami struktur harga ini untuk memungkinkan perkiraan dan penganggaran yang lebih baik, sehingga memastikan alokasi sumber daya yang efisien.
Selain itu, memanfaatkan AWS Savings Plans atau Reserved Instances untuk beban kerja yang dapat diprediksi dapat mengunci tarif yang lebih rendah dan mengurangi biaya keseluruhan.
Strategi optimasi biaya
Untuk mengoptimalkan biaya, Anda harus menerapkan beberapa praktik terbaik saat menjalankan beban kerja Amazon EMR:
- Auto-scaling: Menyesuaikan ukuran klaster secara dinamis berdasarkan permintaan beban kerja memastikan Anda hanya menggunakan sumber daya yang diperlukan kapan pun. Ini mencegah over-provisioning dan mengurangi pemborosan biaya.
- Right-sizing instance: Memilih jenis instance yang paling sesuai untuk beban kerja Anda dapat meningkatkan performa sekaligus meminimalkan biaya. Misalnya, instance yang dioptimalkan komputasi cocok untuk tugas berat pemrosesan, sedangkan instance yang dioptimalkan memori lebih baik untuk analitik in-memory.
- Spot instances untuk penghematan biaya: Menggunakan Spot Instances bila memungkinkan dapat secara signifikan menurunkan biaya komputasi. Untuk mengurangi gangguan, pertimbangkan menjalankan beban kerja yang toleran terhadap penghentian instance dan strategi rebalancing.
- Optimasi klaster: Mengonfigurasi klaster secara efisien dengan memilih jumlah node yang tepat dan menyesuaikan pengaturan Hadoop atau Spark dapat meningkatkan performa tanpa pengeluaran berlebihan.
- Hentikan klaster menganggur: Memantau aktivitas klaster dan mematikan klaster yang tidak aktif mencegah timbulnya biaya yang tidak perlu.
- Memanfaatkan layanan terkelola: Mengalihkan tugas ETL tertentu ke AWS Glue dapat menjadi alternatif yang hemat biaya dibanding menjalankan proses yang sama di Amazon EMR. AWS Glue adalah layanan serverless yang dapat diskalakan otomatis berdasarkan kebutuhan beban kerja, sehingga tidak perlu mengelola dan membayar sumber daya komputasi yang menganggur.
Menerapkan strategi optimasi biaya ini akan membantu Anda menyeimbangkan performa dan efisiensi biaya.
Untuk pemahaman yang lebih luas tentang manajemen biaya cloud AWS, lihat AWS Cloud Technology and Services.
Kesimpulan
Setelah bekerja dengan Amazon EMR, saya menyadari bagaimana layanan ini menyederhanakan pemrosesan big data dengan mengotomatiskan manajemen klaster, penskalaan, dan integrasi layanan AWS. EMR sangat penting bagi siapa pun yang menangani beban kerja data berskala besar, baik Anda baru memulai maupun sedang mengoptimalkan pipeline yang ada.
Jika Anda menjajaki solusi big data berbasis cloud, EMR adalah opsi yang kuat dan dapat diskalakan untuk dipertimbangkan!





Bayangkan Anda mengelola terabita data transaksi pelanggan, dan sistem yang ada mulai kewalahan menanggung beban.
Anda memerlukan solusi yang dapat diskalakan sesuai permintaan, mengoptimalkan biaya, dan terintegrasi dengan setup AWS Anda saat ini. Amazon Elastic MapReduce (EMR) dapat membantu. Ketika saya pertama kali bekerja dengan big data, saya menghadapi tantangan yang sama—sampai saya menemukan EMR.
Dalam panduan ini, kita akan membahas semuanya mulai dari menyiapkan klaster EMR hingga mengeksekusi beban kerja, mengoptimalkan performa, memastikan keamanan, memecahkan masalah, dan mengelola biaya.
Apa itu Amazon EMR?
Amazon EMR adalah layanan klaster terkelola penuh yang menyederhanakan pemrosesan big data dengan menyediakan provisi, penskalaan, dan konfigurasi otomatis untuk kerangka kerja open-source.
Layanan ini memungkinkan Anda menganalisis sejumlah besar data terstruktur dan tidak terstruktur tanpa repot mengelola klaster on-premises secara manual.
Gambar di bawah memperlihatkan cara Amazon EMR on EKS bekerja dengan layanan AWS lainnya, memberikan representasi visual integrasi dan alurnya.
Diagram yang mengilustrasikan bagaimana Amazon EMR berintegrasi dengan Amazon EKS dan layanan AWS lainnya untuk pemrosesan big data. Sumber: AWS Docs
Jika Anda baru di AWS, saya sarankan memeriksa kursus Introduction to AWS untuk membangun pengetahuan dasar.
Beberapa fitur utama Amazon EMR meliputi:
Mengotomatisasi manajemen klaster dan penskalaan memungkinkan Anda mengurangi kompleksitas operasional dan fokus pada pemrosesan serta analitik data.
Jika Anda ingin lebih memahami layanan penyimpanan AWS seperti Amazon S3 sebelum melanjutkan dengan Amazon EMR, simak tutorial AWS Storage ini.
Menyiapkan Klaster Amazon EMR
Untuk menyiapkan klaster Amazon EMR, Anda perlu mengakses layanan EMR, membuat klaster, dan mengonfigurasinya agar sesuai dengan beban kerja Anda.
Membuat klaster EMR
Untuk memulai, masuk ke AWS Management Console dan navigasikan ke layanan EMR.
Anda dapat melakukannya dengan mencari "EMR" di panel pencarian AWS Management Console — seperti pada gambar di bawah.
Setelah berada di sana, klik “Create Cluster” — seperti pada gambar di bawah.
Gambar di bawah menampilkan tangkapan layar antarmuka EMR saat ini—meskipun dapat berubah seiring waktu, pengaturan inti akan tetap serupa.
Untuk mengonfigurasi klaster Amazon EMR Anda, Anda perlu menyesuaikan beberapa pengaturan agar selaras dengan kebutuhan beban kerja spesifik. Ikuti petunjuk di bawah ini:
01: Pilih kerangka kerja big data
EMR menyediakan beberapa kerangka kerja, seperti Apache Spark untuk pemrosesan in-memory, Hadoop untuk penyimpanan dan pemrosesan terdistribusi, serta Presto untuk kueri SQL interaktif.
Pilih kerangka kerja yang paling sesuai dengan use case Anda.
02: Pilih jenis instance
Jenis instance memengaruhi performa dan biaya. Pilihan umum adalah
m5.xlarge, karena menawarkan keseimbangan antara daya komputasi dan keterjangkauan.Untuk beban kerja yang intensif memori, gunakan
r5.xlarge, sedangkanc5.xlargelebih cocok untuk tugas yang intensif komputasi.03: Konfigurasikan node klaster
Klaster EMR terdiri dari tiga jenis node:
04: Konfigurasikan keamanan dan akses
Siapkan pasangan kunci EC2 untuk akses SSH dan konfigurasikan peran IAM untuk mengontrol izin.
Sebaiknya Anda mengaktifkan autentikasi Kerberos atau AWS Lake Formation untuk keamanan yang lebih baik.
05: Siapkan jaringan dan penyimpanan
Tentukan pengaturan VPC, aktifkan auto-scaling untuk menyesuaikan ukuran klaster secara dinamis, dan tentukan Amazon S3 sebagai lokasi penyimpanan utama (
s3://your-bucket-name/).06: Luncurkan klaster
Setelah meninjau konfigurasi, klik "Create Cluster" untuk meluncurkannya.
Klaster akan memerlukan beberapa menit untuk inisialisasi sebelum siap digunakan.
Gambar di bawah menyoroti antarmuka tempat Anda dapat membuat klaster.
Mengonfigurasi aplikasi dan dependensi
Setelah klaster aktif dan berjalan, Anda dapat menyetelnya lebih lanjut dengan memilih aplikasi prainstal dan mengonfigurasi bootstrap actions:
pip install pandas numpy)Konfigurasi yang tepat memastikan klaster EMR Anda benar-benar dioptimalkan untuk bebannya, sehingga mengurangi waktu pemrosesan dan biaya operasional.
Bekerja dengan Amazon EMR
Setelah klaster EMR Anda disiapkan dan dikonfigurasi, langkah berikutnya adalah mulai bekerja dengan data Anda.
Mengunggah data ke Amazon EMR
Amazon EMR terutama mengandalkan Amazon S3 untuk menyimpan dataset masukan dan menyimpan hasil keluaran.
Berbeda dengan HDFS yang menyimpan data di dalam klaster, S3 menawarkan ketahanan, skalabilitas, dan efisiensi biaya, sehingga menjadi pilihan utama untuk mengelola data di EMR.
Untuk mengunggah data ke Amazon S3, ikuti langkah-langkah berikut:
01: Buka konsol S3
Masuk ke AWS Management Console dan buka layanan Amazon S3.
02: Buat atau pilih bucket
Pilih bucket yang sudah ada atau buat yang baru. Pastikan bucket berada di region yang sama dengan klaster EMR Anda untuk meminimalkan latensi.
Gambar di bawah menunjukkan proses pembuatan bucket Amazon S3.
Saat membuat bucket, ingat bahwa nama bucket harus unik secara global dan mematuhi konvensi penamaan AWS. Pastikan Anda memilih nama yang mencerminkan use case Anda sekaligus memenuhi persyaratan tersebut.
03: Unggah file data
Klik "Upload", pilih file yang diperlukan, dan tentukan izin akses.
Gambar di bawah menyoroti antarmuka tempat Anda dapat mengunggah file ke bucket Amazon S3.
Sebagai alternatif, Anda dapat menggunakan AWS CLI untuk mengunggah file secara terprogram.
Sebelum melakukannya, Anda perlu memastikan bahwa AWS CLI terpasang dan dikonfigurasi dengan kredensial yang sesuai dengan menjalankan:
Perintah ini akan meminta Anda memasukkan AWS Access Key ID, Secret Access Key, region, dan format output untuk mengautentikasi sesi Anda. Anda dapat melewati langkah di atas jika AWS CLI sudah dikonfigurasi.
Setelah dikonfigurasi, Anda dapat mengunggah file menggunakan perintah berikut:
04: Akses data dari EMR
Setelah diunggah, data dapat diakses dari EMR menggunakan path S3:
s3://your-bucket-name/data/Aplikasi seperti Spark, Hadoop, dan Hive kemudian dapat memproses data langsung dari S3.
Opsi penyimpanan data alternatif
Menjalankan job Spark atau Hadoop
Setelah mengunggah data, Anda dapat memprosesnya menggunakan Apache Spark, Hadoop, atau kerangka kerja big data lainnya.
EMR memungkinkan eksekusi job melalui AWS CLI, konsol EMR, atau akses SSH langsung.
Menjalankan job Spark
Untuk mengirim job Spark, lakukan SSH ke klaster dan gunakan perintah spark-submit:
Sebagai alternatif, Anda dapat mengirim job melalui fitur "Steps" di AWS EMR — yang memungkinkan otomatisasi job tanpa mengakses klaster secara manual.
Untuk mempelajari konsep dasar sebelum menjalankan job Spark di EMR, kursus Big Data Fundamentals with PySpark menawarkan titik awal yang bagus. Jika alur kerja Anda mencakup menyiapkan dataset yang berantakan, Anda mungkin akan terbantu dengan kursus Cleaning Data with PySpark yang sangat berguna.
Menjalankan job Hadoop MapReduce
Untuk job Hadoop, gunakan antarmuka baris perintah:
Job Hadoop juga dapat dikelola menggunakan AWS Step Functions untuk mengotomatisasi alur kerja.
Keamanan dan kontrol akses yang efektif sangat penting saat menjalankan job big data.
Karena job Spark dan Hadoop berinteraksi dengan data sensitif, Amazon EMR terintegrasi dengan Apache Ranger untuk menerapkan kontrol akses dan izin yang terperinci.
Gambar di bawah mengilustrasikan contoh arsitektur integrasi ini, menyoroti bagaimana kebijakan keamanan diterapkan di seluruh klaster EMR.
Memantau performa klaster
Untuk memastikan pemrosesan yang efisien, pantau klaster EMR Anda menggunakan Amazon CloudWatch, Ganglia, dan Spark UI.
Alat-alat ini memberikan wawasan waktu nyata tentang pemanfaatan sumber daya, progres job, dan potensi bottleneck.
Alat pemantauan utama
Praktik terbaik untuk optimasi performa
spark.executor.memory), paralelisme (spark.default.parallelism), dan ukuran blok Hadoop untuk performa optimal.Dengan mengikuti langkah-langkah ini, Anda dapat memproses dataset besar secara efisien sambil menjaga klaster EMR tetap hemat biaya dan berkinerja tinggi.