

Amazon EMR क्लस्टर्स को स्केल करना
जैसे-जैसे आपकी डेटा प्रोसेसिंग आवश्यकताएँ विकसित होती हैं, आपको प्रदर्शन और लागत दक्षता बनाए रखने के लिए अपने EMR क्लस्टर के संसाधनों को समायोजित करने की आवश्यकता हो सकती है।
EMR मैनुअल और स्वचालित स्केलिंग विकल्प प्रदान करता है, जिससे आप वर्कलोड मांग के आधार पर इंस्टेंस की संख्या संशोधित कर सकते हैं।
इसके अलावा, Spot Instances का लाभ लेने से आप स्केलेबिलिटी सुनिश्चित करते हुए लागतों का अनुकूलन कर सकते हैं।
मैनुअल स्केलिंग
मैनुअल स्केलिंग आपको रीयल-टाइम वर्कलोड मांग के आधार पर अपने क्लस्टर में इंस्टेंस की संख्या बढ़ाने या घटाने की अनुमति देती है।
यह समायोजन EMR कंसोल, AWS CLI, या EMR API के माध्यम से किया जा सकता है।
- EMR कंसोल का उपयोग करके: अपने क्लस्टर पर नेविगेट करें, "Resize" चुनें, और वांछित इंस्टेंस संख्या निर्दिष्ट करें।
- AWS CLI का उपयोग करके: क्लस्टर आकार संशोधित करने के लिए निम्न कमांड चलाएँ:
aws emr modify-instance-groups --cluster-id <your-cluster-id> --instance-groups InstanceGroupId=<your-instance-group-id>,InstanceCount=<new-instance-count>- EMR API का उपयोग करके: आप
ModifyInstanceGroupsAPI का उपयोग करके इंस्टेंस की संख्या को डायनामिक रूप से समायोजित कर सकते हैं।
मैनुअल स्केलिंग पूर्वानुमेय वर्कलोड्स के लिए सबसे उपयुक्त है, जहाँ आप अग्रिम में संसाधन आवश्यकताओं का अनुमान लगा सकते हैं।
उदाहरण के लिए, मैंने मैनुअल स्केलिंग का उपयोग तब किया जब मुझे पता था कि मेरे डेटा प्रोसेसिंग जॉब में स्थिर मांग होगी, जिससे मैंने अपेक्षित वर्कलोड के आधार पर इंस्टेंस संख्या समायोजित की और इष्टतम संसाधन उपयोग सुनिश्चित किया।
Amazon EMR में ऑटो-स्केलिंग
EMR में ऑटो-स्केलिंग वर्कलोड परिवर्तनों के जवाब में इंस्टेंस की संख्या को डायनामिक रूप से समायोजित करती है, जिससे कुशल संसाधन उपयोग सुनिश्चित होता है और लागत नियंत्रण में रहती है।
ऑटो-स्केलिंग नीतियाँ CPU उपयोग, YARN मेमोरी उपयोग, या टास्क कतार की लंबाई जैसे विशिष्ट मेट्रिक्स के आधार पर कब इंस्टेंस जोड़ने या हटाने हैं, यह परिभाषित करती हैं।
मुख्य ऑटो-स्केलिंग कॉन्फ़िगरेशन:
- स्केल-आउट पॉलिसी: वर्कलोड बढ़ने पर इंस्टेंस जोड़ती है, जिससे जॉब्स का समय पर प्रोसेसिंग सुनिश्चित होता है।
- स्केल-इन पॉलिसी: मांग घटने पर इंस्टेंस कम करती है, जिससे अनावश्यक लागतें रोकी जाती हैं।
- कूलडाउन पीरियड्स: कम समयांतराल में अत्यधिक स्केलिंग कार्रवाइयों को रोकते हैं।
ऑटो-स्केलिंग सक्षम करने के लिए, AWS Management Console, CLI, या API के माध्यम से Auto-Scaling Policy कॉन्फ़िगर करें।
ऑटो-स्केलिंग पॉलिसी सेट करने के लिए AWS CLI कमांड का एक उदाहरण है:
aws emr put-auto-scaling-policy --cluster-id <your-cluster-id> --instance-group-id <your-instance-group-id> --auto-scaling-policy file://policy.jsonऑटो-स्केलिंग विशेष रूप से परिवर्ती वर्कलोड्स के लिए लाभकारी है, जैसे स्ट्रीमिंग एनालिटिक्स, बैच प्रोसेसिंग, और मशीन लर्निंग कार्य जहाँ संसाधन आवश्यकताएँ उतार-चढ़ाव करती हैं।
उदाहरण के लिए, मैंने एक मशीन लर्निंग मॉडल चलाते समय ऑटो-स्केलिंग का उपयोग किया जो ट्रैफिक में अप्रत्याशित स्पाइक्स का अनुभव करता था। सिस्टम ने पीक समय में स्वचालित रूप से स्केल-अप किया और मांग घटने पर स्केल-डाउन किया, जिससे लागत और प्रदर्शन दोनों का अनुकूलन हुआ।
लागत अनुकूलन के लिए Spot Instances
Amazon EC2 Spot Instances, अतिरिक्त EC2 क्षमता का काफी कम दरों पर उपयोग करके EMR क्लस्टर्स चलाने का किफायती तरीका प्रदान करती हैं।
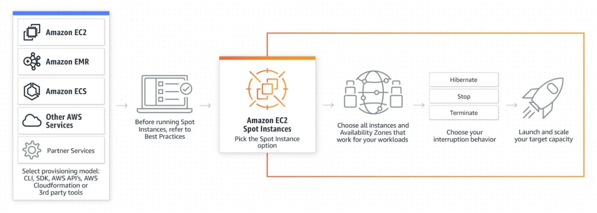
ये इंस्टेंस फ़ॉल्ट-टॉलरेंट वर्कलोड्स, जैसे बिग डेटा प्रोसेसिंग और मशीन लर्निंग, के लिए आदर्श हैं।
EMR में Spot Instances उपयोग के लाभ:
- लागत बचत: Spot Instances, On-Demand इंस्टेंस से 90% तक सस्ती हो सकती हैं।
- स्केलेबिलिटी: आप कम लागत पर अधिक कंप्यूट पावर को डायनामिक रूप से जोड़ सकते हैं।
- हाइब्रिड इंस्टेंस प्रकार: EMR लागत और विश्वसनीयता को संतुलित करने के लिए Spot, On-Demand, और Reserved Instances को मिलाने की अनुमति देता है।
हालाँकि, यदि AWS क्षमता वापस लेता है तो Spot Instances बाधित हो सकती हैं। इसे कम करने के लिए:
- Instance Groups के बजाय Instance Fleets का उपयोग करें ताकि Spot और On-Demand इंस्टेंस को डायनामिक रूप से मिलाया जा सके।
- संभावित बाधाओं से उबरने के लिए वर्कलोड्स में चेकपॉइंटिंग लागू करें।
- स्थिरता बढ़ाने के लिए कई Availability Zones और इंस्टेंस प्रकारों में विविधीकृत Spot Requests सेट करें।
EMR में Spot Instances कॉन्फ़िगर करने के लिए, निम्न AWS CLI कमांड का उपयोग करें:
aws emr create-cluster --instance-fleets file://instance-fleet-config.jsonमैनुअल स्केलिंग, ऑटो-स्केलिंग, और Spot Instances को मिलाकर आप अपने EMR क्लस्टर्स को प्रदर्शन, लागत-दक्षता, और विश्वसनीयता के लिए अनुकूलित कर सकते हैं।
Amazon EMR में सुरक्षा और एक्सेस नियंत्रण
EMR में गलत कॉन्फ़िगर किए गए IAM रोल्स संवेदनशील डेटा को अनपेक्षित उपयोगकर्ताओं के सामने उजागर कर सकते हैं। इसलिए, आपको हमेशा न्यूनतम विशेषाधिकार के सिद्धांत का उपयोग करना चाहिए और SSH एक्सेस को केवल विश्वसनीय IPs तक सीमित करना चाहिए।
AWS मज़बूत सुरक्षा सुविधाएँ प्रदान करता है, जिनमें एक्सेस नियंत्रण के लिए IAM रोल्स, डेटा सुरक्षा के लिए एन्क्रिप्शन, और आपके वातावरण को सुरक्षित रखने के सर्वोत्तम अभ्यास शामिल हैं।
IAM रोल्स और नीतियाँ
AWS Identity and Access Management (IAM) EMR क्लस्टर्स और संबंधित संसाधनों तक पहुँच को नियंत्रित करता है।
क्लस्टर बनाते समय, आपको ऐसे IAM रोल्स असाइन करने होंगे जो S3, DynamoDB, और अन्य AWS सेवाओं के साथ इंटरैक्ट करने की अनुमति दें।
न्यूनतम-विशेषाधिकार नीतियों को परिभाषित करने से केवल आवश्यक संसाधनों तक पहुँच सीमित करके सुरक्षा सुनिश्चित होती है।
नीचे दी गई छवि मैनेज्ड पॉलिसीज़ दिखाती है और यह कि उन्हें EMR के साथ कैसे उपयोग किया जा सकता है।
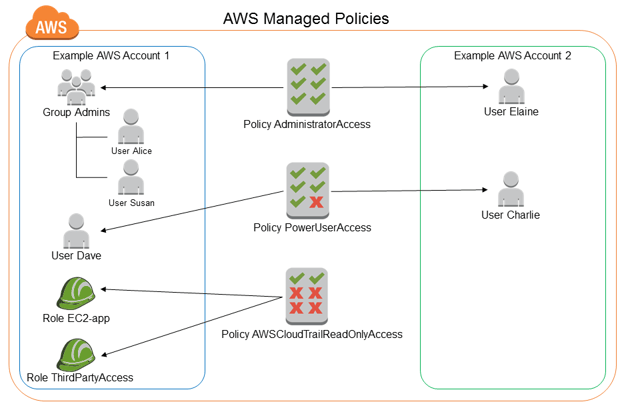
AWS IAM पॉलिसी सेटिंग्स का स्क्रीनशॉट जो दिखाता है कि अनुमतियाँ कैसे असाइन की जाती हैं। सोर्स: AWS Docs
डेटा एन्क्रिप्शन और सुरक्षा सर्वोत्तम अभ्यास
Amazon EMR, डेटा-ऐट-रेस्ट के लिए Amazon S3 सर्वर-साइड एन्क्रिप्शन (SSE) या AWS Key Management Service (KMS) के माध्यम से एन्क्रिप्शन का समर्थन करता है। ट्रांज़िट में डेटा को SSL/TLS प्रोटोकॉल का उपयोग करके सुरक्षित किया जा सकता है।
सुरक्षा के सर्वोत्तम अभ्यासों में AWS कंसोल तक पहुँच के लिए मल्टी-फैक्टर ऑथेंटिकेशन (MFA) का उपयोग करना, SSH एक्सेस को सीमित करना, और API कीज़ को सुरक्षित रूप से प्रबंधित करना शामिल है।
यदि आप AWS सुरक्षा के बारे में अधिक जानना चाहते हैं, तो यह AWS Security and Cost Management कोर्स देखें।
Amazon EMR का समस्या निवारण
हालाँकि Amazon EMR को स्केलेबिलिटी और विश्वसनीयता के लिए डिज़ाइन किया गया है, फिर भी क्लस्टर संचालन और जॉब निष्पादन के दौरान समस्याएँ उत्पन्न हो सकती हैं।
आम चुनौतियों में प्रदर्शन बाधाएँ, जॉब विफलताएँ, और संसाधन सीमाएँ शामिल हैं। इन समस्याओं का निदान और समाधान कैसे करना है, इसे समझने से आप एक कुशल वर्कफ़्लो बनाए रख सकते हैं।
EMR क्लस्टर्स की आम समस्याएँ
उपयोगकर्ता अक्सर धीमी जॉब निष्पादन, अपर्याप्त मेमोरी आवंटन, इंस्टेंस विफलताएँ, और अक्षम डेटा शफ़लिंग जैसी समस्याओं का सामना करते हैं।
प्रदर्शन समस्याएँ गलत इंस्टेंस प्रकारों, कम-प्रोविज़न्ड क्लस्टर्स, या अत्यधिक डिस्क I/O से उत्पन्न हो सकती हैं। इन समस्याओं को दूर करने के लिए:
- जॉब पैरामीटर्स का अनुकूलन करें: एक्जीक्यूटर मेमोरी, पैरेललिज़्म, और शफ़ल पार्टिशन जैसी सेटिंग्स को समायोजित करें ताकि संसाधन उपयोग संतुलित रहे।
- इंस्टेंस को उपयुक्त रूप से स्केल करें: वर्कलोड मांग के आधार पर क्लस्टर आकार को डायनामिक रूप से समायोजित करने के लिए ऑटो-स्केलिंग नीतियों का उपयोग करें।
- लॉग्स की निगरानी और समीक्षा करें: बाधाओं और विफलता बिंदुओं की पहचान करने के लिए Amazon CloudWatch, EMR कंसोल, या सीधे Amazon S3 में लॉग विश्लेषण का उपयोग करें।
Spark और Hadoop जॉब्स का निदान
जब Spark या Hadoop जॉब्स विफल होते हैं, तो मूल कारण को समझना सुधार के लिए महत्वपूर्ण होता है।
Amazon S3 में संग्रहीत या EMR कंसोल के माध्यम से एक्सेस किए गए लॉग्स निष्पादन विफलताओं, मेमोरी समस्याओं, और टास्क स्लोडाउन्स के बारे में मूल्यवान अंतर्दृष्टि प्रदान करते हैं।
- Spark history server का उपयोग करें: यह टूल जॉब निष्पादन टाइमलाइंस, शफ़ल ऑपरेशंस, और टास्क डिस्ट्रीब्यूशन का विश्लेषण करने में मदद करता है ताकि प्रदर्शन बाधाओं की पहचान की जा सके।
- Hadoop job tracker का लाभ उठाएँ: MapReduce वर्कलोड्स के लिए, Job Tracker विस्तृत निष्पादन आँकड़े प्रदान करता है, जो लंबे समय तक चलने वाले कार्यों या डेटा स्क्यू जैसी समस्याओं का पता लगाने में मदद करता है।
- Dr. Elephant और Sparklens के साथ प्रदर्शन ट्यून करें: ये टूल पिछले निष्पादन मेट्रिक्स का विश्लेषण करके Spark और Hadoop वर्कलोड्स को अनुकूलित करने के लिए सिफारिशें प्रदान करते हैं।
नीचे दी गई छवि दिखाती है कि Amazon EMR पर Hadoop और Spark में प्रदर्शन ट्यून करने के लिए Dr. Elephant और Sparklens का कैसे उपयोग किया जा सकता है।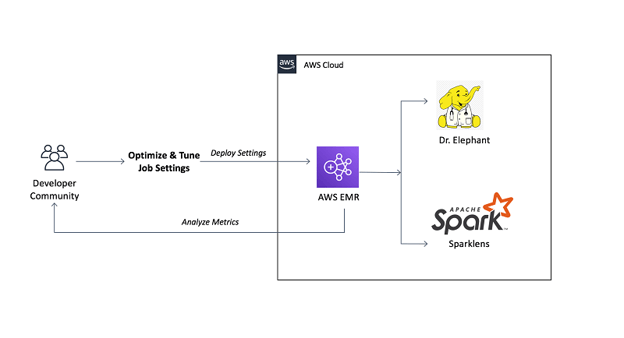
Dr. Elephant और Sparklens इंटरफ़ेस जो Amazon EMR पर Hadoop और Spark जॉब्स के लिए प्रदर्शन ट्यूनिंग इनसाइट्स प्रदर्शित कर रहे हैं। सोर्स: AWS Blogs
क्लस्टर स्वास्थ्य और रिकवरी
यदि कोई क्लस्टर विफलताओं का अनुभव करता है, तो समस्या का शीघ्र निदान डाउनटाइम को कम कर सकता है और डेटा हानि को रोक सकता है।
Amazon CloudWatch और AWS CloudTrail निगरानी और अलर्टिंग क्षमताएँ प्रदान करते हैं जो अंतर्निहित समस्याओं की पहचान करने में मदद कर सकते हैं।
- CloudWatch मेट्रिक्स जाँचें: CPU उपयोग, मेमोरी खपत, और डिस्क I/O देखें ताकि यह निर्धारित किया जा सके कि संसाधन कम-उपयोग या अधिक-उपयोग हो रहे हैं या नहीं।
- विफल इंस्टेंस को रीस्टार्ट करें: यदि कोई इंस्टेंस हार्डवेयर या सॉफ्टवेयर समस्याओं के कारण विफल होता है, तो उसे रीस्टार्ट करना या नए इंस्टेंस से बदलना क्लस्टर स्थिरता बहाल कर सकता है।
- सहेजी गई कॉन्फ़िगरेशन से नया क्लस्टर लॉन्च करें: गंभीर विफलताओं से उबरने के लिए, आप Amazon EMR की क्लोनिंग सुविधा का उपयोग करके समान सेटिंग्स और बूटस्ट्रैप एक्शंस के साथ एक नया क्लस्टर लॉन्च कर सकते हैं।
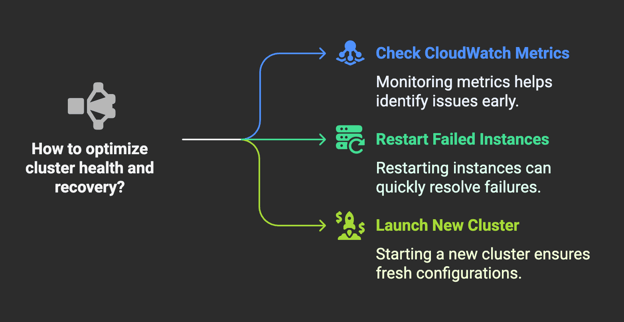 आरेख जो Amazon EMR में क्लस्टर स्वास्थ्य और रिकवरी को अनुकूलित करने के तरीकों को दर्शाता है। चित्र Napkin AI का उपयोग करके बनाया गया
Amazon EMR के साथ लागत प्रबंधन
Amazon EMR पर वर्कलोड्स चलाते समय लागत का प्रभावी प्रबंधन महत्वपूर्ण है। मूल्य-निर्धारण इंस्टेंस प्रकारों, स्टोरेज, और डेटा ट्रांसफ़र जैसे कारकों पर निर्भर करता है, लेकिन खर्च को अनुकूलित करने की रणनीतियाँ मौजूद हैं।
मूल्य-निर्धारण को समझना
Amazon EMR का मूल्य-निर्धारण मुख्य रूप से कई प्रमुख कारकों पर आधारित है: कंप्यूट इंस्टेंस, स्टोरेज, और डेटा ट्रांसफ़र।
- On-demand इंस्टेंस आपको आवश्यकता अनुसार क्लस्टर्स को स्केल करने की अनुमति देते हैं, जो बिना दीर्घकालिक प्रतिबद्धताओं के लचीलापन प्रदान करते हैं। हालाँकि, सतत वर्कलोड्स के लिए यह मॉडल महंगा हो सकता है।
- Spot Instances बिना उपयोग की गई EC2 क्षमता पर काफी कम दरों पर बोली लगाने की अनुमति देकर एक किफायती विकल्प प्रदान करती हैं। जबकि Spot Instances पर्याप्त बचत प्रदान कर सकती हैं, वे उपलब्धता और संभावित व्यवधानों के अधीन होती हैं।
लागत का सटीक अनुमान लगाने के लिए, आप AWS Pricing Calculator का उपयोग कर सकते हैं, जो क्लस्टर कॉन्फ़िगरेशन, इंस्टेंस प्रकारों, और वर्कलोड मांगों को ध्यान में रखता है।
इन मूल्य संरचनाओं को समझना बेहतर पूर्वानुमान और बजटिंग को सक्षम करता है, जिससे कुशल संसाधन आवंटन सुनिश्चित होता है।
इसके अलावा, पूर्वानुमेय वर्कलोड्स के लिए AWS Savings Plans या Reserved Instances का लाभ उठाने से कम दरें लॉक की जा सकती हैं और कुल लागत कम हो सकती है।
लागत अनुकूलन रणनीतियाँ
लागतों को अनुकूलित करने के लिए, आपको Amazon EMR वर्कलोड्स चलाते समय कई सर्वोत्तम अभ्यास लागू करने चाहिए:
- ऑटो-स्केलिंग: वर्कलोड मांग के आधार पर क्लस्टर आकार को डायनामिक रूप से समायोजित करना सुनिश्चित करता है कि आप किसी भी समय केवल आवश्यक संसाधनों का उपयोग कर रहे हैं। यह ओवर-प्रोविज़निंग को रोकता है और बेकार खर्च को कम करता है।
- राइट-साइज़िंग इंस्टेंस: अपने वर्कलोड्स के लिए सबसे उपयुक्त इंस्टेंस प्रकार चुनना प्रदर्शन बढ़ाते हुए लागतों को न्यूनतम कर सकता है। उदाहरण के लिए, कंप्यूट-ऑप्टिमाइज़्ड इंस्टेंस प्रोसेसिंग-हेवी कार्यों के लिए अच्छे होते हैं, जबकि मेमोरी-ऑप्टिमाइज़्ड इंस्टेंस इन-मेमाेरी एनालिटिक्स के लिए बेहतर हैं।
- लागत बचत के लिए Spot Instances: जहाँ संभव हो Spot Instances का उपयोग करने से कंप्यूट लागतों में काफी कमी आ सकती है। व्यवधानों को कम करने के लिए, ऐसे फ़ॉल्ट-टॉलरेंट वर्कलोड्स चलाने पर विचार करें जो इंस्टेंस टर्मिनेशन और रिबैलेंसिंग रणनीतियों को संभाल सकें।
- क्लस्टर अनुकूलन: सही संख्या में नोड्स का चयन करके और Hadoop या Spark सेटिंग्स समायोजित करके क्लस्टर्स को कुशलतापूर्वक कॉन्फ़िगर करना, अतिरिक्त खर्च के बिना प्रदर्शन में सुधार कर सकता है।
- निष्क्रिय क्लस्टर्स समाप्त करें: क्लस्टर गतिविधि की निगरानी करना और निष्क्रिय क्लस्टर्स को बंद करना अनावश्यक लागतों को बढ़ने से रोकता है।
- मैनेज्ड सेवाओं का उपयोग: कुछ ETL कार्यों को AWS Glue पर स्थानांतरित करना Amazon EMR पर वही प्रक्रियाएँ चलाने की तुलना में किफायती विकल्प हो सकता है। AWS Glue एक सर्वरलेस सेवा है जो वर्कलोड आवश्यकताओं के आधार पर स्वचालित रूप से स्केल हो सकती है, जिससे निष्क्रिय कंप्यूट संसाधनों को मैनेज और उसके लिए भुगतान करने की आवश्यकता समाप्त हो जाती है।
इन लागत अनुकूलन रणनीतियों को लागू करने से आप प्रदर्शन और लागत दक्षता के बीच संतुलन बना पाएँगे।
AWS क्लाउड लागत प्रबंधन की व्यापक समझ के लिए, इसे देखेँ AWS Cloud Technology and Services।
निष्कर्ष
Amazon EMR के साथ काम करने के बाद, मैंने सराहा है कि यह क्लस्टर मैनेजमेंट, स्केलिंग, और AWS सेवा इंटीग्रेशन को स्वचालित करके बिग डेटा प्रोसेसिंग को कैसे सरल बनाता है। बड़े पैमाने के डेटा वर्कलोड्स से निपटने वाले किसी भी व्यक्ति के लिए यह आवश्यक है—चाहे आप अभी शुरुआत कर रहे हों या किसी मौजूदा पाइपलाइन का अनुकूलन कर रहे हों।
यदि आप क्लाउड-आधारित बिग डेटा समाधानों का पता लगा रहे हैं, तो EMR एक शक्तिशाली, स्केलेबल विकल्प है जिस पर विचार किया जाना चाहिए!

मान लीजिए आप ग्राहकों के लेन-देन डेटा के टेराबाइट्स संभाल रहे हैं, और आपका मौजूदा सिस्टम दबाव में टूटने लगा है।
आपको ऐसी समाधान की आवश्यकता है जो मांग के अनुसार स्केल हो, लागत का अनुकूलन करे, और आपके मौजूदा AWS सेटअप के साथ इंटीग्रेट हो। Amazon Elastic MapReduce (EMR) इसमें मदद कर सकता है। जब मैंने पहली बार बिग डेटा के साथ काम शुरू किया, तो मुझे भी यही चुनौती का सामना करना पड़ा—जब तक कि मैंने EMR की खोज नहीं की।
इस गाइड में, हम EMR क्लस्टर सेट अप करने से लेकर वर्कलोड चलाने, प्रदर्शन को अनुकूलित करने, सुरक्षा सुनिश्चित करने, समस्याओं का निवारण करने, और लागत प्रबंधन तक सब कुछ कवर करेंगे।
Amazon EMR क्या है?
Amazon EMR एक फुली मैनेज्ड क्लस्टर-आधारित सेवा है जो ओपन-सोर्स फ्रेमवर्क्स की स्वचालित प्रोविजनिंग, स्केलिंग, और कॉन्फ़िगरेशन प्रदान करके बिग डेटा प्रोसेसिंग को सरल बनाती है।
यह आपको ऑन-प्रिमाइसेस क्लस्टर्स को मैन्युअली मैनेज किए बिना, संरचित और असंरचित डेटा की विशाल मात्रा का विश्लेषण करने की सुविधा देता है।
नीचे दी गई छवि दिखाती है कि Amazon EMR on EKS अन्य AWS सेवाओं के साथ कैसे काम करता है, जिससे इसके इंटीग्रेशन और वर्कफ़्लो का दृश्य प्रतिनिधित्व मिलता है।
एक आरेख जो दिखाता है कि Amazon EMR बड़े डेटा प्रोसेसिंग के लिए Amazon EKS और अन्य AWS सेवाओं के साथ कैसे इंटीग्रेट करता है। सोर्स: AWS Docs
यदि आप AWS में नए हैं, तो मैं आपको बुनियादी ज्ञान बनाने के लिए इस Introduction to AWS कोर्स को देखने की सलाह देता/देती हूँ।
Amazon EMR की कुछ प्रमुख विशेषताएँ इस प्रकार हैं:
क्लस्टर मैनेजमेंट और स्केलिंग को ऑटोमेट करने से आप संचालन की जटिलता कम कर सकते हैं और डेटा प्रोसेसिंग व एनालिटिक्स पर ध्यान केंद्रित कर सकते हैं।
यदि आप Amazon EMR पर आगे बढ़ने से पहले Amazon S3 जैसी AWS स्टोरेज सेवाओं को बेहतर समझना चाहते हैं, तो इसे देखें AWS Storage Tutorial।
Amazon EMR क्लस्टर सेट अप करना
Amazon EMR क्लस्टर सेट अप करने के लिए, आपको EMR सेवा तक पहुँचना होगा, क्लस्टर बनाना होगा, और इसे अपने वर्कलोड के अनुरूप कॉन्फ़िगर करना होगा।
EMR क्लस्टर बनाना
शुरू करने के लिए, AWS Management Console में लॉग इन करें और EMR सेवा पर जाएँ।
आप यह AWS Management Console के सर्च पैनल में "EMR" खोजकर कर सकते हैं—जैसा कि नीचे दी गई छवि में दिखाया गया है।
वहाँ पहुँचने के बाद, “Create Cluster” पर क्लिक करें—जैसा कि नीचे दी गई छवि में दिखाया गया है।
नीचे दी गई छवि वर्तमान EMR इंटरफ़ेस का स्क्रीनशॉट देती है—समय के साथ यह विकसित हो सकता है, लेकिन मूल सेटिंग्स समान रहेंगी।
अपने Amazon EMR क्लस्टर को कॉन्फ़िगर करने के लिए, आपको कई सेटिंग्स को अपने विशिष्ट वर्कलोड आवश्यकताओं के अनुरूप समायोजित करना होगा। नीचे दिए गए निर्देशों का पालन करें:
01: एक बिग डेटा फ्रेमवर्क चुनें
EMR कई फ्रेमवर्क प्रदान करता है, जैसे इन-मेमाेरी प्रोसेसिंग के लिए Apache Spark, वितरित स्टोरेज और प्रोसेसिंग के लिए Hadoop, और इंटरैक्टिव SQL क्वेरी के लिए Presto।
अपने उपयोग के मामले के लिए सबसे उपयुक्त फ्रेमवर्क चुनें।
02: एक इंस्टेंस प्रकार चुनें
इंस्टेंस प्रकार प्रदर्शन और लागत को प्रभावित करता है। एक सामान्य विकल्प
m5.xlargeहै, क्योंकि यह कंप्यूटिंग पावर और किफ़ायत के बीच संतुलन प्रदान करता है।मेमोरी-इंटेंसिव वर्कलोड्स के लिए
r5.xlargeका उपयोग करें, जबकिc5.xlargeकंप्यूट-इंटेंसिव कार्यों के लिए बेहतर है।03: क्लस्टर नोड्स को कॉन्फ़िगर करें
EMR क्लस्टर्स तीन प्रकार के नोड्स से मिलकर बनते हैं:
04: सुरक्षा और एक्सेस कॉन्फ़िगर करें
SSH एक्सेस के लिए EC2 की-पेयर्स सेट अप करें और अनुमतियों को नियंत्रित करने के लिए IAM रोल्स कॉन्फ़िगर करें।
बेहतर सुरक्षा के लिए Kerberos प्रमाणीकरण या AWS Lake Formation सक्षम करना आपके लिए अच्छा विचार होगा।
05: नेटवर्किंग और स्टोरेज सेट अप करें
VPC सेटिंग्स परिभाषित करें, क्लस्टर आकार को डायनामिक रूप से समायोजित करने के लिए ऑटो-स्केलिंग सक्षम करें, और Amazon S3 को प्राथमिक स्टोरेज लोकेशन के रूप में निर्दिष्ट करें (
s3://your-bucket-name/)।06: क्लस्टर लॉन्च करें
कॉन्फ़िगरेशन की समीक्षा करने के बाद, लॉन्च करने के लिए "Create Cluster" पर क्लिक करें।
क्लस्टर के उपलब्ध होने से पहले इसे प्रारंभ होने में कुछ मिनट लगेंगे।
नीचे दी गई छवि उस इंटरफ़ेस को हाइलाइट करती है जहाँ आप क्लस्टर बना सकते हैं।
एप्लिकेशन और डिपेंडेंसीज़ कॉन्फ़िगर करना
क्लस्टर के चालू होने के बाद, आप प्री-इंस्टॉल्ड एप्लिकेशन का चयन करके और बूटस्ट्रैप एक्शन कॉन्फ़िगर करके इसे फाइन-ट्यून कर सकते हैं:
pip install pandas numpy)उचित कॉन्फ़िगरेशन यह सुनिश्चित करता है कि आपका EMR क्लस्टर अपने वर्कलोड के लिए पूरी तरह अनुकूलित हो, जिससे प्रोसेसिंग समय और संचालन लागत कम हो।
Amazon EMR के साथ काम करना
एक बार आपका EMR क्लस्टर सेट अप और कॉन्फ़िगर हो जाए, अगला कदम आपके डेटा के साथ काम शुरू करना है।
Amazon EMR पर डेटा अपलोड करना
Amazon EMR मुख्य रूप से इनपुट डेटासेट स्टोर करने और आउटपुट रिज़ल्ट सेव करने के लिए Amazon S3 पर निर्भर करता है।
HDFS, जो डेटा को क्लस्टर के भीतर स्टोर करता है, के विपरीत, S3 टिकाऊपन, स्केलेबिलिटी, और लागत-दक्षता प्रदान करता है, जो EMR में डेटा मैनेज करने के लिए इसे पसंदीदा विकल्प बनाता है।
Amazon S3 पर डेटा अपलोड करने के लिए, इन चरणों का पालन करें:
01: S3 कंसोल पर जाएँ
AWS Management Console में लॉग इन करें और Amazon S3 सेवा खोलें।
02: एक बकेट बनाएं या चुनें
किसी मौजूदा बकेट का चयन करें या नया बकेट बनाएं। लेटेंसी को न्यूनतम रखने के लिए सुनिश्चित करें कि बकेट आपके EMR क्लस्टर के समान रीजन में है।
नीचे दी गई छवि Amazon S3 बकेट बनाने की प्रक्रिया दिखाती है।
बकेट बनाते समय, याद रखें कि बकेट का नाम वैश्विक रूप से यूनिक होना चाहिए और AWS नामकरण नियमों का पालन करना चाहिए। सुनिश्चित करें कि आप ऐसा नाम चुनें जो आपके उपयोग के मामले को दर्शाता हो और इन आवश्यकताओं का पालन करता हो।
03: डेटा फ़ाइलें अपलोड करें
"Upload" पर क्लिक करें, आवश्यक फ़ाइलें चुनें, और एक्सेस अनुमतियाँ परिभाषित करें।
नीचे दी गई छवि उस इंटरफ़ेस को हाइलाइट करती है जहाँ आप Amazon S3 बकेट में फ़ाइलें अपलोड कर सकते हैं।
वैकल्पिक रूप से, आप प्रोग्रामेटिक रूप से फ़ाइलें अपलोड करने के लिए AWS CLI का उपयोग कर सकते हैं।
ऐसा करने से पहले, आपको यह सुनिश्चित करना होगा कि AWS CLI इंस्टॉल है और उपयुक्त प्रमाण-पत्रों के साथ कॉन्फ़िगर है, इसके लिए यह कमांड चलाएँ:
यह आपको अपने AWS Access Key ID, Secret Access Key, रीजन, और आउटपुट फॉर्मेट दर्ज करने के लिए प्रेरित करेगा ताकि आपका सत्र प्रमाणित हो सके। यदि AWS CLI पहले से कॉन्फ़िगर है, तो आप उपर्युक्त चरण को छोड़ सकते हैं।
एक बार कॉन्फ़िगर होने के बाद, आप निम्न कमांड का उपयोग करके फ़ाइलें अपलोड कर सकते हैं:
04: EMR से डेटा एक्सेस करें
अपलोड होने के बाद, डेटा को EMR से S3 पाथ का उपयोग करके एक्सेस किया जा सकता है:
s3://your-bucket-name/data/Spark, Hadoop, और Hive जैसे एप्लिकेशन फिर S3 से सीधे डेटा प्रोसेस कर सकते हैं।
वैकल्पिक डेटा स्टोरेज विकल्प
Spark या Hadoop जॉब्स चलाना
डेटा अपलोड करने के बाद, आप Apache Spark, Hadoop, या अन्य बिग डेटा फ्रेमवर्क्स का उपयोग करके इसे प्रोसेस कर सकते हैं।
EMR AWS CLI, EMR कंसोल, या सीधे SSH एक्सेस के माध्यम से जॉब निष्पादन की अनुमति देता है।
Spark जॉब चलाना
Spark जॉब सबमिट करने के लिए, क्लस्टर में SSH करें और spark-submit कमांड का उपयोग करें:
वैकल्पिक रूप से, आप AWS EMR के "Steps" फीचर के माध्यम से जॉब्स सबमिट कर सकते हैं—जो क्लस्टर को मैन्युअली एक्सेस किए बिना जॉब ऑटोमेशन की अनुमति देता है।
EMR पर Spark जॉब्स चलाने से पहले बुनियादी अवधारणाओं का पता लगाने के लिए, यह Big Data Fundamentals with PySpark कोर्स एक बेहतरीन शुरुआत है। यदि आपके वर्कफ़्लो में अस्त-व्यस्त डेटासेट तैयार करना शामिल है, तो आपको यह Cleaning Data with PySpark कोर्स विशेष रूप से उपयोगी लग सकता है।
Hadoop MapReduce जॉब चलाना
Hadoop जॉब्स के लिए, कमांड-लाइन इंटरफ़ेस का उपयोग करें:
Hadoop जॉब्स को वर्कफ़्लो ऑटोमेशन के लिए AWS Step Functions का उपयोग करके भी प्रबंधित किया जा सकता है।
बिग डेटा जॉब्स चलाते समय प्रभावी सुरक्षा और एक्सेस नियंत्रण महत्वपूर्ण हैं।
चूँकि Spark और Hadoop जॉब्स संवेदनशील डेटा के साथ इंटरैक्ट करते हैं, Amazon EMR सूक्ष्म-स्तरीय एक्सेस कंट्रोल और परमिशन्स लागू करने के लिए Apache Ranger के साथ इंटीग्रेट होता है।
नीचे दी गई छवि इस इंटीग्रेशन के एक उदाहरण आर्किटेक्चर को दर्शाती है, जो हाइलाइट करती है कि EMR क्लस्टर्स में सुरक्षा नीतियाँ कैसे लागू होती हैं।
क्लस्टर प्रदर्शन की निगरानी
कुशल प्रोसेसिंग सुनिश्चित करने के लिए, Amazon CloudWatch, Ganglia, और Spark UI का उपयोग करके अपने EMR क्लस्टर की निगरानी करें।
ये टूल्स संसाधन उपयोग, जॉब प्रगति, और संभावित बाधाओं के बारे में रीयल-टाइम इनसाइट्स प्रदान करते हैं।
प्रमुख मॉनिटरिंग टूल्स
प्रदर्शन अनुकूलन के सर्वोत्तम अभ्यास
spark.executor.memory), पैरेललिज़्म (spark.default.parallelism), और Hadoop ब्लॉक साइज को सर्वोत्तम प्रदर्शन के लिए समायोजित करें।इन चरणों का पालन करके आप बड़े डेटासेट्स को कुशलतापूर्वक प्रोसेस कर सकते हैं, जबकि अपने EMR क्लस्टर को लागत-प्रभावी और उच्च-प्रदर्शन वाला बनाए रख सकते हैं।