

Amazon EMR Kümelerini Ölçeklendirme
Veri işleme ihtiyaçlarınız geliştikçe, performansı ve maliyet verimliliğini korumak için EMR kümenizin kaynaklarını ayarlamanız gerekebilir.
EMR, iş yükü taleplerine göre örnek sayılarını değiştirmenize olanak tanıyan manuel ve otomatik ölçeklendirme seçenekleri sunar.
Buna ek olarak, Spot Instances kullanmak, ölçeklenebilirliği korurken maliyetleri optimize etmeye yardımcı olabilir.
Manuel ölçeklendirme
Manuel ölçeklendirme, gerçek zamanlı iş yükü taleplerine bağlı olarak kümenizdeki örnek sayısını artırmanıza veya azaltmanıza olanak tanır.
Bu ayarlama, EMR konsolu, AWS CLI veya EMR API üzerinden yapılabilir.
- EMR konsolunu kullanarak: Kümenize gidin, "Resize"ı seçin ve istenen örnek sayısını belirtin.
- AWS CLI’ı kullanarak: Küme boyutunu değiştirmek için aşağıdaki komutu çalıştırın:
aws emr modify-instance-groups --cluster-id <your-cluster-id> --instance-groups InstanceGroupId=<your-instance-group-id>,InstanceCount=<new-instance-count>- EMR API’ı kullanarak: Örnek sayısını dinamik olarak ayarlamak için
ModifyInstanceGroupsAPI’ını kullanabilirsiniz.
Manuel ölçeklendirme, kaynak ihtiyaçlarını önceden öngörebildiğiniz, öngörülebilir iş yükleri için en uygunudur.
Örneğin, veri işleme işimin sabit bir talebe sahip olacağını bildiğimde manuel ölçeklendirme kullandım; bu sayede beklenen iş yüküne göre örnek sayısını ayarlayarak kaynak kullanımını optimize ettim.
Amazon EMR’da otomatik ölçeklendirme
EMR’daki otomatik ölçeklendirme, iş yükü değişikliklerine yanıt olarak örnek sayısını dinamik olarak ayarlar; böylece kaynaklar verimli kullanılırken maliyetler kontrol altında tutulur.
Otomatik ölçeklendirme ilkeleri, CPU kullanımı, YARN bellek kullanımı veya görev kuyruğu uzunluğu gibi belirli metriklere göre ne zaman örnek ekleneceğini veya kaldırılacağını tanımlar.
Temel otomatik ölçeklendirme yapılandırmaları:
- Scale-out ilkesi: İş yükü arttığında zamanında işlemeyi sağlamak için örnek ekler.
- Scale-in ilkesi: Talep azaldığında örnekleri azaltır, gereksiz maliyetleri önler.
- Bekleme süreleri (cooldown): Kısa zaman aralıklarında aşırı ölçeklendirme eylemlerini önler.
Otomatik ölçeklendirmeyi etkinleştirmek için AWS Management Console, CLI veya API üzerinden bir Auto-Scaling Policy yapılandırın.
Bir otomatik ölçeklendirme ilkesini ayarlamak için örnek bir AWS CLI komutu şöyledir:
aws emr put-auto-scaling-policy --cluster-id <your-cluster-id> --instance-group-id <your-instance-group-id> --auto-scaling-policy file://policy.jsonOtomatik ölçeklendirme; akış analitiği, toplu işleme ve kaynak gereksinimleri dalgalanan makine öğrenimi görevleri gibi değişken iş yükleri için özellikle faydalıdır.
Örneğin, trafiği öngörülemeyen artışlar gösteren bir makine öğrenimi modeli çalıştırırken otomatik ölçeklendirme kullandım. Sistem, yoğun dönemlerde otomatik olarak ölçeklenip talep düştüğünde küçülerek hem maliyeti hem de performansı optimize etti.
Maliyet optimizasyonu için Spot örnekleri
Amazon EC2 Spot Instances, önemli ölçüde daha düşük oranlarla boşta olan EC2 kapasitesini kullanarak EMR kümelerini çalıştırmanın uygun maliyetli bir yolunu sağlar.
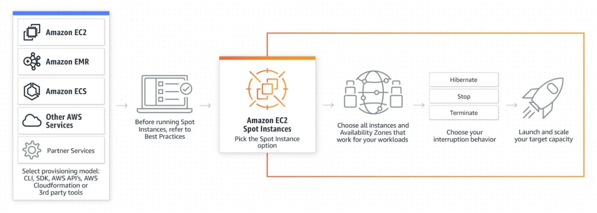
Bu örnekler, büyük veri işleme ve makine öğrenimi gibi hata toleranslı iş yükleri için idealdir.
EMR’da Spot Instances kullanmanın faydaları:
- Maliyet tasarrufu: Spot Instances, On-Demand örneklerden %90’a kadar daha ucuz olabilir.
- Ölçeklenebilirlik: Daha düşük maliyetle dinamik olarak daha fazla hesaplama gücü ekleyebilirsiniz.
- Hibrit örnek türleri: EMR, maliyet ile güvenilirliği dengelemek için Spot, On-Demand ve Reserved Instances karışımına izin verir.
Ancak AWS kapasiteyi geri alırsa Spot Instances kesintiye uğrayabilir. Bunu azaltmak için:
- Instance Groups yerine Instance Fleets kullanarak Spot ve On-Demand örneklerini dinamik olarak karıştırın.
- Olası kesintilerden kurtulmak için iş yüklerinde checkpointing uygulayın.
- Kararlılığı artırmak için birden çok Erişilebilirlik Bölgesi ve örnek türüne yayılmış çeşitlendirilmiş Spot İstekleri ayarlayın.
EMR’da Spot Instances yapılandırmak için şu AWS CLI komutunu kullanın:
aws emr create-cluster --instance-fleets file://instance-fleet-config.jsonManuel ölçeklendirme, otomatik ölçeklendirme ve Spot Instances’ı birleştirerek EMR kümelerinizi performans, maliyet verimliliği ve güvenilirlik için optimize edebilirsiniz.
Amazon EMR’da Güvenlik ve Erişim Kontrolü
EMR’da yanlış yapılandırılmış IAM rolleri, hassas verileri istenmeyen kullanıcılara açığa çıkarabilir. Bu nedenle her zaman asgari ayrıcalık ilkesini kullanmalı ve SSH erişimini yalnızca güvenilir IP’lerle sınırlamalısınız.
AWS, erişim kontrolü için IAM rolleri, veri koruması için şifreleme ve ortamınızı korumaya yönelik en iyi uygulamalar dahil olmak üzere sağlam güvenlik özellikleri sağlar.
IAM rolleri ve ilkeleri
AWS Identity and Access Management (IAM), EMR kümelerine ve ilgili kaynaklara erişimi kontrol eder.
Bir küme oluştururken, S3, DynamoDB ve diğer AWS hizmetleriyle etkileşime izin veren IAM rolleri atamalısınız.
Asgari ayrıcalık ilkelerini tanımlamak, erişimi yalnızca gerekli kaynaklarla sınırlayarak güvenliği sağlar.
Aşağıdaki görsel, yönetilen ilkeleri ve EMR ile nasıl kullanılabileceklerini göstermektedir.
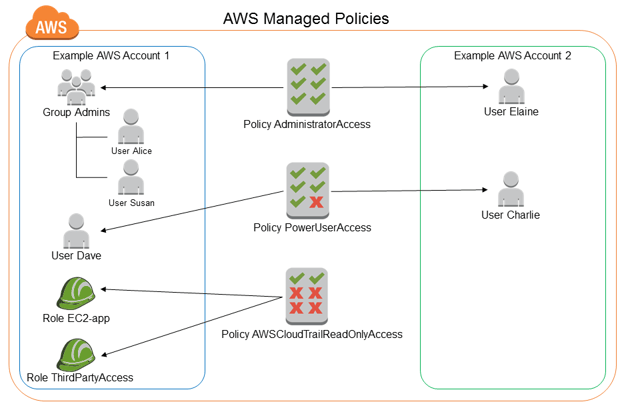
İzinlerin nasıl atandığını gösteren AWS IAM ilke ayarları ekran görüntüsü. Kaynak: AWS Dokümanları
Veri şifreleme ve güvenlik en iyi uygulamaları
Amazon EMR, beklemede veri için Amazon S3 sunucu tarafı şifreleme (SSE) veya AWS Key Management Service (KMS) ile şifrelemeyi destekler. Aktarım halindeki veri, SSL/TLS protokolleri kullanılarak güvence altına alınabilir.
En iyi güvenlik uygulamaları arasında AWS konsoluna erişim için çok faktörlü kimlik doğrulama (MFA) kullanmak, SSH erişimini kısıtlamak ve API anahtarlarını güvenli şekilde yönetmek yer alır.
AWS güvenliği hakkında daha fazla bilgi edinmek isterseniz, AWS Security and Cost Management kursuna göz atın.
Amazon EMR’da Sorun Giderme
Amazon EMR, ölçeklenebilirlik ve güvenilirlik için tasarlansa da, küme işletimi ve iş yürütme sırasında yine de sorunlar ortaya çıkabilir.
Yaygın zorluklar arasında performans darboğazları, iş hataları ve kaynak kısıtları bulunur. Bu sorunları nasıl teşhis edip çözeceğinizi anlamak, verimli bir iş akışı sürdürmenize yardımcı olur.
EMR kümelerinde yaygın sorunlar
Kullanıcılar sıklıkla yavaş iş yürütme, yetersiz bellek tahsisi, örnek hataları ve verimsiz veri karıştırma (shuffling) gibi sorunlarla karşılaşır.
Performans sorunları, yanlış örnek türlerinden, yetersiz sağlanmış kümelerden veya aşırı disk I/O’dan kaynaklanabilir. Bu sorunları ele almak için:
- İş parametrelerini optimize edin: Kaynak kullanımını dengelemek için yürütücü belleği, paralellik ve shuffle bölümleri gibi ayarları düzenleyin.
- Örnekleri uygun şekilde ölçekleyin: İş yükü taleplerine göre küme boyutunu dinamik olarak ayarlamak için otomatik ölçeklendirme ilkelerini kullanın.
- Günlükleri izleyin ve inceleyin: Darboğazları ve hata noktalarını belirlemek için Amazon CloudWatch, EMR konsolu veya doğrudan Amazon S3 üzerindeki günlükleri kullanın.
Spark ve Hadoop işlerini teşhis etme
Spark veya Hadoop işleri başarısız olduğunda, temel nedeni anlamak düzeltme için kritik öneme sahiptir.
Amazon S3’te tutulan veya EMR konsolu aracılığıyla erişilebilen günlükler, yürütme hataları, bellek sorunları ve görev yavaşlamaları hakkında değerli içgörüler sağlar.
- Spark history server’ı kullanın: Bu araç, performans darboğazlarını belirlemek için iş yürütme zaman çizelgelerini, shuffle işlemlerini ve görev dağılımını analiz etmeye yardımcı olur.
- Hadoop job tracker’dan yararlanın: MapReduce iş yükleri için Job Tracker ayrıntılı yürütme istatistikleri sağlar; uzun süren görevler veya veri yanlılığı gibi sorunların saptanmasına yardımcı olur.
- Dr. Elephant ve Sparklens ile performans ayarı yapın: Bu araçlar, geçmiş yürütme metriklerini analiz ederek Spark ve Hadoop iş yüklerini optimize etmeye yönelik öneriler sunar.
Aşağıdaki görsel, Amazon EMR üzerinde Hadoop ve Spark’ta Dr. Elephant ve Sparklens’in performans ayarı için nasıl kullanılabileceğini göstermektedir.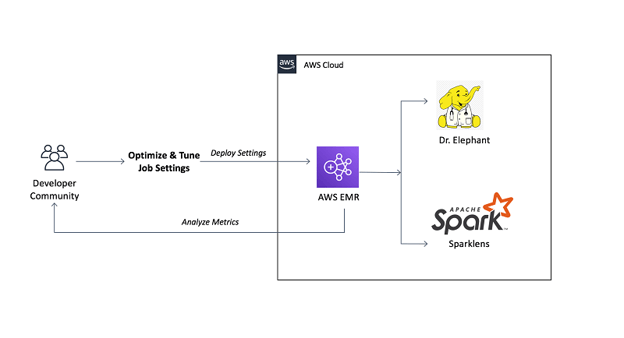
Amazon EMR üzerinde Hadoop ve Spark işleri için performans ayarı içgörülerini gösteren Dr. Elephant ve Sparklens arayüzü. Kaynak: AWS Blogları
Küme sağlığı ve kurtarma
Bir küme hatalar yaşarsa, sorunu hızla teşhis etmek, kesinti süresini en aza indirmeye ve veri kaybını önlemeye yardımcı olabilir.
Amazon CloudWatch ve AWS CloudTrail, temel sorunları belirlemeye yardımcı olabilecek izleme ve uyarı yetenekleri sunar.
- CloudWatch metriklerini kontrol edin: Kaynakların yetersiz mi yoksa aşırı mı kullanıldığını belirlemek için CPU kullanımı, bellek tüketimi ve disk I/O’ya bakın.
- Başarısız örnekleri yeniden başlatın: Bir örnek donanım veya yazılım sorunları nedeniyle başarısız olursa, onu yeniden başlatmak veya yeni bir örnekle değiştirmek küme kararlılığını geri getirebilir.
- Kaydedilmiş yapılandırmalardan yeni bir küme başlatın: Kritik hatalardan kurtulmak için Amazon EMR’ın klonlama özelliğini kullanarak aynı ayarlar ve bootstrap eylemleriyle yeni bir küme başlatabilirsiniz.
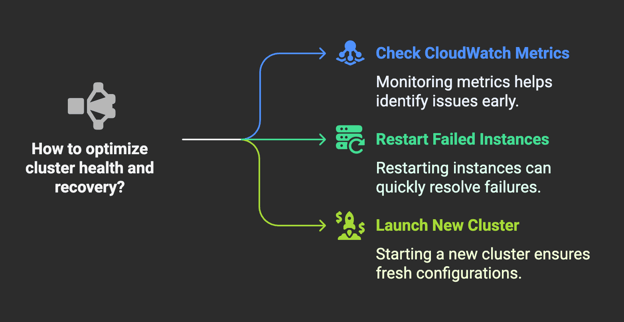 Amazon EMR’da küme sağlığı ve kurtarmayı optimize etme yollarını gösteren diyagram. Görsel Napkin AI ile oluşturulmuştur
Amazon EMR ile Maliyet Yönetimi
Amazon EMR üzerinde iş yükleri çalıştırırken maliyetleri etkin şekilde yönetmek kritik önem taşır. Fiyatlandırma; örnek türleri, depolama ve veri transferi gibi faktörlere bağlıdır; ancak harcamayı optimize etmek için stratejiler mevcuttur.
Fiyatlandırmayı anlama
Amazon EMR fiyatlandırması temel olarak birkaç ana faktöre dayanır: hesaplama örnekleri, depolama ve veri transferi.
- On-Demand örnekler, uzun vadeli taahhütler olmadan ihtiyaç duydukça kümeleri ölçeklendirmenizi sağlar. Ancak bu model, sürekli iş yükleri için pahalı olabilir.
- Spot Instances, kullanılmayan EC2 kapasitesi için çok daha düşük oranlarla teklif vermenize olanak tanıyarak uygun maliyetli bir alternatif sunar. Spot Instances önemli tasarruflar sağlayabilse de, kullanılabilirlik ve olası kesintilere tabidir.
Maliyetleri doğru tahmin etmek için AWS Pricing Calculator’ı kullanabilirsiniz; bu araç, küme yapılandırmalarını, örnek türlerini ve iş yükü taleplerini dikkate alır.
Bu fiyatlandırma yapılarını anlamanız, daha iyi tahmin ve bütçeleme sağlar; böylece kaynak tahsisini verimli hale getirir.
Ayrıca, öngörülebilir iş yükleri için AWS Savings Plans veya Reserved Instances’tan yararlanmak daha düşük oranlar sağlayarak toplam maliyetleri azaltabilir.
Maliyet optimizasyonu stratejileri
Maliyetleri optimize etmek için Amazon EMR iş yükleri çalıştırırken birkaç en iyi uygulamayı hayata geçirmelisiniz:
- Otomatik ölçeklendirme: İş yükü talebine göre küme boyutunu dinamik olarak ayarlamak, herhangi bir anda yalnızca gerekli kaynakları kullanmanızı sağlar. Bu, aşırı provizyonu önler ve israfı azaltır.
- Doğru boyutlandırma: İş yüklerinize en uygun örnek türlerini seçmek, performansı artırırken maliyetleri en aza indirebilir. Örneğin, hesaplama açısından yoğun görevler için compute-optimized örnekler uygunken, bellek içi analitik için memory-optimized örnekler daha iyidir.
- Tasarruf için Spot örnekleri: Mümkün olduğunda Spot Instances kullanmak, hesaplama maliyetlerini önemli ölçüde düşürebilir. Kesintileri azaltmak için örnek sonlandırmalarını ve yeniden dengeleme stratejilerini kaldırabilecek hata toleranslı iş yükleri çalıştırmayı düşünün.
- Küme optimizasyonu: Doğru düğüm sayısını seçerek ve Hadoop veya Spark ayarlarını düzenleyerek kümeleri verimli şekilde yapılandırmak, aşırı harcama yapmadan performansı artırabilir.
- Boşta kümeleri sonlandırın: Küme etkinliğini izlemek ve etkin olmayan kümeleri kapatmak, gereksiz maliyetlerin oluşmasını engeller.
- Yönetilen hizmetlerden yararlanma: Belirli ETL görevlerini AWS Glue’a devretmek, aynı süreçleri Amazon EMR üzerinde çalıştırmaya kıyasla maliyet açısından etkili olabilir. AWS Glue, iş yükü gereksinimlerine göre otomatik olarak ölçeklenebilen sunucusuz bir hizmettir; bu sayede atıl hesaplama kaynaklarını yönetme ve bunlar için ödeme yapma ihtiyacını ortadan kaldırır.
Bu maliyet optimizasyonu stratejilerini uygulamak, performans ile maliyet verimliliği arasında denge kurmanıza yardımcı olacaktır.
AWS bulut maliyeti yönetimine daha geniş bir bakış için AWS Cloud Technology and Services’a göz atın.
Sonuç
Amazon EMR ile çalıştıktan sonra, küme yönetimini, ölçeklendirmeyi ve AWS hizmet entegrasyonunu otomatikleştirerek büyük veri işlemeyi nasıl basitleştirdiğini takdir etmeye başladım. İster yeni başlıyor olun ister mevcut bir hattı optimize ediyor olun, büyük ölçekli veri iş yükleriyle uğraşan herkes için vazgeçilmezdir.
Bulut tabanlı büyük veri çözümlerini araştırıyorsanız, EMR güçlü ve ölçeklenebilir bir seçenek olarak değerlendirmeye değerdir!




Terabaytlarca müşteri işlem verisini yönettiğinizi ve mevcut sisteminizin bu baskı altında zorlandığını hayal edin.
Talep üzerine ölçeklenen, maliyetleri optimize eden ve mevcut AWS kurulumunuzla entegre olan bir çözüme ihtiyacınız var. Amazon Elastic MapReduce (EMR) bu konuda yardımcı olabilir. Büyük veriyle çalışmaya ilk başladığımda ben de aynı zorlukla karşılaştım—ta ki EMR’ı keşfedene kadar.
Bu rehberde, bir EMR kümesini kurmaktan iş yükleri çalıştırmaya, performansı optimize etmeye, güvenliği sağlamaya, sorun gidermeye ve maliyetleri yönetmeye kadar her şeyi ele alacağız.
Amazon EMR nedir?
Amazon EMR, açık kaynaklı çerçevelerin sağlanmasını, ölçeklendirilmesini ve yapılandırılmasını otomatikleştirerek büyük veri işlemesini basitleştiren, tamamen yönetilen küme tabanlı bir hizmettir.
Şirket içi kümeleri manuel olarak yönetme zahmeti olmadan, yapılandırılmış ve yapılandırılmamış büyük miktarda veriyi analiz etmenizi sağlar.
Aşağıdaki görsel, Amazon EMR on EKS’in diğer AWS hizmetleriyle nasıl çalıştığını göstererek entegrasyonunu ve iş akışını görselleştirir.
Amazon EMR’nin Amazon EKS ve diğer AWS hizmetleriyle büyük veri işleme için nasıl entegre olduğunu gösteren bir diyagram. Kaynak: AWS Dokümanları
AWS’ye yeniyseniz, temel bilgi oluşturmak için şu Introduction to AWS kursuna göz atmanızı öneririm.
Amazon EMR’ın bazı temel özellikleri şunlardır:
Küme yönetimini ve ölçeklendirmeyi otomatikleştirmek, operasyonel karmaşıklığı azaltmanıza ve veri işleme ile analitiğe odaklanmanıza olanak tanır.
Amazon EMR’a geçmeden önce Amazon S3 gibi AWS depolama hizmetlerini daha iyi anlamak isterseniz, şu AWS Storage Eğitimine göz atın.
Amazon EMR Kümesi Kurma
Bir Amazon EMR kümesi kurmak için EMR hizmetine erişmeniz, kümeyi oluşturmanız ve iş yükünüze uygun şekilde yapılandırmanız gerekir.
EMR kümesi oluşturma
Başlamak için AWS Management Console’a giriş yapın ve EMR hizmetine gidin.
Bunu, AWS Management Console’un arama panelinde "EMR" araması yaparak gerçekleştirebilirsiniz — aşağıdaki görselde gösterildiği gibi.
Oraya ulaştığınızda, aşağıdaki görselde gösterildiği gibi “Create Cluster”a tıklayın.
Aşağıdaki görsel mevcut EMR arayüzünün bir ekran görüntüsünü sağlar — zamanla değişse de temel ayarlar benzer kalacaktır.
Amazon EMR kümenizi yapılandırmak için, iş yükünüzün özel gereksinimlerine uyacak şekilde birkaç ayarı yapmanız gerekir. Aşağıdaki yönergeleri izleyin:
01: Bir büyük veri çerçevesi seçin
EMR; bellek içi işlem için Apache Spark, dağıtık depolama ve işlem için Hadoop ve etkileşimli SQL sorguları için Presto gibi birden fazla çerçeve sunar.
Kullanım senaryonuza en uygun çerçeveyi seçin.
02: Bir örnek türü seçin
Örnek türü performansı ve maliyeti etkiler. Yaygın bir seçim, hesaplama gücü ile uygun maliyet arasında denge sunduğu için
m5.xlarge’dır.Bellek yoğun iş yükleri için
r5.xlarge, hesaplama yoğun görevler için isec5.xlargekullanın.03: Küme düğümlerini yapılandırın
EMR kümeleri üç tür düğümden oluşur:
04: Güvenlik ve erişimi yapılandırın
SSH erişimi için EC2 anahtar çiftleri kurun ve izinleri kontrol etmek için IAM rollerini yapılandırın.
Güvenliği artırmak için Kerberos kimlik doğrulamayı veya AWS Lake Formation’ı etkinleştirmeniz iyi olur.
05: Ağ ve depolamayı ayarlayın
VPC ayarlarını tanımlayın, küme boyutunu dinamik olarak ayarlamak için otomatik ölçeklendirmeyi etkinleştirin ve birincil depolama konumu olarak Amazon S3’ü belirtin (
s3://your-bucket-name/).06: Kümeyi başlatın
Yapılandırmayı gözden geçirdikten sonra, başlatmak için "Create Cluster"a tıklayın.
Kümenin kullanılabilir hale gelmesi için başlatma birkaç dakika sürecektir.
Aşağıdaki görsel, kümeyi oluşturabileceğiniz arayüzü vurgular.
Uygulamaları ve bağımlılıkları yapılandırma
Küme çalışır duruma geldikten sonra, önceden yüklenmiş uygulamaları seçerek ve bootstrap eylemlerini yapılandırarak ince ayar yapabilirsiniz:
pip install pandas numpy)Doğru yapılandırma, EMR kümenizin iş yükü için tam olarak optimize edilmesini sağlar, işlem süresini ve operasyonel maliyetleri düşürür.
Amazon EMR ile Çalışmak
EMR kümeniz kurulduktan ve yapılandırıldıktan sonra, sıradaki adım verilerinizle çalışmaya başlamaktır.
Verileri Amazon EMR’a yükleme
Amazon EMR, girdi veri kümelerini depolamak ve çıktı sonuçlarını kaydetmek için öncelikle Amazon S3’e dayanır.
Veriyi küme içinde depolayan HDFS’in aksine S3; dayanıklılık, ölçeklenebilirlik ve maliyet verimliliği sunar; bu da EMR’da veri yönetimi için tercih edilen seçenek olmasını sağlar.
Verileri Amazon S3’e yüklemek için şu adımları izleyin:
01: S3 konsoluna gidin
AWS Management Console’a giriş yapın ve Amazon S3 hizmetini açın.
02: Bir bucket oluşturun veya seçin
Mevcut bir bucket’ı seçin veya yeni bir tane oluşturun. Gecikmeyi en aza indirmek için bucket’ın EMR kümenizle aynı bölgede olduğundan emin olun.
Aşağıdaki görsel, bir Amazon S3 bucket’ı oluşturma sürecini göstermektedir.
Bir bucket oluştururken, bucket adının dünya çapında benzersiz olması ve AWS adlandırma kurallarına uyması gerektiğini unutmayın. Hem kullanım senaryonuzu yansıtan hem de bu gerekliliklere uyan bir ad seçtiğinizden emin olun.
03: Veri dosyalarını yükleyin
"Upload"a tıklayın, gerekli dosyaları seçin ve erişim izinlerini tanımlayın.
Aşağıdaki görsel, dosyaları bir Amazon S3 bucket’ına yükleyebileceğiniz arayüzü vurgular.
Alternatif olarak, dosyaları programatik olarak yüklemek için AWS CLI’ı kullanabilirsiniz.
Bunu yapmadan önce, AWS CLI’ın kurulu olduğundan ve aşağıdaki komutu çalıştırarak uygun kimlik bilgileriyle yapılandırıldığından emin olmanız gerekir:
Bu işlem, oturumunuzu kimlik doğrulamak için AWS Access Key ID, Secret Access Key, bölge ve çıktı formatını girmenizi ister. AWS CLI zaten yapılandırıldıysa yukarıdaki adımı atlayabilirsiniz.
Yapılandırıldıktan sonra, aşağıdaki komutu kullanarak dosyaları yükleyebilirsiniz:
04: EMR’dan veriye erişin
Yükleme tamamlandıktan sonra verilere S3 yolu kullanılarak EMR’dan erişilebilir:
s3://your-bucket-name/data/Spark, Hadoop ve Hive gibi uygulamalar daha sonra veriyi doğrudan S3 üzerinden işleyebilir.
Alternatif veri depolama seçenekleri
Spark veya Hadoop işleri çalıştırma
Verileri yükledikten sonra, Apache Spark, Hadoop veya diğer büyük veri çerçevelerini kullanarak işleyebilirsiniz.
EMR, işleri AWS CLI, EMR konsolu veya doğrudan SSH erişimiyle yürütmenize izin verir.
Spark işi çalıştırma
Bir Spark işini göndermek için kümeye SSH ile bağlanın ve spark-submit komutunu kullanın:
Alternatif olarak, işleri AWS EMR’ın "Steps" özelliği üzerinden gönderebilirsiniz — bu, kümeye manuel erişim olmadan iş otomasyonu sağlar.
EMR üzerinde Spark işleri çalıştırmadan önce temel kavramları keşfetmek için Big Data Fundamentals with PySpark kursu harika bir başlangıç noktası sunar. İş akışınızda dağınık veri kümelerini hazırlamak varsa, Cleaning Data with PySpark korsu özellikle faydalı olabilir.
Hadoop MapReduce işi çalıştırma
Hadoop işleri için komut satırı arayüzünü kullanın:
Hadoop işleri, iş akışlarını otomatikleştirmek için AWS Step Functions kullanılarak da yönetilebilir.
Büyük veri işleri çalıştırırken etkili güvenlik ve erişim kontrolü kritik öneme sahiptir.
Spark ve Hadoop işleri hassas verilerle etkileşime geçtiğinden, Amazon EMR, ayrıntılı erişim kontrolü ve izinleri uygulamak için Apache Ranger ile entegre olur.
Aşağıdaki görsel, bu entegrasyonun örnek mimarisini gösterir ve güvenlik ilkelerinin EMR kümeleri genelinde nasıl uygulandığını vurgular.
Küme performansını izleme
Verimli işlemeyi sağlamak için EMR kümenizi Amazon CloudWatch, Ganglia ve Spark UI kullanarak izleyin.
Bu araçlar, kaynak kullanımı, iş ilerlemesi ve olası darboğazlar hakkında gerçek zamanlı içgörüler sunar.
Temel izleme araçları
Performans optimizasyonu için en iyi uygulamalar
spark.executor.memory), paralellik (spark.default.parallelism) ve Hadoop blok boyutunu en iyi performans için düzenleyin.Bu adımları izleyerek büyük veri kümelerini verimli şekilde işlerken EMR kümenizi maliyet etkin ve yüksek performanslı tutabilirsiniz.