

扩展 Amazon EMR 集群
随着数据处理需求的增长,您可能需要调整 EMR 集群资源,以保持性能与成本效率。
EMR 提供手动与自动扩缩容两种方式,可根据工作负载动态修改实例数量。
此外,利用 Spot 实例还能在保障可扩展性的同时进一步优化成本。
手动扩缩容
手动扩缩容允许您根据实时工作负载增减集群实例数量。
您可以通过 EMR 控制台、AWS CLI 或 EMR API 进行调整。
- 使用 EMR 控制台: 进入您的集群,选择 “Resize”,并指定期望的实例数量。
- 使用 AWS CLI: 运行以下命令修改集群规模:
aws emr modify-instance-groups --cluster-id <your-cluster-id> --instance-groups InstanceGroupId=<your-instance-group-id>,InstanceCount=<new-instance-count>- 使用 EMR API: 可通过
ModifyInstanceGroupsAPI 动态调整实例数量。
手动扩缩容更适用于可预测的工作负载,您可以提前预估资源需求。
例如,当我知道某个数据处理作业的需求较为稳定时,会使用手动扩缩容,依据预期工作负载调整实例数量,确保资源使用最优化。
Amazon EMR 的自动扩缩容
EMR 的自动扩缩容会根据工作负载自动调整实例数量,以实现高效资源利用并控制成本。
自动扩缩容策略会基于特定指标(如 CPU 使用率、YARN 内存使用或任务队列长度)定义何时增减实例。
关键自动扩缩容配置:
- 扩容策略(Scale-out): 工作负载上升时增加实例,确保及时处理作业。
- 缩容策略(Scale-in): 需求下降时减少实例,避免不必要的成本。
- 冷却期(Cooldown): 防止在短时间内频繁扩缩容。
要启用自动扩缩容,可通过 AWS 管理控制台、CLI 或 API 配置 Auto-Scaling Policy。
以下是设置自动扩缩容策略的 AWS CLI 命令示例:
aws emr put-auto-scaling-policy --cluster-id <your-cluster-id> --instance-group-id <your-instance-group-id> --auto-scaling-policy file://policy.json自动扩缩容对波动型工作负载尤为有利,例如流式分析、批处理与资源需求不稳定的机器学习任务。
例如,我在运行流量峰谷不定的机器学习模型时使用了自动扩缩容。系统在高峰期自动扩容、在低谷期自动缩容,从而同时优化了成本与性能。
使用 Spot 实例进行成本优化
Amazon EC2 Spot 实例利用闲置的 EC2 容量,以显著更低的价格运行 EMR 集群。
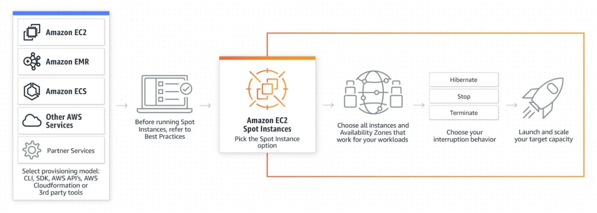
对于具备容错能力的工作负载(如大数据处理与机器学习),Spot 实例尤为理想。
在 EMR 中使用 Spot 实例的收益:
- 成本节省: Spot 实例最高可比按需实例便宜 90%。
- 可扩展性: 以更低成本动态增加计算能力。
- 混合实例类型: EMR 支持混合使用 Spot、按需与预留实例,以平衡成本与可靠性。
但需注意,若 AWS 回收容量,Spot 实例可能被中断。为降低风险:
- 使用 Instance Fleets 替代 Instance Groups,以便动态混用 Spot 与按需实例。
- 在工作负载中实现检查点(checkpointing),以便从中断中恢复。
- 在多个可用区与实例类型上分散 Spot 请求,提高稳定性。
在 EMR 中配置 Spot 实例,可使用以下 AWS CLI 命令:
aws emr create-cluster --instance-fleets file://instance-fleet-config.json结合手动扩缩容、自动扩缩容与 Spot 实例,您可以在性能、成本效率与可靠性之间取得最佳平衡。
Amazon EMR 的安全与访问控制
EMR 中配置不当的 IAM 角色可能会将敏感数据暴露给无关用户。因此,请始终遵循最小权限原则,并将 SSH 访问限制在可信任 IP 范围内。
AWS 提供强大的安全能力,包括用于访问控制的 IAM 角色、用于数据保护的加密机制,以及保护环境的最佳实践。
IAM 角色与策略
AWS 身份与访问管理(IAM)用于控制对 EMR 集群及相关资源的访问。
创建集群时,必须分配 IAM 角色,使其具备与 S3、DynamoDB 等 AWS 服务交互的权限。
定义最小权限策略,有助于将访问限制在必要资源范围内,确保安全。
下图展示了托管策略以及其在 EMR 中的使用方式。
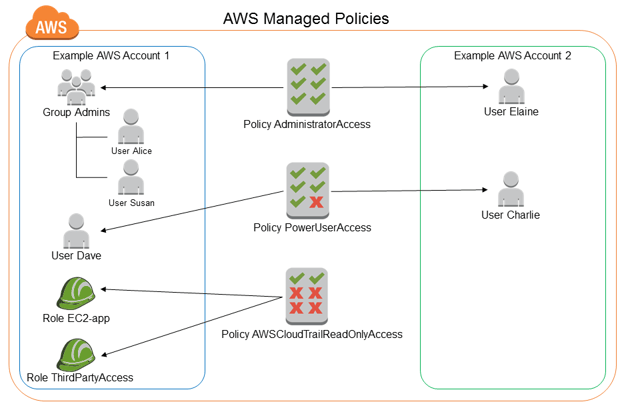
AWS IAM 策略设置截图,展示如何分配权限。来源:AWS 文档
数据加密与安全最佳实践
Amazon EMR 支持静态数据加密,可使用 Amazon S3 服务器端加密(SSE)或 AWS Key Management Service(KMS)。传输中的数据可使用 SSL/TLS 协议进行保护。
安全最佳实践包括:登录 AWS 控制台使用多重身份验证(MFA)、限制 SSH 访问,以及安全管理 API 密钥。
如需进一步了解 AWS 安全,请查看 AWS Security and Cost Management 课程。
排查 Amazon EMR 问题
尽管 Amazon EMR 旨在提供可扩展且可靠的服务,但在集群运行与作业执行过程中仍可能出现问题。
常见挑战包括性能瓶颈、作业失败与资源受限。掌握诊断与解决方法有助于维持高效工作流。
EMR 集群常见问题
常见问题包括作业执行缓慢、内存分配不足、实例故障与数据 Shuffle 效率低下。
性能问题可能源自实例类型选择不当、集群配置偏小或磁盘 I/O 过高。应对措施包括:
- 优化作业参数: 调整如执行器内存、并行度与 Shuffle 分区等设置,以平衡资源使用。
- 合理扩容实例: 使用自动扩缩容策略,根据工作负载动态调整集群规模。
- 监控与审阅日志: 利用 Amazon CloudWatch、EMR 控制台或直接在 Amazon S3 中分析日志,以定位瓶颈与故障点。
诊断 Spark 与 Hadoop 作业
当 Spark 或 Hadoop 作业失败时,找出根因至关重要。
Amazon S3 中保存的日志或 EMR 控制台中可访问的日志,能为执行失败、内存问题与任务变慢提供重要线索。
- 使用 Spark History Server: 用于分析作业执行时间线、Shuffle 操作与任务分布,以识别性能瓶颈。
- 利用 Hadoop Job Tracker: 对于 MapReduce 工作负载,Job Tracker 提供详细执行统计,有助于定位长耗时任务或数据倾斜等问题。
- 借助 Dr. Elephant 与 Sparklens 调优: 这些工具通过分析历史执行指标,为 Spark 与 Hadoop 工作负载提供优化建议。
下图展示了如何使用 Dr. Elephant 与 Sparklens 在 Amazon EMR 上调优 Hadoop 与 Spark 的性能。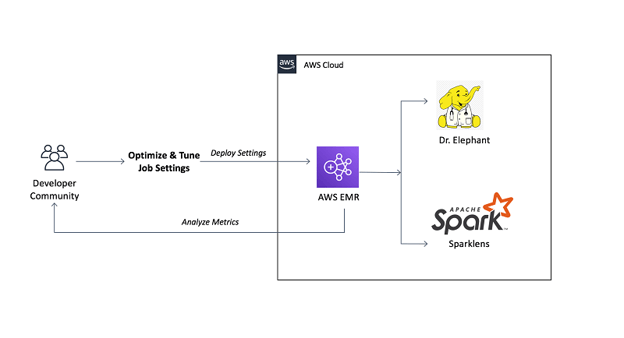
Dr. Elephant 与 Sparklens 界面展示了对 Amazon EMR 上 Hadoop 与 Spark 作业的性能调优洞察。来源:AWS 博客
集群健康与恢复
当集群发生故障时,快速定位问题能将停机时间与数据丢失降到最低。
Amazon CloudWatch 与 AWS CloudTrail 提供监控与告警功能,帮助识别潜在根因。
- 查看 CloudWatch 指标: 关注 CPU 利用率、内存消耗与磁盘 I/O,评估资源是否过度或不足使用。
- 重启故障实例: 若实例因软硬件问题失败,可重启或以新实例替换,以恢复集群稳定性。
- 基于保存的配置启动新集群: 遇到严重故障时,可使用 Amazon EMR 的克隆功能,基于相同设置与引导操作启动新集群。
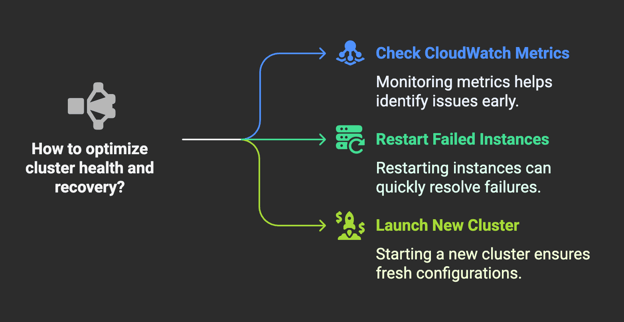 图示说明在 Amazon EMR 中优化集群健康与恢复的方法。图片由 Napkin AI 制作
Amazon EMR 的成本管理
在 Amazon EMR 上运行工作负载时,合理管理成本至关重要。定价受实例类型、存储与数据传输等因素影响,但有多种策略可优化支出。
理解定价
Amazon EMR 的定价主要基于几个关键因素:计算实例、存储与数据传输。
- 按需实例可按需扩展集群,灵活性高且无需长期承诺。但对于持续性工作负载,成本可能较高。
- Spot 实例通过竞价获取未使用的 EC2 容量,价格大幅降低。尽管能显著节省成本,但其受限于可用性且可能被中断。
要准确估算成本,您可以使用 AWS Pricing Calculator,它会综合考虑集群配置、实例类型与工作负载需求。
理解这些定价结构,有助于更好地进行预测与预算,从而实现高效的资源分配。
此外,对于可预测的工作负载,利用 AWS Savings Plans 或预留实例可锁定更低价格,降低总体成本。
成本优化策略
为优化成本,建议在运行 Amazon EMR 工作负载时实践以下最佳做法:
- 自动扩缩容: 根据工作负载动态调整集群规模,确保任一时刻只使用必要资源,避免过度预置与浪费。
- 正确选型(Right-sizing): 为工作负载匹配合适的实例类型,可在提升性能的同时降低成本。例如,计算优化型更适合重计算任务,而内存优化型更适合内存内分析。
- 使用 Spot 实例节省成本: 在可行场景下使用 Spot 实例可显著降低计算成本。为缓解中断风险,可运行具备容错性的工作负载,并采用再平衡策略。
- 集群优化: 通过选择合适的节点数量并调优 Hadoop 或 Spark 配置,在不额外支出的情况下提升性能。
- 终止空闲集群: 监控集群活动并关闭不活跃的集群,避免产生不必要费用。
- 利用托管服务: 将部分 ETL 任务迁移到 AWS Glue,可成为比在 Amazon EMR 上执行更具成本效益的替代方案。AWS Glue 是无服务器服务,可根据工作负载自动扩展,无需管理与为闲置计算资源付费。
落实这些成本优化策略,将帮助您在性能与成本效率间取得平衡。
如需更全面地了解 AWS 云成本管理,请查看 AWS Cloud Technology and Services。
结语
在使用 Amazon EMR 的过程中,我逐渐体会到它如何通过自动化集群管理、弹性扩缩容以及与 AWS 服务的集成来简化大数据处理。无论您是刚起步,还是在优化现有流水线,它都是处理大规模数据工作负载的关键工具。
如果您正在探索云端大数据解决方案,EMR 是值得考虑的强大且可扩展的选择!

想象一下,您要管理数万亿字节的客户交易数据,而现有系统正不堪重负。
您需要的是一种按需扩展、优化成本、并能与现有 AWS 环境集成的方案。Amazon Elastic MapReduce(EMR)可以满足这些需求。刚接触大数据时,我也遇到过同样的挑战——直到发现了 EMR。
在本指南中,我们将从搭建 EMR 集群到执行工作负载、优化性能、确保安全、排查问题以及管理成本,逐步讲解全部流程。
什么是 Amazon EMR?
Amazon EMR 是一项全托管的集群服务,通过自动化的资源预置、扩缩容与开源框架配置,简化大数据处理。
它让您无需手动管理本地集群,即可分析海量结构化与非结构化数据。
下图展示了 Amazon EMR on EKS 如何与其它 AWS 服务协同工作,帮助您直观理解其集成与工作流。
一张图示说明 Amazon EMR 如何与 Amazon EKS 以及其他 AWS 服务集成以进行大数据处理。来源:AWS 文档
如果您刚接触 AWS,建议先查看这门 Introduction to AWS 课程,打好基础。
Amazon EMR 的一些关键特性包括:
通过自动化集群管理与扩缩容,您可以降低运维复杂度,把精力集中在数据处理与分析上。
如果您在继续学习 Amazon EMR 之前想更好地了解如 Amazon S3 等 AWS 存储服务,可以查看这篇 AWS 存储教程。
创建 Amazon EMR 集群
要创建 Amazon EMR 集群,您需要进入 EMR 服务、创建集群并根据工作负载进行配置。
创建 EMR 集群
首先,登录 AWS 管理控制台并导航到 EMR 服务。
您可以在控制台的搜索栏中输入“EMR”——如下图所示。
进入后,点击“Create Cluster”(创建集群)——如下图所示。
下图展示了当前的 EMR 界面——尽管未来可能有所变化,但核心设置基本相同。
要配置 Amazon EMR 集群,您需要根据具体工作负载调整多项设置。请按以下步骤操作:
01:选择大数据框架
EMR 提供多种框架,例如用于内存计算的 Apache Spark、用于分布式存储与处理的 Hadoop,以及用于交互式 SQL 查询的 Presto。
选择最符合您用例的框架。
02:选择实例类型
实例类型会影响性能与成本。常见选择是
m5.xlarge,因其在算力与价格之间较为均衡。对于内存密集型工作负载,请使用
r5.xlarge;而c5.xlarge更适合计算密集型任务。03:配置集群节点
EMR 集群由三类节点组成:
04:配置安全与访问
设置 EC2 密钥对用于 SSH 访问,并配置 IAM 角色以控制权限。
建议启用 Kerberos 认证或 AWS Lake Formation,以强化安全性。
05:设置网络与存储
定义 VPC 设置,启用自动扩缩容以动态调整集群规模,并将 Amazon S3 指定为主存储位置(
s3://your-bucket-name/)。06:启动集群
核对配置后,点击“Create Cluster”进行启动。
集群需要几分钟初始化,随后即可使用。
下图标示了您创建集群的界面位置。
配置应用与依赖
集群运行后,您可以通过选择预装应用和配置引导操作(Bootstrap Actions)进行微调:
pip install pandas numpy)合理配置可确保 EMR 集群充分贴合其工作负载,从而缩短处理时间并降低运维成本。
使用 Amazon EMR 处理数据
当 EMR 集群搭建并配置完成后,下一步就是开始处理您的数据。
向 Amazon EMR 上传数据
Amazon EMR 主要依赖 Amazon S3 来存储输入数据集并保存输出结果。
不同于将数据存储在集群内的 HDFS,S3 具备高耐久性、可扩展性与成本优势,因此成为 EMR 管理数据的首选。
要将数据上传到 Amazon S3,请按以下步骤进行:
01:进入 S3 控制台
登录 AWS 管理控制台并打开 Amazon S3 服务。
02:创建或选择存储桶
选择现有存储桶或新建一个。请确保存储桶与您的 EMR 集群处于同一地区,以降低延迟。
下图展示了创建 Amazon S3 存储桶的流程。
创建存储桶时,请注意存储桶名称在全球范围内必须唯一,并符合 AWS 命名规范。请选择既能体现用例又满足规范的名称。
03:上传数据文件
点击“Upload”,选择所需文件,并设置访问权限。
下图标示了在 Amazon S3 存储桶中上传文件的界面。
或者,您也可以使用 AWS CLI 以编程方式上传文件。
在此之前,需确保已安装 AWS CLI,并通过运行以下命令配置好凭证:
系统将提示您输入 AWS Access Key ID、Secret Access Key、区域和输出格式,以完成会话认证。如果 AWS CLI 已配置,可跳过此步骤。
配置完成后,您可以使用以下命令上传文件:
04:从 EMR 访问数据
上传完成后,可通过 S3 路径在 EMR 中访问数据:
s3://your-bucket-name/data/随后,Spark、Hadoop、Hive 等应用即可直接从 S3 处理数据。
其他数据存储选项
运行 Spark 或 Hadoop 作业
数据上传后,您可以使用 Apache Spark、Hadoop 或其他大数据框架进行处理。
EMR 支持通过 AWS CLI、EMR 控制台或 SSH 直接访问来执行作业。
运行 Spark 作业
要提交 Spark 作业,先通过 SSH 登录集群,并使用 spark-submit 命令:
或者,您也可以通过 AWS EMR 的 “Steps” 功能提交作业——无需手动登录集群即可实现作业自动化。
在 EMR 上运行 Spark 作业前,如需先了解基础概念,可查看 Big Data Fundamentals with PySpark 课程作为入门。如果您的流程包含清洗杂乱数据集,不妨看看 Cleaning Data with PySpark 课程,可能会特别有帮助。
运行 Hadoop MapReduce 作业
对于 Hadoop 作业,请使用命令行界面:
您也可以使用 AWS Step Functions 管理 Hadoop 作业,实现工作流自动化。
在运行大数据作业时,安全与访问控制至关重要。
由于 Spark 与 Hadoop 作业会涉及敏感数据,Amazon EMR 与 Apache Ranger 集成,以实施细粒度的访问控制与权限管理。
下图展示了该集成的示例架构,说明安全策略如何在 EMR 集群间生效。
监控集群性能
为确保处理高效,请使用 Amazon CloudWatch、Ganglia 与 Spark UI 监控您的 EMR 集群。
这些工具可提供资源使用、作业进度与潜在瓶颈的实时洞察。
关键监控工具
性能优化最佳实践
spark.executor.memory)、并行度(spark.default.parallelism)及 Hadoop 块大小以获得最佳性能。按照上述步骤,您可以在保持成本可控与性能优异的前提下,高效处理海量数据集。