Association rule mining adalah teknik untuk mengungkap hubungan tersembunyi antar variabel dalam kumpulan data besar. Ini merupakan metode populer dalam penambangan data dan pembelajaran mesin, dengan beragam penerapan di berbagai bidang seperti analisis keranjang belanja, segmentasi pelanggan, dan deteksi penipuan.
Dalam artikel ini, kita akan membahas association rule mining di Python, termasuk kasus penggunaan, algoritme, dan implementasinya. Kita akan mulai dengan gambaran singkat tentang association rule mining dan penerapannya, kemudian membahas detail algoritme serta implementasinya di Python. Terakhir, kita akan menutup dengan rangkuman poin-poin penting yang dibahas.
Apa itu Association Rule Mining?
Association rule mining adalah teknik untuk mengidentifikasi pola dalam kumpulan data besar. Teknik ini mencakup pencarian hubungan antar variabel dalam data dan menggunakan hubungan tersebut untuk membuat prediksi atau keputusan. Tujuan association rule mining adalah menemukan aturan yang menggambarkan hubungan antar item berbeda dalam kumpulan data.
Sebagai contoh, pertimbangkan kumpulan data transaksi di sebuah toko kelontong. Association rule mining dapat digunakan untuk mengidentifikasi hubungan antar item yang sering dibeli bersamaan. Misalnya, aturan "Jika pelanggan membeli roti, mereka juga cenderung membeli susu" adalah association rule yang dapat digali dari kumpulan data tersebut. Aturan seperti ini dapat digunakan untuk mendukung keputusan terkait tata letak toko, penempatan produk, dan upaya pemasaran.
Association rule mining umumnya melibatkan penggunaan algoritme untuk menganalisis data dan mengidentifikasi hubungan. Algoritme ini bisa berbasis metode statistik atau teknik pembelajaran mesin. Aturan yang dihasilkan sering dinyatakan dalam bentuk pernyataan "jika-maka", di mana bagian "jika" mewakili anteseden (kondisi yang diuji) dan bagian "maka" mewakili konsekuen (hasil yang terjadi jika kondisi terpenuhi).
Association rule mining merupakan teknik penting dalam analisis data karena memungkinkan pengguna menemukan pola atau hubungan dalam data yang mungkin tidak langsung terlihat. Dengan mengidentifikasi asosiasi antar variabel, association rule mining dapat membantu pengguna memahami hubungan antar berbagai variabel dan bagaimana variabel-variabel tersebut saling terkait.
Hal ini bermanfaat untuk berbagai tujuan, seperti mengidentifikasi tren pasar, mendeteksi aktivitas penipuan, atau memahami perilaku pelanggan. Association rule mining juga dapat digunakan sebagai landasan untuk jenis analisis data lainnya, seperti memprediksi hasil atau mengidentifikasi penggerak utama suatu fenomena. Secara keseluruhan, association rule mining adalah alat yang berharga untuk mengekstrak wawasan dan memahami struktur dasar data.
Kasus Penggunaan Association Rule Mining:
Association rule mining umum digunakan dalam berbagai aplikasi, beberapa yang sering dijumpai adalah:
Analisis Keranjang Belanja
Salah satu penerapan association rule mining yang paling dikenal adalah dalam analisis keranjang belanja. Ini melibatkan analisis item yang dibeli pelanggan secara bersamaan untuk memahami kebiasaan dan preferensi pembelian mereka.
Misalnya, seorang peritel dapat menggunakan association rule mining untuk mengetahui bahwa pelanggan yang membeli popok juga cenderung membeli susu formula bayi. Informasi ini dapat digunakan untuk mengoptimalkan penempatan produk dan promosi guna meningkatkan penjualan.
Untuk mempelajari lebih lanjut tentang Analisis Keranjang Belanja, lihat tutorial Market Basket Analysis di R kami.
Segmentasi Pelanggan
Association rule mining juga dapat digunakan untuk mengelompokkan pelanggan berdasarkan kebiasaan pembeliannya.
Misalnya, sebuah perusahaan mungkin mengetahui melalui association rule mining bahwa pelanggan yang membeli jenis produk tertentu cenderung lebih muda. Demikian pula, mereka dapat mengetahui bahwa pelanggan yang membeli kombinasi produk tertentu lebih mungkin berada di wilayah geografis tertentu.
Informasi ini dapat digunakan untuk menyesuaikan kampanye pemasaran dan rekomendasi yang dipersonalisasi untuk segmen pelanggan tertentu. Pelajari lebih lanjut topik ini dalam tutorial pengantar segmentasi pelanggan di Python.
Deteksi Penipuan
Anda juga dapat menggunakan association rule mining untuk mendeteksi aktivitas penipuan. Misalnya, sebuah perusahaan kartu kredit dapat menggunakan association rule mining untuk mengidentifikasi pola transaksi penipuan, seperti banyak pembelian dari pedagang yang sama dalam waktu singkat.
Kemudian informasi ini dapat digunakan untuk menandai aktivitas yang berpotensi curang dan mengambil langkah pencegahan untuk melindungi pelanggan. Dalam blog kami Data Sciece in Banking: Fraud Detection, Anda dapat mempelajari lebih lanjut tentang cara kerjanya.
Analisis jejaring sosial
Berbagai perusahaan menggunakan association rule mining untuk mengidentifikasi pola dalam data media sosial yang dapat mendukung analisis jejaring sosial.
Misalnya, analisis data Twitter dapat mengungkap bahwa pengguna yang men-tweet tentang topik tertentu juga cenderung men-tweet tentang topik terkait lainnya, yang dapat membantu mengidentifikasi kelompok atau komunitas dalam jaringan.
Sistem rekomendasi
Association rule mining dapat digunakan untuk menyarankan item yang mungkin diminati pelanggan berdasarkan riwayat pembelian atau penelusurannya. Misalnya, layanan streaming musik dapat menggunakan association rule mining untuk merekomendasikan artis atau album baru kepada pengguna berdasarkan riwayat mendengarnya.
Dengan tutorial sistem rekomendasi di Python, Anda dapat mempelajari lebih lanjut cara membangun berbagai model yang menjalankan fungsi ini.
Algoritme Association Rule Mining
Ada beberapa algoritme yang digunakan untuk association rule mining. Beberapa yang umum adalah:
Algoritme Apriori
Algoritme Apriori adalah salah satu algoritme yang paling luas digunakan untuk association rule mining. Algoritme ini bekerja dengan terlebih dahulu mengidentifikasi himpunan item sering (frequent itemsets) dalam dataset (himpunan item yang muncul dalam sejumlah transaksi tertentu). Kemudian, himpunan item sering ini digunakan untuk menghasilkan association rule, yaitu pernyataan seperti "jika item A dibeli, maka item B juga kemungkinan besar dibeli." Algoritme Apriori menggunakan pendekatan bottom-up, dimulai dari item individual dan secara bertahap membangun ke himpunan item yang lebih kompleks.
Algoritme FP-Growth
Algoritme FP-Growth (Frequent Pattern Growth) adalah algoritme populer lainnya untuk association rule mining. Algoritme ini bekerja dengan membangun struktur seperti pohon yang disebut FP-tree, yang menyandikan himpunan item sering dalam dataset. FP-tree kemudian digunakan untuk menghasilkan association rule dengan cara yang mirip dengan algoritme Apriori. FP-Growth umumnya lebih cepat daripada Apriori, terutama untuk dataset besar.
Algoritme ECLAT
Algoritme ECLAT (Equivalence Class Clustering and bottom-up Lattice Traversal) adalah variasi dari Apriori yang menggunakan pendekatan top-down, bukan bottom-up. Algoritme ini bekerja dengan membagi item ke dalam kelas ekivalen berdasarkan support-nya (jumlah transaksi tempat item tersebut muncul). Association rule kemudian dihasilkan dengan mengombinasikan kelas ekivalen ini dalam struktur seperti kisi. Ini adalah versi Apriori yang lebih efisien dan dapat diskalakan.
Algoritme Apriori
Algoritme apriori telah menjadi salah satu algoritme yang paling luas digunakan untuk penambangan himpunan item sering dan pembelajaran association rule. Algoritme ini telah diterapkan pada berbagai aplikasi, termasuk analisis keranjang belanja, sistem rekomendasi, dan deteksi penipuan, serta menginspirasi pengembangan banyak algoritme lain untuk tugas serupa.
Detail Algoritme
Algoritme apriori dimulai dengan menetapkan ambang batas minimum support. Ini adalah jumlah minimum kemunculan suatu item dalam basis data agar dianggap sebagai himpunan item sering. Algoritme kemudian menyaring kandidat himpunan item yang tidak memenuhi ambang batas minimum support.
Selanjutnya, algoritme menghasilkan daftar semua kombinasi himpunan item sering dan menghitung berapa kali setiap kombinasi muncul dalam basis data. Lalu, algoritme menghasilkan daftar association rule berdasarkan kombinasi himpunan item sering tersebut.
Association rule adalah pernyataan berbentuk "jika item A ada dalam sebuah transaksi, maka item B juga kemungkinan ada". Kekuatan asosiasi diukur menggunakan confidence dari aturan tersebut, yaitu probabilitas bahwa item B ada dengan syarat item A ada.
Algoritme kemudian menyaring association rule yang tidak memenuhi ambang batas minimum confidence. Aturan-aturan ini disebut strong association rules. Terakhir, algoritme mengembalikan daftar strong association rules sebagai keluaran.
Apriori menggunakan pendekatan "bottom-up", dimulai dari item individual dan secara bertahap menggabungkannya menjadi himpunan item yang lebih besar saat mencari pola yang sering. Algoritme ini juga menggunakan pendekatan "hapus-beri label ulang" untuk memangkas ruang pencarian secara efisien dengan mengeliminasi himpunan item yang jarang dari pertimbangan.
Kelebihan:
- Apriori relatif sederhana dan mudah dipahami.
- Efektif mengidentifikasi pola sering dan association rule dalam dataset besar.
- Efisien dalam memangkas ruang pencarian dengan mengeliminasi himpunan item yang jarang, sehingga mengurangi kompleksitas komputasi algoritme.
- Telah banyak digunakan dan diuji di berbagai aplikasi, menjadikannya algoritme yang mapan dan andal.
Kekurangan:
- Apriori tidak cocok untuk dataset yang sangat besar, karena kompleksitas komputasi algoritme meningkat secara eksponensial seiring ukuran dataset.
- Mungkin kurang efektif mengidentifikasi pola pada dataset dengan banyak item langka atau transaksi yang jarang.
- Sensitif terhadap ambang batas minimum support dan minimum confidence, yang dapat memengaruhi kualitas hasil.
- Cenderung menghasilkan banyak association rule, yang dapat menyulitkan interpretasi hasil.
Untuk mempelajari lebih dalam tentang algoritme Apriori, lihat tutorial Market Basket Analysis yang luar biasa di DataCamp.
Metrik untuk Mengevaluasi Association Rule
Dalam association rule mining, terdapat beberapa metrik yang umum digunakan untuk mengevaluasi kualitas dan pentingnya association rule yang ditemukan.
Metrik-metrik ini dapat digunakan untuk menilai kualitas dan kepentingan association rule dan memilih aturan yang paling relevan untuk suatu aplikasi. Penting untuk dicatat bahwa pemilihan metrik yang tepat bergantung pada tujuan dan kebutuhan spesifik aplikasi.
Menginterpretasikan hasil metrik association rule mining memerlukan pemahaman makna dan implikasi tiap metrik, serta cara menggunakannya untuk mengevaluasi kualitas dan kepentingan association rule yang ditemukan. Berikut beberapa panduan untuk menginterpretasikan hasil metrik utama association rule mining:
Support
Support adalah ukuran seberapa sering suatu item atau himpunan item muncul dalam dataset. Dihitung sebagai jumlah transaksi yang memuat item tersebut dibagi jumlah total transaksi dalam dataset. Support tinggi menunjukkan bahwa suatu item atau himpunan item umum dalam dataset, sedangkan support rendah menunjukkan item tersebut jarang.
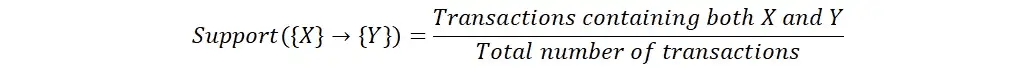
Confidence
Confidence adalah ukuran kekuatan asosiasi antara dua item. Dihitung sebagai jumlah transaksi yang memuat kedua item dibagi jumlah transaksi yang memuat item pertama. Confidence tinggi menunjukkan bahwa keberadaan item pertama merupakan prediktor kuat bagi keberadaan item kedua.
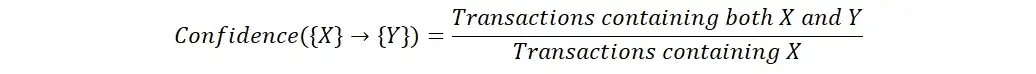
Lift
Lift adalah ukuran kekuatan asosiasi antara dua item dengan mempertimbangkan frekuensi keduanya dalam dataset. Dihitung sebagai confidence dari asosiasi dibagi support item kedua. Lift digunakan untuk membandingkan kekuatan asosiasi antara dua item dengan kekuatan yang diharapkan jika item-item tersebut independen.
Nilai lift lebih dari 1 menunjukkan bahwa asosiasi antara dua item lebih kuat daripada yang diharapkan berdasarkan frekuensi masing-masing item. Ini menyiratkan bahwa asosiasi tersebut mungkin bermakna dan layak ditelusuri lebih lanjut. Nilai lift kurang dari 1 menunjukkan bahwa asosiasi lebih lemah dari yang diharapkan dan mungkin kurang andal atau kurang signifikan.

Pustaka Python dan R untuk Association Rule Mining
Ada beberapa pustaka di R dan Python yang dapat digunakan untuk association rule mining:
Pustaka R
- arules: Paket untuk menambang association rule dan himpunan item sering di R. Menyediakan fungsi untuk membaca dan memanipulasi data transaksional, serta menghasilkan association rule dan mengevaluasi kualitasnya.
- arulesViz: Paket untuk memvisualisasikan association rule dan himpunan item sering di R. Menyediakan fungsi untuk membuat plot dan bagan guna membantu memahami dan menafsirkan hasil association rule mining.
- arulesSequences: Paket untuk menambang association rule dari data berurutan di R. Menyediakan fungsi untuk membaca dan memanipulasi data berurutan, serta menghasilkan association rule dan mengevaluasi kualitasnya.
Pustaka Python
- apyori: Pustaka untuk mengimplementasikan algoritme Apriori di Python. Menyediakan fungsi untuk membaca dan memanipulasi data transaksional, serta menghasilkan association rule dan mengevaluasi kualitasnya.
- mlxtend: Pustaka untuk mengimplementasikan berbagai algoritme dan alat pembelajaran mesin di Python, termasuk association rule mining. Menyediakan fungsi untuk membaca dan memanipulasi data transaksional, serta menghasilkan association rule dan mengevaluasi kualitasnya.
- PyCaret: PyCaret adalah pustaka pembelajaran mesin open-source berbasis low-code di Python untuk mengotomatisasi alur kerja pembelajaran mesin. Menyediakan pembungkus di atas mlxtend untuk implementasi algoritme Apriori yang mudah.
Mengimplementasikan Association Rules di Python
Kita akan menggunakan PyCaret untuk mengimplementasikan association rules di Python. Mari mulai dengan memasang PyCaret lalu mengimpor dataset contoh.
Pasang PyCaret
Anda dapat memasang pycaret menggunakan pip.
```

# install pycaret

pip install pycaret

```
Dataset
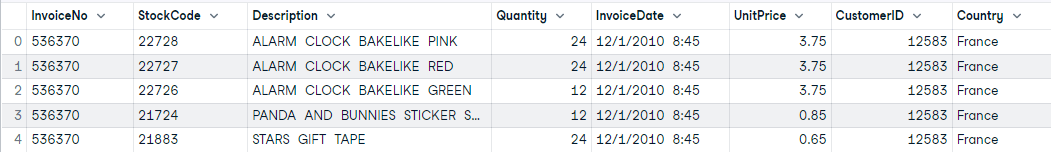
Kita akan mulai dengan memuat dataset contoh dari repositori pycaret. Ini adalah dataset transaksional dari salah satu toko ritel di Prancis. Dataset ini memiliki nomor faktur untuk mengidentifikasi transaksi dan deskripsi item. Hanya dua hal inilah yang kita perlukan saat menambang aturan dari dataset ini.
```

# load sample data

from pycaret.datasets import get_data

data = get_data('france')

```
Setup
Langkah pertama adalah mengimpor modul `arules` dan menginisialisasi fungsi `setup` dengan mendefinisikan data, transaction_id, dan item_id.
```

# init setup

from pycaret.arules import *

s = setup(data = data, transaction_id = 'InvoiceNo', item_id = 'Description')

```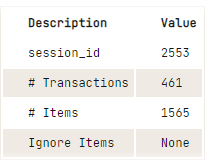
Keluaran dari fungsi setup
Buat Model
```

The `create_model` function runs the algorithm and return the rules in pandas DataFrame based on the selection parameters defined in the `create_model`. In this example we have used selection metric `confidence` with threshold and support of 0.5.

# train model

arules = create_model(metric='confidence', threshold=0.5, min_support=0.05)

```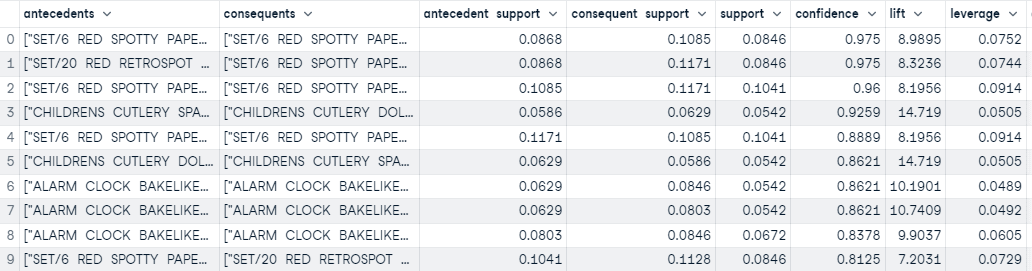
Keluaran dari fungsi create_model
Berdasarkan ambang batas yang didefinisikan dalam fungsi `create_model`, kita telah membuat 45 aturan. Keluaran di atas menampilkan 10 aturan pertama yang diurutkan berdasarkan confidence (tertinggi ke terendah).
Plot Rules
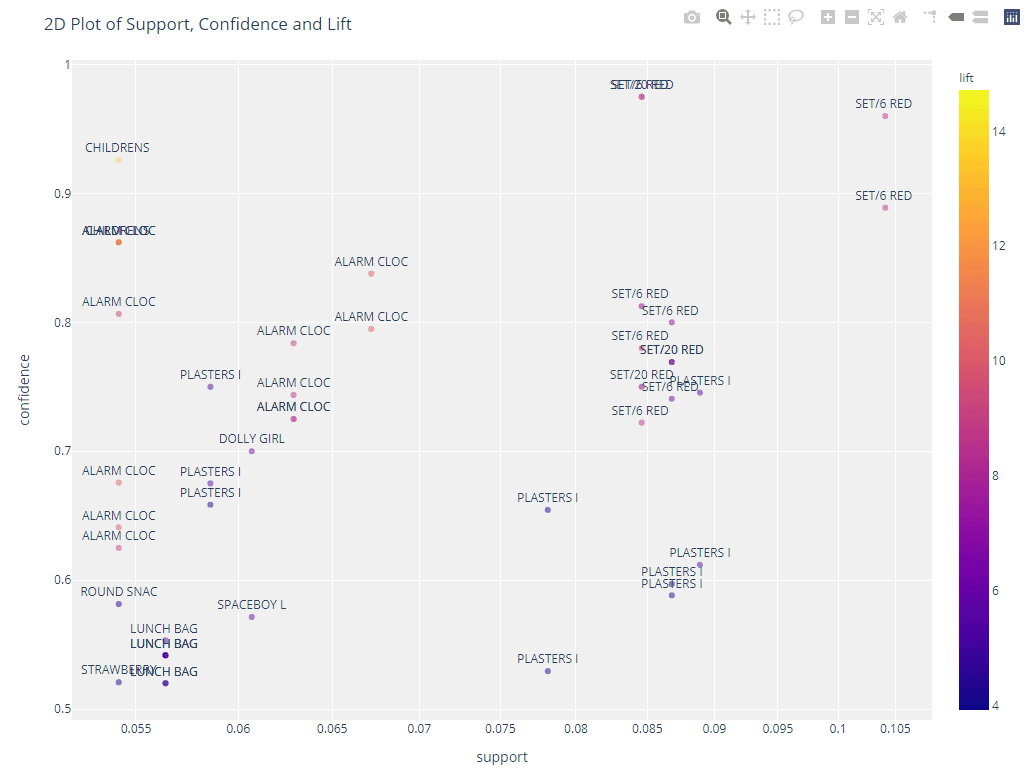
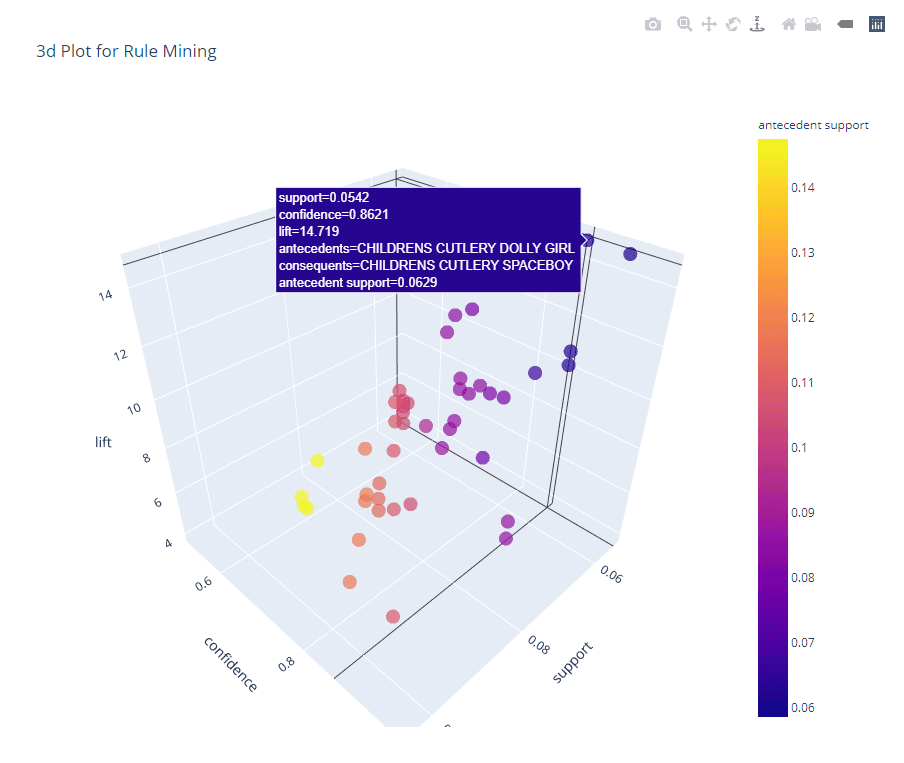
Visualisasikan dan analisis aturan menggunakan fungsi `plot_model` di PyCaret.
```

# 2d plot
plot_model(arules, plot = '2d')

```
```

# 3d plot

plot_model(arules, plot = '3d')

```
Lihat Notebook lengkap untuk mengikutinya.
Kesimpulan
Association rule mining adalah alat yang berharga untuk analisis data dan teknik yang kuat untuk menemukan pola serta hubungan dalam data. Di Python dan R, tersedia beberapa pustaka untuk mengimplementasikan association rule mining yang menyediakan implementasi siap pakai untuk berbagai algoritme serta opsi untuk memvisualisasikan hasilnya.
Anda dapat menggunakan association rule mining dalam berbagai konteks untuk mengekstrak wawasan dan memahami struktur dasar data. Namun, penting untuk memilih algoritme yang tepat dan menetapkan parameter yang sesuai, seperti ambang batas minimum support dan confidence, untuk memperoleh hasil yang bermakna dan akurat.
Jika Anda ingin mendalami topik ini dan mempelajari lebih lanjut tentang association rule mining, Anda dapat melihat kursus berikut:



