Kursus
Pengantar Data Science dengan Python
4 jam
503.1K
Di sektor Ritel, berbagai jaringan hipermarket menghasilkan jumlah data yang sangat besar. Data ini dihasilkan setiap hari di seluruh gerai. Basis data transaksi pelanggan yang luas ini perlu dianalisis untuk merancang strategi yang menguntungkan.
Setiap pelanggan memiliki kebutuhan yang berbeda-beda. Seiring bertambahnya basis pelanggan dan transaksi, tidak mudah memahami kebutuhan masing-masing pelanggan. Mengidentifikasi pelanggan potensial dapat meningkatkan kampanye pemasaran, yang pada akhirnya menaikkan penjualan. Segmentasi dapat berperan lebih baik dalam mengelompokkan pelanggan ke dalam berbagai segmen.
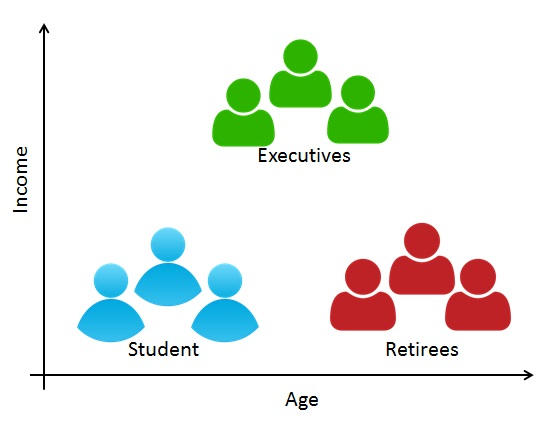
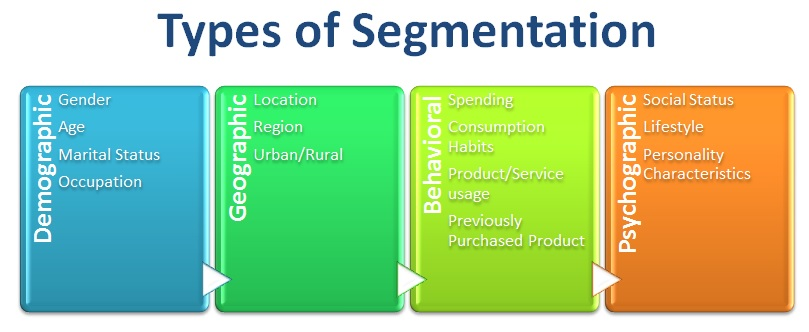
Segmentasi pelanggan adalah metode membagi pelanggan ke dalam kelompok atau klaster berdasarkan karakteristik yang sama. Peneliti pasar dapat membagi pelanggan dalam model B2C menggunakan berbagai karakteristik demografis pelanggan seperti pekerjaan, jenis kelamin, usia, lokasi, dan status pernikahan. Karakteristik psikografis seperti kelas sosial, gaya hidup, dan kepribadian serta karakteristik perilaku seperti pola belanja, kebiasaan konsumsi, penggunaan produk/layanan, dan produk yang pernah dibeli. Dalam model B2B menggunakan berbagai karakteristik perusahaan seperti ukuran perusahaan, jenis industri, dan lokasi.
Analisis RFM (Recency, Frequency, Monetary) adalah pendekatan berbasis perilaku untuk mengelompokkan pelanggan ke dalam segmen. Ini mengelompokkan pelanggan berdasarkan transaksi pembelian sebelumnya. Seberapa baru, seberapa sering, dan seberapa banyak pelanggan berbelanja. RFM menyaring pelanggan ke dalam berbagai kelompok untuk tujuan layanan yang lebih baik. Ini membantu manajer mengidentifikasi pelanggan potensial untuk bisnis yang lebih menguntungkan. Ada segmen pelanggan yang pemboros besar, tetapi bagaimana jika mereka hanya membeli sekali atau seberapa baru mereka membeli? Apakah mereka sering membeli produk kita? Selain itu, ini membantu manajer menjalankan kampanye promosi yang efektif untuk layanan yang dipersonalisasi.
Di sini, masing-masing dari tiga variabel (Recency, Frequency, dan Monetary) terdiri dari empat kelompok yang sama besar, yang menghasilkan 64 (4x4x4) segmen pelanggan berbeda.
Langkah-langkah RFM (Recency, Frequency, Monetary):
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Mari kita muat terlebih dahulu dataset HR yang diperlukan menggunakan fungsi read CSV dari pandas. Anda dapat mengunduh datanya dari tautan ini.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
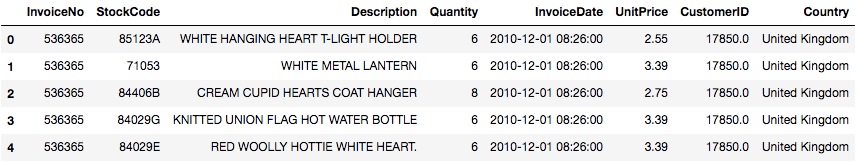
data.tail()
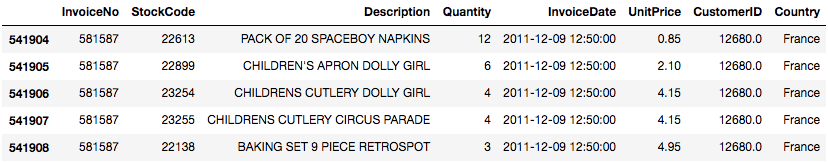
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
Terkadang Anda mendapatkan dataset yang berantakan. Anda mungkin harus menangani duplikasi, yang akan mengacaukan analisis. Dalam python, pandas menyediakan fungsi drop_duplicates(), yang menghapus catatan yang berulang atau duplikat.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
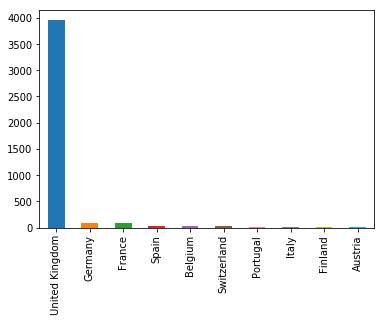
Pada dataset yang diberikan, Anda dapat melihat sebagian besar pelanggan berasal dari "United Kingdom". Jadi, Anda dapat memfilter data untuk pelanggan United Kingdom.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
Fungsi describe() di pandas memudahkan untuk mendapatkan berbagai statistik ringkas. Fungsi ini mengembalikan jumlah, rata-rata, simpangan baku, nilai minimum dan maksimum, serta kuantil data.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Di sini, Anda dapat melihat sebagian pelanggan memesan dengan kuantitas negatif, yang tidak mungkin. Jadi, Anda perlu memfilter Quantity yang lebih besar dari nol.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Di sini, Anda dapat menyaring kolom yang diperlukan untuk analisis RFM. Anda hanya membutuhkan lima kolom: CustomerID, InvoiceDate, InvoiceNo, Quantity, dan UnitPrice. CustomerID akan mendefinisikan pelanggan secara unik, InvoiceDate membantu Anda menghitung recency pembelian, InvoiceNo membantu Anda menghitung berapa kali transaksi dilakukan (frekuensi). Quantity yang dibeli di setiap transaksi dan UnitPrice dari setiap unit yang dibeli pelanggan akan membantu Anda menghitung total nilai pembelian.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Di sini, Anda akan melakukan operasi berikut:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
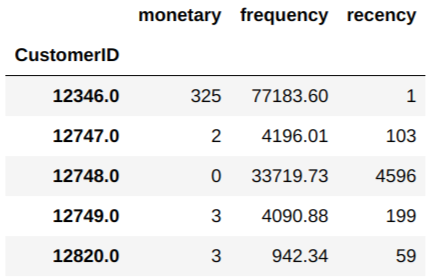
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
Pelanggan dengan recency terendah, serta frequency dan monetary tertinggi dianggap sebagai pelanggan teratas.
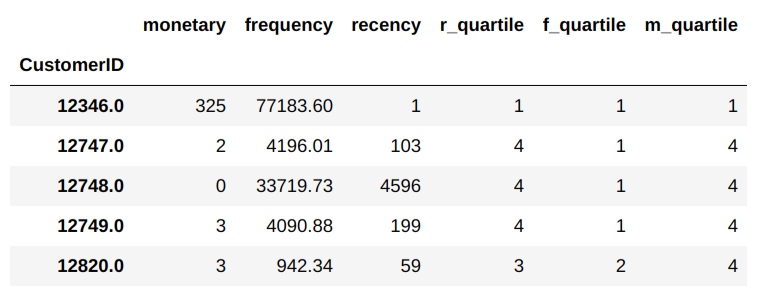
qcut() adalah fungsi diskretisasi berbasis kuantil. qcut membagi data berdasarkan kuantil sampel. Misalnya, 1000 nilai untuk 4 kuantil akan menghasilkan objek kategorikal yang menunjukkan keanggotaan kuantil untuk setiap pelanggan.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
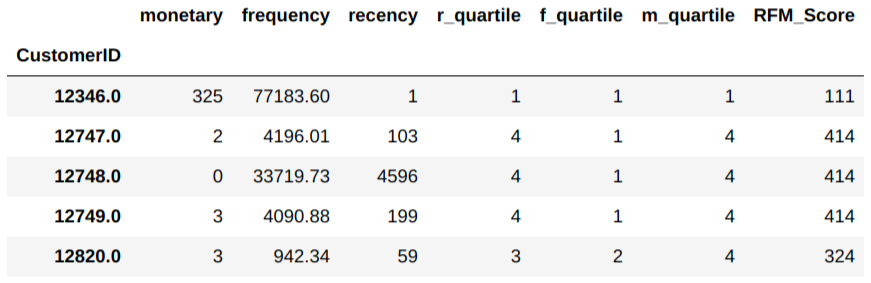
Gabungkan ketiga kuartil (r_quartile, f_quartile, m_quartile) dalam satu kolom; peringkat ini akan membantu Anda mensegmentasi pelanggan dengan baik.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
Selamat, Anda telah sampai di akhir tutorial ini!
Dalam tutorial ini, Anda telah membahas banyak detail tentang Segmentasi Pelanggan. Anda telah mempelajari apa itu segmentasi pelanggan, kebutuhan akan Segmentasi Pelanggan, jenis-jenis Segmentasi, analisis RFM, implementasi RFM dari nol di python. Anda juga membahas beberapa konsep dasar pandas seperti menangani duplikasi, groupby, dan qcut() untuk bin berdasarkan kuantil sampel.
Semoga sekarang Anda dapat memanfaatkan pemodelan topik untuk menganalisis dataset Anda sendiri. Terima kasih telah membaca tutorial ini!
Jika Anda ingin mempelajari lebih lanjut tentang Python, ikuti kursus gratis DataCamp Intro to Python for Data Science.
Pelajari lebih lanjut tentang Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



