

Apa itu Data Sintetis?
Data sintetis adalah data yang dihasilkan komputer yang mirip dengan data dunia nyata. Tujuan utama data sintetis adalah untuk meningkatkan privasi dan integritas sistem. Misalnya, untuk melindungi Personally Identifiable Information (PII) atau Personal Health Information (PHI) para pengguna, perusahaan harus menerapkan strategi perlindungan data. Menggunakan data sintetis dapat membantu perusahaan menguji aplikasi baru dan melindungi privasi pengguna.
Dalam kasus pembelajaran mesin, kita menggunakan data sintetis untuk meningkatkan kinerja model. Ini juga berlaku untuk situasi ketika data langka dan tidak seimbang. Penggunaan umum data sintetis dalam pembelajaran mesin adalah kendaraan otonom, keamanan, robotika, perlindungan penipuan, dan layanan kesehatan.
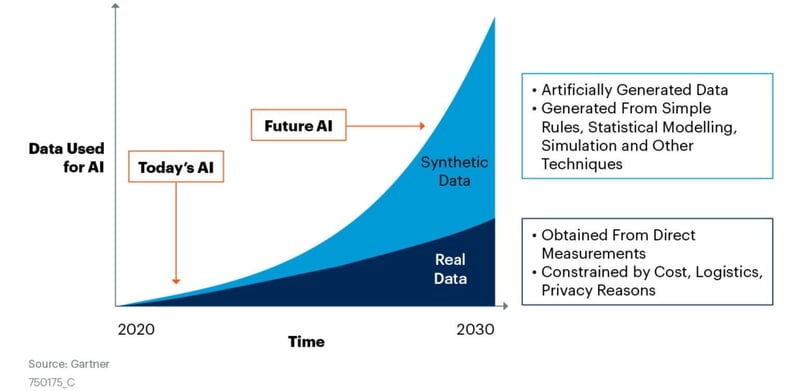
Gambar dari Nvidia
Menurut data dari Gartner, pada tahun 2024, 60% data yang digunakan untuk mengembangkan aplikasi pembelajaran mesin dan analitik akan dihasilkan secara sintetis. Lalu mengapa kita melihat tren peningkatan data sintetis?
Mengumpulkan dan membersihkan data dunia nyata itu mahal, dan dalam beberapa kasus, langka. Misalnya, data penipuan bank, kanker payudara, mobil tanpa pengemudi, dan serangan malware sulit ditemukan di dunia nyata. Kalaupun Anda mendapatkan datanya, akan butuh waktu dan sumber daya untuk membersihkannya dan memprosesnya untuk tugas-tugas pembelajaran mesin.
Pada bagian pertama tutorial, kita akan mempelajari mengapa kita membutuhkan data sintetis, penerapannya, dan cara menghasilkannya. Pada bagian akhir, kita akan menelusuri pustaka Python Faker dan menggunakannya untuk membuat data sintetis guna pengujian dan menjaga privasi pengguna.
Mengapa Kita Perlu Menghasilkan Data Sintetis?
Gambar oleh Penulis
Kita membutuhkan data sintetis untuk privasi pengguna, pengujian aplikasi, meningkatkan kinerja model, merepresentasikan kasus langka, dan mengurangi biaya operasional.
- Privasi: untuk melindungi data pengguna. Anda dapat mengganti nama, email, dan alamat dengan data sintetis. Ini akan membantu kita menghindari serangan siber dan black-box di mana model menyimpulkan detail data pelatihan.
- Pengujian: pengujian aplikasi pada data dunia nyata itu mahal. Menguji basis data, UI, dan aplikasi AI pada data sintetis lebih hemat biaya dan aman.
- Kinerja Model: data sintetis yang dihasilkan dapat meningkatkan kinerja model. Contoh: pada pengklasifikasi gambar, kita menggunakan shear, shift, dan rotasi gambar untuk menambah ukuran dataset dan meningkatkan akurasi model.
- Kasus Langka: kita tidak bisa menunggu kejadian langka terjadi dan mengumpulkan data dunia nyata. Contoh: deteksi penipuan kartu kredit, kecelakaan mobil, dan data kanker.
- Biaya: pengumpulan data memerlukan waktu dan sumber daya. Biaya untuk memperoleh data dunia nyata, membersihkan, memberi label, dan menyiapkannya untuk pengujian atau pelatihan model cukup tinggi.
Apa Saja Aplikasi Data Sintetis?
Pada bagian ini, kita akan mempelajari bagaimana perusahaan menggunakan data sintetis untuk membangun aplikasi yang hemat biaya, ramah privasi, dan berkinerja tinggi.
- Berbagi Data: data sintetis memungkinkan perusahaan berbagi data sensitif secara internal dan dengan pihak ketiga. Ini juga membantu memindahkan data pribadi ke cloud dan mempertahankan data untuk analitik.
- Layanan keuangan: data sintetis dihasilkan untuk meniru kejadian langka seperti transaksi penipuan, deteksi anomali, dan resesi ekonomi. Ini juga digunakan untuk memahami perilaku pelanggan menggunakan alat analitik.
- Quality Assurance: memelihara dan menguji kualitas aplikasi atau sistem data. Data sintetis dirender untuk menguji sistem pada anomali yang lebih jarang dan meningkatkan kinerja.
- Kesehatan: memungkinkan kita berbagi catatan medis secara internal dan eksternal sambil menjaga kerahasiaan pasien. Anda juga dapat menggunakannya untuk uji klinis dan mendeteksi penyakit langka. Pelajari cara memproses informasi sensitif dengan mengikuti kursus privasi data dan anonimisasi menggunakan Python atau R.
- Otomotif: sulit dan lambat mendapatkan data dunia nyata untuk robot, drone, dan mobil tanpa pengemudi. Perusahaan menguji dan melatih sistem mereka pada data simulasi sintetis serta menghemat biaya dalam membangun solusi tanpa mengorbankan kinerja.
- Pembelajaran Mesin: kita dapat menggunakan data sintetis untuk menambah ukuran dataset pelatihan, mengatasi masalah ketidakseimbangan data, dan menguji model untuk memastikan kinerja dan akurasi. Ini juga digunakan untuk mengurangi bias pada data gambar dan teks yang ada. Ini akan membantu kita menguji sistem dan menjaga privasi pengguna. Contohnya, DeepFake digunakan untuk menguji sistem pengenalan wajah.
Cara Menghasilkan Data Sintetis
Kita dapat menggunakan generator data palsu, alat statistik, jaringan saraf, dan generative adversarial networks untuk menghasilkan data sintetis.
Menghasilkan basis data palsu menggunakan pustaka Faker untuk menguji basis data dan sistem. Ini dapat menghasilkan profil pengguna palsu dengan alamat dan semua informasi penting. Anda juga dapat menggunakannya untuk menghasilkan teks dan paragraf acak. Ini membantu perusahaan melindungi privasi pengguna pada fase pengujian dan menghemat biaya perolehan dataset dunia nyata.
Memahami distribusi data untuk menghasilkan dataset yang benar-benar baru menggunakan alat statistik seperti Gaussian, Eksponensial, Chi-square, t, lognormal, dan Uniform. Anda harus memiliki pengetahuan domain untuk menghasilkan data sintetis berbasis distribusi.
Variational Autoencoder adalah metode pembelajaran tanpa pengawasan yang menggunakan encoder dan decoder untuk mengompresi dataset asli dan menghasilkan representasi dari dataset asli. Ini dirancang untuk mengoptimalkan korelasi antara dataset masukan dan keluaran.
Generative Adversarial Network adalah cara paling populer untuk menghasilkan data. Anda dapat menggunakannya untuk merender gambar sintetis, suara, data tabular, dan data simulasi. Ini menggunakan arsitektur model pembelajaran mendalam generator dan discriminator untuk menghasilkan data sintetis dengan membandingkan sampel acak dengan data aktual. Baca tutorial Demystifying Generative Adversarial Nets kami untuk membuat data sintetis Anda sendiri menggunakan Keras.
Apa itu Python Faker?
Python Faker adalah paket Python sumber terbuka yang digunakan untuk membuat dataset palsu untuk pengujian aplikasi, bootstrap basis data, dan menjaga anonimitas pengguna.
Gambar oleh Penulis
Anda dapat memasang Faker menggunakan:
pip install fakerFaker hadir dengan dukungan command line, fixture Pytest, lokalisasi (mendukung berbagai wilayah), reprodusibilitas, dan penyedia dinamis (menyesuaikan dengan kebutuhan Anda).
Anda juga dapat menggunakan fungsionalitas dasar Faker untuk membuat dataset cepat dan menyesuaikannya dengan kebutuhan Anda. Pada tabel di bawah, Anda dapat melihat berbagai fungsi Faker dan tujuannya.
|
Fungsi Faker |
Tujuan |
|
name() |
Menghasilkan nama lengkap palsu |
|
credit_card_full() |
Menghasilkan nomor kartu kredit dengan kedaluwarsa dan CVV |
|
email() |
Menghasilkan alamat email palsu |
|
url() |
Menghasilkan URL palsu |
|
phone_number() |
Menghasilkan nomor telepon palsu dengan kode negara |
|
address() |
Menghasilkan alamat lengkap palsu |
|
license_plate() |
Menghasilkan pelat nomor palsu |
|
currency() |
Menghasilkan tuple kode mata uang dan bentuk lengkapnya |
|
color_name() |
Menghasilkan nama warna acak |
|
local_latlng() |
Menghasilkan lintang, bujur, area, negara, dan negara bagian |
|
domain_name() |
Menghasilkan situs web palsu berdasarkan nama orang palsu |
|
text() |
Menghasilkan teks pendek palsu |
|
company() |
Menghasilkan nama perusahaan palsu |
Untuk mempelajari fungsi yang lebih lanjut, lihat dokumentasi Faker.
Penting untuk meninjau fungsi-fungsi ini karena kita akan menggunakannya untuk membuat berbagai contoh dan dataframe.
Generasi Data Sintetis dengan Python Faker
Pada bagian ini, kita akan menggunakan Python Faker untuk menghasilkan data sintetis. Terdiri dari 5 contoh tentang bagaimana Anda dapat menggunakan Faker untuk berbagai tugas. Tujuan utamanya adalah mengembangkan pendekatan berfokus privasi untuk pengujian sistem. Pada bagian terakhir, kita akan menghasilkan data palsu untuk melengkapi data asli menggunakan penyedia terlokalisasi Faker.
Anda dapat menemukan semua kode untuk tutorial ini di buku kerja DataLab ini; Anda dapat dengan mudah membuat salinan buku kerja Anda sendiri untuk menjalankan semua kode di peramban, tanpa memasang apa pun di komputer Anda.
Pertama, kita akan memulai generator palsu menggunakan `Faker()`. Secara bawaan, ini menggunakan locale “en_US”.
from faker import Faker
fake = Faker()Contoh 1
Objek “fake” dapat menghasilkan data dengan menggunakan nama properti. Misalnya, `fake.name()` digunakan untuk menghasilkan nama lengkap orang secara acak.
print(fake.name())
>>> Jessica RobinsonDemikian pula, kita dapat menghasilkan alamat email palsu, nama negara, teks, geolokasi, dan URL seperti di bawah ini.
print(fake.email())
print(fake.country())
print(fake.name())
print(fake.text())
print(fake.latitude(), fake.longitude())
print(fake.url())Keluaran
ybanks@example.com
Mayotte
Mr. Jose Browning DDS
Dog might bank dog total life financial. Dark view doctor time just.
Stay second treatment language theory. Space seek adult create matter imagine lay.
51.7514185 -148.802970
http://fischer.info/Contoh 2
Anda dapat menggunakan berbagai locale untuk menghasilkan data dalam beragam bahasa dan untuk wilayah berbeda.
Pada contoh di bawah, kita akan menghasilkan data dalam bahasa Spanyol dan wilayah Spanyol.
fake = Faker("es_ES")
print(fake.email())
print(fake.country())
print(fake.name())
print(fake.text())
print(fake.latitude(), fake.longitude())
print(fake.url())Keluaran
Seperti yang kita lihat, nama individu berubah, dan teksnya berbahasa Spanyol.
casandrahierro@example.com
Tonga
Juan Solera-Mancebo
Cumque adipisci eligendi aperiam. Quas laboriosam amet at dignissimos. Excepturi pariatur ipsam esse.
89.180798 -2.274117
https://corbacho-galan.net/Mari coba lagi dengan bahasa Jerman dan Jerman sebagai negara. Untuk menghasilkan profil pengguna lengkap, kita akan menggunakan fungsi `profile()`.
fake = Faker("de_DE")
fake.profile()Keluaran
Cukup jelas bagaimana kita dapat menggunakan Faker untuk menghasilkan data dalam berbagai bahasa untuk berbagai negara. Mengubah locale akan mengubah nama, pekerjaan, alamat, perusahaan, dan data identifikasi pengguna lainnya berdasarkan bahasa dan negara.
{'job': 'Erzieher',
'company': 'Stadelmann Thanel GmbH',
'ssn': '631-64-0521',
'residence': 'Leo-Schinke-Allee 298\n26224 Altötting',
'current_location': (Decimal('51.5788595'), Decimal('29.780659')),
'blood_group': 'B+',
'website': ['https://www.schmidtke.de/',
'https://roskoth.com/',
'http://www.textor.de/',
'https://www.zirme.com/'],
'username': 'vdoerr',
'name': 'Francesca Fröhlich',
'sex': 'F',
'address': 'Steinbergallee 13\n84765 Saarbrücken',
'mail': '[email protected]',
'birthdate': datetime.date(1998, 3, 19)}Contoh 3
Dalam contoh ini, kita akan membuat dataframe pandas menggunakan Faker.
- Buat dataframe pandas kosong (data)
- Jalankan melalui x jumlah loop untuk membuat banyak baris
- Gunakan `randint()` untuk menghasilkan id unik
- Gunakan Faker untuk membuat nama, alamat, dan geo-lokasi
- Jalankan fungsi `input_data()` dengan x=10
from random import randint
import pandas as pd
fake = Faker()
def input_data(x):
# pandas dataframe
data = pd.DataFrame()
for i in range(0, x):
data.loc[i,'id']= randint(1, 100)
data.loc[i,'name']= fake.name()
data.loc[i,'address']= fake.address()
data.loc[i,'latitude']= str(fake.latitude())
data.loc[i,'longitude']= str(fake.longitude())
return data
input_data(10)Keluaran terlihat bagus. Kita memiliki kolom id, name, address, latitude, dan longitude dengan data pengguna unik.
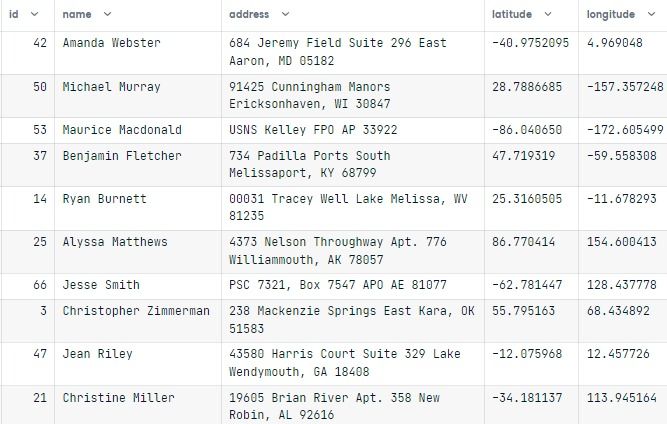
Untuk mereproduksi hasil, kita harus menetapkan seed. Jadi setiap kali kita menjalankan sel kode lagi, kita akan mendapatkan hasil serupa.
Faker.seed(2)
input_data(10)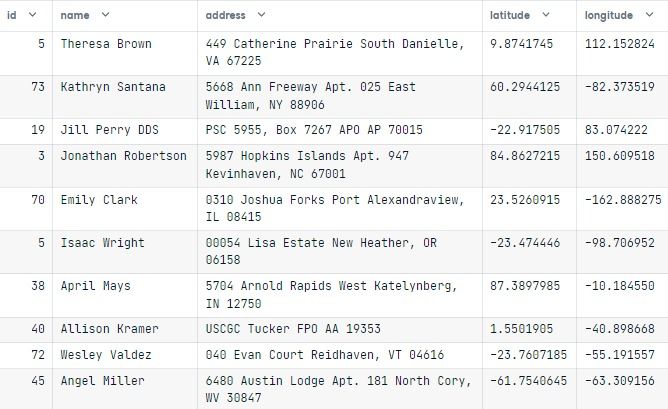
Contoh 4
Kita juga dapat menghasilkan sebuah kalimat yang berisi kata kunci pilihan kita. Mirip dengan `text(), texts(), paragraph(), word(), dan words()`. Anda dapat menambah jumlah kata dalam satu kalimat dengan menyetel argumen nb_words.
Pada contoh di bawah, kita menghasilkan lima kalimat menggunakan daftar kata. Ini tidak sempurna, tetapi dapat membantu kita menguji aplikasi yang membutuhkan banyak data teks.
word_list = ["DataCamp", "says", "great", "loves", "tutorial", "workplace"]
for i in range(0, 5):
print(fake.sentence(ext_word_list=word_list))Keluaran
Loves great says.
Says workplace workplace tutorial great loves.
Loves workplace workplace loves workplace loves great DataCamp.
Loves says workplace great.
Workplace great DataCamp.Mencampur data sintetis dan data nyata
Pada bagian ini, kita akan menggunakan Data E-Commerce dari repositori dataset DataCamp dan menambahkan data pengguna palsu menggunakan kolom CustomerID dan Country. Ini akan membantu kita menjaga privasi pengguna dan menguji sistem pada parameter tambahan.
Untuk memuat file CSV, kita akan menggunakan fungsi pandas `read_csv()` dan menampilkan lima baris teratas menggunakan `head()`
# Loading CSV file
Ecommerce = pd.read_csv("e-commerce.csv")
Ecommerce.head()Dataset terdiri dari kolom InvoiceNo, StockCode (ID produk), Description, Product (nama item), Quantity (per transaksi), InvoiceDate, UnitPrice (dalam Pound), CustomerID, dan Country.
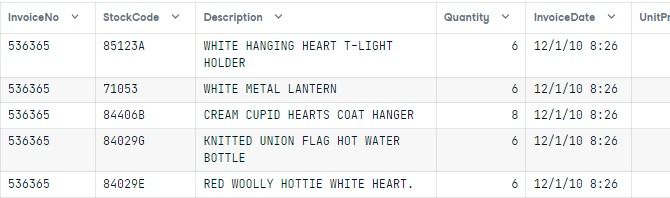
Untuk membuat objek faker terlokalisasi, kita akan menampilkan nama negara unik dan menggunakannya untuk membuat kamus. Seperti yang dapat kita amati, ada tujuh negara, dan kita akan membuat tujuh generator faker terlokalisasi pada bagian berikutnya.
Ecommerce.Country.dropna().unique()
>>> array(['United Kingdom', 'France', 'Australia', 'Netherlands', 'Germany',
'Norway', 'EIRE'], dtype=object)Dalam fungsi `anonymous`, kita telah:
- Mengekstrak id pelanggan unik dan menghapus nilai yang hilang
- Membuat kamus nama negara dan bentuk singkat locale
- Mengekstrak indeks baris dan nama negara untuk id pelanggan unik
- Menggunakan kamus dan nama negara untuk menginisialisasi generator faker terlokalisasi
- Menambahkan nama pelanggan, alamat, dan geo-lokasi ke dataframe yang ada.
Fungsi di bawah ini menggunakan dataframe dan menambahkan empat kolom baru dengan data pengguna berdasarkan kolom CustomerID dan Country.
def anonymous(df):
# Extracting unique CustomerID
unique_id = df.CustomerID.dropna().unique()
# Creating the dictionary for Faker localized providers
local = {
"United Kingdom": "en_GB",
"France": "fr_FR",
"Australia": "en_AU",
"Netherlands": "nl_NL",
"Germany": "de_DE",
"Norway": "no_NO",
"EIRE": "ga_IE",
}
for i in unique_id:
# Extracting row index
row_id = df[df["CustomerID"] == i].index
# Extracting country name for faker locale
CountryName = Ecommerce.loc[
Ecommerce["CustomerID"] == i, "Country"
].to_numpy()[0]
# Using locale dictionary to create faker locale generator
code = local[CountryName]
fake = Faker(code)
# Generating fake data and adding it to dataframe
CustomerName = fake.name()
Address = fake.address()
Latitude = str(fake.latitude())
Longitude = str(fake.longitude())
for x in row_id:
df.loc[x, "CustomerName"] = CustomerName
df.loc[x, "Address"] = Address
df.loc[x, "Latitude"] = Latitude
df.loc[x, "Longitude"] = Longitude
return dfKita akan menggunakan seed(5) untuk reprodusibilitas dan menjalankan fungsi `anonymous` pada dataframe Ecommerce.
# Using seed for reproducibility
Faker.seed(5)
secure_db = anonymous(Ecommerce)
secure_dbBeberapa hasil pertama menampilkan data untuk 17850, United Kingdom, dan Pamela Cox-James.
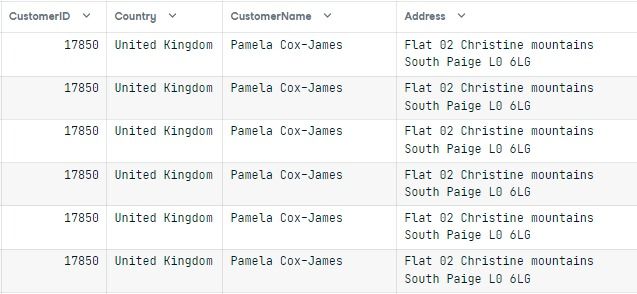
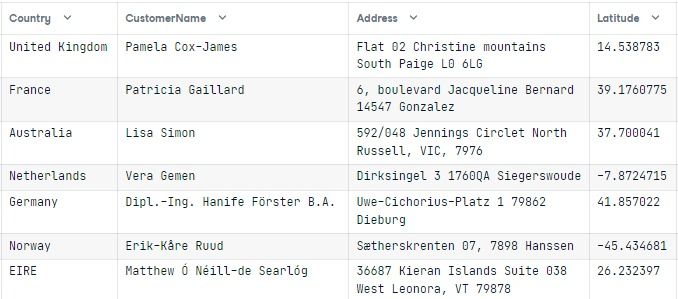
Untuk memvisualisasikan hasil terlokalisasi dari fungsi, kita perlu melihat data untuk kolom Country yang unik.
display_db = []
for i in Ecommerce.Country.dropna().unique():
display_db.append(secure_db[secure_db["Country"] == i].to_numpy()[0])
pd.DataFrame(display_db, columns=Ecommerce.columns)Hasilnya menjanjikan. Anda dapat melihat nama yang berbeda per wilayah dan bahasa. Alamatnya cocok dengan negara. Dengan metode ini, Anda dapat menghapus data identifikasi pribadi dan membuat data terlokalisasi menggunakan Faker untuk melindungi privasi pengguna dan menghemat biaya.
Sumber kode tersedia di buku kerja DataLab ini.
Kesimpulan
Salah satu kelemahan menggunakan Python Faker adalah kualitas datanya kurang baik. Ini dapat berfungsi untuk pengujian aplikasi, tetapi kurang akurat. Misalnya, nama tidak cocok dengan email, nama domain, atau nama pengguna.
Anda dapat menyesuaikan penyedia atau membuat yang baru sesuai preferensi Anda, tetapi Anda akan membutuhkan waktu ekstra untuk menyempurnakan sistem. Dalam waktu tersebut, Anda dapat membuat paket Python sendiri menggunakan `random.choice()`.
Pada perusahaan teknologi besar, data scientist menggunakan berbagai alat untuk memproses data sensitif dan menjaga privasi data. Mereka juga menggunakan data sintetis untuk meningkatkan kinerja model, mengurangi bias, menguji aplikasi, dan menghemat biaya dalam mengembangkan solusi AI mutakhir.
Jika Anda tertarik untuk belajar lebih jauh, lihat jalur karier Data Scientist dengan Python untuk memulai perjalanan Anda menjadi data scientist yang percaya diri.
Dalam tutorial ini, kita telah mempelajari pentingnya data sintetis dan penerapannya. Kita juga telah menghasilkan data palsu dari awal menggunakan Python Faker untuk menguji sistem data dan menjaga privasi pengguna.



