

Sentetik Veri Nedir?
Sentetik veri, gerçek dünya verilerine benzer şekilde bilgisayar tarafından oluşturulan veridir. Sentetik verinin birincil amacı, sistemlerin gizliliğini ve bütünlüğünü artırmaktır. Örneğin, kullanıcıların Kişisel Olarak Tanımlanabilir Bilgilerini (PII) veya Kişisel Sağlık Bilgilerini (PHI) korumak için şirketlerin veri koruma stratejileri uygulaması gerekir. Sentetik veri kullanımı, şirketlerin yeni uygulamaları test etmesine ve kullanıcı gizliliğini korumasına yardımcı olabilir.
Makine öğrenimi söz konusu olduğunda, sentetik verileri model performansını iyileştirmek için kullanırız. Veri kıt ve dengesiz olduğunda da geçerlidir. Makine öğreniminde sentetik verinin tipik kullanım alanları otonom araçlar, güvenlik, robotik, dolandırıcılık koruması ve sağlık hizmetleridir.
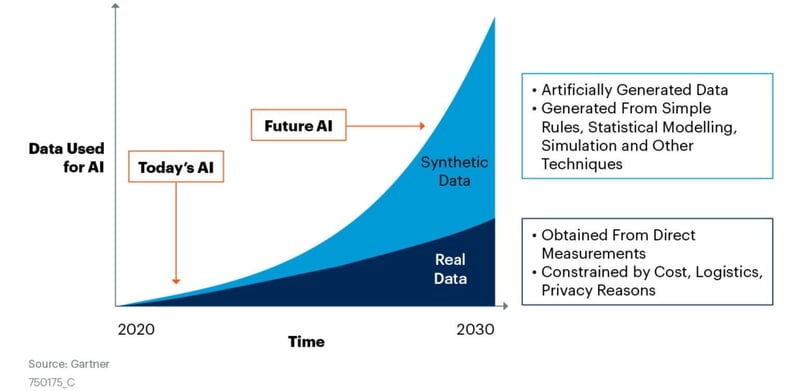
Görsel: Nvidia
Gartner verilerine göre 2024 yılına kadar makine öğrenimi ve analitik uygulamaları geliştirmek için kullanılan verilerin %60’ı sentetik olarak üretilecek. Peki neden sentetik veride yükselen bir trend görüyoruz?
Gerçek dünya verilerini toplamak ve temizlemek maliyetlidir ve bazı durumlarda nadirdir. Örneğin, banka dolandırıcılığı, meme kanseri, otonom araçlar ve kötü amaçlı yazılım saldırı verileri gerçek dünyada nadir bulunur. Veriyi elde etseniz bile, makine öğrenimi görevleri için temizlemek ve işlemek zaman ve kaynak gerektirir.
Eğitimin ilk bölümünde neden sentetik veriye ihtiyaç duyduğumuzu, uygulamalarını ve nasıl üretileceğini öğreneceğiz. Son bölümde ise Python Faker kütüphanesini inceleyip test ve kullanıcı gizliliğini koruma amacıyla sentetik veri oluşturmak için kullanacağız.
Neden Sentetik Veri Üretmemiz Gerekir?
Görsel: Yazar
Kullanıcı gizliliği, uygulama testi, model performansını artırma, nadir vakaları temsil etme ve operasyon maliyetlerini düşürme için sentetik veriye ihtiyaç duyarız.
- Gizlilik: kullanıcıların verilerini korumak için. İsimleri, e-postaları ve adresleri sentetik verilerle değiştirebilirsiniz. Bu, modellerin eğitim verilerinin ayrıntılarını çıkardığı siber ve kara kutu saldırılarından kaçınmamıza yardımcı olur.
- Test: uygulamaları gerçek dünya verileri üzerinde test etmek pahalıdır. Veritabanı, arayüz ve yapay zekâ uygulamalarını sentetik verilerle test etmek daha uygun maliyetli ve güvenlidir.
- Model Performansı: üretilen sentetik veriler model performansını iyileştirebilir. Örneğin: görüntü sınıflandırıcılarda, veri kümesini büyütmek ve model doğruluğunu artırmak için görüntüleri kesme, kaydırma ve döndürme işlemleri kullanılır.
- Nadir Vakalar: nadir olayların gerçekleşmesini bekleyip gerçek dünya verisi toplayamayız. Örnekler: kredi dolandırıcılığı tespiti, araba kazaları ve kanser verileri.
- Maliyet: veri toplama zaman ve kaynak gerektirir. Gerçek dünya verilerini edinmek, temizlemek, etiketlemek ve test veya eğitim için hazırlamak pahalıdır.
Sentetik Verinin Uygulama Alanları Nelerdir?
Bu bölümde, şirketlerin nasıl uygun maliyetli, gizlilik dostu ve yüksek performanslı uygulamalar geliştirmek için sentetik veriler kullandığını öğreneceğiz.
- Veri Paylaşımı: sentetik veriler kurumların hassas verileri kurum içinde ve üçüncü taraflarla paylaşmasını sağlar. Özel verilerin buluta taşınmasına ve analitik için elde tutulmasına da yardımcı olur.
- Finansal hizmetler: dolandırıcılık işlemleri, anomali tespiti ve ekonomik durgunluk gibi nadir olayları taklit etmek için sentetik veriler üretilir. Müşteri davranışlarını analitik araçlarla anlamak için de kullanılır.
- Kalite Güvencesi: uygulama veya veri sistemlerinin kalitesini sürdürmek ve test etmek. Sentetik veriler, sistemleri daha nadir anomaliler üzerinde test etmek ve performansı artırmak için oluşturulur.
- Sağlık: hasta mahremiyetini korurken tıbbi kayıtların iç ve dış paylaşımlarına imkân tanır. Klinik deneyler ve nadir hastalıkların tespiti için de kullanılabilir. Python veya R ile veri gizliliği ve anonimleştirme kursu alarak hassas bilgileri işlemeyi öğrenin.
- Otomotiv: robotlar, dronlar ve otonom araçlar için gerçek dünya verilerini elde etmek zor ve yavaştır. Şirketler, performanstan ödün vermeden çözümler geliştirmek için sistemlerini sentetik simülasyon verileri üzerinde test eder ve eğitir, böylece maliyet tasarrufu sağlar.
- Makine Öğrenimi: eğitim veri kümesi boyutunu artırmak, dengesiz veri sorunlarını çözmek ve modelleri performans ve doğruluk açısından test etmek için sentetik veriler kullanabiliriz. Mevcut görüntü ve metin verilerindeki önyargıları azaltmak için de kullanılır. Bu, sistemleri test etmemize ve kullanıcı gizliliğini korumamıza yardımcı olur. Örneğin, DeepFake yüz tanıma sistemlerini test etmek için kullanılır.
Sentetik Veri Nasıl Üretilir
Sahte veri üreticileri, istatistiksel araçlar, sinir ağları ve üretici çekişmeli ağlar kullanarak sentetik veri üretebiliriz.
Sahte veritabanları oluşturma: Veritabanlarını ve sistemleri test etmek için Faker kütüphanesini kullanma. Adresler ve tüm temel bilgilerle sahte kullanıcı profilleri üretebilir. Ayrıca rastgele metin ve paragraflar üretmek için de kullanabilirsiniz. Bu, şirketlerin test aşamasında kullanıcı gizliliğini korumasına ve gerçek dünya veri setlerini edinme maliyetinden tasarruf etmesine yardımcı olur.
Veri dağılımını anlama: Gaussian, Exponential, Ki-kare, t, lognormal ve Uniform gibi istatistiksel araçlar kullanarak tamamen yeni bir veri kümesi oluşturma. Dağılım tabanlı sentetik veri üretmek için konuya hâkim olmanız gerekir.
Varyasyonel Otokodlayıcı (Variational Autoencoder), özgün veri kümesini sıkıştırmak ve özgün veri kümesinin bir temsilini üretmek için kodlayıcı ve kod çözücü kullanan gözetimsiz bir öğrenme yöntemidir. Girdi ve çıktı veri kümeleri arasındaki korelasyonu eniyileyecek şekilde tasarlanmıştır.
Üretici Çekişmeli Ağ (Generative Adversarial Network), veri üretmenin en popüler yoludur. Bunu kullanarak sentetik görüntüler, ses, tablosal veriler ve simülasyon verileri oluşturabilirsiniz. Rastgele örnekleri gerçek verilerle karşılaştırarak sentetik veri üretmek için üreteç ve ayrıştırıcıdan oluşan derin öğrenme mimarisi kullanır. Kendi sentetik verinizi Keras ile oluşturmak için Üretici Çekişmeli Ağların Şifresini Çözmek eğitimimizi okuyun.
Python Faker Nedir?
Python Faker, uygulama testi, veritabanı başlatma ve kullanıcı anonimliğini koruma için sahte veri kümeleri oluşturmakta kullanılan açık kaynaklı bir Python paketidir.
Görsel: Yazar
Faker’ı şu komutla yükleyebilirsiniz:
pip install fakerFaker; komut satırı desteği, Pytest kolaylıkları, yerelleştirme (farklı bölgeleri destekler), tekrarlanabilirlik ve dinamik sağlayıcı (ihtiyaçlarınıza göre özelleştirme) ile birlikte gelir.
Ayrıca, Faker’ın temel işlevlerini kullanarak hızlıca bir veri kümesi oluşturabilir ve ihtiyaçlarınıza göre özelleştirebilirsiniz. Aşağıdaki tabloda çeşitli Faker işlevlerini ve amaçlarını görebilirsiniz.
|
Faker İşlevi |
Amaç |
|
name() |
Sahte tam ad üretir |
|
credit_card_full() |
Son kullanma tarihi ve CVV ile kredi kartı numarası üretir |
|
email() |
Sahte e-posta adresi üretir |
|
url() |
Sahte URL üretir |
|
phone_number() |
Ülke kodu ile sahte telefon numarası üretir |
|
address() |
Sahte tam adres üretir |
|
license_plate() |
Sahte plaka üretir |
|
currency() |
Para birimi kodu ve tam adından oluşan bir ikili döndürür |
|
color_name() |
Rastgele renk adı üretir |
|
local_latlng() |
Enlem, boylam, bölge, ülke ve eyalet/iller üretir |
|
domain_name() |
Sahte kişi adına dayalı sahte web sitesi alanı üretir |
|
text() |
Kısa sahte metin üretir |
|
company() |
Sahte şirket adı üretir |
Daha gelişmiş işlevler hakkında bilgi edinmek için Faker belgelerine göz atın.
Bu işlevleri gözden geçirmek önemlidir; çünkü çeşitli örnekler ve veri çerçeveleri oluştururken bunları kullanacağız.
Python Faker ile Sentetik Veri Üretimi
Bu bölümde Python Faker’ı kullanarak sentetik veriler üreteceğiz. Faker’ı çeşitli görevler için nasıl kullanabileceğinize dair 5 örnekten oluşur. Ana hedefimiz, sistemleri test etmek için gizlilik odaklı bir yaklaşım geliştirmektir. Son bölümde, Faker’ın yerelleştirilmiş sağlayıcısını kullanarak özgün veriyi tamamlamak üzere sahte veriler oluşturacağız.
Bu eğitime ait tüm kodları bu DataLab çalışma kitabında bulabilirsiniz; tarayıcıda tüm kodları çalıştırmak için kendi çalışma kitabı kopyanızı kolayca oluşturabilir, bilgisayarınıza hiçbir şey kurmadan çalışabilirsiniz.
Önce, `Faker()` kullanarak bir sahte veri üreteci başlatacağız. Varsayılan olarak “en_US” yereli kullanılır.
from faker import Faker
fake = Faker()Örnek 1
“fake” nesnesi, özellik adlarını kullanarak veri üretebilir. Örneğin, rastgele bir kişinin tam adını üretmek için `fake.name()` kullanılır.
print(fake.name())
>>> Jessica RobinsonBenzer şekilde, aşağıda gösterildiği gibi sahte e-posta adresi, ülke adı, metin, coğrafi konum ve URL üretebiliriz.
print(fake.email())
print(fake.country())
print(fake.name())
print(fake.text())
print(fake.latitude(), fake.longitude())
print(fake.url())Çıktı
ybanks@example.com
Mayotte
Mr. Jose Browning DDS
Dog might bank dog total life financial. Dark view doctor time just.
Stay second treatment language theory. Space seek adult create matter imagine lay.
51.7514185 -148.802970
http://fischer.info/Örnek 2
Farklı dillerde ve farklı bölgeler için veri üretmek üzere çeşitli yerelleri kullanabilirsiniz.
Aşağıdaki örnekte, İspanyolca dilinde ve İspanya bölgesine yönelik veri üreteceğiz.
fake = Faker("es_ES")
print(fake.email())
print(fake.country())
print(fake.name())
print(fake.text())
print(fake.latitude(), fake.longitude())
print(fake.url())Çıktı
Gördüğümüz gibi, kişinin adı değişti ve metin İspanyolca.
casandrahierro@example.com
Tonga
Juan Solera-Mancebo
Cumque adipisci eligendi aperiam. Quas laboriosam amet at dignissimos. Excepturi pariatur ipsam esse.
89.180798 -2.274117
https://corbacho-galan.net/Almanca dilini ve ülke olarak Almanya’yı deneyelim. Tam bir kullanıcı profili üretmek için `profile()` işlevini kullanacağız.
fake = Faker("de_DE")
fake.profile()Çıktı
Faker’ı farklı ülkeler için farklı dillerde veri üretmek amacıyla nasıl kullanabileceğimiz oldukça açık. Yereli değiştirmek, dil ve ülkeye bağlı olarak ad, meslek, adres, şirket ve diğer kullanıcı tanımlama verilerini değiştirir.
{'job': 'Erzieher',
'company': 'Stadelmann Thanel GmbH',
'ssn': '631-64-0521',
'residence': 'Leo-Schinke-Allee 298\n26224 Altötting',
'current_location': (Decimal('51.5788595'), Decimal('29.780659')),
'blood_group': 'B+',
'website': ['https://www.schmidtke.de/',
'https://roskoth.com/',
'http://www.textor.de/',
'https://www.zirme.com/'],
'username': 'vdoerr',
'name': 'Francesca Fröhlich',
'sex': 'F',
'address': 'Steinbergallee 13\n84765 Saarbrücken',
'mail': '[email protected]',
'birthdate': datetime.date(1998, 3, 19)}Örnek 3
Bu örnekte, Faker kullanarak bir pandas veri çerçevesi oluşturacağız.
- Boş bir pandas veri çerçevesi (data) oluşturun
- Birden çok satır oluşturmak için x kez döngüden geçirin
- Benzersiz kimlik üretmek için `randint()` kullanın
- Ad, adres ve coğrafi konum oluşturmak için Faker kullanın
- `input_data()` işlevini x=10 ile çalıştırın
from random import randint
import pandas as pd
fake = Faker()
def input_data(x):
# pandas dataframe
data = pd.DataFrame()
for i in range(0, x):
data.loc[i,'id']= randint(1, 100)
data.loc[i,'name']= fake.name()
data.loc[i,'address']= fake.address()
data.loc[i,'latitude']= str(fake.latitude())
data.loc[i,'longitude']= str(fake.longitude())
return data
input_data(10)Çıktı harika görünüyor. Benzersiz kullanıcı verileriyle id, name, address, latitude ve longitude sütunlarımız var.
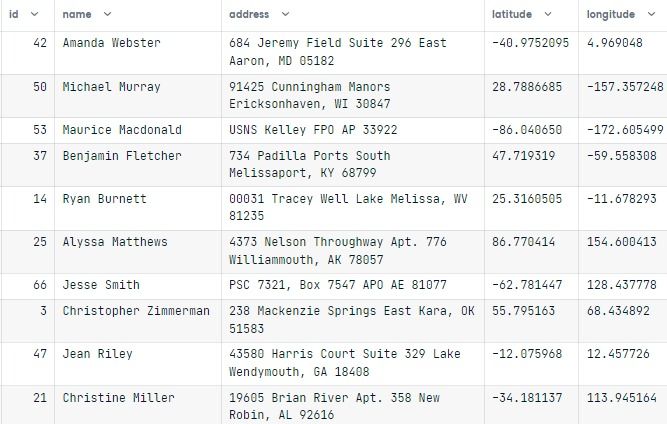
Sonucu tekrar üretebilmek için tohum (seed) ayarlamamız gerekir. Böylece kod hücresini her yeniden çalıştırdığımızda benzer sonuçlar elde ederiz.
Faker.seed(2)
input_data(10)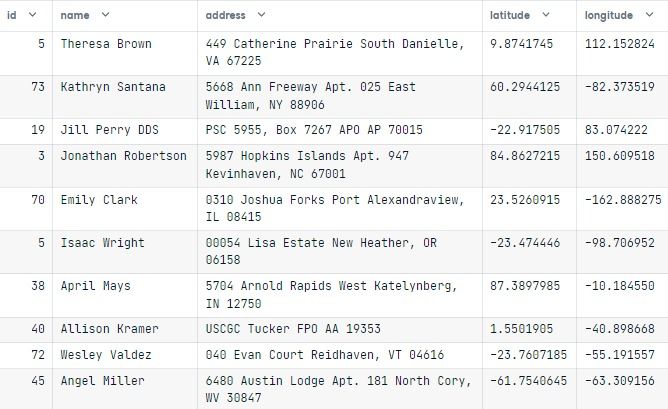
Örnek 4
Seçtiğimiz anahtar kelimeleri içeren bir cümle de üretebiliriz. `text(), texts(), paragraph(), word(), ve words()` işlevlerine benzer. Bir cümledeki kelime sayısını nb_words bağımsız değişkenini ayarlayarak artırabilirsiniz.
Aşağıdaki örnekte, bir kelime listesi kullanarak beş cümle üretiyoruz. Mükemmel değildir, ancak tonlarca metin verisi gerektiren uygulamaları test etmemize yardımcı olabilir.
word_list = ["DataCamp", "says", "great", "loves", "tutorial", "workplace"]
for i in range(0, 5):
print(fake.sentence(ext_word_list=word_list))Çıktı
Loves great says.
Says workplace workplace tutorial great loves.
Loves workplace workplace loves workplace loves great DataCamp.
Loves says workplace great.
Workplace great DataCamp.Sentetik ve gerçek veriyi harmanlama
Bu bölümde, DataCamp’in veri kümesi deposundaki E-Ticaret Verilerini kullanacak ve CustomerID ve Country sütunlarını kullanarak sahte kullanıcı verileri ekleyeceğiz. Bu, kullanıcı gizliliğini korumamıza ve sistemi ek parametrelerle test etmemize yardımcı olacaktır.
CSV dosyasını yüklemek için pandas’ın `read_csv()` işlevini kullanacağız ve ilk beş satırı `head()` ile görüntüleyeceğiz
# Loading CSV file
Ecommerce = pd.read_csv("e-commerce.csv")
Ecommerce.head()Veri kümesi; InvoiceNo, StockCode (ürün kimliği), Description, Product (ürün) adı, Quantity (işlem başına), InvoiceDate, UnitPrice (Sterlin cinsinden), CustomerID ve Country sütunlarından oluşur.
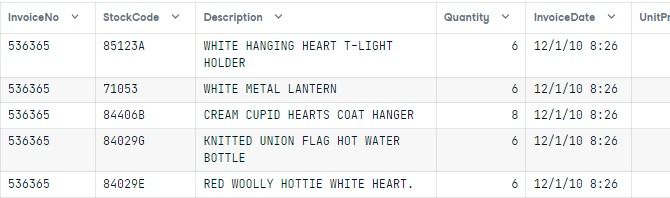
Yerelleştirilmiş bir Faker nesnesi oluşturmak için benzersiz ülke adlarını görüntüleyecek ve bunları kullanarak bir sözlük oluşturacağız. Gözlemlediğimiz üzere yedi ülkemiz var ve bir sonraki bölümde yedi yerelleştirilmiş Faker üreteci oluşturacağız.
Ecommerce.Country.dropna().unique()
>>> array(['United Kingdom', 'France', 'Australia', 'Netherlands', 'Germany',
'Norway', 'EIRE'], dtype=object)`anonymous` işlevinde şunlar var:
- Benzersiz müşteri kimliklerini çıkardık ve eksik değerleri kaldırdık
- Ülke adları ve yerel kısaltmalarından bir sözlük oluşturduk
- Benzersiz müşteri kimliği için satır indeksini ve ülke adını çıkardık
- Yerelleştirilmiş Faker üretecini başlatmak için sözlük ve ülke adını kullandık
- Mevcut veri çerçevesine müşteri adı, adres ve coğrafi konum ekledik.
Aşağıdaki işlev, veri çerçevesini kullanır ve CustomerID ve Country sütunlarına göre kullanıcı verileri içeren dört yeni sütun ekler.
def anonymous(df):
# Extracting unique CustomerID
unique_id = df.CustomerID.dropna().unique()
# Creating the dictionary for Faker localized providers
local = {
"United Kingdom": "en_GB",
"France": "fr_FR",
"Australia": "en_AU",
"Netherlands": "nl_NL",
"Germany": "de_DE",
"Norway": "no_NO",
"EIRE": "ga_IE",
}
for i in unique_id:
# Extracting row index
row_id = df[df["CustomerID"] == i].index
# Extracting country name for faker locale
CountryName = Ecommerce.loc[
Ecommerce["CustomerID"] == i, "Country"
].to_numpy()[0]
# Using locale dictionary to create faker locale generator
code = local[CountryName]
fake = Faker(code)
# Generating fake data and adding it to dataframe
CustomerName = fake.name()
Address = fake.address()
Latitude = str(fake.latitude())
Longitude = str(fake.longitude())
for x in row_id:
df.loc[x, "CustomerName"] = CustomerName
df.loc[x, "Address"] = Address
df.loc[x, "Latitude"] = Latitude
df.loc[x, "Longitude"] = Longitude
return dfTekrarlanabilirlik için seed(5) kullanacak ve `anonymous` işlevini Ecommerce veri çerçevesi üzerinde çalıştıracağız.
# Using seed for reproducibility
Faker.seed(5)
secure_db = anonymous(Ecommerce)
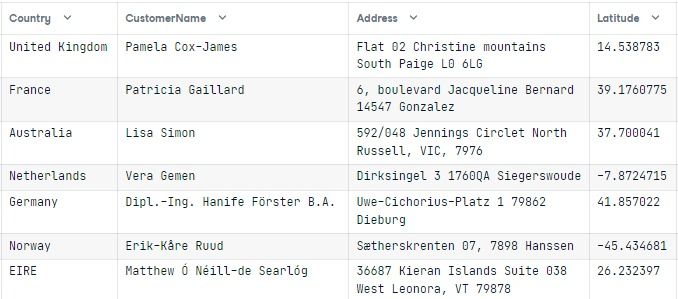
secure_dbİlk birkaç sonuç, 17850, United Kingdom ve Pamela Cox-James verilerini gösteriyor.
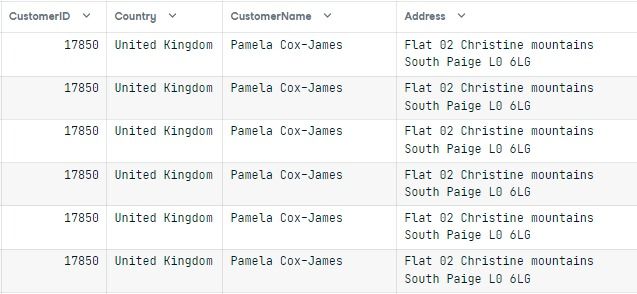
İşlevin yerelleştirilmiş sonuçlarını görselleştirmek için benzersiz Country sütununa ait verileri görüntülememiz gerekir.
display_db = []
for i in Ecommerce.Country.dropna().unique():
display_db.append(secure_db[secure_db["Country"] == i].to_numpy()[0])
pd.DataFrame(display_db, columns=Ecommerce.columns)Sonuç umut verici. Bölge ve dile göre farklı isimler görebilirsiniz. Adresler ülkeyle eşleşiyor. Bu yöntemle, kişisel tanımlama verilerini kaldırabilir ve Faker kullanarak yerelleştirilmiş veriler oluşturarak kullanıcı gizliliğini koruyup maliyetten tasarruf edebilirsiniz.
Kod kaynağı bu DataLab çalışma kitabında mevcuttur.
Sonuç
Python Faker kullanmanın sakıncalarından biri zayıf veri kalitesi sunmasıdır. Uygulama testleri için işe yarayabilir, ancak veri doğruluğu düşüktür. Örneğin, isimler e-posta, alan adı veya kullanıcı adıyla eşleşmeyebilir.
Sağlayıcıyı özelleştirebilir veya tercihinize göre yenisini oluşturabilirsiniz; ancak sistemi mükemmelleştirmek ekstra zaman alacaktır. Bu süre içinde `random.choice()` kullanarak kendi Python paketinizi de oluşturabilirsiniz.
Büyük teknoloji şirketlerinde, veri bilimciler hassas verileri işlemek ve veri gizliliğini korumak için çeşitli araçlar kullanıyor. Ayrıca model performansını iyileştirmek, önyargıyı azaltmak, uygulamaları test etmek ve ileri düzey yapay zekâ çözümleri geliştirirken maliyeti düşürmek için sentetik verilerden yararlanıyorlar.
Daha fazlasını öğrenmek isterseniz, yolculuğunuza güvenli bir veri bilimci olarak başlamak için Python ile Veri Bilimci kariyer yoluna göz atın.
Bu eğitimde, sentetik verinin önemini ve uygulamalarını öğrendik. Ayrıca, veri sistemlerini test etmek ve kullanıcıların gizliliğini korumak için Python Faker kullanarak sıfırdan sahte veriler ürettik.



