

Dữ liệu tổng hợp là gì?
Dữ liệu tổng hợp là dữ liệu do máy tính tạo ra, tương tự dữ liệu thế giới thực. Mục đích chính của dữ liệu tổng hợp là tăng cường quyền riêng tư và tính toàn vẹn của hệ thống. Ví dụ: để bảo vệ Thông tin Nhận dạng Cá nhân (PII) hoặc Thông tin Sức khỏe Cá nhân (PHI) của người dùng, các công ty phải triển khai chiến lược bảo vệ dữ liệu. Việc sử dụng dữ liệu tổng hợp có thể giúp các công ty kiểm thử ứng dụng mới và bảo vệ quyền riêng tư người dùng.
Trong trường hợp học máy, chúng ta dùng dữ liệu tổng hợp để cải thiện hiệu suất mô hình. Điều này cũng hữu ích khi dữ liệu khan hiếm và mất cân bằng. Các trường hợp sử dụng điển hình của dữ liệu tổng hợp trong học máy gồm xe tự lái, an ninh, robot, phòng chống gian lận và chăm sóc sức khỏe.
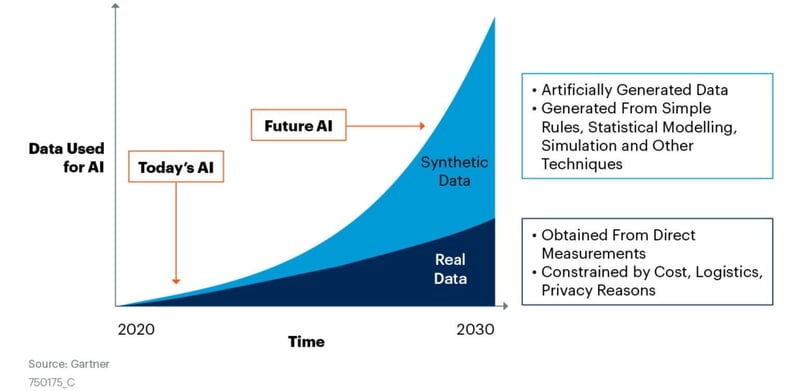
Hình ảnh từ Nvidia
Theo dữ liệu từ Gartner, đến năm 2024, 60% dữ liệu dùng để phát triển các ứng dụng học máy và phân tích sẽ được tạo tổng hợp. Nhưng vì sao chúng ta thấy xu hướng tăng của dữ liệu tổng hợp?
Việc thu thập và làm sạch dữ liệu thực tế tốn kém, và trong một số trường hợp lại hiếm. Chẳng hạn, dữ liệu gian lận ngân hàng, ung thư vú, xe tự lái và tấn công phần mềm độc hại rất khó tìm trong thế giới thực. Ngay cả khi có được dữ liệu, sẽ mất thời gian và nguồn lực để làm sạch và xử lý cho các tác vụ học máy.
Trong phần đầu của hướng dẫn, chúng ta sẽ tìm hiểu vì sao cần dữ liệu tổng hợp, các ứng dụng của nó và cách tạo ra. Ở phần cuối, chúng ta sẽ khám phá thư viện Python Faker và dùng nó để tạo dữ liệu tổng hợp phục vụ kiểm thử và duy trì quyền riêng tư người dùng.
Vì sao chúng ta cần tạo dữ liệu tổng hợp?
Hình ảnh của Tác giả
Chúng ta cần dữ liệu tổng hợp để bảo vệ quyền riêng tư người dùng, kiểm thử ứng dụng, cải thiện hiệu suất mô hình, biểu diễn các trường hợp hiếm và giảm chi phí vận hành.
- Quyền riêng tư: bảo vệ dữ liệu người dùng. Bạn có thể thay thế tên, email và địa chỉ bằng dữ liệu tổng hợp. Điều này giúp tránh các cuộc tấn công mạng và “hộp đen” khi mô hình suy ra chi tiết dữ liệu huấn luyện.
- Kiểm thử: kiểm thử ứng dụng trên dữ liệu thực tế rất tốn kém. Kiểm thử cơ sở dữ liệu, UI và ứng dụng AI trên dữ liệu tổng hợp tiết kiệm chi phí và an toàn hơn.
- Hiệu suất mô hình: dữ liệu tổng hợp tạo ra có thể cải thiện hiệu suất mô hình. Ví dụ: trong bộ phân loại ảnh, chúng ta cắt xén, tịnh tiến và xoay ảnh để tăng kích thước tập dữ liệu và nâng độ chính xác mô hình.
- Trường hợp hiếm: chúng ta không thể chờ sự kiện hiếm xảy ra rồi mới thu thập dữ liệu thực. Ví dụ: phát hiện gian lận tín dụng, tai nạn xe hơi và dữ liệu ung thư.
- Chi phí: thu thập dữ liệu tốn thời gian và nguồn lực. Chi phí cao cho việc thu thập dữ liệu thực, làm sạch, gán nhãn và chuẩn bị để kiểm thử hoặc huấn luyện mô hình.
Các ứng dụng của dữ liệu tổng hợp là gì?
Trong phần này, chúng ta sẽ học cách các công ty dùng dữ liệu tổng hợp để xây dựng ứng dụng hiệu quả về chi phí, thân thiện với quyền riêng tư và có hiệu năng cao.
- Chia sẻ dữ liệu: dữ liệu tổng hợp cho phép doanh nghiệp chia sẻ dữ liệu nhạy cảm nội bộ và với bên thứ ba. Nó cũng hỗ trợ đưa dữ liệu riêng tư lên đám mây và giữ lại dữ liệu để phân tích.
- Dịch vụ tài chính: tạo dữ liệu tổng hợp để mô phỏng các sự kiện hiếm như giao dịch gian lận, phát hiện bất thường và suy thoái kinh tế. Cũng được dùng để hiểu hành vi khách hàng bằng công cụ phân tích.
- Đảm bảo chất lượng: duy trì và kiểm thử chất lượng của ứng dụng hoặc hệ thống dữ liệu. Dữ liệu tổng hợp được tạo để kiểm thử hệ thống trên các bất thường hiếm và cải thiện hiệu năng.
- Chăm sóc sức khỏe: cho phép chia sẻ hồ sơ y tế nội bộ và bên ngoài mà vẫn bảo mật cho bệnh nhân. Bạn cũng có thể dùng cho thử nghiệm lâm sàng và phát hiện bệnh hiếm. Học cách xử lý thông tin nhạy cảm với khóa học về quyền riêng tư dữ liệu và ẩn danh bằng Python hoặc R.
- Ô tô và robot: khó và chậm để có dữ liệu thực cho robot, máy bay không người lái và xe tự lái. Các công ty kiểm thử và huấn luyện hệ thống trên dữ liệu mô phỏng tổng hợp, tiết kiệm chi phí mà không đánh đổi hiệu năng.
- Học máy: chúng ta có thể dùng dữ liệu tổng hợp để tăng kích thước tập huấn luyện, giải quyết mất cân bằng dữ liệu và kiểm thử mô hình nhằm đảm bảo hiệu suất và độ chính xác. Cũng được dùng để giảm thiên lệch trong dữ liệu ảnh và văn bản hiện có. Nó giúp kiểm thử hệ thống và duy trì quyền riêng tư người dùng. Ví dụ, DeepFake được dùng để kiểm thử hệ thống nhận diện khuôn mặt.
Cách tạo dữ liệu tổng hợp
Chúng ta có thể dùng các trình tạo dữ liệu giả, công cụ thống kê, mạng nơ-ron và mạng đối sinh để tạo dữ liệu tổng hợp.
Tạo cơ sở dữ liệu giả bằng thư viện Faker để kiểm thử cơ sở dữ liệu và hệ thống. Nó có thể tạo hồ sơ người dùng giả với địa chỉ và mọi thông tin thiết yếu. Bạn cũng có thể dùng để tạo văn bản và đoạn văn ngẫu nhiên. Cách này giúp các công ty bảo vệ quyền riêng tư người dùng trong giai đoạn kiểm thử và tiết kiệm chi phí thu thập tập dữ liệu thực.
Hiểu phân phối dữ liệu để tạo một tập dữ liệu hoàn toàn mới bằng công cụ thống kê như Gaussian, Exponential, Chi-square, t, lognormal và Uniform. Bạn cần có kiến thức lĩnh vực để tạo dữ liệu tổng hợp dựa trên phân phối.
Variational Autoencoder là phương pháp học không giám sát dùng bộ mã hóa và giải mã để nén tập dữ liệu gốc và tạo biểu diễn của tập dữ liệu đó. Nó được thiết kế để tối ưu hóa tương quan giữa tập dữ liệu đầu vào và đầu ra.
Generative Adversarial Network là cách phổ biến nhất để tạo dữ liệu. Bạn có thể dùng để sinh ảnh, âm thanh, dữ liệu dạng bảng và dữ liệu mô phỏng tổng hợp. Nó dùng kiến trúc mô hình học sâu gồm bộ sinh và bộ phân biệt để tạo dữ liệu tổng hợp bằng cách so sánh mẫu ngẫu nhiên với dữ liệu thực. Đọc hướng dẫn Giải mã Generative Adversarial Nets để tự tạo dữ liệu tổng hợp bằng Keras.
Python Faker là gì?
Python Faker là một gói Python nguồn mở dùng để tạo tập dữ liệu giả phục vụ kiểm thử ứng dụng, khởi tạo cơ sở dữ liệu và duy trì tính ẩn danh của người dùng.
Hình ảnh của Tác giả
Bạn có thể cài Faker bằng:
pip install fakerFaker hỗ trợ dòng lệnh, fixture cho Pytest, bản địa hóa (hỗ trợ nhiều vùng), khả năng tái lập và nhà cung cấp động (tùy biến theo nhu cầu của bạn).
Bạn cũng có thể dùng các chức năng cơ bản của Faker để nhanh chóng tạo một tập dữ liệu rồi tùy biến theo nhu cầu. Trong bảng dưới đây, bạn có thể xem các hàm Faker khác nhau và mục đích của chúng.
|
Hàm Faker |
Mục đích |
|
name() |
Tạo họ tên giả |
|
credit_card_full() |
Tạo số thẻ tín dụng kèm ngày hết hạn và CVV |
|
email() |
Tạo địa chỉ email giả |
|
url() |
Tạo URL giả |
|
phone_number() |
Tạo số điện thoại giả kèm mã quốc gia |
|
address() |
Tạo địa chỉ đầy đủ giả |
|
license_plate() |
Tạo biển số xe giả |
|
currency() |
Tạo bộ gồm mã tiền tệ và tên đầy đủ |
|
color_name() |
Tạo tên màu ngẫu nhiên |
|
local_latlng() |
Tạo vĩ độ, kinh độ, khu vực, quốc gia và bang/tỉnh |
|
domain_name() |
Tạo tên website giả dựa trên tên người |
|
text() |
Tạo đoạn văn bản ngắn giả |
|
company() |
Tạo tên công ty giả |
Để tìm hiểu các hàm nâng cao, hãy xem tài liệu Faker.
Việc rà soát các hàm này rất quan trọng vì chúng ta sẽ dùng chúng để tạo nhiều ví dụ và dataframe khác nhau.
Tạo dữ liệu tổng hợp với Python Faker
Trong phần này, chúng ta sẽ dùng Python Faker để tạo dữ liệu tổng hợp. Phần này gồm 5 ví dụ về cách bạn có thể dùng Faker cho nhiều tác vụ. Mục tiêu chính là phát triển cách tiếp cận ưu tiên quyền riêng tư khi kiểm thử hệ thống. Ở phần cuối, chúng ta sẽ tạo dữ liệu giả để bổ sung cho dữ liệu gốc bằng nhà cung cấp bản địa hóa của Faker.
Bạn có thể tìm toàn bộ mã cho hướng dẫn này trong sổ tay DataLab này; bạn có thể dễ dàng tạo bản sao sổ tay của riêng mình để chạy toàn bộ mã trên trình duyệt mà không cần cài đặt gì trên máy tính.
Đầu tiên, chúng ta sẽ khởi tạo bộ tạo dữ liệu giả bằng `Faker()`. Theo mặc định, nó dùng locale “en_US”.
from faker import Faker
fake = Faker()Ví dụ 1
Đối tượng “fake” có thể tạo dữ liệu bằng cách gọi tên thuộc tính. Ví dụ, `fake.name()` dùng để tạo họ tên đầy đủ ngẫu nhiên.
print(fake.name())
>>> Jessica RobinsonTương tự, chúng ta có thể tạo email giả, tên quốc gia, văn bản, vị trí địa lý và URL như dưới đây.
print(fake.email())
print(fake.country())
print(fake.name())
print(fake.text())
print(fake.latitude(), fake.longitude())
print(fake.url())Kết quả
ybanks@example.com
Mayotte
Mr. Jose Browning DDS
Dog might bank dog total life financial. Dark view doctor time just.
Stay second treatment language theory. Space seek adult create matter imagine lay.
51.7514185 -148.802970
http://fischer.info/Ví dụ 2
Bạn có thể dùng các locale khác nhau để tạo dữ liệu bằng nhiều ngôn ngữ và cho các vùng khác nhau.
Trong ví dụ dưới, chúng ta sẽ tạo dữ liệu bằng tiếng Tây Ban Nha và vùng là Tây Ban Nha.
fake = Faker("es_ES")
print(fake.email())
print(fake.country())
print(fake.name())
print(fake.text())
print(fake.latitude(), fake.longitude())
print(fake.url())Kết quả
Như thấy, tên cá nhân đã thay đổi và văn bản ở tiếng Tây Ban Nha.
casandrahierro@example.com
Tonga
Juan Solera-Mancebo
Cumque adipisci eligendi aperiam. Quas laboriosam amet at dignissimos. Excepturi pariatur ipsam esse.
89.180798 -2.274117
https://corbacho-galan.net/Hãy thử tiếp với tiếng Đức và quốc gia là Đức. Để tạo hồ sơ người dùng đầy đủ, chúng ta sẽ dùng hàm `profile()`.
fake = Faker("de_DE")
fake.profile()Kết quả
Rất rõ ràng cách chúng ta có thể dùng Faker để tạo dữ liệu bằng nhiều ngôn ngữ cho nhiều quốc gia. Thay đổi locale sẽ thay đổi tên, công việc, địa chỉ, công ty và các dữ liệu nhận dạng người dùng khác dựa trên ngôn ngữ và quốc gia.
{'job': 'Erzieher',
'company': 'Stadelmann Thanel GmbH',
'ssn': '631-64-0521',
'residence': 'Leo-Schinke-Allee 298\n26224 Altötting',
'current_location': (Decimal('51.5788595'), Decimal('29.780659')),
'blood_group': 'B+',
'website': ['https://www.schmidtke.de/',
'https://roskoth.com/',
'http://www.textor.de/',
'https://www.zirme.com/'],
'username': 'vdoerr',
'name': 'Francesca Fröhlich',
'sex': 'F',
'address': 'Steinbergallee 13\n84765 Saarbrücken',
'mail': '[email protected]',
'birthdate': datetime.date(1998, 3, 19)}Ví dụ 3
Trong ví dụ này, chúng ta sẽ tạo một pandas dataframe bằng Faker.
- Tạo pandas dataframe trống (data)
- Chạy qua x vòng lặp để tạo nhiều hàng
- Dùng `randint()` để tạo id duy nhất
- Dùng Faker để tạo tên, địa chỉ và vị trí địa lý
- Chạy hàm `input_data()` với x=10
from random import randint
import pandas as pd
fake = Faker()
def input_data(x):
# pandas dataframe
data = pd.DataFrame()
for i in range(0, x):
data.loc[i,'id']= randint(1, 100)
data.loc[i,'name']= fake.name()
data.loc[i,'address']= fake.address()
data.loc[i,'latitude']= str(fake.latitude())
data.loc[i,'longitude']= str(fake.longitude())
return data
input_data(10)Kết quả trông rất ấn tượng. Chúng ta có các cột id, name, address, latitude và longitude với dữ liệu người dùng duy nhất.
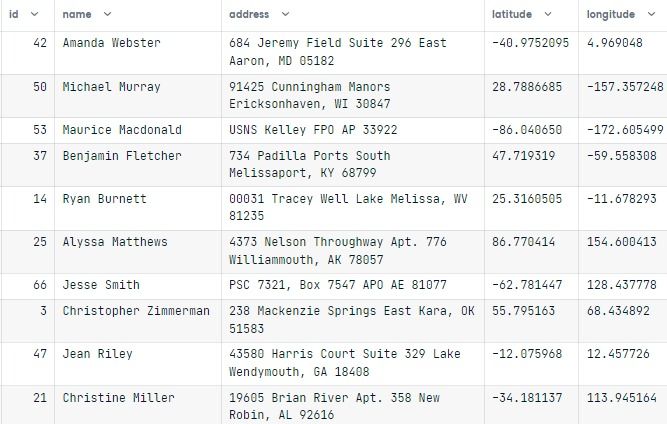
Để tái lập kết quả, chúng ta phải đặt seed. Nhờ vậy, mỗi lần chạy lại ô mã, chúng ta sẽ nhận kết quả tương tự.
Faker.seed(2)
input_data(10)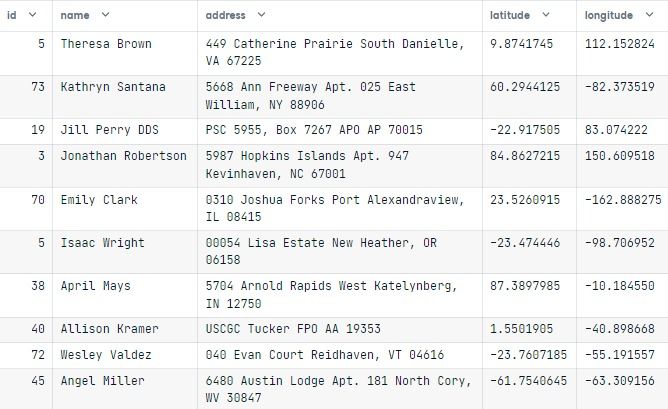
Ví dụ 4
Chúng ta cũng có thể tạo câu chứa các từ khóa do mình chọn. Tương tự như `text(), texts(), paragraph(), word(), và words()`. Bạn có thể tăng số từ trong câu bằng cách đặt đối số nb_words.
Trong ví dụ dưới đây, chúng ta tạo năm câu bằng một danh sách từ. Không hoàn hảo, nhưng có thể giúp kiểm thử các ứng dụng cần rất nhiều dữ liệu văn bản.
word_list = ["DataCamp", "says", "great", "loves", "tutorial", "workplace"]
for i in range(0, 5):
print(fake.sentence(ext_word_list=word_list))Kết quả
Loves great says.
Says workplace workplace tutorial great loves.
Loves workplace workplace loves workplace loves great DataCamp.
Loves says workplace great.
Workplace great DataCamp.Trộn dữ liệu tổng hợp và dữ liệu thực
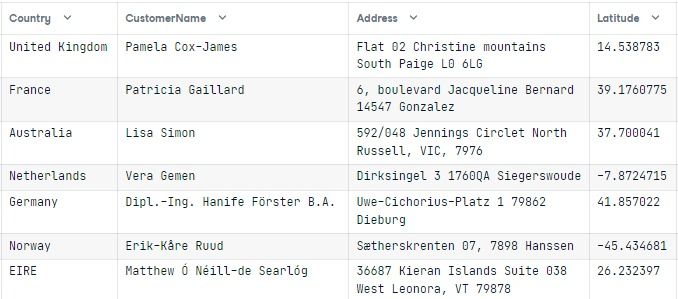
Ở phần này, chúng ta sẽ dùng Dữ liệu Thương mại điện tử từ kho dữ liệu của DataCamp và thêm dữ liệu người dùng giả dựa trên cột CustomerID và Country. Cách này giúp duy trì quyền riêng tư người dùng và kiểm thử hệ thống trên các tham số bổ sung.
Để tải tệp CSV, chúng ta sẽ dùng hàm `read_csv()` của pandas và hiển thị 5 hàng đầu bằng `head()`
# Loading CSV file
Ecommerce = pd.read_csv("e-commerce.csv")
Ecommerce.head()Tập dữ liệu gồm các cột InvoiceNo, StockCode (mã sản phẩm), Description, Product (tên mặt hàng), Quantity (mỗi giao dịch), InvoiceDate, UnitPrice (bằng Bảng Anh), CustomerID và Country.
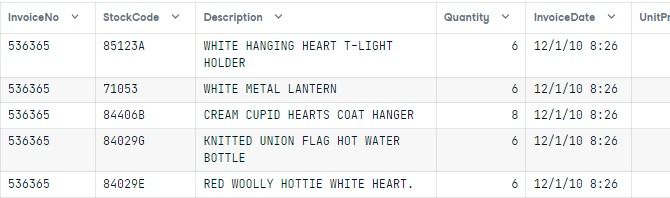
Để tạo đối tượng Faker bản địa hóa, chúng ta sẽ hiển thị các tên quốc gia duy nhất và dùng chúng để tạo một từ điển. Như quan sát, chúng ta có bảy quốc gia và sẽ tạo bảy bộ tạo dữ liệu Faker bản địa hóa ở phần tiếp theo.
Ecommerce.Country.dropna().unique()
>>> array(['United Kingdom', 'France', 'Australia', 'Netherlands', 'Germany',
'Norway', 'EIRE'], dtype=object)Trong hàm `anonymous`, chúng ta đã:
- Trích xuất CustomerID duy nhất và loại bỏ giá trị thiếu
- Tạo từ điển tên quốc gia và dạng rút gọn locale
- Trích xuất chỉ mục hàng và tên quốc gia cho CustomerID duy nhất
- Dùng từ điển và tên quốc gia để khởi tạo bộ tạo Faker bản địa hóa
- Thêm tên khách hàng, địa chỉ và vị trí địa lý vào dataframe hiện có.
Hàm dưới đây dùng dataframe và thêm bốn cột mới với dữ liệu người dùng dựa trên các cột CustomerID và Country.
def anonymous(df):
# Extracting unique CustomerID
unique_id = df.CustomerID.dropna().unique()
# Creating the dictionary for Faker localized providers
local = {
"United Kingdom": "en_GB",
"France": "fr_FR",
"Australia": "en_AU",
"Netherlands": "nl_NL",
"Germany": "de_DE",
"Norway": "no_NO",
"EIRE": "ga_IE",
}
for i in unique_id:
# Extracting row index
row_id = df[df["CustomerID"] == i].index
# Extracting country name for faker locale
CountryName = Ecommerce.loc[
Ecommerce["CustomerID"] == i, "Country"
].to_numpy()[0]
# Using locale dictionary to create faker locale generator
code = local[CountryName]
fake = Faker(code)
# Generating fake data and adding it to dataframe
CustomerName = fake.name()
Address = fake.address()
Latitude = str(fake.latitude())
Longitude = str(fake.longitude())
for x in row_id:
df.loc[x, "CustomerName"] = CustomerName
df.loc[x, "Address"] = Address
df.loc[x, "Latitude"] = Latitude
df.loc[x, "Longitude"] = Longitude
return dfChúng ta sẽ dùng seed(5) để tái lập và chạy hàm `anonymous` trên dataframe Ecommerce.
# Using seed for reproducibility
Faker.seed(5)
secure_db = anonymous(Ecommerce)
secure_dbVài kết quả đầu cho thấy dữ liệu của 17850, United Kingdom và Pamela Cox-James.
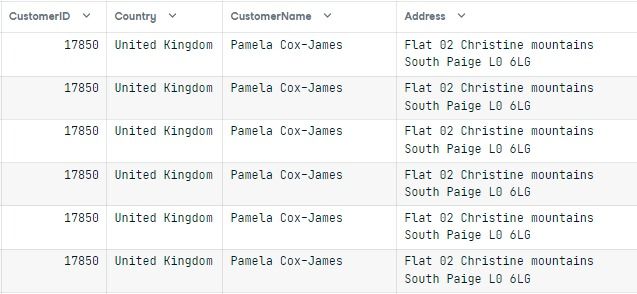
Để trực quan hóa kết quả bản địa hóa của hàm, chúng ta cần xem dữ liệu cho từng giá trị duy nhất của cột Country.
display_db = []
for i in Ecommerce.Country.dropna().unique():
display_db.append(secure_db[secure_db["Country"] == i].to_numpy()[0])
pd.DataFrame(display_db, columns=Ecommerce.columns)Kết quả rất hứa hẹn. Bạn có thể thấy các tên khác nhau theo từng vùng và ngôn ngữ. Địa chỉ khớp với quốc gia. Với phương pháp này, bạn có thể loại bỏ dữ liệu nhận dạng cá nhân và tạo dữ liệu bản địa hóa bằng Faker để bảo vệ quyền riêng tư người dùng và tiết kiệm chi phí.
Mã nguồn có trong sổ tay DataLab này.
Kết luận
Một nhược điểm khi dùng Python Faker là chất lượng dữ liệu còn thấp. Nó phù hợp cho kiểm thử ứng dụng, nhưng thiếu độ chính xác dữ liệu. Ví dụ, tên không khớp với email, tên miền hay tên người dùng.
Bạn có thể tùy biến nhà cung cấp hoặc tạo nhà cung cấp mới theo ý, nhưng sẽ tốn thêm thời gian để hoàn thiện hệ thống. Trong thời gian đó, bạn có thể tạo gói Python riêng bằng `random.choice()`.
Ở các công ty công nghệ lớn, các nhà khoa học dữ liệu dùng nhiều công cụ để xử lý dữ liệu nhạy cảm và duy trì quyền riêng tư dữ liệu. Họ cũng dùng dữ liệu tổng hợp để cải thiện hiệu suất mô hình, giảm thiên lệch, kiểm thử ứng dụng và tiết kiệm chi phí phát triển các giải pháp AI tiên tiến.
Nếu bạn quan tâm tìm hiểu thêm, hãy xem lộ trình nghề nghiệp Data Scientist with Python để bắt đầu hành trình trở thành một nhà khoa học dữ liệu vững vàng.
Trong hướng dẫn này, chúng ta đã học tầm quan trọng và các ứng dụng của dữ liệu tổng hợp. Chúng ta cũng đã tạo dữ liệu giả từ đầu bằng Python Faker để kiểm thử hệ thống dữ liệu và duy trì quyền riêng tư cho người dùng.

