Kursus
Analisis Klaster di R
4 jam
44.4K
Ada beberapa hal yang perlu Anda perhatikan sebelum memulai.
Sangat penting untuk menormalkan skala nilai fitur sebelum memulai proses clustering. Ini karena nilai fitur setiap observasi direpresentasikan sebagai koordinat dalam ruang berdimensi-n (n adalah jumlah fitur) dan kemudian jarak antar koordinat ini dihitung. Jika koordinat ini tidak dinormalkan, hasilnya bisa keliru.
Misalnya, anggap Anda memiliki data tentang tinggi dan berat tiga orang: A (6ft, 75kg), B (6ft, 77kg), C (8ft, 75kg). Jika Anda merepresentasikan fitur ini dalam sistem koordinat dua dimensi, tinggi dan berat, dan menghitung jarak Euclidean di antara mereka, jarak antara pasangan berikut adalah:
A-B : 2 unit
A-C : 2 unit
Metode jarak menyatakan bahwa kedua pasangan A-B dan A-C serupa, tetapi kenyataannya jelas tidak! Pasangan A-B lebih mirip daripada pasangan A-C. Karena itu penting untuk menskalakan nilai-nilai ini terlebih dahulu lalu menghitung jarak.
Ada berbagai cara untuk menormalkan nilai fitur; Anda bisa mempertimbangkan menstandarkan keseluruhan skala semua nilai fitur (x(i)) di antara [0,1] (dikenal sebagai normalisasi min-maks) dengan menerapkan transformasi berikut:
$ x(s) = x(i) - min(x)/(max(x) - min (x)) $
Anda dapat menggunakan fungsi normalize() di R untuk ini atau Anda bisa menulis fungsi sendiri seperti:
standardize <- function(x){(x-min(x))/(max(x)-min(x))}
Jenis penskalaan lain dapat dicapai melalui transformasi berikut:
$ x(s) = x(i)-mean(x) / sd(x) $
Di mana sd(x) adalah simpangan baku nilai fitur. Ini akan memastikan sebaran nilai fitur Anda memiliki mean 0 dan simpangan baku 1. Anda dapat mencapainya melalui fungsi scale() di R.
Penting juga untuk menangani nilai missing/null/inf dalam dataset Anda terlebih dahulu. Ada banyak cara untuk menangani nilai seperti itu, salah satunya adalah menghapusnya atau mengimputasinya dengan mean, median, modus atau menggunakan beberapa teknik regresi lanjutan. R memiliki banyak paket dan fungsi untuk menangani imputasi nilai hilang seperti impute(), Amelia, Mice, Hmisc, dan lain-lain. Anda dapat membaca tentang Amelia dalam tutorial ini.
Operasi kunci dalam clustering agglomerative hierarkis adalah berulang kali menggabungkan dua klaster terdekat menjadi klaster yang lebih besar. Ada tiga pertanyaan kunci yang perlu dijawab terlebih dahulu:
Semoga pada akhir tutorial ini Anda dapat menjawab semua pertanyaan tersebut. Sebelum menerapkan clustering hierarkis mari lihat cara kerjanya:
Ada beberapa cara untuk mengukur jarak antar klaster guna menentukan aturan clustering, yang sering disebut Metode Linkage. Beberapa metode linkage umum adalah:
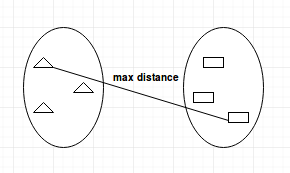
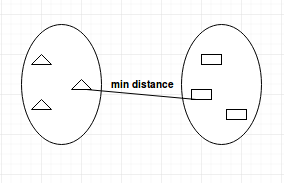
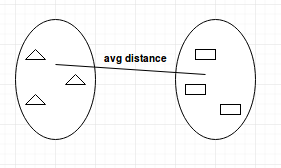
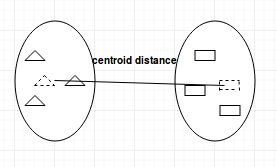
Pilihan metode linkage sepenuhnya bergantung pada Anda dan tidak ada metode baku yang selalu memberikan hasil baik. Metode linkage yang berbeda menghasilkan klaster yang berbeda.
Dalam clustering hierarkis, Anda mengategorikan objek ke dalam hierarki mirip diagram pohon yang disebut dendrogram. Jarak pemisahan atau penggabungan (disebut ketinggian/height) ditampilkan pada sumbu y dari dendrogram di bawah.
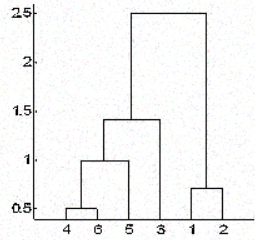
Pada gambar di atas, pertama 4 dan 6 digabung menjadi satu klaster, sebut saja klaster 1, karena jaraknya paling dekat diikuti oleh titik 1 dan 2, sebut klaster 2. Setelah itu 5 digabung ke klaster yang sama 1 diikuti oleh 3 sehingga menghasilkan dua klaster. Terakhir dua klaster tersebut digabung menjadi satu klaster dan di sinilah proses clustering berhenti.
Satu pertanyaan yang mungkin muncul sekarang adalah bagaimana Anda memutuskan kapan harus berhenti menggabungkan klaster? Itu bergantung pada pengetahuan domain yang Anda miliki tentang data. Misalnya jika Anda melakukan clustering pemain sepak bola di lapangan berdasarkan posisi mereka di lapangan yang merepresentasikan koordinat untuk perhitungan jarak, Anda sudah tahu bahwa Anda harus berakhir dengan hanya 2 klaster karena hanya ada dua tim yang bermain dalam satu pertandingan sepak bola.
Tetapi terkadang Anda tidak memiliki informasi itu juga. Dalam kasus seperti itu, Anda dapat memanfaatkan hasil dari dendrogram untuk memperkirakan jumlah klaster. Anda memotong pohon dendrogram dengan garis horizontal pada ketinggian di mana garis tersebut dapat melintasi jarak maksimum ke atas dan ke bawah tanpa berpotongan dengan titik penggabungan. Pada kasus di atas, tingginya antara 1,5 dan 2,5 seperti ditunjukkan:
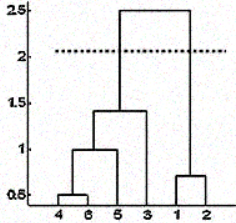
Jika Anda membuat potongan seperti yang ditunjukkan, Anda akan berakhir dengan hanya dua klaster.
Catatan bahwa tidak wajib memotong hanya di tempat seperti itu; Anda dapat memilih titik mana pun sebagai titik potong tergantung pada berapa banyak klaster yang Anda inginkan. Misalnya, potongan di bawah 1,5 dan di atas 1 akan menghasilkan 3 klaster.
Catatan ini bukan aturan baku untuk menentukan jumlah klaster. Anda juga dapat mempertimbangkan plot seperti Silhouette plot, elbow plot, atau beberapa ukuran numerik seperti indeks Dunn, gamma Hubert, dll. yang menunjukkan variasi galat terhadap jumlah klaster (k), dan Anda memilih nilai k di mana galatnya paling kecil.
Mungkin bagian terpenting dalam tugas pembelajaran tanpa pengawasan apa pun adalah analisis hasil. Setelah Anda melakukan clustering menggunakan algoritme apa pun dan serangkaian parameter apa pun, Anda perlu memastikan bahwa Anda melakukannya dengan benar. Lalu bagaimana menentukannya?
Ada banyak ukuran untuk ini, mungkin yang paling populer adalah Indeks Dunn. Indeks Dunn adalah rasio antara jarak antarklaster minimum terhadap diameter intraklaster maksimum. Diameter klaster adalah jarak antara dua titik terjauhnya. Untuk mendapatkan klaster yang terpisah baik dan kompak, Anda sebaiknya menargetkan nilai Indeks Dunn yang lebih tinggi.
Sekarang Anda akan menerapkan pengetahuan yang telah diperoleh untuk menyelesaikan masalah dunia nyata.
Anda akan menerapkan clustering hierarkis pada dataset seeds. Dataset ini terdiri dari pengukuran properti geometris kernel yang termasuk dalam tiga varietas gandum: Kama, Rosa, dan Canadian. Dataset memiliki variabel yang menggambarkan properti benih seperti area, keliling, koefisien asimetri, dan sebagainya. Ada 70 observasi untuk setiap varietas gandum. Anda dapat menemukan detail tentang dataset tersebut di sini.
Mulailah dengan mengimpor dataset ke dalam dataframe dengan fungsi read.csv().
Catatan bahwa berkas ini tidak memiliki header dan dipisahkan dengan tab. Untuk menjaga reprodusibilitas hasil, Anda perlu menggunakan fungsi set.seed().
set.seed(786)
file_loc <- 'seeds.txt'
seeds_df <- read.csv(file_loc,sep = '\t',header = FALSE)
Karena dataset tidak memiliki nama kolom, Anda akan memberikan nama kolom sendiri dari deskripsi data.
feature_name <- c('area','perimeter','compactness','length.of.kernel','width.of.kernal','asymmetry.coefficient','length.of.kernel.groove','type.of.seed')
colnames(seeds_df) <- feature_name
Sebaiknya kumpulkan beberapa informasi dasar yang berguna tentang dataset seperti dimensinya, tipe data dan distribusinya, jumlah NA, dan sebagainya. Anda akan melakukannya dengan menggunakan fungsi str(), summary() dan is.na() di R.
str(seeds_df)
summary(seeds_df)
any(is.na(seeds_df))
Perhatikan bahwa dataset ini memiliki semua kolom sebagai nilai numerik. Tidak ada nilai hilang dalam dataset ini yang perlu Anda bersihkan sebelum clustering. Namun, skala fiturnya berbeda dan perlu Anda normalkan. Selain itu, data diberi label dan Anda sudah memiliki informasi tentang observasi mana yang termasuk ke varietas gandum mana.
Sekarang Anda akan menyimpan label dalam variabel terpisah dan mengecualikan kolom type.of.seed dari dataset untuk melakukan clustering. Nantinya Anda akan menggunakan label sebenarnya untuk memeriksa seberapa baik hasil clustering Anda.
seeds_label <- seeds_df$type.of.seed
seeds_df$type.of.seed <- NULL
str(seeds_df)
Seperti yang akan Anda lihat, Anda telah menghapus kolom label sebenarnya dari dataset.
Sekarang Anda akan menggunakan fungsi scale() di R untuk menskalakan semua nilai kolom Anda.
seeds_df_sc <- as.data.frame(scale(seeds_df))
summary(seeds_df_sc)
Perhatikan mean semua kolom adalah 0 dan simpangan bakunya 1. Setelah prapemrosesan data selesai, saatnya membangun matriks jarak. Karena semua nilainya di sini adalah nilai numerik kontinu, Anda akan menggunakan metode jarak euclidean.
dist_mat <- dist(seeds_df_sc, method = 'euclidean')Pada titik ini Anda harus memutuskan metode linkage yang ingin digunakan dan melanjutkan ke clustering hierarkis. Anda dapat mencoba semua jenis metode linkage dan kemudian memutuskan mana yang kinerjanya lebih baik. Di sini Anda akan melanjutkan dengan metode linkage average.
Anda akan membangun dendrogram dengan memplot objek klaster hierarkis yang akan Anda bangun dengan hclust(). Anda dapat menentukan metode linkage melalui argumen method.
hclust_avg <- hclust(dist_mat, method = 'average')
plot(hclust_avg)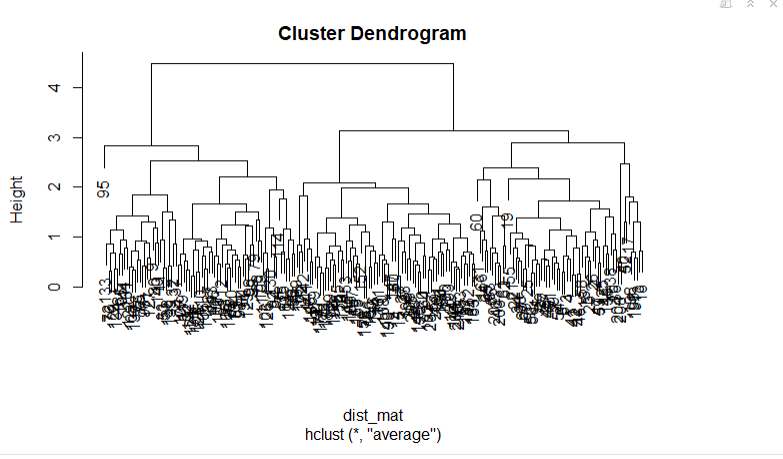
Perhatikan bagaimana dendrogram dibangun dan setiap titik data akhirnya bergabung menjadi satu klaster dengan ketinggian (jarak) ditampilkan pada sumbu y.
Selanjutnya, Anda dapat memotong dendrogram untuk membuat jumlah klaster yang diinginkan. Karena dalam kasus ini Anda sudah tahu bahwa hanya ada tiga jenis gandum, Anda akan memilih jumlah klaster k = 3, atau seperti yang dapat Anda lihat pada dendrogram h = 3 Anda mendapatkan tiga klaster. Anda akan menggunakan fungsi cutree() di R untuk memotong pohon dengan hclust_avg sebagai salah satu parameter dan parameter lain sebagai h = 3 atau k = 3.
cut_avg <- cutree(hclust_avg, k = 3)Jika Anda ingin melihat klaster secara visual pada dendrogram, Anda dapat menggunakan fungsi abline() di R untuk menggambar garis potong dan menumpangkan kompartemen berbentuk persegi panjang untuk setiap klaster pada pohon dengan fungsi rect.hclust() seperti pada kode berikut:
plot(hclust_avg)
rect.hclust(hclust_avg , k = 3, border = 2:6)
abline(h = 3, col = 'red')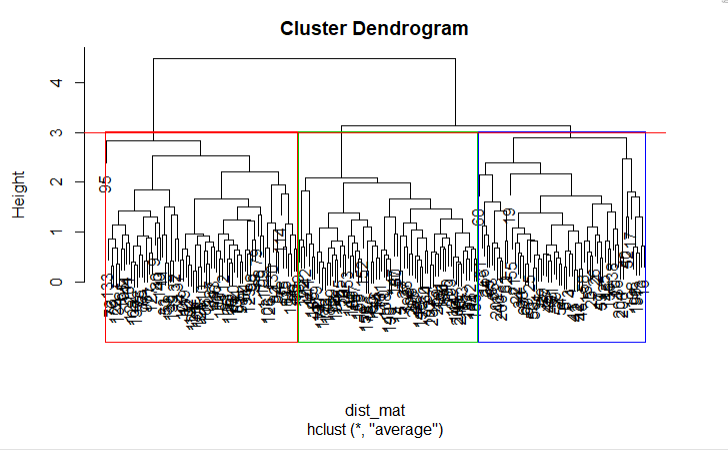
Sekarang Anda dapat melihat tiga klaster yang tertutup dalam tiga kotak berwarna berbeda. Anda juga dapat menggunakan fungsi color_branches() dari pustaka dendextend untuk memvisualisasikan pohon Anda dengan cabang berwarna berbeda.
Ingat bahwa Anda dapat memasang paket di R menggunakan perintah install.packages('package_name', dependencies = TRUE).
suppressPackageStartupMessages(library(dendextend))
avg_dend_obj <- as.dendrogram(hclust_avg)
avg_col_dend <- color_branches(avg_dend_obj, h = 3)
plot(avg_col_dend)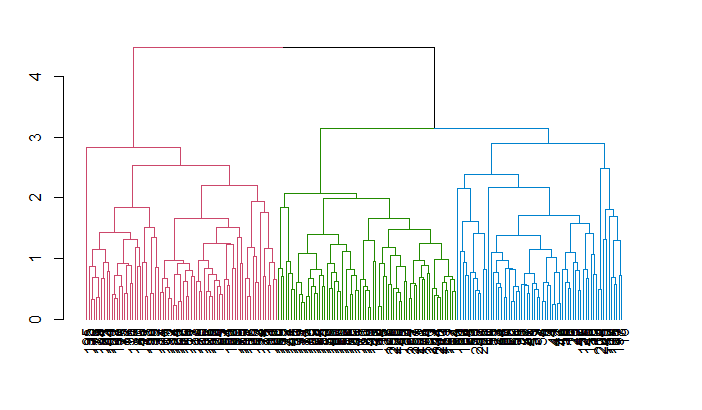
Sekarang Anda akan menambahkan kembali hasil klaster yang diperoleh ke dataframe asli pada nama kolom cluster dengan mutate() dari paket dplyr dan menghitung berapa banyak observasi yang ditetapkan ke setiap klaster dengan fungsi count().
suppressPackageStartupMessages(library(dplyr))
seeds_df_cl <- mutate(seeds_df, cluster = cut_avg)
count(seeds_df_cl,cluster)
Anda akan dapat melihat berapa banyak observasi yang ditetapkan di setiap klaster. Perhatikan bahwa pada kenyataannya dari data berlabel Anda memiliki 70 observasi untuk setiap varietas gandum.
Umum untuk mengevaluasi tren antara dua fitur berdasarkan clustering yang Anda lakukan guna mengekstrak wawasan yang lebih berguna dari data per klaster. Sebagai latihan, Anda dapat menganalisis tren antara perimeter dan area gandum per klaster dengan bantuan paket ggplot2.
suppressPackageStartupMessages(library(ggplot2))
ggplot(seeds_df_cl, aes(x=area, y = perimeter, color = factor(cluster))) + geom_point()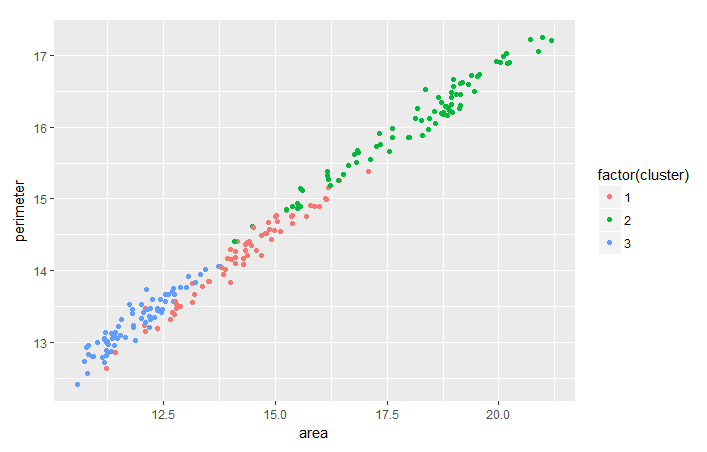
Perhatikan bahwa untuk semua varietas gandum tampaknya ada hubungan linear antara keliling dan areanya.
Karena Anda sudah memiliki label sebenarnya untuk dataset ini, Anda juga dapat mempertimbangkan memeriksa ulang hasil clustering Anda menggunakan fungsi table().
table(seeds_df_cl$cluster,seeds_label)Jika Anda melihat tabel yang dihasilkan, Anda jelas melihat tiga grup dengan 55 elemen atau lebih. Secara keseluruhan, Anda dapat mengatakan bahwa klaster Anda cukup merepresentasikan berbagai jenis benih karena awalnya Anda memiliki 70 observasi untuk setiap varietas gandum. Grup yang lebih besar merepresentasikan kesesuaian antara klaster dan jenis sebenarnya.
Catatan bahwa dalam banyak kasus Anda sebenarnya tidak memiliki label sebenarnya. Dalam kasus tersebut, seperti yang telah dibahas, Anda dapat menggunakan ukuran lain seperti memaksimalkan Indeks Dunn. Anda dapat menghitung indeks dunn dengan menggunakan fungsi dunn() dari pustaka clValid. Selain itu, Anda dapat mempertimbangkan melakukan validasi silang atas hasil dengan membuat set train dan test, seperti yang Anda lakukan pada algoritme machine learning lainnya, lalu melakukan clustering saat Anda memang memiliki label sebenarnya.
Anda mungkin pernah mendengar tentang algoritme clustering k-means; jika belum, lihat tutorial ini. Ada banyak perbedaan mendasar antara kedua algoritme, meskipun salah satunya bisa berkinerja lebih baik daripada yang lain dalam kasus yang berbeda. Beberapa perbedaannya adalah:
Selamat! Anda telah sampai di akhir tutorial ini. Anda mempelajari cara memproses data awal, dasar-dasar clustering hierarkis serta metrik jarak dan metode linkage yang digunakan beserta penerapannya di R. Anda juga mengetahui bagaimana clustering hierarkis berbeda dari algoritme k-means. Kerja bagus! Namun selalu ada lebih banyak hal untuk dipelajari. Saya sarankan Anda melihat kursus Unsupervised Learning in R kami.
Terus Belajar
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



