Cursus
Clusteranalyse in R
4 uur
44.4K
Er zijn een paar dingen waar je vooraf op moet letten.
Het is essentieel dat je de schaal van featurewaarden normaliseert voordat je met het clusteringsproces begint. Dit komt doordat de featurewaarden van elke observatie worden weergegeven als coördinaten in een n-dimensionale ruimte (n is het aantal features) en vervolgens de afstanden tussen deze coördinaten worden berekend. Als deze coördinaten niet zijn genormaliseerd, kan dit tot foutieve resultaten leiden.
Stel bijvoorbeeld dat je gegevens hebt over lengte en gewicht van drie personen: A (6 ft, 75 kg), B (6 ft, 77 kg), C (8 ft, 75 kg). Als je deze features weergeeft in een tweedimensionaal coördinatensysteem (lengte en gewicht) en de euclidische afstand daartussen berekent, dan zijn de afstanden tussen de volgende paren:
A-B : 2 eenheden
A-C : 2 eenheden
Het afstandscriterium zegt dus dat de paren A-B en A-C vergelijkbaar zijn, maar in werkelijkheid is dat duidelijk niet zo! Het paar A-B lijkt meer op elkaar dan het paar A-C. Daarom is het belangrijk om deze waarden eerst te schalen en dan pas de afstand te berekenen.
Er zijn verschillende manieren om de featurewaarden te normaliseren. Je kunt bijvoorbeeld de hele schaal van alle featurewaarden (x(i)) standaardiseren tussen [0,1] (bekend als min-max-normalisatie) door de volgende transformatie toe te passen:
$ x(s) = x(i) - min(x)/(max(x) - min (x)) $
Je kunt hiervoor de normalize()-functie van R gebruiken, of je kunt je eigen functie schrijven zoals:
standardize <- function(x){(x-min(x))/(max(x)-min(x))}
Een ander type schaling kan worden bereikt via de volgende transformatie:
$ x(s) = x(i)-mean(x) / sd(x) $
Waar sd(x) de standaarddeviatie van de featurewaarden is. Dit zorgt ervoor dat je verdeling van featurewaarden een gemiddelde van 0 en een standaarddeviatie van 1 heeft. Dit kun je bereiken met de scale()-functie in R.
Het is ook belangrijk om vooraf om te gaan met missende/null/inf-waarden in je dataset. Er zijn veel manieren om met zulke waarden om te gaan: je kunt ze verwijderen, imputeren met gemiddelde, mediaan of modus, of geavanceerde regressietechnieken gebruiken. R heeft veel pakketten en functies voor het imputeren van missende waarden, zoals impute(), Amelia, Mice, Hmisc, enz. Je kunt over Amelia lezen in deze tutorial.
De sleutelbewerking in hiërarchische agglomeratieve clustering is het herhaaldelijk samenvoegen van de twee dichtstbijzijnde clusters tot een groter cluster. Er zijn drie kernvragen die eerst beantwoord moeten worden:
Hopelijk kun je aan het einde van deze tutorial al deze vragen beantwoorden. Laten we, voordat we hiërarchische clustering toepassen, even naar de werking kijken:
Er zijn verschillende manieren om de afstand tussen clusters te meten om de regels voor clustering te bepalen; dit worden vaak Linkage-methoden genoemd. Enkele veelgebruikte linkage-methoden zijn:
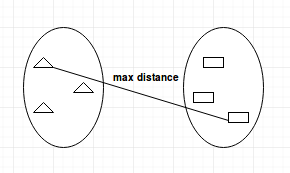
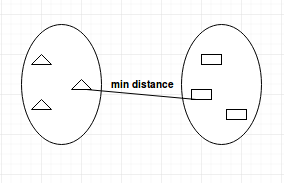
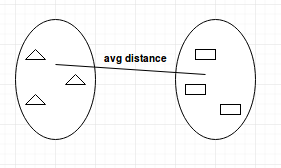
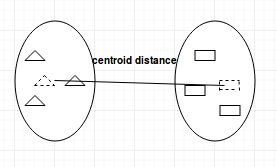
De keuze van de linkage-methode hangt volledig van jou af en er is geen harde regel die altijd goede resultaten geeft. Verschillende linkage-methoden leiden tot verschillende clusters.
Bij hiërarchische clustering categoriseer je objecten in een hiërarchie, vergelijkbaar met een boomdiagram, dat een dendrogram wordt genoemd. De afstand van splitsing of samenvoeging (de hoogte) wordt op de y-as van het dendrogram hieronder weergegeven.
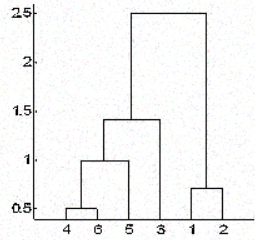
In de bovenstaande figuur worden eerst 4 en 6 samengevoegd tot één cluster, zeg cluster 1, omdat ze het dichtst bij elkaar lagen, gevolgd door punten 1 en 2, zeg cluster 2. Daarna werd 5 in hetzelfde cluster 1 samengevoegd, gevolgd door 3, resulterend in twee clusters. Tot slot worden de twee clusters samengevoegd tot één cluster en daar stopt het clusteringsproces.
Een vraag die je nu misschien bezighoudt: hoe beslis je wanneer je moet stoppen met het samenvoegen van clusters? Dat hangt af van je domeinkennis over de data. Als je bijvoorbeeld voetballers op het veld clustert op basis van hun posities op het veld, die hun coördinaten voor de afstandsberekening representeren, weet je al dat je moet eindigen met slechts 2 clusters, omdat er maar twee teams aan een voetbalwedstrijd meedoen.
Maar soms heb je die informatie niet. In zulke gevallen kun je de resultaten van het dendrogram gebruiken om het aantal clusters te benaderen. Je snijdt de dendrogramboom met een horizontale lijn op een hoogte waar de lijn de maximale afstand omhoog en omlaag kan afleggen zonder het samenvoegpunt te kruisen. In het bovenstaande geval zou dat tussen hoogtes 1,5 en 2,5 zijn, zoals getoond:
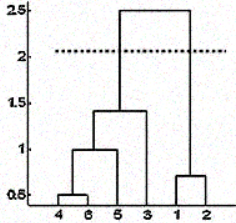
Als je de snede maakt zoals getoond, eindig je met slechts twee clusters.
Let op dat het niet noodzakelijk is om alleen op zulke plekken te snijden; je kunt elk punt kiezen als snijpunt, afhankelijk van hoeveel clusters je wilt. Een snede onder 1,5 en boven 1 levert bijvoorbeeld 3 clusters op.
Let op dit is geen harde regel om het aantal clusters te bepalen. Je kunt ook grafieken overwegen zoals de Silhouette-plot, de elbow-plot, of numerieke maten zoals Dunn's index, Hubert's gamma, enz., die de variatie van de fout laten zien bij een bepaald aantal clusters (k), waarna je de k kiest waarbij de fout het kleinst is.
Misschien wel het belangrijkste onderdeel van elke unsupervised learning-taak is de analyse van de resultaten. Nadat je clustering hebt uitgevoerd met welk algoritme en welke parameters dan ook, moet je zeker weten dat je het goed hebt gedaan. Maar hoe bepaal je dat?
Er zijn veel maten hiervoor; wellicht de populairste is de Dunn's Index. Dunn's index is de verhouding tussen de minimale afstanden tussen clusters en de maximale intra-clusterdiameter. De diameter van een cluster is de afstand tussen de twee verste punten ervan. Om goed gescheiden en compacte clusters te hebben, moet je streven naar een hogere Dunn's index.
Nu ga je de opgedane kennis toepassen om een realistisch probleem op te lossen.
Je past hiërarchische clustering toe op de seeds-dataset. Deze dataset bevat metingen van geometrische eigenschappen van korrels die behoren tot drie verschillende tarwevariëteiten: Kama, Rosa en Canadian. Hij heeft variabelen die de eigenschappen van zaden beschrijven, zoals oppervlakte, omtrek, asymmetriecoëfficiënt, enz. Er zijn 70 observaties per tarwevariëteit. Je vindt de details over de dataset hier.
Begin met het importeren van de dataset in een dataframe met de read.csv()-functie.
Let op dat het bestand geen headers heeft en tab-gescheiden is. Om de reproduceerbaarheid van de resultaten te waarborgen, moet je de set.seed()-functie gebruiken.
set.seed(786)
file_loc <- 'seeds.txt'
seeds_df <- read.csv(file_loc,sep = '\t',header = FALSE)
Aangezien de dataset geen kolomnamen heeft, geef je de kolommen zelf namen op basis van de beschrijving van de data.
feature_name <- c('area','perimeter','compactness','length.of.kernel','width.of.kernal','asymmetry.coefficient','length.of.kernel.groove','type.of.seed')
colnames(seeds_df) <- feature_name
Het is raadzaam om eerst wat basisinformatie over de dataset te verzamelen, zoals de dimensies, datatypen en verdelingen, aantal NA's, enz. Dat doe je met de functies str(), summary() en is.na() in R.
str(seeds_df)
summary(seeds_df)
any(is.na(seeds_df))
Merk op dat deze dataset alle kolommen als numerieke waarden heeft. Er zijn geen missende waarden die je vooraf moet opschonen voor clustering. Maar de schalen van de features verschillen en die moet je normaliseren. Ook is de data gelabeld en heb je al informatie over welke observatie bij welke tarwevariëteit hoort.
Je slaat nu de labels op in een aparte variabele en sluit de kolom type.of.seed uit van je dataset om te clusteren. Later gebruik je de ware labels om te controleren hoe goed je clustering is gelukt.
seeds_label <- seeds_df$type.of.seed
seeds_df$type.of.seed <- NULL
str(seeds_df)
Zoals je ziet, heb je de kolom met de ware labels uit je dataset verwijderd.
Nu gebruik je de scale()-functie van R om alle kolomwaarden te schalen.
seeds_df_sc <- as.data.frame(scale(seeds_df))
summary(seeds_df_sc)
Let op: het gemiddelde van alle kolommen is 0 en de standaarddeviatie is 1. Nu je je data hebt voorbewerkt, is het tijd om de afstandsmatrix te bouwen. Aangezien hier alle waarden continue numerieke waarden zijn, gebruik je de euclidean-afstandsmethode.
dist_mat <- dist(seeds_df_sc, method = 'euclidean')Op dit punt moet je beslissen welke linkage-methode je wilt gebruiken en doorgaan met hiërarchische clustering. Je kunt allerlei linkage-methoden proberen en later beslissen welke beter presteerde. Hier ga je verder met de average-linkage-methode.
Je bouwt je dendrogram door het hiërarchische clusterobject te plotten dat je bouwt met hclust(). Je kunt de linkage-methode opgeven via het argument method.
hclust_avg <- hclust(dist_mat, method = 'average')
plot(hclust_avg)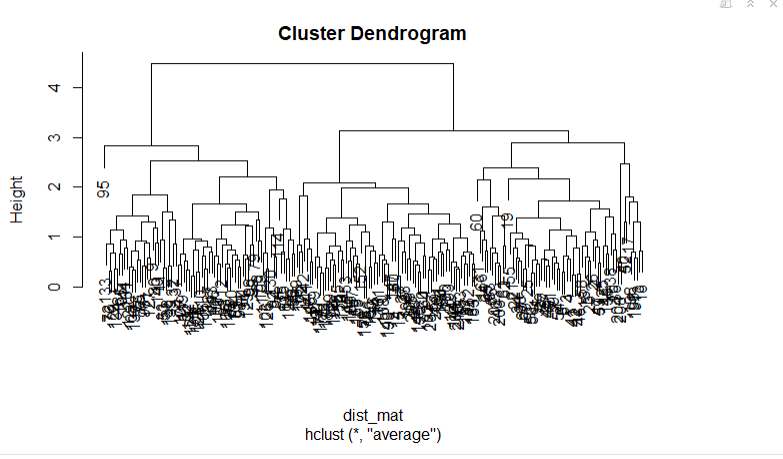
Let op hoe het dendrogram is opgebouwd en elk datapunt uiteindelijk samenkomt in één cluster, met de hoogte (afstand) weergegeven op de y-as.
Vervolgens kun je het dendrogram doorsnijden om het gewenste aantal clusters te maken. Aangezien je in dit geval al weet dat er slechts drie soorten tarwe kunnen zijn, kies je het aantal clusters k = 3, of zoals je in het dendrogram ziet, bij h = 3 krijg je drie clusters. Je gebruikt de cutree()-functie van R om de boom te snijden met hclust_avg als de ene parameter en de andere parameter als h = 3 of k = 3.
cut_avg <- cutree(hclust_avg, k = 3)Als je de clusters visueel op het dendrogram wilt zien, kun je met de abline()-functie van R de snijlijn tekenen en met de rect.hclust()-functie rechthoekige vakken voor elk cluster over de boom leggen, zoals in de volgende code:
plot(hclust_avg)
rect.hclust(hclust_avg , k = 3, border = 2:6)
abline(h = 3, col = 'red')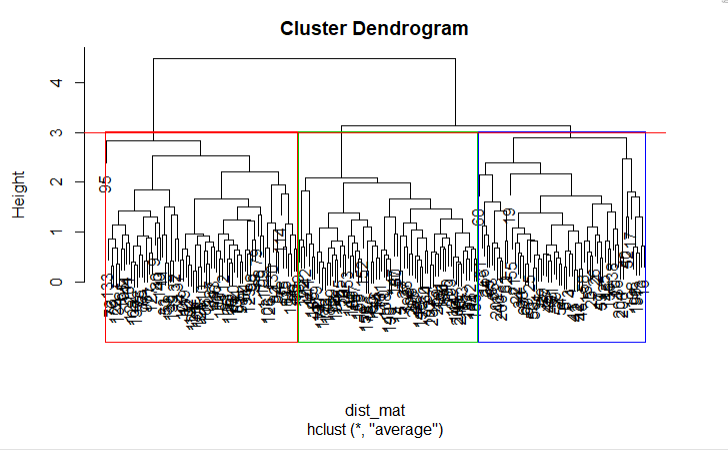
Nu zie je de drie clusters, elk omsloten door een anders gekleurd vak. Je kunt ook de color_branches()-functie uit de dendextend-bibliotheek gebruiken om je boom te visualiseren met verschillend gekleurde takken.
Onthoud dat je een pakket in R kunt installeren met het commando install.packages('package_name', dependencies = TRUE).
suppressPackageStartupMessages(library(dendextend))
avg_dend_obj <- as.dendrogram(hclust_avg)
avg_col_dend <- color_branches(avg_dend_obj, h = 3)
plot(avg_col_dend)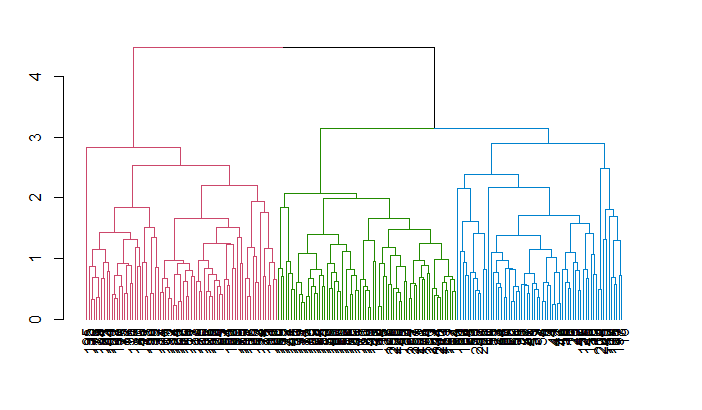
Nu voeg je de verkregen clusterresultaten terug toe aan het oorspronkelijke dataframe onder de kolomnaam cluster met mutate() uit het dplyr-pakket en tel je met de functie count() hoeveel observaties aan elk cluster zijn toegewezen.
suppressPackageStartupMessages(library(dplyr))
seeds_df_cl <- mutate(seeds_df, cluster = cut_avg)
count(seeds_df_cl,cluster)
Je ziet dan hoeveel observaties aan elk cluster zijn toegewezen. Merk op dat je in werkelijkheid op basis van de gelabelde data 70 observaties per tarwevariëteit had.
Het is gebruikelijk om de relatie tussen twee features te evalueren op basis van de clustering die je hebt gedaan, om zo per cluster meer nuttige inzichten uit de data te halen. Als oefening kun je de relatie tussen de perimeter en de area van tarwe per cluster analyseren met behulp van het pakket ggplot2.
suppressPackageStartupMessages(library(ggplot2))
ggplot(seeds_df_cl, aes(x=area, y = perimeter, color = factor(cluster))) + geom_point()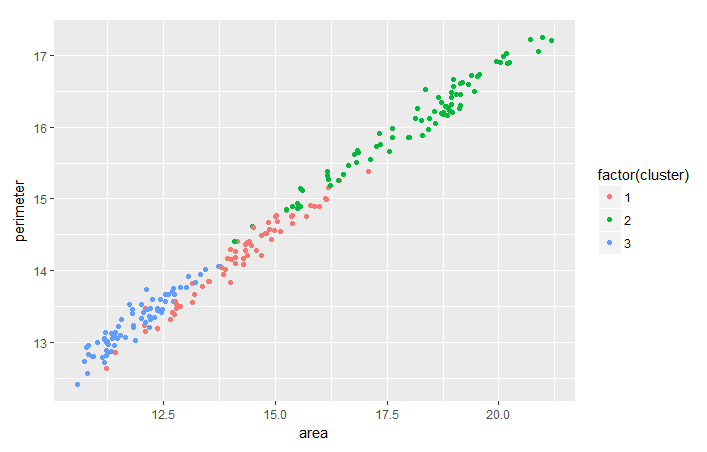
Merk op dat er voor alle tarwevariëteiten een lineaire relatie lijkt te zijn tussen hun omtrek en oppervlakte.
Aangezien je de ware labels voor deze dataset al hebt, kun je je clusteringsresultaten ook kruisgewijs controleren met de functie table().
table(seeds_df_cl$cluster,seeds_label)Als je naar de gegenereerde tabel kijkt, zie je duidelijk drie groepen met 55 elementen of meer. Over het geheel genomen kun je zeggen dat je clusters de verschillende soorten zaden adequaat vertegenwoordigen, omdat je oorspronkelijk 70 observaties per tarwevariëteit had. De grotere groepen geven de correspondentie weer tussen de clusters en de werkelijke typen.
Let op dat je in veel gevallen de ware labels niet hebt. In die gevallen kun je, zoals al besproken, andere maten gebruiken, zoals het maximaliseren van Dunn's index. Je kunt de dunn's-index berekenen met de functie dunn() uit de clValid-bibliotheek. Ook kun je overwegen om de resultaten te valideren door train- en testsets te maken, net zoals bij andere machine learning-algoritmen, en vervolgens te clusteren wanneer je de ware labels wel hebt.
Je hebt misschien al gehoord van het k-means clustering-algoritme; zo niet, bekijk dan deze tutorial. Er zijn veel fundamentele verschillen tussen beide algoritmen, hoewel het ene in sommige gevallen beter kan presteren dan het andere. Enkele verschillen zijn:
Gefeliciteerd! Je bent aan het einde van deze tutorial gekomen. Je leerde hoe je je data voorbewerkt, de basis van hiërarchische clustering, de afstandsmetriek en linkage-methoden waarop het werkt, en hoe je dit in R gebruikt. Je weet ook hoe hiërarchische clustering verschilt van het k-means-algoritme. Goed gedaan! Maar er valt altijd meer te leren. Ik raad je aan om onze cursus Unsupervised Learning in R te bekijken.
Blijf leren
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

