
Lewati ke konten utama

10 Model Generasi Video Terbaik Tahun 2026

Model generasi video open-source dan proprietari berperingkat teratas yang mendefinisikan ulang kreativitas di dunia sinema, periklanan, dan pembuatan konten.
Diperbarui 28 Sep 2026  · 9 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Saya pertama kali mengenal model generasi video ketika OpenAI meluncurkan iterasi pertama Sora. Sejak saat itu, saya mulai menemukan banyak model generasi video kelas atas. Hal ini menginspirasi saya untuk menyusun daftar model terbaik yang tersedia. Peringkat ini didasarkan pada pengalaman pribadi saya, papan peringkat Artificial Analysis video generation, dan masukan pengguna secara keseluruhan.

Generasi video mirip dengan generasi gambar, tetapi dengan batasan tambahan: waktu. Setiap frame harus tetap konsisten dengan frame sebelumnya, menjaga identitas karakter, pencahayaan, pergerakan kamera, dan tata letak adegan, untuk mempertahankan koherensi temporal. 

Sistem modern melampaui text-to-video: Anda dapat menganimasikan satu gambar dalam gaya Anda sendiri, menyambung shot menjadi urutan yang lebih panjang, dan bahkan menghasilkan audio tersinkron (musik, SFX, dialog) dari prompt, menghasilkan klip sinematik end-to-end.

Dalam blog ini, kita akan menjelajahi beberapa model generasi video berperingkat teratas yang mengubah dunia pemasaran, sinema, periklanan, dan pembuatan konten, membuka kemungkinan kreatif baru di berbagai industri.
Gambar oleh Penulis | Canva + Google Nano Banana

Apa itu Model Generasi Video?

Model generasi video adalah sistem AI yang membuat gambar bergerak dari masukan seperti teks, gambar, atau video yang ada. Model ini dibangun di atas metode text-to-image dengan menggabungkan elemen waktu. Selain memastikan realisme dan kepatuhan pada prompt, model-model ini juga harus mempertahankan gerakan yang mulus, kontinuitas subjek, dan koherensi dari frame ke frame. 
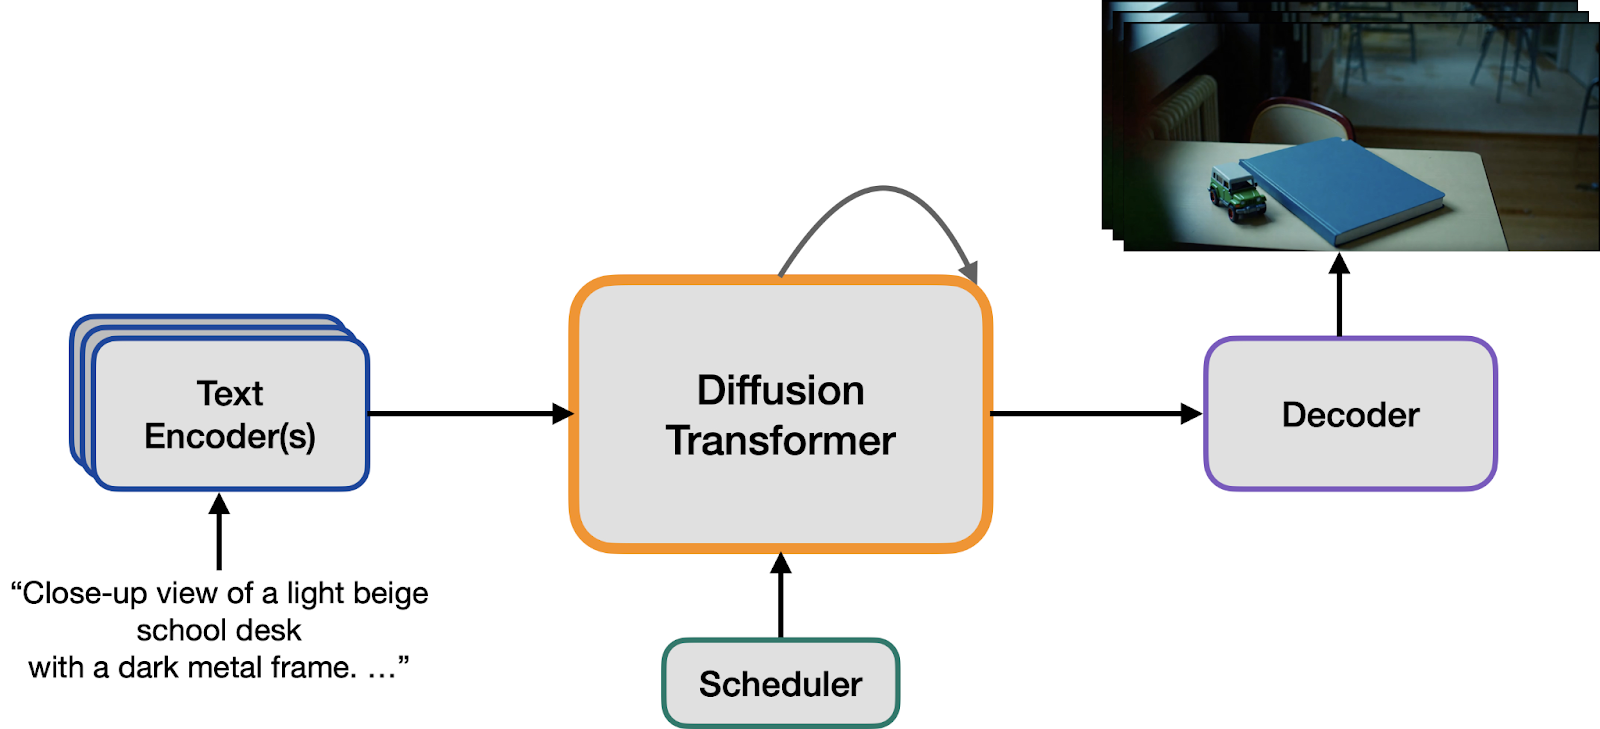
text-to-video diagram of video diffusion model

Gambar dari State of open video generation models in Diffusers

Model generasi video bekerja dengan mengubah prompt teks menjadi representasi terstruktur menggunakan encoder teks, lalu memulai dari noise acak dan menyempurnakannya selangkah demi selangkah melalui jaringan denoising. Sebuah scheduler memandu proses ini, sementara encoder dan decoder bergerak antara ruang piksel dan ruang laten terkompresi demi efisiensi. Tidak seperti model gambar, model video memproses token 3D yang menangkap detail spasial dan gerakan temporal. Karena proses decoding membutuhkan banyak memori, banyak pipeline menggunakan decoding per frame untuk membuat generasi lebih efisien.

1. Veo 3

Veo 3 adalah model generasi video tercanggih dari Google, menghasilkan klip 8 detik berkualitas tinggi pada 720p atau 1080p (16:9) dengan audio native yang selalu aktif pada 24fps. Tersedia melalui Gemini API, model ini unggul dalam adegan berbasis dialog, realisme sinematik, dan animasi kreatif, menangkap dialog kutipan, efek suara eksplisit, dan lanskap suara ambient langsung dari prompt Anda.

Veo 3 menerjemahkan prompt teks menjadi shot sinematik dengan pencahayaan yang koheren, depth-of-field, dan warna bergaya film, sambil menjaga konsistensi temporal dari frame ke frame. Model ini secara native merender dialog, SFX, dan ambience yang tersinkron, memungkinkan ucapan selaras bibir, akustik yang sesuai adegan, dan isyarat waktu yang tepat untuk meningkatkan realisme.

2. Sora 2

Sora 2 adalah sistem text-to-video serbaguna yang kini menghasilkan audio tersinkron bersama visual, termasuk dialog, suara ambient, dan efek suara, semuanya dalam satu kali proses. Kemajuan ini menjembatani celah besar dalam alur kerja sebelumnya dan memungkinkan penceritaan yang lebih padu di berbagai shot.

Selain audio, model ini berfokus pada pembuatan adegan yang lebih realistis, meningkatkan kelayakan fisik (seperti berat, keseimbangan, kekekalan objek, dan hubungan sebab-akibat), serta meningkatkan kontinuitas di berbagai shot (memastikan konsistensi karakter, pencahayaan, dan keadaan dunia secara keseluruhan). Model ini juga menyediakan opsi gaya yang fleksibel, mendukung estetika fotorealistik, sinematik, dan animasi.

Selain itu, Sora 2 memperkenalkan kemampuan canggih untuk mensimulasikan kegagalan, seperti lompatan yang meleset atau tergelincir, yang berguna untuk prapvisualisasi dan konsep terkait keselamatan. 

3. PixVerse V5

PixVerse V5 adalah peningkatan besar dibanding V4.5, memadukan generasi text-to-video dan image-to-video yang lebih cepat dengan visual yang lebih tajam dan sinematik. Model ini menghadirkan gerakan yang halus dan ekspresif, gaya dan warna yang stabil, serta kepatuhan kuat pada prompt sehingga arahan Anda tersaji dengan bersih di layar.

PixVerse V5 berfokus pada realisme melalui tiga pilar: gerakan, konsistensi, dan detail. Pergerakan kamera yang lebih mulus dan animasi yang alami serta berbobot mengurangi kekakuan yang terlihat pada versi sebelumnya, sementara konsistensi temporal menjaga gaya, warna, dan subjek tetap koheren di seluruh frame untuk aliran bak film yang padu. Hasilnya adalah gambar yang tajam dan sinematik yang oleh banyak kreator digambarkan sebagai “layak film,” dengan kepatuhan prompt yang andal untuk gaya, nada, dan subjek. 

4. Kling 2.5 Turbo

Kling 2.5 Turbo adalah peningkatan terbaru dalam rangkaian generasi video AI Kling, dibangun untuk kecepatan tingkat lanjut dan kebebasan berkreasi. Model ini memajukan text‑to‑video dan image‑to‑video dengan kepatuhan prompt yang lebih kuat, kontrol kamera canggih, dan realisme yang menyadari fisika, sehingga arahan Anda diterjemahkan menjadi hasil sinematik dengan lebih sedikit iterasi dan jeda.

Kling 2.5 Turbo berfokus pada estetika setara film, menampilkan frame yang lebih tajam, pencahayaan seimbang, dan kedalaman warna yang kaya, memberikan kualitas sinematik yang terarah sejak awal. Kepatuhan prompt dan kontrol kamera yang ditingkatkan menerjemahkan naskah terperinci menjadi visual yang presisi, mengeksekusi pan, zoom, dan transisi dengan mulus sehingga terasa dibuat secara profesional.

Realisme ditingkatkan oleh gerakan yang menyadari fisika, menggabungkan elemen seperti gravitasi dan benturan bersama gerakan mirip fluida. Hal ini dilengkapi oleh ekspresi karakter yang lebih hidup, membuat aksi dan performa tampak meyakinkan di layar.

5. Hailuo 02

MiniMax Hailuo 02 adalah model generasi video generasi berikutnya yang dirancang untuk keluaran native 1080p. Model ini menampilkan kemampuan mengikuti instruksi tercanggih dan kecakapan luar biasa dalam fisika. Ditenagai oleh arsitektur baru bernama Noise-Aware Compute Redistribution (NCR), model ini mencapai efisiensi sekitar 2,5 kali pada skala parameter serupa.

Kemajuan ini memungkinkan model yang tiga kali lebih besar dan dilatih pada data empat kali lebih banyak dibanding pendahulunya, sekaligus menjaga biaya bagi kreator tetap tidak berubah. Hasilnya adalah sistem yang lebih cepat dan lebih mumpuni yang secara akurat menafsirkan prompt kompleks dan menghasilkan gerakan berkualitas tinggi

Hailuo 02 unggul dalam membuat adegan yang membutuhkan fisika realistis dan kontrol presisi. Misalnya, model ini dapat menangani koreografi setingkat senam di mana gerakan tubuh, distribusi berat, dan penentuan waktu semuanya harus terasa autentik. Skala pelatihan yang ditingkatkan dan efisiensi NCR menghasilkan frame yang lebih jelas, konsistensi temporal yang stabil, dan akurasi tinggi dalam mengikuti prompt, memastikan instruksi yang rumit dijalankan di layar dengan penyimpangan minimal.

6. Seedance 1.0

Seedance 1.0 adalah model generasi video berkualitas tinggi terbaru dari ByteDance, dirancang untuk menciptakan gerakan yang halus dan stabil sambil menggabungkan penceritaan multi-shot native. Model ini menangani alur kerja text-to-video (T2V) dan image-to-video (I2V) secara efektif.

Model ini memiliki rentang dinamis yang lebar, memungkinkan pergerakan berskala besar yang fluida sekaligus mempertahankan stabilitas dan realisme fisik. Model ini dapat menangkap segala hal mulai dari ekspresi halus hingga adegan yang sangat aktif.

Selain kemampuan gerakannya, Seedance 1.0 mendukung pembuatan video naratif multi-shot, memastikan konsistensi pada subjek utama, gaya, dan suasana keseluruhan selama transisi shot serta perubahan ruang dan waktu. Konsistensi ini penting untuk penceritaan yang padu dan alur produksi yang efisien.

Seedance 1.0 juga menawarkan ekspresi gaya yang beragam dan kontrol presisi. Model ini dapat mengelola interaksi multi-agen, urutan aksi yang kompleks, dan pergerakan kamera dinamis sambil secara akurat mengikuti prompt terperinci. Hal ini memungkinkan terjemahan teks ke video sinematik yang setia. Selain itu, model ini mendukung keluaran definisi tinggi, termasuk 1080p, memastikan gerakan yang mulus dan detail visual yang kuat yang berkontribusi pada tampilan bak film yang rapi dalam tugas T2V maupun I2V.

7. Wan2.2

Wan-AI/Wan2.2 adalah model generatif video skala besar yang canggih dan open-source. Membangun dari Wan 2.1, model ini menampilkan arsitektur difusi Mixture-of-Experts (MoE) yang secara efisien merutekan pakar khusus di sepanjang timestep denoising, memungkinkan kapasitas yang diperluas tanpa meningkatkan kebutuhan komputasi.

Bagian terbaiknya adalah model ini sepenuhnya terbuka, artinya tim Wan-AI merilis kode dan bobot untuk penggunaan praktis, termasuk model hibrida TI2V 5B dengan VAE kompresi tinggi (16×16×4) yang mendukung 720p pada 24fps untuk tugas text-to-video dan image-to-video di GPU konsumsi (misalnya 4090). Tersedia juga model A14B T2V/I2V untuk keluaran 480p dan 720p.

Wan2.2 menciptakan video dengan kontrol sinematik dan gerakan yang kompleks serta meyakinkan. Desain MoE mengalokasikan pakar noise tinggi untuk tata letak global tahap awal dan pakar noise rendah untuk tahap akhir yang detail. Kombinasi ini menghasilkan komposisi yang bersih, tekstur yang tajam, dan koherensi temporal yang stabil sehingga tampak realistis di layar. Label estetika terkurasi memungkinkan gaya visual yang presisi dan terkontrol, mencakup pencahayaan, color grading, dan pembingkaian. 

8. Mochi 1

genmo/mochi-1 adalah model generasi video canggih dan open-source yang menunjukkan gerakan berkualitas tinggi dan kepatuhan kuat pada prompt dalam evaluasi awal, secara signifikan mengurangi kesenjangan antara sistem tertutup dan yang terbuka.

Mochi 1 unggul dalam mengonversi prompt bahasa alami menjadi gerakan yang koheren dan sinematik, secara efektif menangkap maksud pengguna. Video yang dihasilkan terlihat rapi, terarah, dan sesuai dengan deskripsi yang diberikan. Dengan menjembatani kesenjangan kualitas dengan model tertutup terkemuka sekaligus tetap sepenuhnya terbuka dan berlisensi Apache, Mochi 1 memungkinkan peneliti, kreator, dan pengembang untuk bereksperimen, menyetel halus, dan mengintegrasikan teknologi text-to-video mutakhir ke dalam proyek nyata tanpa kendala ketat atau hambatan biaya.

9. LTX-Video

LTX-Video adalah sistem generasi video berlatih difusi (DiT) dari Lightricks, dikenal karena menghadirkan video berkualitas tinggi secara real time. Model ini menghasilkan 30 frame per detik (FPS) pada resolusi 1216×704, lebih cepat dari kecepatan pemutaran. Dilatih pada dataset video yang besar dan beragam, LTX‑Video berfokus pada konversi gambar menjadi video dengan pengondisian opsional menggunakan gambar dan klip pendek. 

Model ini menawarkan berbagai varian untuk menyeimbangkan kualitas dan biaya: model 13 miliar parameter untuk fidelitas tertinggi, varian distilled dan FP8 untuk penggunaan VRAM lebih rendah dan pemrosesan lebih cepat, serta opsi 2 miliar parameter untuk penyebaran ringan. Hasilnya adalah sistem yang praktis dan ramah kreator yang memadukan kecepatan dengan visual realistis beresolusi tinggi.

LTX‑Video mengubah gambar diam menjadi gerakan yang halus dan koheren pada 30 FPS, menampilkan tekstur yang tajam, subjek yang stabil, dan dinamika kamera yang meyakinkan, sehingga hasilnya terasa sengaja difilmkan alih-alih disintesis. Arsitektur DiT dan pelatihan yang luas berkontribusi pada konsistensi temporal serta konten yang beragam dan hidup, sementara prompt terperinci dalam bahasa Inggris memberi Anda kontrol gaya yang presisi.

10. Marey

Marey adalah model video AI dasar dari Moonvalley, yang dirancang khusus untuk memenuhi standar sinematografi kelas dunia. Model ini disesuaikan untuk pembuat film yang membutuhkan presisi pada setiap frame, menekankan kontrol, konsistensi, dan fidelitas. Hal ini memastikan visi kreatif Anda terwujud dengan setia dari konsep hingga final cut. Dari pengembangan tampilan hingga penyuntingan, Marey terintegrasi mulus ke dalam alur kerja profesional dan menghadirkan gambar berkualitas tinggi yang tahan terhadap pemeriksaan mendetail.

Marey mengubah arahan terperinci menjadi urutan yang presisi dan siap produksi, memastikan subjek yang stabil, pencahayaan konsisten, dan gerakan halus untuk kualitas sinematik. Dengan menekankan kontrol tingkat frame dan konsistensi temporal, model ini membantu menjaga tone, gaya, dan tempo di berbagai shot. Hal ini memungkinkan kreator untuk dengan percaya diri memproduksi trailer, adegan, dan kampanye.

Kesimpulan

Model generasi video berkembang pesat, dan para kreator di bidang periklanan, e-commerce, pemasaran, sinema, YouTube, dan penceritaan format pendek sudah menggunakannya. Manfaatnya sangat besar: iterasi lebih cepat, kualitas sinematik, dan kemungkinan kreatif baru yang sebelumnya sulit dijangkau. Namun, realisme yang dicapai sistem ini juga menyajikan risiko nyata, seperti iklan menyesatkan, penipuan produk, dan deepfake tokoh publik yang sangat meyakinkan. 

Saat kita memanfaatkan alat ini, penting untuk memasangkan inovasi dengan tanggung jawab. Ini berarti bersikap transparan tentang penggunaan AI, memverifikasi sumber, dan mematuhi pedoman etika serta hukum yang jelas. 

Dalam blog ini, kita telah menelusuri sepuluh model video terkemuka yang mengonversi teks dan gambar menjadi cuplikan yang sangat realistis, disertai demo YouTube untuk menunjukkan keunggulan masing-masing model. Saya juga menyoroti opsi open-source yang dapat Anda jalankan secara lokal, yang sangat baik untuk belajar, bereksperimen, dan menyetel hasil agar sesuai dengan merek atau cerita Anda.


Abid Ali Awan's photo
Author
Abid Ali Awan
LinkedIn
Twitter

Sebagai data scientist tersertifikasi, saya bersemangat memanfaatkan teknologi mutakhir untuk menciptakan aplikasi machine learning yang inovatif. Dengan latar belakang kuat di pengenalan ucapan, analisis dan pelaporan data, MLOps, conversational AI, dan NLP, saya mengasah keterampilan dalam mengembangkan sistem cerdas yang berdampak nyata. Selain keahlian teknis, saya juga komunikator andal yang mampu menyederhanakan konsep kompleks menjadi bahasa yang jelas dan ringkas. Karena itu, saya menjadi blogger yang dicari di bidang data science, membagikan wawasan dan pengalaman kepada komunitas profesional data yang terus berkembang. Saat ini, saya berfokus pada pembuatan dan penyuntingan konten, bekerja dengan large language model untuk mengembangkan konten yang kuat dan menarik agar membantu bisnis dan individu memaksimalkan data mereka.

Topik
Kecerdasan Buatan

Kursus Teratas di DataCamp

Program

Dasar-Dasar Kecerdasan Buatan

10 jam
Pelajari dasar-dasar kecerdasan buatan (AI), pelajari cara memanfaatkan AI secara efektif untuk pekerjaan, dan jelajahi model seperti ChatGPT untuk memahami lanskap AI yang dinamis.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

Lihat SelengkapnyaLihat Selengkapnya
