Program
Llama Fundamentals
4 jam
Meta akhirnya menambahkan kemampuan multimodal ke ekosistem Llama dengan memperkenalkan model visi Llama 3.2 11B & 90B. Kedua model ini unggul dalam memroses teks dan gambar, yang mendorong saya untuk mencoba membangun proyek menggunakan versi 90B.
Dalam artikel ini, saya akan membagikan pekerjaan saya dan memandu Anda membangun aplikasi image captioning interaktif menggunakan Streamlit untuk front end dan Llama 3.2 90B sebagai mesin untuk menghasilkan caption.
Llama 3.2-Vision 90B adalah large language model (LLM) multimodal mutakhir yang dibangun untuk tugas yang melibatkan input gambar dan teks sekaligus.
Model ini menonjol dengan kemampuannya menangani tugas kompleks seperti penalaran visual, pengenalan gambar, dan pembuatan caption gambar. Model ini dilatih pada himpunan data masif berisi 6 miliar pasangan gambar-teks.
Llama 3.2-Vision adalah pilihan tepat untuk aplikasi kita karena mendukung banyak bahasa untuk tugas berbasis teks, meski fokus utamanya untuk aplikasi terkait gambar adalah bahasa Inggris. Fitur-fitur kuncinya menjadikannya pilihan unggul untuk tugas seperti Visual Question Answering (VQA), Document VQA, dan penelusuran gambar-teks, dengan image captioning sebagai salah satu aplikasinya yang menonjol.
Mari kita lihat bagaimana kapabilitas ini diterapkan dalam aplikasi dunia nyata seperti image captioning.
Image captioning adalah proses otomatis untuk menghasilkan teks deskriptif yang merangkum konten sebuah gambar. Proses ini menggabungkan computer vision dan pemrosesan bahasa alami untuk menafsirkan dan mengungkapkan detail visual dalam bentuk bahasa.
Secara tradisional, image captioning memerlukan pipeline yang kompleks, sering kali melibatkan tahapan terpisah untuk pemrosesan gambar dan pembangkitan bahasa. Pendekatan standar mencakup tiga langkah utama: prapemrosesan gambar, ekstraksi fitur, dan pembuatan caption.
Dengan Llama 3.2 90B, proses yang secara tradisional rumit ini menjadi lebih sederhana. Vision adapter model mengintegrasikan fitur visual ke dalam model bahasa inti, memungkinkannya menafsirkan gambar secara langsung dan menghasilkan caption melalui prompt sederhana.
Dengan menyematkan lapisan cross-attention dalam arsitekturnya, Llama 3.2 90B memungkinkan pengguna mendeskripsikan gambar hanya dengan memberi prompt pada model—menghilangkan kebutuhan akan tahapan pemrosesan terpisah. Kesederhanaan ini membuat image captioning lebih mudah diakses dan efisien, di mana satu prompt dapat menghasilkan caption alami dan deskriptif yang menangkap esensi sebuah gambar.
Untuk menghadirkan kekuatan Llama 3.2 90B, kita akan membangun aplikasi image captioning yang sederhana namun efektif menggunakan Streamlit untuk front end dan Groq untuk menghasilkan caption.
Aplikasi ini akan memungkinkan pengguna mengunggah gambar dan menerima caption deskriptif yang dihasilkan model hanya dengan dua kali klik. Pengaturan ini ramah pengguna dan membutuhkan pengetahuan coding minimal untuk memulai.
Aplikasi kita akan mencakup fitur-fitur berikut:
Groq API akan berperan sebagai jembatan antara gambar yang diunggah pengguna dan model Llama 3.2-Vision. Jika Anda ingin mengikuti dan ngoding bersama saya, pastikan Anda terlebih dahulu:
Cuplikan kode Python di bawah ini menyiapkan aplikasi Streamlit untuk berinteraksi dengan Groq API. Kode ini mencakup:
import streamlit as stfrom groq import Groqimport base64import osimport json# Set up Groq API Keyos.environ['GROQ_API_KEY'] = json.load(open('credentials.json', 'r'))['groq_token']# Function to encode the imagedef encode_image(image_path): with open(image_path, "rb") as image_file: return base64.b64encode(image_file.read()).decode('utf-8')Kita lanjutkan dengan menulis fungsi di bawah ini, yang dirancang untuk menghasilkan deskripsi tekstual dari gambar yang diunggah menggunakan Groq API. Berikut ringkasan fungsinya:
# Function to generate captiondef generate_caption(uploaded_image): base64_image = base64.b64encode(uploaded_image.read()).decode('utf-8') client = Groq() chat_completion = client.chat.completions.create( messages=[ { "role": "user", "content": [ {"type": "text", "text": "What's in this image?"}, { "type": "image_url", "image_url": { "url": f"data:image/jpeg;base64,{base64_image}", }, }, ], } ], model="llama-3.2-90b-vision-preview", ) return chat_completion.choices[0].message.contentTerakhir, kita menghasilkan aplikasi web interaktif melalui Streamlit:
# Streamlit Appst.title("Llama Captioner")uploaded_file = st.file_uploader("Upload an image", type=["jpg", "jpeg", "png"])if uploaded_file is not None: # Show the uploaded image st.image(uploaded_file, caption="Uploaded Image", use_container_width=True) if st.button("Generate Caption"): with st.spinner("Generating caption..."): caption = generate_caption(uploaded_file) st.success("Caption Generated!") st.write("**Caption:**", caption)Aplikasi Streamlit ini menyediakan antarmuka yang ramah pengguna untuk image captioning. Berikut ringkasan fungsinya:
st.image.Cuplikan di bawah ini adalah kode yang berjalan ketika gambar Eddie Hall diunggah untuk menghasilkan caption. Mengejutkannya, model juga mengekstrak informasi yang tidak terlihat jelas seperti “Strongest Man” dan sebagainya.
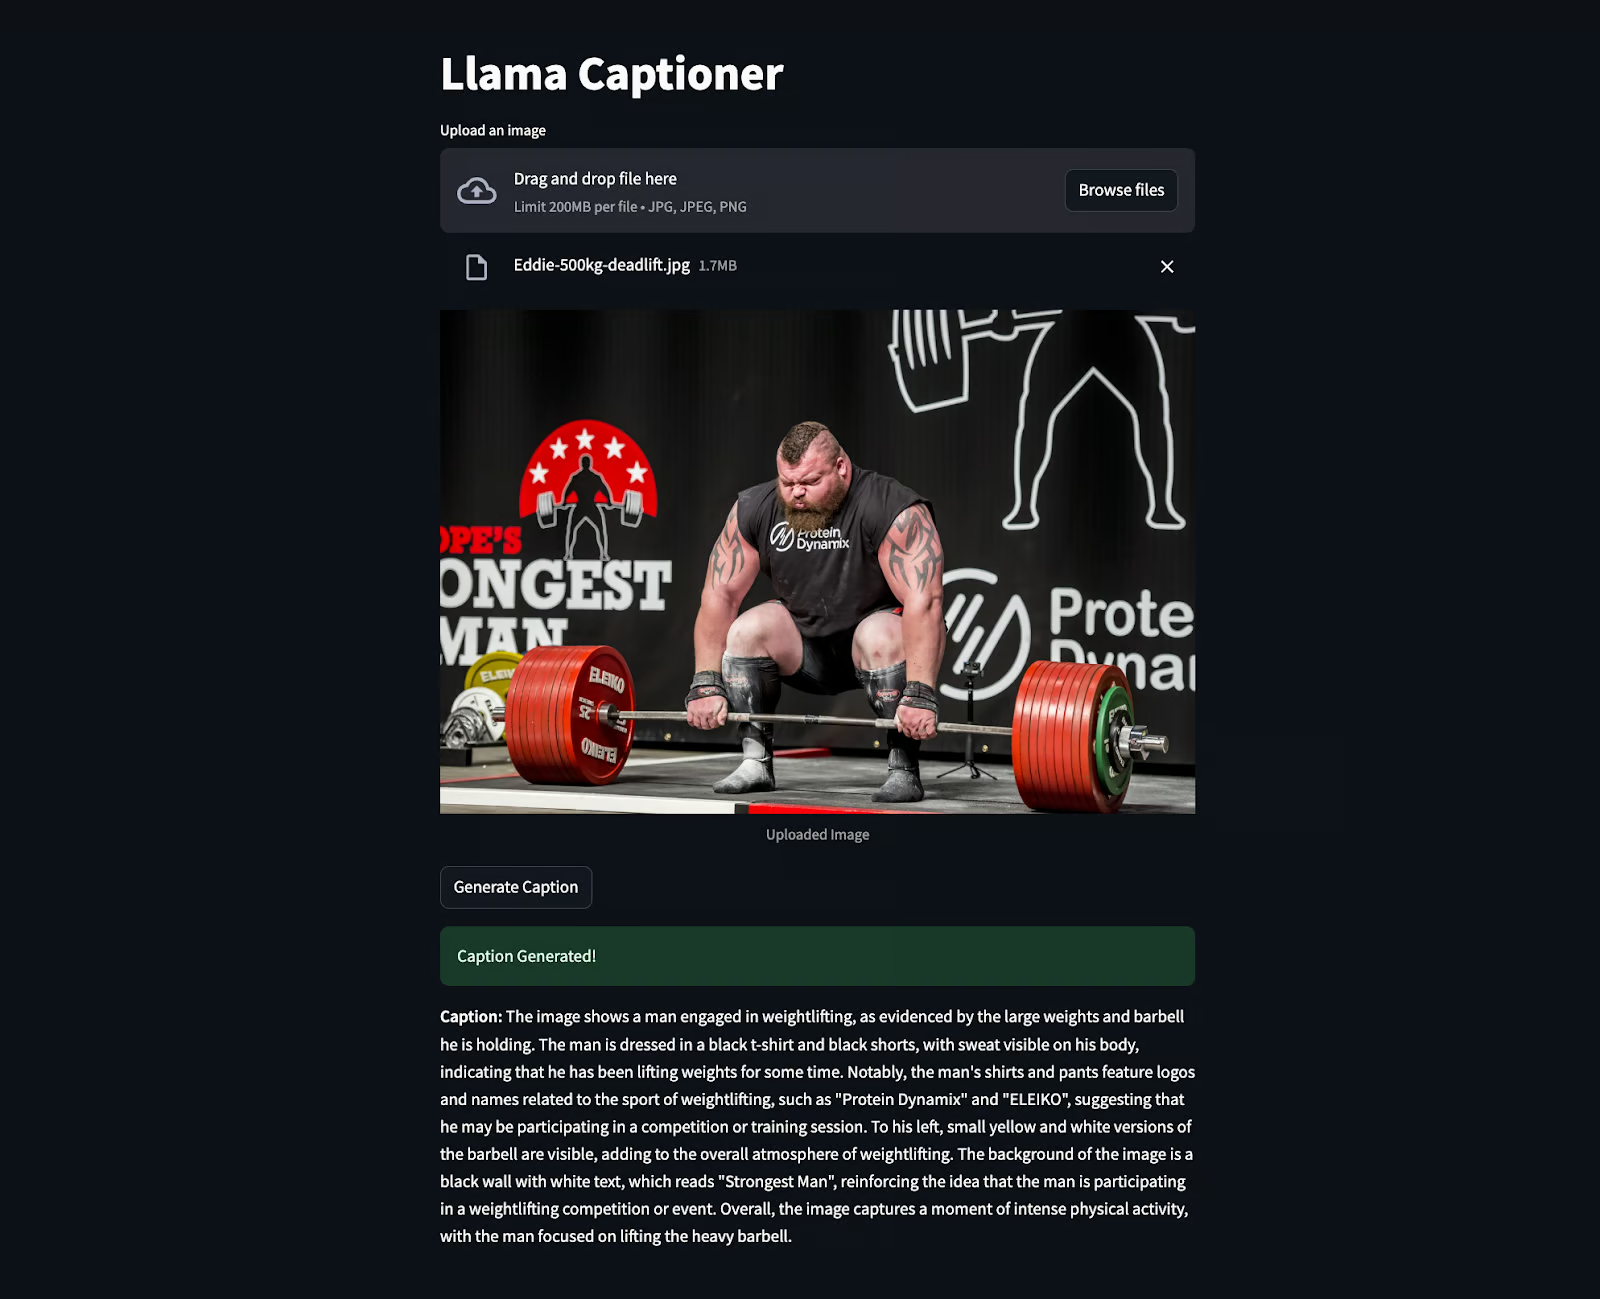
Membangun aplikasi image captioning dengan Llama 3.2 90B dan Streamlit menunjukkan bagaimana AI canggih dapat mempermudah tugas yang sulit. Proyek ini menggabungkan model yang kuat dengan antarmuka sederhana untuk menciptakan alat yang intuitif dan mudah digunakan.
Sebagai AI Engineer, saya melihat potensi besar pada alat seperti ini. Alat ini dapat membuat teknologi lebih mudah diakses, membantu orang berinteraksi lebih baik dengan konten, dan mengotomatisasi proses dengan cara yang lebih cerdas.
Untuk melanjutkan pembelajaran Anda tentang Llama, saya merekomendasikan sumber daya berikut:
Pelajari Llama dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt



