
Menurut contoh dari Meta, model dapat menganalisis bagan yang disematkan dalam dokumen dan merangkum tren utama. Model juga bisa menafsirkan peta, menentukan bagian jalur pendakian yang paling curam, atau menghitung jarak antara dua titik.
Use case model visi Llama
Integrasi penalaran teks dan gambar ini menawarkan beragam aplikasi potensial, termasuk:
- Pemahaman dokumen: Model ini dapat mengekstrak dan merangkum informasi dari dokumen yang berisi gambar, grafik, dan bagan. Misalnya, sebuah bisnis dapat menggunakan Llama 3.2 untuk secara otomatis menafsirkan data penjualan yang disajikan dalam bentuk visual.
- Visual question answering: Dengan memahami teks dan gambar, model Llama 3.2 dapat menjawab pertanyaan berdasarkan konten visual, seperti mengidentifikasi objek dalam suatu adegan atau merangkum isi sebuah gambar.
- Pembuatan caption gambar: Model dapat menghasilkan caption untuk gambar, berguna di bidang seperti media digital atau aksesibilitas, di mana pemahaman isi gambar itu penting.
Terbuka dan dapat dikustomisasi
Model visi Llama 3.2 bersifat terbuka dan dapat dikustomisasi. Pengembang dapat melakukan fine-tuning pada versi pre-trained maupun aligned dari model-model ini menggunakan kerangka kerja Torchtune dari Meta.
Selain itu, model ini dapat dideploy secara lokal melalui Torchchat, mengurangi ketergantungan pada infrastruktur cloud dan memberikan solusi bagi pengembang yang ingin mendeploy sistem AI di on-prem atau lingkungan dengan sumber daya terbatas.
Model visi juga tersedia untuk diuji melalui Meta AI, asisten cerdas dari Meta.
Cara kerja model visi Llama 3.2
Agar model visi Llama 3.2 dapat memahami teks dan gambar, Meta mengintegrasikan encoder gambar yang telah dilatih sebelumnya ke dalam model bahasa yang ada menggunakan adaptor khusus. Adaptor ini menghubungkan data gambar dengan bagian pemrosesan teks pada model, sehingga dapat menangani kedua jenis masukan.
Proses pelatihan dimulai dari model bahasa Llama 3.1. Pertama, tim melatihnya pada set gambar berpasangan dengan deskripsi teks dalam jumlah besar untuk mengajarkan hubungan keduanya. Lalu, pemurnian dilakukan menggunakan data yang lebih bersih dan spesifik untuk meningkatkan kemampuan memahami dan menalar konten visual.
Pada tahap akhir, Meta menggunakan teknik seperti fine-tuning dan pembuatan data sintetis untuk memastikan model memberikan jawaban yang bermanfaat dan berperilaku aman.
Benchmark: Kekuatan dan kelemahan
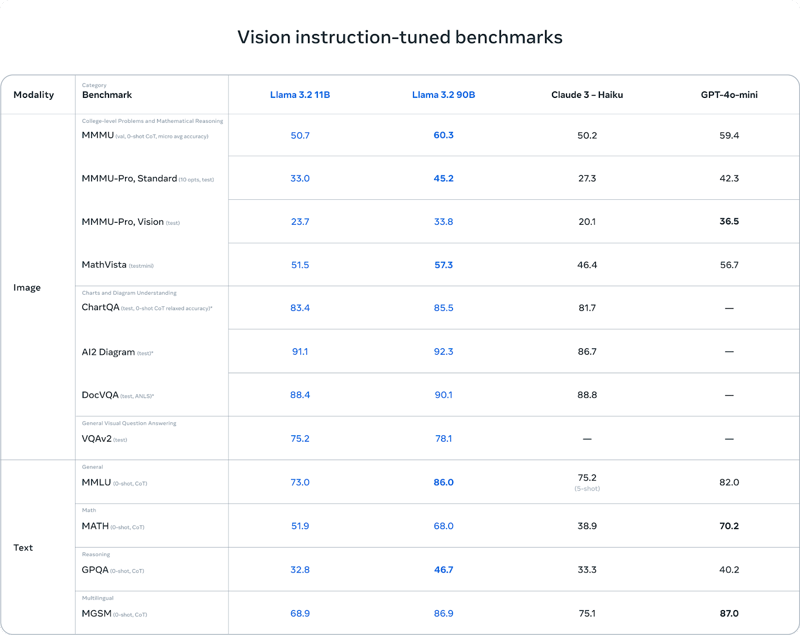
Model visi Llama 3.2 menonjol dalam pemahaman bagan dan diagram. Pada benchmark seperti AI2 Diagram (92,3) dan DocVQA (90,1), Llama 3.2 melampaui Claude 3 Haiku. Ini menjadikannya pilihan unggul untuk tugas yang melibatkan pemahaman tingkat dokumen, visual question answering, dan ekstraksi data dari bagan.
Dalam tugas multibahasa (MGSM), Llama 3.2 juga tampil baik, hampir menyamai GPT-4o-mini dengan skor 86,9, sehingga menjadi opsi solid bagi pengembang yang bekerja dengan banyak bahasa.
Sumber: Meta AI
Walau Llama 3.2 berkinerja baik pada tugas berbasis visi, ia menghadapi tantangan di area lain. Pada MMMU-Pro Vision, yang menguji penalaran matematis atas data visual, GPT-4o-mini mengungguli Llama 3.2 dengan skor 36,5 dibanding 33,8 milik Llama.
Demikian pula, pada benchmark MATH, performa GPT-4o-mini (70,2) jauh melampaui Llama 3.2 (51,9), menunjukkan Llama masih punya ruang peningkatan untuk tugas penalaran matematis.
Model Ringan Llama 3.2 1B & 3B
Kemajuan signifikan lainnya di Llama 3.2 adalah diperkenalkannya model ringan yang dirancang untuk perangkat edge dan mobile. Model dengan 1 miliar dan 3 miliar parameter ini dioptimalkan untuk berjalan pada perangkat keras yang lebih kecil sambil mempertahankan kompromi kinerja yang wajar.
AI On-Device: Real-time dan privat
Model-model ini dirancang berjalan di perangkat seluler, menyediakan pemrosesan lokal yang cepat tanpa perlu mengirim data ke cloud. Menjalankan model secara lokal pada perangkat edge memberikan dua manfaat utama:
- Waktu respons lebih cepat: Karena model berjalan di perangkat, permintaan dapat diproses dan respons dihasilkan hampir seketika. Ini sangat berguna untuk interaksi real-time di mana kecepatan krusial.
- Peningkatan privasi: Dengan pemrosesan lokal, data pengguna tidak perlu keluar dari perangkat. Ini menjaga informasi sensitif, seperti pesan pribadi atau agenda, tetap aman dan berada di bawah kendali pengguna, alih-alih dikirim ke cloud.
Model ringan Llama 3.2 dioptimalkan untuk prosesor Arm dan diaktifkan pada perangkat keras Qualcomm serta MediaTek, yang mendayai banyak perangkat mobile dan edge saat ini.
Aplikasi Llama 3.2 1B & 3B
Model ringan ini dirancang untuk berbagai aplikasi praktis di perangkat, seperti:
1. Perangkuman: Pengguna dapat meringkas teks dalam jumlah besar, seperti email atau catatan rapat, langsung di perangkat tanpa bergantung pada layanan cloud.
2. Asisten pribadi AI: Model dapat menafsirkan instruksi bahasa alami dan melakukan tugas, seperti membuat daftar tugas atau menjadwalkan pertemuan.
3. Penulisan ulang teks: Model ini mampu meningkatkan atau memodifikasi teks secara langsung, sehingga berguna untuk aplikasi seperti penyuntingan otomatis atau alat parafrase.
Cara kerja model ringan Llama 3.2
Model ringan Llama 3.2 (1B dan 3B) dibangun agar efisien pada perangkat mobile dan edge sembari mempertahankan performa yang kuat. Untuk mencapainya, Meta menggunakan dua teknik utama: pruning dan distillation.
Sumber: Meta AI
Pruning: Membuat model lebih kecil
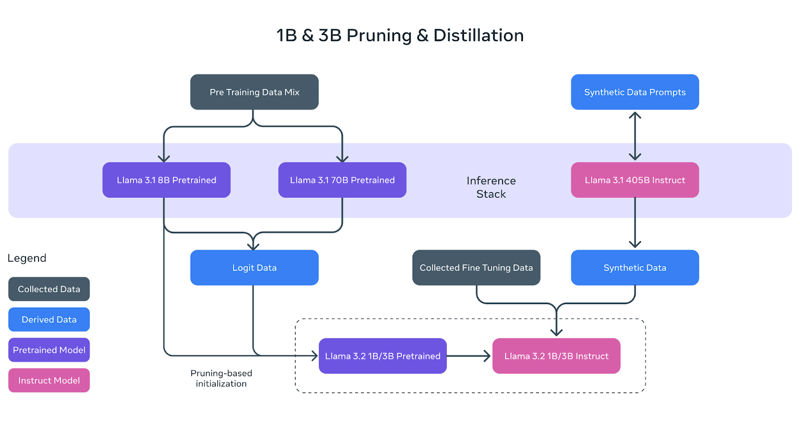
Pruning membantu mengurangi ukuran model Llama asli dengan menghapus bagian jaringan yang kurang krusial sambil mempertahankan sebanyak mungkin pengetahuan. Pada model 1B dan 3B Llama 3.2, proses ini dimulai dari model pre-trained Llama 3.1 8B yang lebih besar.
Dengan melakukan pruning secara sistematis, tim Meta AI dapat membuat versi model yang lebih kecil dan efisien tanpa kehilangan performa yang signifikan. Ini tergambar pada diagram di atas, di mana model pre-trained 8B (kotak ungu) dipangkas dan disempurnakan untuk menjadi basis model Llama 3.2 1B/3B yang lebih kecil.
Distillation: Mengajarkan model yang lebih kecil
Distillation adalah proses mentransfer pengetahuan dari model yang lebih besar dan kuat ("guru") ke model yang lebih kecil ("murid"). Di Llama 3.2, logit (prediksi) dari model Llama 3.1 8B dan Llama 3.1 70B yang lebih besar digunakan untuk mengajarkan model yang lebih kecil.
Dengan cara ini, model 1B dan 3B yang lebih kecil dapat belajar melakukan tugas lebih efektif meski ukurannya berkurang. Diagram di atas menunjukkan bagaimana proses ini menggunakan data logit dari model yang lebih besar untuk membimbing model 1B dan 3B selama pre-training.
Penyempurnaan akhir
Setelah pruning dan distillation, model 1B dan 3B menjalani post-training, mirip dengan model Llama sebelumnya. Ini melibatkan teknik seperti supervised fine-tuning, rejection sampling, dan direct preference optimization untuk menyelaraskan keluaran model dengan ekspektasi pengguna.
Data sintetis juga dihasilkan untuk memastikan model mampu menangani berbagai tugas, seperti perangkuman, penulisan ulang, dan mengikuti instruksi.
Sebagaimana ditunjukkan pada diagram, model instruksi Llama 3.2 1B/3B final merupakan hasil dari pruning, distillation, dan post-training yang ekstensif.
Benchmark: Kekuatan dan kelemahan
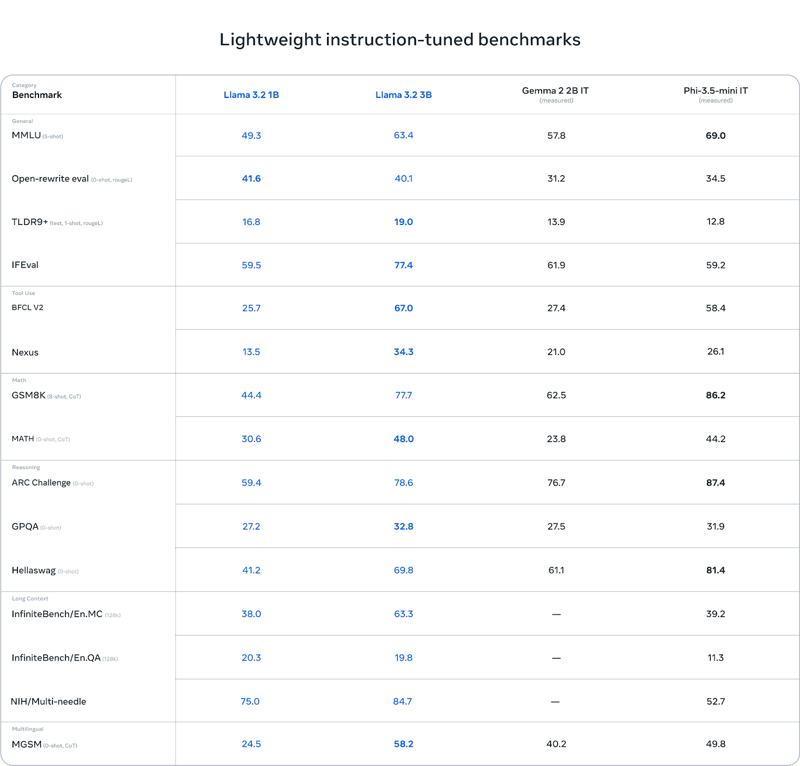
Llama 3.2 3B menonjol pada kategori tertentu, khususnya tugas yang melibatkan penalaran. Sebagai contoh, pada ARC Challenge, model ini meraih 78,6, melampaui Gemma (76,7) dan sedikit di belakang Phi-3.5-mini (87,4). Demikian pula, performanya baik pada benchmark Hellawag dengan capaian 69,8, mengungguli Gemma dan tetap kompetitif dengan Phi.
Dalam tugas penggunaan alat seperti BFCL V2, Llama 3.2 3B juga menonjol dengan skor 67,0, di depan kedua pesaingnya. Ini menunjukkan bahwa model 3B efektif menangani tugas mengikuti instruksi dan terkait alat.
Sumber: Meta AI
Llama Stack Distribution
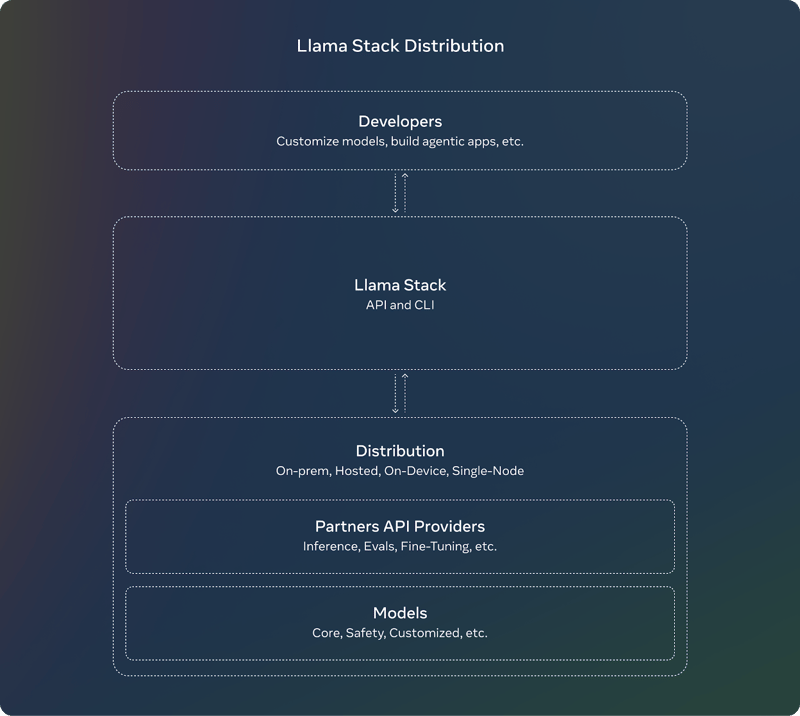
Untuk melengkapi rilis Llama 3.2, Meta memperkenalkan Llama Stack. Bagi pengembang, menggunakan Llama Stack berarti tidak perlu khawatir dengan detail kompleks penyiapan atau deployment model besar. Mereka dapat fokus membangun aplikasi dan mempercayakan pekerjaan berat pada Llama Stack.
Berikut fitur utama Llama Stack:
- API yang distandardisasi: Pengembang dapat menggunakannya untuk berinteraksi dengan model Llama tanpa harus membangun semuanya dari nol.
- Bekerja di mana saja: Llama Stack dirancang untuk bekerja di berbagai platform:
- Single-node: Menjalankan model Llama pada satu komputer saja.
- On-premises: Menggunakan model di server Anda sendiri atau cloud privat.
- Cloud: Mendeploy model Llama melalui penyedia cloud seperti AWS atau Google Cloud.
- Perangkat mobile dan edge: Memungkinkan menjalankan model Llama di ponsel atau perangkat kecil tanpa bergantung pada cloud.
- Solusi siap pakai: Llama Stack menawarkan solusi “turnkey”, berupa setelan siap pakai untuk tugas umum seperti analisis dokumen atau tanya jawab. Ini dapat menghemat waktu dan upaya pengembang.
- Keamanan terintegrasi: Stack ini juga menyertakan fitur keamanan bawaan, memastikan AI berperilaku bertanggung jawab dan etis saat dideploy.
Sumber: Meta AI
Keamanan Llama 3.2
Meta melanjutkan fokus pada AI yang bertanggung jawab pada Llama 3.2. Llama Guard 3 telah diperbarui dengan versi berkemampuan visi yang mendukung kapabilitas multimodal baru Llama 3.2. Ini memastikan aplikasi yang menggunakan fitur pemahaman gambar baru tetap aman dan patuh pada pedoman etika.
Selain itu, Llama Guard 3 1B telah dioptimalkan untuk deployment di lingkungan dengan sumber daya lebih terbatas, sehingga lebih kecil dan lebih efisien dibanding versi sebelumnya.
Cara Mengakses dan Mengunduh Model Llama 3.2
Mengakses dan mengunduh model Llama 3.2 cukup mudah. Meta menyediakan model-model ini di berbagai platform, termasuk situs resmi mereka dan Hugging Face, platform populer untuk hosting dan berbagi model AI.
Anda dapat mengunduh model Llama 3.2 langsung dari situs resmi Llama. Meta menawarkan model ringan yang lebih kecil (1B dan 3B) serta model berkemampuan visi yang lebih besar (11B dan 90B) untuk digunakan pengembang.
Hugging Face adalah platform lain tempat model Llama 3.2 tersedia. Platform ini memberikan akses mudah dan umum digunakan oleh komunitas pengembang AI.
Model Llama 3.2 tersedia untuk pengembangan segera pada ekosistem luas platform mitra kami, termasuk AMD, AWS, Databricks, Dell, Google Cloud, Groq, IBM, Intel, Microsoft Azure, NVIDIA, Oracle Cloud, Snowflake, dan lainnya.
Kesimpulan
Rilis Llama 3.2 dari Meta memperkenalkan model multimodal pertama dalam seri ini, dengan fokus pada dua area utama: model berkemampuan visi dan model ringan untuk perangkat edge dan mobile.
Model multimodal 11B dan 90B kini dapat menangani pemrosesan teks dan gambar, sementara model 1B dan 3B dioptimalkan untuk penggunaan lokal yang efisien pada perangkat yang lebih kecil.
Dalam artikel ini, saya telah memaparkan hal-hal esensial—cara kerja model-model ini, aplikasi praktisnya, dan cara Anda mengaksesnya.
FAQ
Apa itu Llama 3.2 dan apa bedanya dengan Llama 3.1?
Llama 3.2 memperkenalkan kapabilitas multimodal, memungkinkan model memahami teks dan gambar. Versi ini juga menawarkan model ringan yang dirancang untuk penggunaan efisien pada perangkat edge dan mobile, berbeda dengan Llama 3.1 yang berfokus terutama pada pemrosesan teks.
Bagaimana perbandingan model visi Llama 3.2 dengan GPT-4o-mini dan Claude 3 Haiku?
Model visi Llama 3.2 tampil kompetitif, unggul dalam tugas yang melibatkan penalaran atas teks dan gambar. Namun, model ini bisa sedikit tertinggal dari GPT-4o-mini pada tugas khusus tertentu seperti pemecahan masalah matematis.
Apakah Llama 3.2 bersifat open source?
Ya, model Llama 3.2 bersifat open-source dan tersedia untuk diunduh di situs resmi Llama dan Hugging Face. Pengembang dapat mengakses, melakukan fine-tuning, dan mendeploy model di berbagai platform, memastikan fleksibilitas dan kustomisasi.
Apa itu Llama Stack dan mengapa penting bagi pengembang?
Llama Stack menyediakan API yang distandardisasi dan solusi siap pakai untuk mendeploy model Llama di berbagai lingkungan, dari cloud hingga on-device. Stack ini menyederhanakan proses membangun aplikasi AI dengan Llama 3.2, memastikan integrasi dan deployment yang lebih mudah.
Apa persyaratan perangkat keras untuk menjalankan model Llama 3.2?
Llama 3.2 menawarkan model ringan yang dioptimalkan untuk prosesor Arm serta perangkat keras Qualcomm dan MediaTek, sehingga dapat berjalan efisien di perangkat seluler. Model yang lebih besar mungkin memerlukan GPU yang lebih kuat atau infrastruktur berbasis cloud untuk performa optimal.
Saya adalah editor dan penulis yang mengulas blog, tutorial, dan berita AI, memastikan semuanya selaras dengan strategi konten yang kuat dan praktik terbaik SEO. Saya telah menulis kursus data science tentang Python, statistik, probabilitas, dan visualisasi data. Saya juga telah menerbitkan novel pemenang penghargaan dan menghabiskan waktu luang untuk menulis skenario serta menyutradarai film.




Meta AI mengumumkan peluncuran Llama 3.2, yang memperkenalkan model multimodal pertama dalam seri ini. Llama 3.2 berfokus pada dua area utama:
Dalam artikel ini, saya akan menyoroti aspek kunci dari model Llama 3.2 yang baru, termasuk cara kerjanya, use case, cara mengaksesnya, dan lainnya. Anda dapat melihat panduan terpisah kami tentang fine-tuning Llama 3.2.
Model Visi Llama 3.2 11B & 90B
Fitur utama Llama 3.2 adalah diperkenalkannya model berkemampuan visi dengan 11 miliar dan 90 miliar parameter.
Model-model ini menghadirkan kapabilitas multimodal ke ekosistem Llama, memungkinkan pemrosesan dan pemahaman teks sekaligus gambar.
Kapabilitas multimodal
Model visi di Llama 3.2 unggul dalam tugas yang memerlukan pengenalan gambar dan pemrosesan bahasa. Model ini bisa menjawab pertanyaan tentang gambar, menghasilkan keterangan deskriptif, dan bahkan melakukan penalaran atas data visual yang kompleks.