{count, plural, one {Kursus} other {Kursus}}
Bekerja dengan Llama 3
{hours} jam
15.6K
Llama Stack adalah kerangka kerja yang dibangun untuk merampingkan pengembangan dan penerapan aplikasi AI generatif yang dibangun di atas model Llama milik Meta. Hal ini dicapai dengan menyediakan kumpulan API dan komponen terstandar untuk tugas seperti inferensi, keamanan, manajemen memori, dan kapabilitas agen.
Berikut tujuan dan manfaatnya:
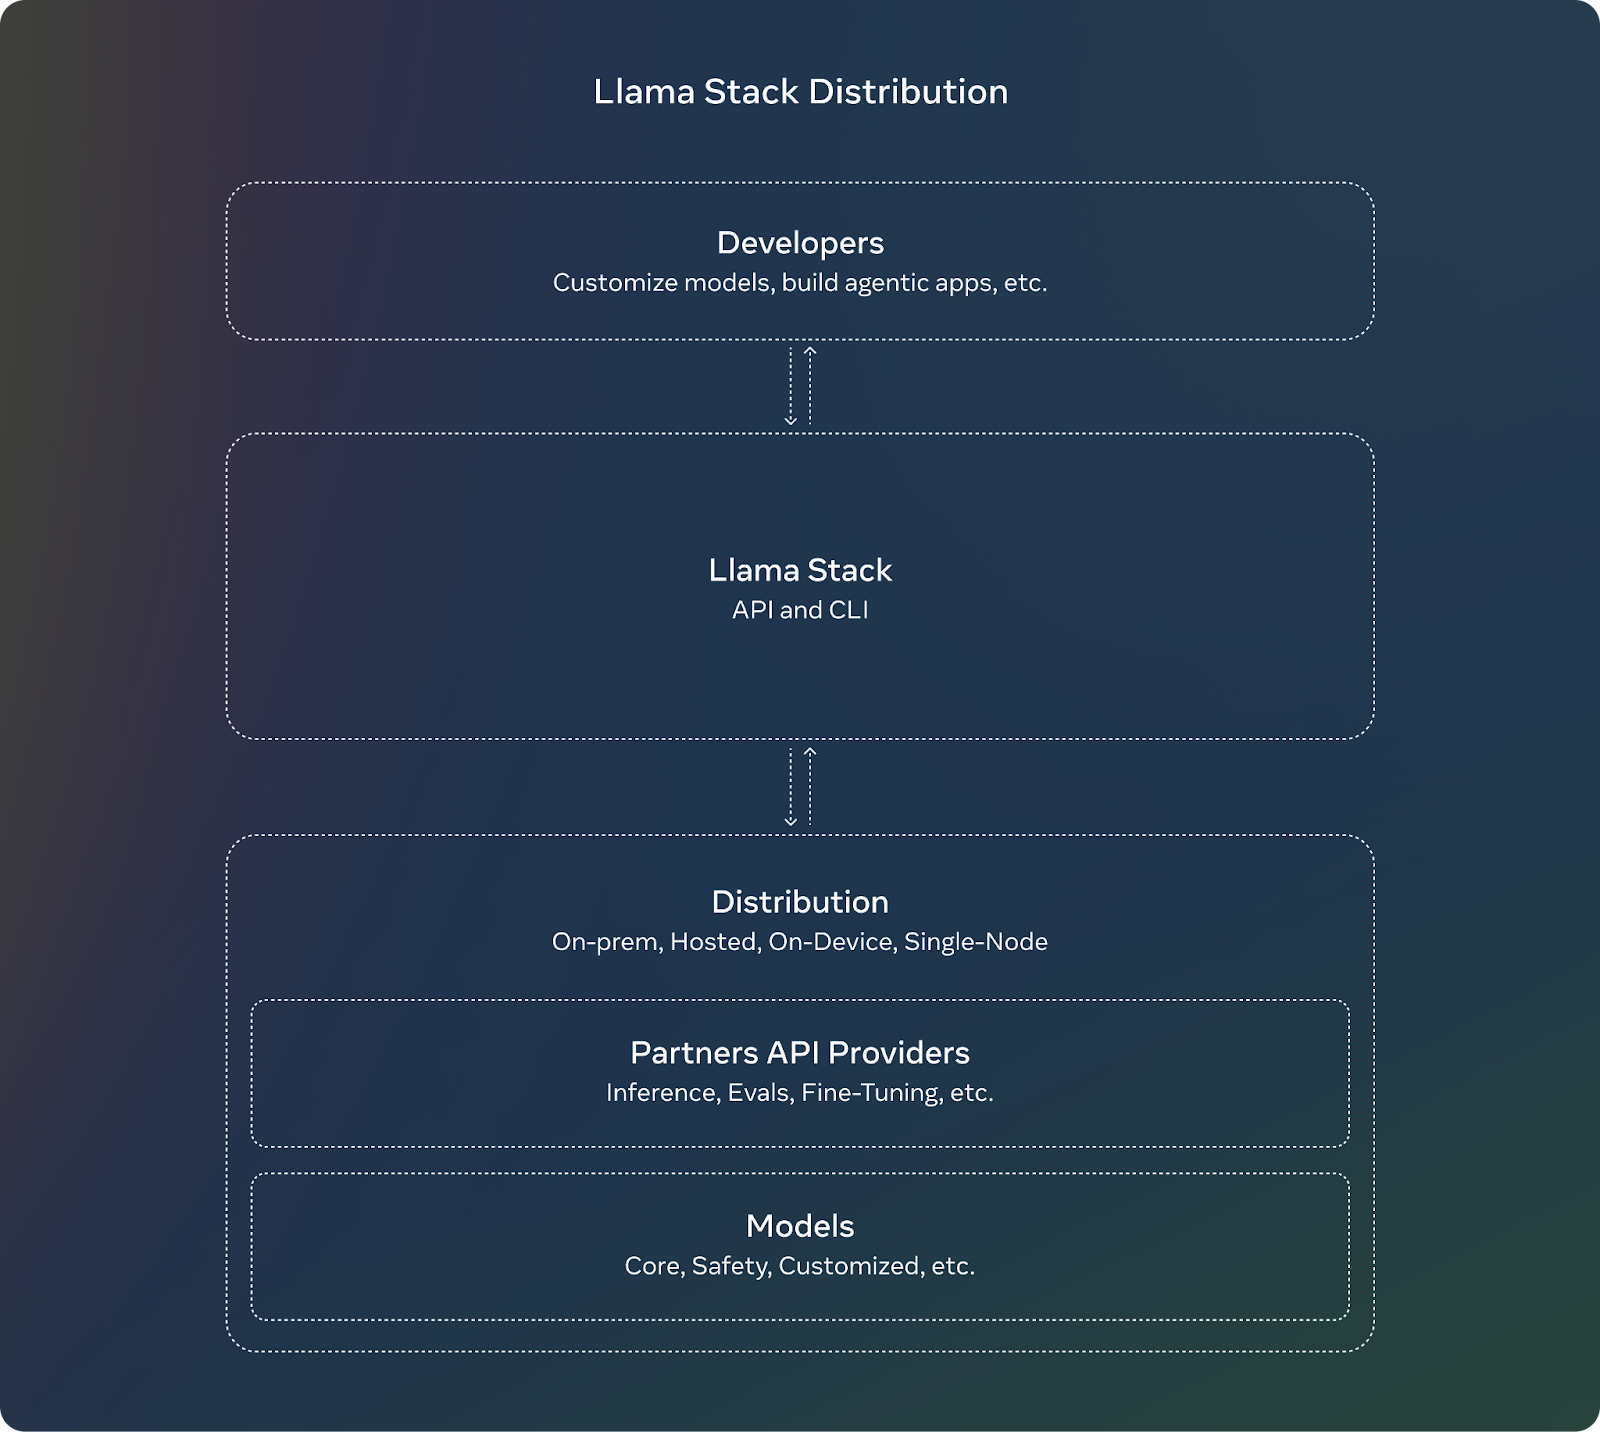
Sumber: Meta AI
Llama Stack hadir dengan beberapa API, masing-masing menargetkan serangkaian tugas tertentu dalam membangun aplikasi AI generatif.
Inference API menangani generasi teks atau pemanggilan variasi Llama multimodal. Fitur utamanya adalah:
API ini mendefinisikan berbagai konfigurasi yang memungkinkan pengembang mengontrol perilaku model (misalnya, kuantisasi FP8 atau BF16) berdasarkan kebutuhan aplikasi mereka.
Safety API dibuat untuk penerapan model AI yang bertanggung jawab melalui moderasi konten dan pemfilteran keluaran yang berbahaya atau berpotensi bias. API ini dapat dikonfigurasi untuk mendefinisikan tingkat pelanggaran (misalnya, INFO, WARN, ERROR) dan mengembalikan pesan yang dapat ditindaklanjuti kepada pengguna.
Memory API memberikan kemampuan untuk mempertahankan dan merujuk interaksi sebelumnya serta menciptakan percakapan yang lebih koheren dan sadar konteks. Beragam konfigurasi memori memberi opsi bagi pengembang untuk memilih jenis penyimpanan berdasarkan kebutuhan aplikasi. Fitur utamanya adalah:
Agentic API memungkinkan LLM menggunakan alat dan fungsi eksternal, sehingga dapat melakukan tugas seperti penelusuran web, eksekusi kode, atau pengambilan memori. API ini memungkinkan pengembang mengonfigurasi agen dengan alat dan tujuan tertentu. Ini mendukung interaksi multi-giliran di mana setiap giliran terdiri dari beberapa langkah. Fitur utamanya adalah:
Berikut API lain yang ditawarkan Llama Stack:
Kita akan mengimplementasikan proyek contoh di Llama Stack untuk membiasakan diri dengan gagasan umum dan kapabilitas kerangka kerja ini.
Sebelum mulai, harap perhatikan bahwa:
Mari mulai dengan menyiapkan antarmuka baris perintah (CLI) Llama.
Llama Stack menyediakan Command-Line Interface (CLI) untuk mengelola distribusi, menginstal model, dan mengonfigurasi lingkungan. Berikut langkah instalasi yang perlu kita lakukan:
a. Buat dan aktifkan lingkungan virtual:
conda create -n llama_stack python=3.10
conda activate llama_stack
b. Kloning repositori Llama Stack:
git clone <https://github.com/meta-llama/llama-stack.git>
cd llama-stack
c. Instal dependensi yang diperlukan:
pip install llama-stack
pip install -r requirements.txtKontainer Docker menyederhanakan penerapan server Llama Stack dan penyedia API agen. Image Docker siap pakai tersedia untuk penyiapan yang mudah:
docker pull llamastack/llamastack-local-gpu
llama stack build
llama stack configure llamastack-local-gpu
Perintah ini menarik image Docker, membangunnya, dan mengonfigurasi stack.
Mari kita bangun chatbot dasar menggunakan API Llama Stack. Berikut langkah-langkah yang perlu kita lakukan:
Kita akan menjalankan server pada port 5000. Pastikan server berjalan sebelum bekerja dengan API:
llama stack run local-gpu --port 5000Setelah menginstal Llama Stack, Anda dapat menggunakan kode klien untuk berinteraksi dengan API-nya. Gunakan Inference API untuk menghasilkan respons berdasarkan masukan pengguna:
from llama_stack_client import LlamaStackClient
client = LlamaStackClient(base_url="<http://localhost:5000>")
user_input = "Hello! How are you?"
response = client.inference.chat_completion(
    model="Llama3.1-8B-Instruct",
    messages=[{"role": "user", "content": user_input}],
    stream=False
)
print("Bot:", response.text)
Catatan: Ganti "Llama3.1-8B-Instruct" dengan nama model aktual yang tersedia di penyiapan Anda.
Terapkan Safety API untuk memoderasi respons dan memastikan respons tersebut sesuai:
safety_response = client.safety.run_shield(
    messages=[{"role": "assistant", "content": response.text}],
    shield_type="llama_guard",
    params={}
)
if safety_response.violation:
    print("Unsafe content detected.")
else:
print("Bot:", response.text)Buat kesadaran konteks chatbot dengan menyimpan dan mengambil riwayat percakapan:
### building a memory bank that can be used to store and retrieve context.
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)Kita dapat mengombinasikan API lebih lanjut untuk membangun chatbot yang tangguh:
Berikut kode lengkap setelah mencakup semua langkah:
import uuid
client = LlamaStackClient(base_url="<http://localhost:5000>")
### create a memory bank at the start
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)
def get_bot_response(user_input):
    ### retrieving conversation history
    query_response = client.memory.query_documents(
        bank_id=bank.bank_id,
        query=[user_input],
        params={"max_chunks": 10}
    )
    history = [chunk.content for chunk in query_response.chunks]
    ### preparing messages with history
    messages = [{"role": "user", "content": user_input}]
    if history:
        messages.insert(0, {"role": "system", "content": "\\n".join(history)})

    ### generate response
    response = client.inference.chat_completion(
        model="llama-2-7b-chat",
        messages=messages,
        stream=False
    )
    bot_response = response.text
    ### safety check
    safety_response = client.safety.run_shield(
        messages=[{"role": "assistant", "content": bot_response}],
        shield_type="llama_guard",
        params={}
    )
    if safety_response.violation:
        return "I'm sorry, but I can't assist with that request."
    ### memory storing
    documents = [
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=user_input,
            mime_type="text/plain"
        ),
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=bot_response,
            mime_type="text/plain"
        )
    ]
    client.memory.insert_documents(
        bank_id=bank.bank_id,
        documents=documents
    )
    return bot_response
### putting all together
while True:
    user_input = input("You: ")
    if user_input.lower() == "bye":
        break
    bot_response = get_bot_response(user_input)
print("Bot:", bot_response)Untuk melihat beberapa contoh dan memulai implementasi aplikasi menggunakan Llama Stack, Meta telah menyediakan repositori llama-stack-apps tempat Anda dapat melihat beberapa aplikasi contoh. Pastikan untuk meninjau dan membiasakan diri dengan kerangka kerjanya.
Sebagai proyek open-source, Llama Stack bergantung pada kontribusi komunitas. API berkembang pesat, dan proyek ini terbuka terhadap umpan balik serta partisipasi dari para pengembang, membantu membentuk masa depan platform. Jika Anda menguji Llama Stack, akan membantu pengembang lain jika Anda juga membagikan proyek Anda sebagai contoh, atau berkontribusi pada dokumentasi.
Sepanjang artikel ini, kita menelusuri cara memulai dengan Llama Stack melalui instruksi langkah demi langkah.
Saat Anda melangkah maju dalam menerapkan aplikasi AI, ingat untuk terus memantau repositori Llama Stack untuk pembaruan dan peningkatan terbaru.
Untuk mempelajari lebih lanjut tentang ekosistem Llama, lihat sumber daya berikut:
Pelajari AI dengan kursus-kursus ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



